


중요: RAG 코퍼스를 만들 때 코퍼스 description를 설정합니다. description은 생성 후에는 수정할 수 없습니다. 고품질 설명은 효과적인 교차 코퍼스 검색에 매우 중요합니다. 시스템은 이를 기반으로 쿼리에 적합한 코퍼스를 선택하기 때문입니다.
이 페이지에서는 백엔드의 Agentic Retrieval을 기반으로 하는 RAG 교차 코퍼스 검색을 지원하는 두 가지 API(AsyncRetrieveContexts 및 AskContexts)를 설명합니다.
AsyncRetrieveContexts API: 사용자가 여러 RAG 관리 코퍼스에서 관련 컨텍스트를 검색할 수 있는 비동기 API입니다. 장기 실행 API입니다. 사용자는 작업 ID를 사용하여 쿼리 및 결과의 상태를 가져올 수 있습니다.
AskContexts API: 여러 RAG 관리 코퍼스를 검색하여 쿼리에 대한 답변을 직접 생성하는 동기 API입니다.
중요: 이 기능을 사용하려면 프로젝트에서 RAG Engine 서비스 계정(service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com)에 Vertex AI 사용자 역할을 부여해야 합니다.
중요: 이 기능은 us-central1에서만 사용할 수 있습니다.
시스템 아키텍처 및 코퍼스 선택
이 섹션에서는 RAG 교차 코퍼스 검색 시스템의 아키텍처와 검색에 적합한 코퍼스를 선택하는 방법을 설명합니다.
시스템 아키텍처
교차 코퍼스 검색 시스템은 에이전트 접근 방식을 사용하여 여러 코퍼스에서 검색을 오케스트레이션합니다. 아키텍처의 대략적인 개요에는 다음 구성요소가 포함됩니다.
- 오케스트레이터/라우터: 사용자 쿼리를 수신하고 검색 프로세스를 조정합니다.
- 계획 에이전트: 쿼리를 분석하고
descriptions를 기반으로 가장 관련성이 높은 코퍼스를 결정합니다. - 검색 엔진: 선택한 RAG 코퍼스에서 시맨틱 검색을 실행합니다.
- 추론 에이전트: 검색된 컨텍스트가 쿼리에 답변하기에 충분한지 평가합니다. 충분하지 않은 경우 충분한 컨텍스트 인식 (SCA)을 기반으로 다른 검색 루프를 트리거하는 의견을 생성합니다. 자세한 내용은 SCA 블로그 게시물 및 연구 논문을 참고하세요.
- LLM 생성기 (
AskContexts용): 검색된 컨텍스트를 종합하여 최종 답변을 생성합니다.
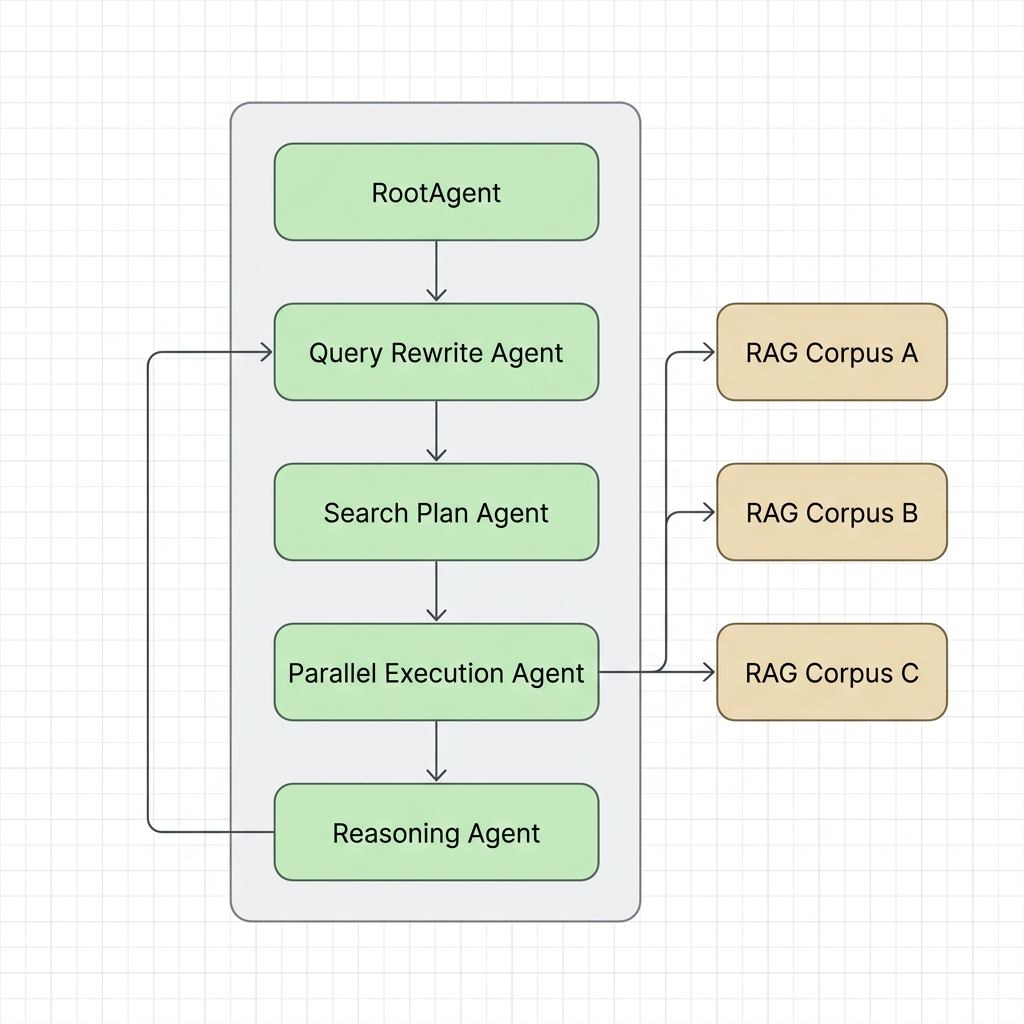
코퍼스 선택 방법
여러 RAG 관리 코퍼스에서 쿼리가 실행되면 시스템은 쿼리에 답변하는 데 필요한 정보가 포함된 코퍼스를 결정해야 합니다. 이는 Agentic Retrieval을 통해 이루어집니다.
- 코퍼스 매핑: 시스템은 사용 가능한 RAG 코퍼스의 맵과 기술 설명 (RAG 코퍼스의
description필드에 지정됨)을 유지합니다. - 시맨틱 일치: Gemini 모델을 기반으로 하는 전략 계획 에이전트가 사용 가능한 코퍼스의
descriptions에 대해 사용자의 쿼리를 평가합니다. - 타겟팅된 라우팅: 플래너는 쿼리의 특정 부분을 가장 관련성이 높은 코퍼스에 매핑하는 검색 계획을 생성하여 모든 코퍼스를 순진하게 검색하는 대신 검색이 집중되고 효율적으로 이루어지도록 합니다.
코드 샘플
다음 코드 샘플은 RAG 교차 코퍼스 검색 API를 사용하는 방법을 보여줍니다.
AsyncRetrieveContexts API
이 코드 샘플은 여러 RAG 코퍼스에서 컨텍스트를 비동기식으로 검색하는 방법을 보여줍니다.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
작업 결과 가져오기
AsyncRetrieveContexts는 장기 실행 작업이므로 작업 ID를 사용하여 GetOperations API를 폴링하여 결과를 가져올 수 있습니다.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
AskContexts API
이 코드 샘플은 여러 RAG 코퍼스를 동기식으로 검색하여 답변을 직접 생성하는 방법을 보여줍니다.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
다음 단계
- RAG API에 대해 자세히 알아보려면 RAG Engine API를 참조하세요.
- RAG의 응답에 대해 자세히 알아보려면 RAG Engine의 검색 및 생성 출력을 참조하세요.
- RAG Engine에 대해 알아보려면 RAG Engine 개요를 참조하세요.