


重要: RAG コーパスを作成するときに、コーパス description を設定します。description は作成後に編集できません。高品質な説明は、効果的なクロスコーパス検索に不可欠です。システムは、説明に基づいてクエリに適したコーパスを選択します。
このページでは、バックエンドのエージェント型検索を利用した RAG クロスコーパス検索をサポートする 2 つの API(AsyncRetrieveContexts と AskContexts)について説明します。
AsyncRetrieveContexts API: これは、ユーザーが複数の RAG 管理コーパスから関連するコンテキストを取得できるようにする非同期 API です。これは長時間実行 API です。ユーザーはオペレーション ID を使用して、クエリと結果のステータスを取得できます。
AskContexts API: これは、複数の RAG 管理コーパスを検索してクエリに対する回答を直接生成する同期 API です。
重要: この機能を使用するには、プロジェクトの Agent Platform ユーザーロールを Gemini Enterprise Agent Platform サービス アカウントの RAG Engine(service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com)に付与する必要があります。
重要: この機能は us-central1 でのみご利用いただけます。
システム アーキテクチャとコーパスの選択
このセクションでは、RAG クロスコーパス検索システムのアーキテクチャと、検索に適したコーパスを選択する方法について説明します。
システム アーキテクチャ
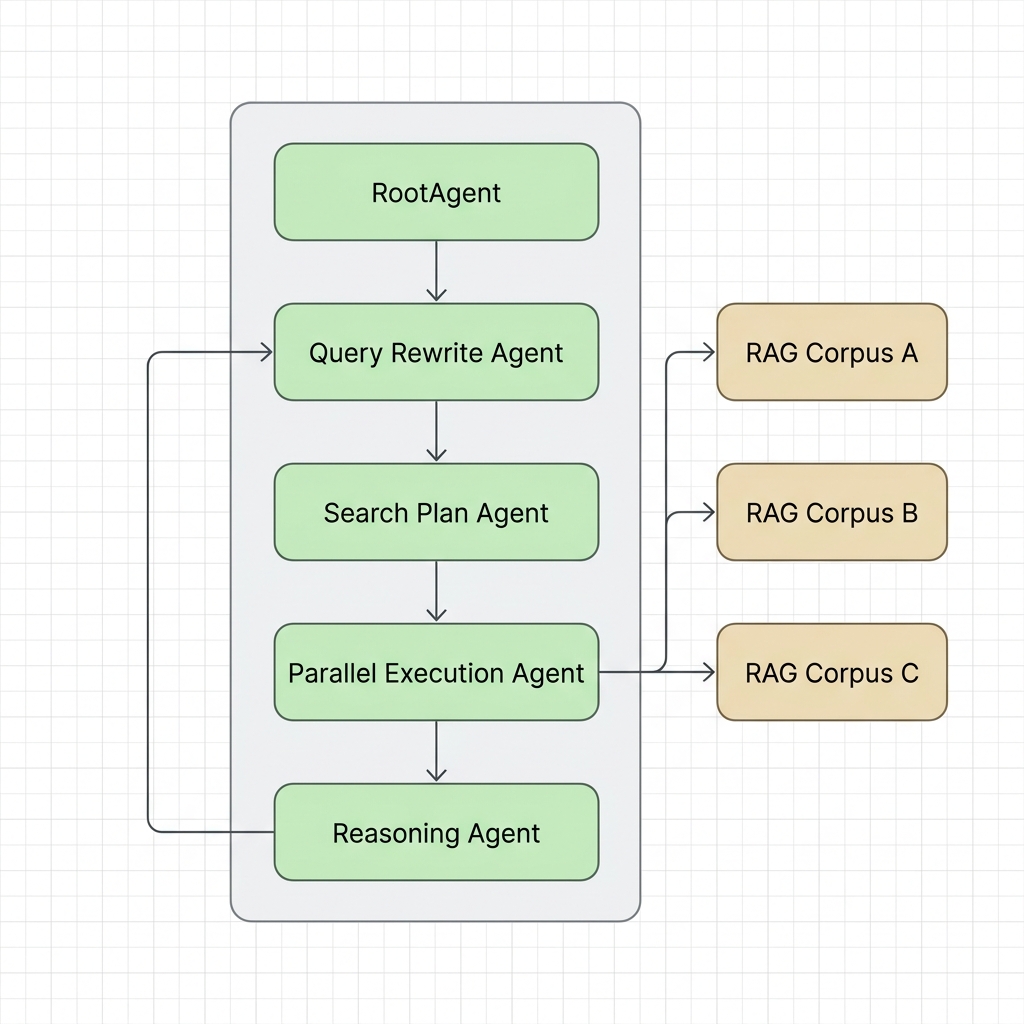
クロスコーパス検索システムは、エージェント型のアプローチを使用して、複数のコーパスにわたる検索をオーケストレートします。アーキテクチャの概要には、次のコンポーネントが含まれています。
- オーケストレーター / ルーター: ユーザークエリを受信し、検索プロセスを調整します。
- プランニング エージェント: クエリを分析し、
descriptionsに基づいて最も関連性の高いコーパスを決定します。 - 検索エンジン: 選択した RAG コーパスに対してセマンティック検索を実行します。
- 推論エージェント: 取得したコンテキストがクエリに回答するのに十分かどうかを評価します。不十分な場合は、十分なコンテキスト認識(SCA)に基づいて別の取得ループをトリガーするフィードバックを生成します。詳細については、SCA のブログ投稿と研究論文をご覧ください。
- LLM 生成ツール(
AskContexts用): 取得したコンテキストを合成して最終的な回答を生成します。
コーパスの選択方法
複数の RAG マネージド コーパスにわたってクエリが実行される場合、システムは、クエリに回答するために必要な情報が含まれているコーパスを特定する必要があります。これは、エージェント型検索によって実現されます。
- コーパス マッピング: システムは、利用可能な RAG コーパスのマップと、その技術的な説明(RAG コーパスの
descriptionフィールドで指定)を保持します。 - セマンティック マッチング: 戦略計画エージェント(Gemini モデルを搭載)が、利用可能なコーパスの
descriptionsとユーザーのクエリを評価します。 - ターゲット ルーティング: プランナーは、クエリの特定の部分を最も関連性の高いコーパスにマッピングする検索プランを生成します。これにより、すべてのコーパスを単純に検索するのではなく、検索を絞り込んで効率的に行うことができます。
コードサンプル
次のコードサンプルは、RAG Cross Corpus Retrieval API の使用方法を示しています。
AsyncRetrieveContexts API
このコードサンプルは、複数の RAG コーパスからコンテキストを非同期で取得する方法を示しています。
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
オペレーション結果を取得する
AsyncRetrieveContexts は長時間実行オペレーションであるため、GetOperations API を使用して、オペレーション ID を使用して結果をポーリングできます。
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
AskContexts API
このコードサンプルは、複数の RAG コーパスを同期的に検索して回答を直接生成する方法を示しています。
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
次のステップ
- RAG API の詳細を確認する。RAG Engine API をご覧ください。
- RAG からのレスポンスの詳細については、RAG Engine の検索と生成の出力をご覧ください。
- RAG Engine の詳細については、RAG Engine の概要をご覧ください。