


Importante: imposta il corpus description durante la creazione di un corpus RAG. Il campo description non è modificabile dopo la creazione. Le descrizioni di alta qualità sono fondamentali per un recupero efficace tra corpora, poiché il sistema si basa su di esse per selezionare i corpora appropriati per la tua query.
Questa pagina descrive due API, AsyncRetrieveContexts e AskContexts, che supportano il recupero tra corpora RAG, basato sul recupero agentico nel backend.
API AsyncRetrieveContexts: si tratta di un'API asincrona che consente agli utenti di recuperare contesti pertinenti da più corpora gestiti da RAG. Questa è un'API a lunga esecuzione. Gli utenti possono utilizzare l'ID operazione per ottenere lo stato della query e del risultato.
API AskContexts: si tratta di un'API sincrona che genera direttamente la risposta alla query eseguendo ricerche in più corpus gestiti da RAG.
Importante: per utilizzare questa funzionalità, devi concedere il ruolo Utente Agent Platform nel tuo progetto al account di servizio RAG Engine su Gemini Enterprise Agent Platform: service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com.
Importante: questa funzionalità è disponibile solo in us-central1.
Architettura del sistema e selezione del corpus
Questa sezione descrive l'architettura del sistema di recupero tra corpora RAG e il modo in cui seleziona i corpora appropriati per il recupero.
Architettura di sistema
Il sistema di recupero tra corpora utilizza un approccio basato su agenti per orchestrare il recupero tra più corpora. Una panoramica di alto livello dell'architettura include i seguenti componenti:
- Orchestratore/router: riceve la query dell'utente e coordina il processo di recupero.
- Agente di pianificazione: analizza la query e determina quali corpora sono più pertinenti in base alla loro
descriptions. - Motore di recupero: esegue la ricerca semantica sui corpora RAG selezionati.
- Reasoning Agent: valuta se i contesti recuperati sono sufficienti per rispondere alla query. Se non sono sufficienti, genera un feedback per attivare un altro loop di recupero basato sulla Sufficient Context Awareness (SCA). Per maggiori dettagli, consulta il blog post su SCA e il documento di ricerca.
- Generatore LLM (per
AskContexts): sintetizza i contesti recuperati per generare una risposta finale.
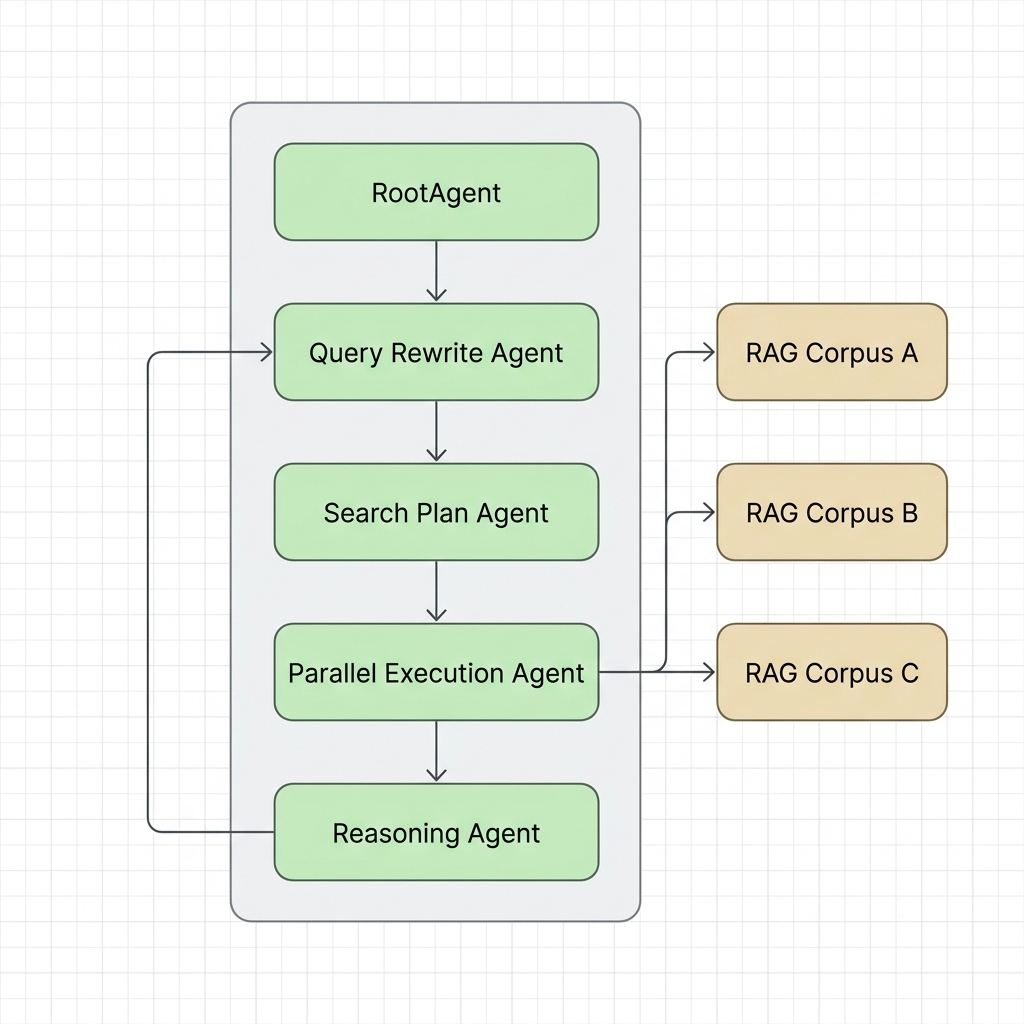
Come vengono selezionati i corpora
Quando una query viene eseguita su più corpus gestiti da RAG, il sistema deve determinare quale corpus contiene le informazioni necessarie per rispondere alla query. Ciò avviene tramite il recupero agentico:
- Mappatura dei corpus: il sistema mantiene una mappa dei corpus RAG disponibili insieme alle relative descrizioni tecniche (specificate nel campo
descriptiondel corpus RAG). - Corrispondenza semantica: un agente di pianificazione strategica (basato su un modello Gemini) valuta la query dell'utente rispetto alla
descriptionsdei corpora disponibili. - Routing mirato: il planner genera un piano di recupero che mappa parti specifiche della query ai corpora più pertinenti, garantendo che il recupero sia mirato ed efficiente anziché eseguire una ricerca ingenua in tutti i corpora.
Esempi di codice
I seguenti esempi di codice mostrano come utilizzare le API RAG Cross Corpus Retrieval.
AsyncRetrieveContexts API
Questo esempio di codice mostra come recuperare i contesti da più corpus RAG in modo asincrono.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Ottieni il risultato dell'operazione
Poiché AsyncRetrieveContexts è un'operazione a lunga esecuzione, puoi utilizzare l'API GetOperations per eseguire il polling del risultato utilizzando l'ID operazione.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
API AskContexts
Questo esempio di codice mostra come generare direttamente una risposta eseguendo ricerche in più corpus RAG in modo sincrono.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Passaggi successivi
- Per scoprire di più sull'API RAG, consulta l'API RAG Engine.
- Per scoprire di più sulle risposte di RAG, consulta Output di recupero e generazione di RAG Engine.
- Per scoprire di più su RAG Engine, consulta la panoramica di RAG Engine.