


Important : Définissez le description du corpus lors de la création d'un corpus RAG. Le description ne peut pas être modifié après sa création. Des descriptions de haute qualité sont essentielles pour une récupération efficace entre plusieurs corpus, car le système s'appuie sur elles pour sélectionner les corpus appropriés pour votre requête.
Cette page décrit deux API, AsyncRetrieveContexts et AskContexts, qui sont compatibles avec la récupération inter-corpus RAG, optimisée par la récupération agentique dans le backend.
API AsyncRetrieveContexts : il s'agit d'une API asynchrone qui permet aux utilisateurs de récupérer des contextes pertinents à partir de plusieurs corpus gérés par RAG. Il s'agit d'une API de longue durée. Les utilisateurs peuvent utiliser l'ID d'opération pour obtenir l'état de la requête et du résultat.
API AskContexts : il s'agit d'une API synchrone qui génère directement la réponse à la requête en effectuant une recherche dans plusieurs corpus gérés par RAG.
Important : Pour utiliser cette fonctionnalité, vous devez attribuer le rôle Utilisateur Vertex AI dans votre projet au compte de service du moteur RAG sur Gemini Enterprise Agent Platform : service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com.
Important : Cette fonctionnalité n'est disponible qu'en us-central1.
Architecture du système et sélection du corpus
Cette section décrit l'architecture du système de récupération inter-corpus RAG et la manière dont il sélectionne les corpus appropriés pour la récupération.
Architecture du système
Le système de récupération inter-corpus utilise une approche agentive pour orchestrer la récupération sur plusieurs corpus. Une présentation générale de l'architecture comprend les composants suivants :
- Orchestrateur/Routeur : reçoit la requête de l'utilisateur et coordonne le processus de récupération.
- Agent de planification : analyse la requête et détermine les corpus les plus pertinents en fonction de leur
descriptions. - Moteur de récupération : effectue une recherche sémantique sur les corpus RAG sélectionnés.
- Agent de raisonnement : évalue si les contextes récupérés sont suffisants pour répondre à la requête. Si ce n'est pas le cas, il génère des commentaires pour déclencher une autre boucle de récupération basée sur la reconnaissance du contexte suffisant (SCA, Sufficient Context Awareness). Pour en savoir plus, consultez l'article de blog sur l'ACS et l'article de recherche.
- Générateur LLM (pour
AskContexts) : synthétise les contextes récupérés pour générer une réponse finale.
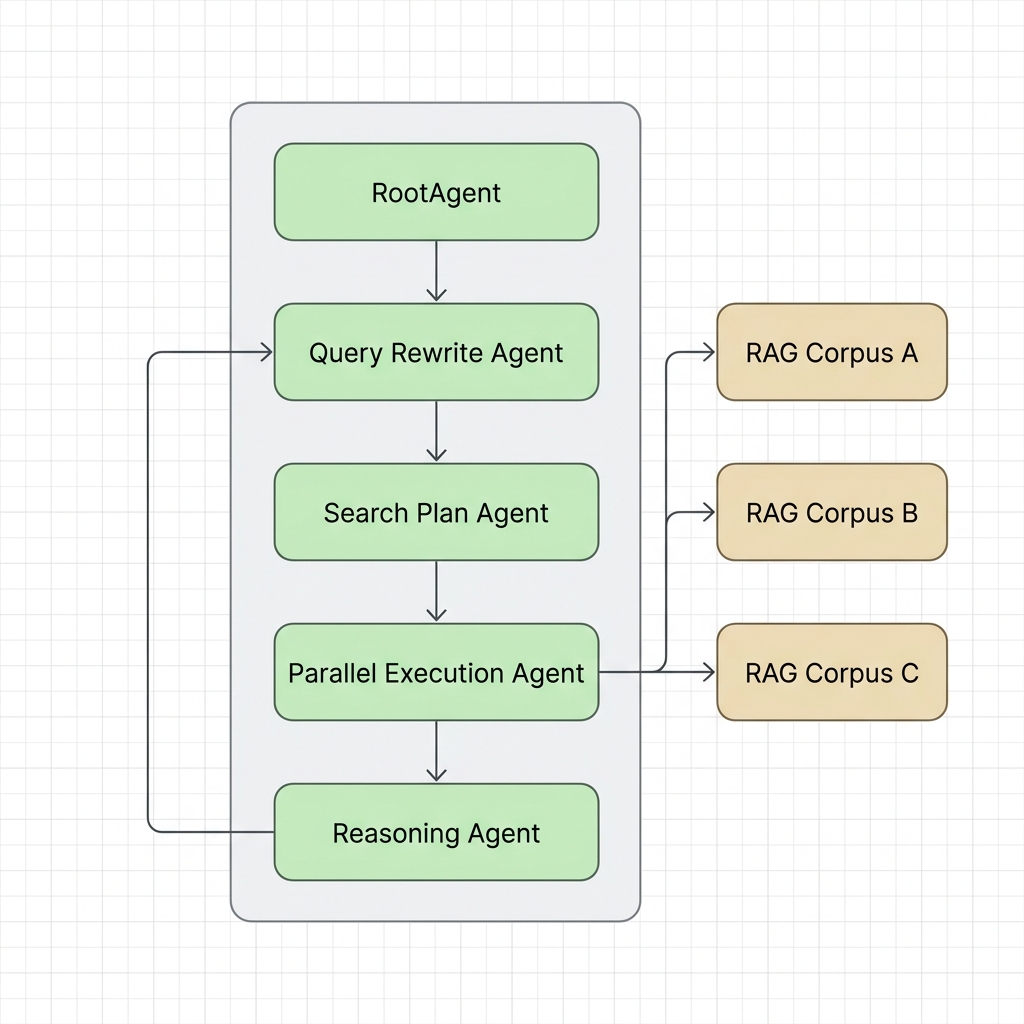
Sélection des corpus
Lorsqu'une requête est exécutée sur plusieurs corpus gérés par RAG, le système doit déterminer quel corpus contient les informations nécessaires pour répondre à la requête. Pour ce faire, il utilise la récupération agentique :
- Mappage des corpus : le système gère un mappage des corpus RAG disponibles ainsi que leurs descriptions techniques (spécifiées dans le champ
descriptiondu corpus RAG). - Correspondance sémantique : un agent de planification stratégique (optimisé par un modèle Gemini) évalue la requête de l'utilisateur par rapport au
descriptionsdes corpus disponibles. - Routage ciblé : le planificateur génère un plan de récupération qui mappe des parties spécifiques de la requête aux corpus les plus pertinents, ce qui garantit que la récupération est ciblée et efficace, plutôt que de rechercher naïvement dans tous les corpus.
Exemples de code
Les exemples de code suivants montrent comment utiliser les API de récupération inter-corpus RAG.
AsyncRetrieveContexts API
Cet exemple de code montre comment récupérer des contextes à partir de plusieurs corpus RAG de manière asynchrone.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Obtenir le résultat de l'opération
Étant donné que AsyncRetrieveContexts est une opération de longue durée, vous pouvez utiliser l'API GetOperations pour interroger le résultat à l'aide de l'ID d'opération.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
API AskContexts
Cet exemple de code montre comment générer directement une réponse en effectuant une recherche synchrone dans plusieurs corpus RAG.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Étapes suivantes
- Pour en savoir plus sur l'API RAG, consultez API du moteur RAG.
- Pour en savoir plus sur les réponses du moteur RAG, consultez Résultats de récupération et de génération du moteur RAG.
- Pour en savoir plus sur le moteur RAG, consultez la présentation du moteur RAG.