


Depois de coletar métricas das
cargas de trabalho implantadas no Google Distributed Cloud (GDC) com isolamento físico, comece
a analisá-las. Para analisar as métricas, é possível visualizá-las e filtrá-las em
painéis informativos do Grafana ou acessá-las diretamente do Cortex usando a ferramenta
curl para scripts e automação flexíveis.
Nesta página, fornecemos instruções detalhadas sobre como consultar e visualizar suas métricas usando a interface do usuário do Grafana e a ferramenta curl para o endpoint do Cortex para receber insights sobre o desempenho da carga de trabalho.
É possível acessar as métricas de duas maneiras:
- Painéis do Grafana: analise tendências e identifique anomalias com visualizações intuitivas de métricas importantes, como uso da CPU, consumo de armazenamento e atividade da rede. O Grafana oferece uma interface fácil de usar para filtrar e analisar os dados da carga de trabalho em painéis.
- Endpoint do Cortex: para casos de uso mais avançados, consulte a instância do Cortex do seu projeto diretamente usando a ferramenta
curlem uma linha de comando. O Cortex armazena as métricas do Prometheus do seu projeto e fornece um endpoint HTTP para acesso programático. Com esse acesso, é possível exportar dados, automatizar tarefas e criar integrações personalizadas.
Antes de começar
Para receber as permissões necessárias para consultar e visualizar métricas nos painéis do Grafana, peça ao administrador da organização do IAM ou ao administrador do projeto do IAM para conceder a você um dos papéis predefinidos de Leitor do Grafana da organização ou Leitor do Grafana do projeto. Dependendo do nível de acesso e das permissões necessárias, é possível receber papéis do Grafana em uma organização ou um projeto.
Como alternativa, para receber as permissões necessárias para consultar métricas do endpoint do Cortex, peça ao administrador do projeto do IAM para conceder a você o papel de Leitor do Prometheus do Project Cortex no namespace do projeto.
A tabela a seguir resume os requisitos de Role para as personas de PA e AO.
| Persona | Objeto | Cluster | Papel | Namespace | Grupo/Usuário | Configuração |
|---|---|---|---|---|---|---|
| PA | grafana | org-admin | project-grafana-viewer |
platform-obs | Grupo | 1 |
| PA | córtex | org-admin | project-cortex-prometheus-viewer |
platform-obs | Grupo | 2 |
| PA | grafana | org-admin | project-grafana-viewer |
platform-obs | Usuário | 3 |
| PA | córtex | org-admin | project-cortex-prometheus-viewer |
platform-obs | Usuário | 4 |
| AO | grafana | org-admin | project-grafana-viewer |
PROJECT_NAMESPACE | Grupo | 1 |
| AO | córtex | org-admin | project-cortex-prometheus-viewer |
PROJECT_NAMESPACE | Grupo | 2 |
| AO | grafana | org-admin | project-grafana-viewer |
PROJECT_NAMESPACE | Usuário | 3 |
| AO | córtex | org-admin | project-cortex-prometheus-viewer |
PROJECT_NAMESPACE | Usuário | 4 |
Substitua as seguintes variáveis:
| Variável | Descrição |
|---|---|
KUBECONFIG |
Você vai precisar do kubeconfig para o cluster específico que contém o NAMESPACE em que esse RoleBinding será aplicado. |
RULE_NAME |
O nome exclusivo desse recurso RoleBinding no namespace. Por exemplo, io-root-cortex-prometheus-viewer. |
NAMESPACE |
O namespace do Kubernetes em que esse RoleBinding será criado e aplicado. Procure a coluna Namespace na tabela anterior. |
EMAIL_ADDRESS |
O identificador do usuário que está recebendo o papel. Geralmente, é um endereço de e-mail. Por exemplo, infrastructure-operator@example.com |
ROLE |
O nome do Role que contém as permissões que você quer conceder ao usuário. Procure os papéis disponíveis na tabela anterior |
GROUP_NAME |
O nome do Group ao qual o usuário de PA/AO pertence. Por exemplo, pa-group. |
ZONE |
Nome da zona |
Configuração 1
Essa configuração concede permissões para um grupo de usuários acessar o Grafana de PA/AO no cluster org. Depois de definir essa configuração, consulte a seção Painéis do Grafana deste documento para ver as métricas no Grafana.
Comando kubectl
Este é o formato de comando genérico:
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n platform-obs --group=`GROUP_NAME` --role=project-grafana-viewerExemplo:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-grafana-viewers-binding --role=project-grafana-viewer --group=my-team --namespace=platform-obsCaminho do arquivo IAC
/infrastructure/zonal/zones/`ZONE`/org-admin/rolebindings/`GROUP_NAME`/<YAML_FILE>Arquivo YAML
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: RULE_NAME
  namespace: platform-obs
subjects:
- kind: Group
  name: GROUP_NAME
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: project-grafana-viewer
  apiGroup: rbac.authorization.k8s.io
Configuração 2
Essa configuração concede permissões a um grupo de usuários para acessar de forma programática as métricas de PA/AO no cluster org. Depois de definir essa configuração, consulte a seção endpoint do Cortex deste documento para consultar as métricas de maneira programática.
Comando kubectl
Este é o formato de comando genérico:
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n platform-obs --group=`GROUP_NAME` --role=project-cortex-prometheus-viewerExemplo:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-cortex-prometheus-viewer-binding --role=project-cortex-prometheus-viewer --group=my-team --namespace=platform-obsCaminho do arquivo IAC
/infrastructure/zonal/zones/`ZONE`/org-admin/rolebindings/`GROUP_NAME`/<YAML_FILE>Arquivo YAML
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: RULE_NAME
  namespace: platform-obs
subjects:
- kind: Group
  name: GROUP_NAME
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: project-cortex-prometheus-viewer
  apiGroup: rbac.authorization.k8s.io
Configuração 3
Essa configuração concede permissões para um usuário acessar o Grafana de PA/AO no cluster org. Depois de definir essa configuração, consulte a seção Painéis do Grafana deste documento para ver as métricas no Grafana.
Comando kubectl
Este é o formato de comando genérico:
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n platform-obs --user=`EMAIL_ADDRESS` --role=project-grafana-viewerExemplo:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-grafana-viewers-binding --role=project-grafana-viewer --user=my-email@example.com --namespace=platform-obsCaminho do arquivo IAC
/infrastructure/zonal/zones/`ZONE`/org-admin/rolebindings/`EMAIL_ADDRESS`/<YAML_FILE>Arquivo YAML
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: RULE_NAME
  namespace: platform-obs
subjects:
- kind: User
  name: EMAIL_ADDRESS
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: project-grafana-viewer
  apiGroup: rbac.authorization.k8s.io
Configuração 4
Essa configuração concede permissões para que um usuário possa acessar de forma programática as métricas de PA/AO no cluster org. Depois de definir essa configuração, consulte a seção endpoint do Cortex deste documento para consultar as métricas de maneira programática.
Comando kubectl
Este é o formato de comando genérico:
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n platform-obs --user=`EMAIL_ADDRESS` --role=project-cortex-prometheus-viewerExemplo:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-cortex-prometheus-viewer-binding --role=project-cortex-prometheus-viewer --user=my-email@example.com --namespace=platform-obsCaminho do arquivo IAC
/infrastructure/zonal/zones/`ZONE`/org-admin/rolebindings/`EMAIL_ADDRESS`/<YAML_FILE>Arquivo YAML
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: RULE_NAME
  namespace: platform-obs
subjects:
- kind: User
  name: EMAIL_ADDRESS
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: project-cortex-prometheus-viewer
  apiGroup: rbac.authorization.k8s.io
Para mais informações sobre esses papéis, consulte Preparar permissões do IAM.
Obter e filtrar suas métricas
Selecione um dos métodos a seguir para criar consultas, visualizar tendências e filtrar métricas das cargas de trabalho do projeto:
Painéis do Grafana
Nesta seção, descrevemos como acessar suas métricas usando os painéis do Grafana.
Identificar o endpoint do Grafana
O URL a seguir é o endpoint da instância do Grafana do seu projeto:
https://GDC_URL/PROJECT_NAMESPACE/grafana
Substitua:
GDC_URL: o URL da sua organização no GDC.PROJECT_NAMESPACE: o namespace do projeto.Por exemplo, o endpoint do Grafana para o projeto
platform-obsna organizaçãoorg-1éhttps://org-1/platform-obs/grafana.
Ver métricas na interface do usuário do Grafana
Recupere as métricas na interface do usuário do Grafana:
- No console do GDC, selecione seu projeto.
- No menu de navegação, selecione Operações > Monitoramento.
Clique em Ver tudo no Grafana.
Uma nova página abre o endpoint do Grafana e exibe a interface do usuário.
Na interface do usuário, clique em Análise Análise no menu de navegação para abrir a página Análise.
No menu da barra Explorar, selecione uma fonte de dados para recuperar métricas, de acordo com o tipo de universo:
Universos de zona única: selecione prometheus para exibir métricas da zona única do seu universo.
Universos de várias zonas: o Grafana pode se conectar a diferentes zonas e mostrar dados entre zonas. Selecione Métricas ZONE_NAME para exibir métricas de qualquer zona do seu universo, independentemente da zona em que você fez login.
Além disso, para ter visualizações de dados entre zonas em um único painel e adicionar várias zonas à consulta, selecione Misto como a fonte de dados.
Insira uma consulta para pesquisar métricas usando expressões PromQL (Prometheus Query Language). Você pode fazer isso de duas maneiras:
- Selecione uma métrica e um rótulo para sua consulta nos menus Métrica e Filtros de rótulo. Clique em add Adicionar para incluir mais rótulos na consulta. Em seguida, clique em Executar consulta.
- Insira sua consulta diretamente no campo de texto Métricas e pressione Shift+Enter para executá-la.
A página mostra as métricas que correspondem à sua consulta.
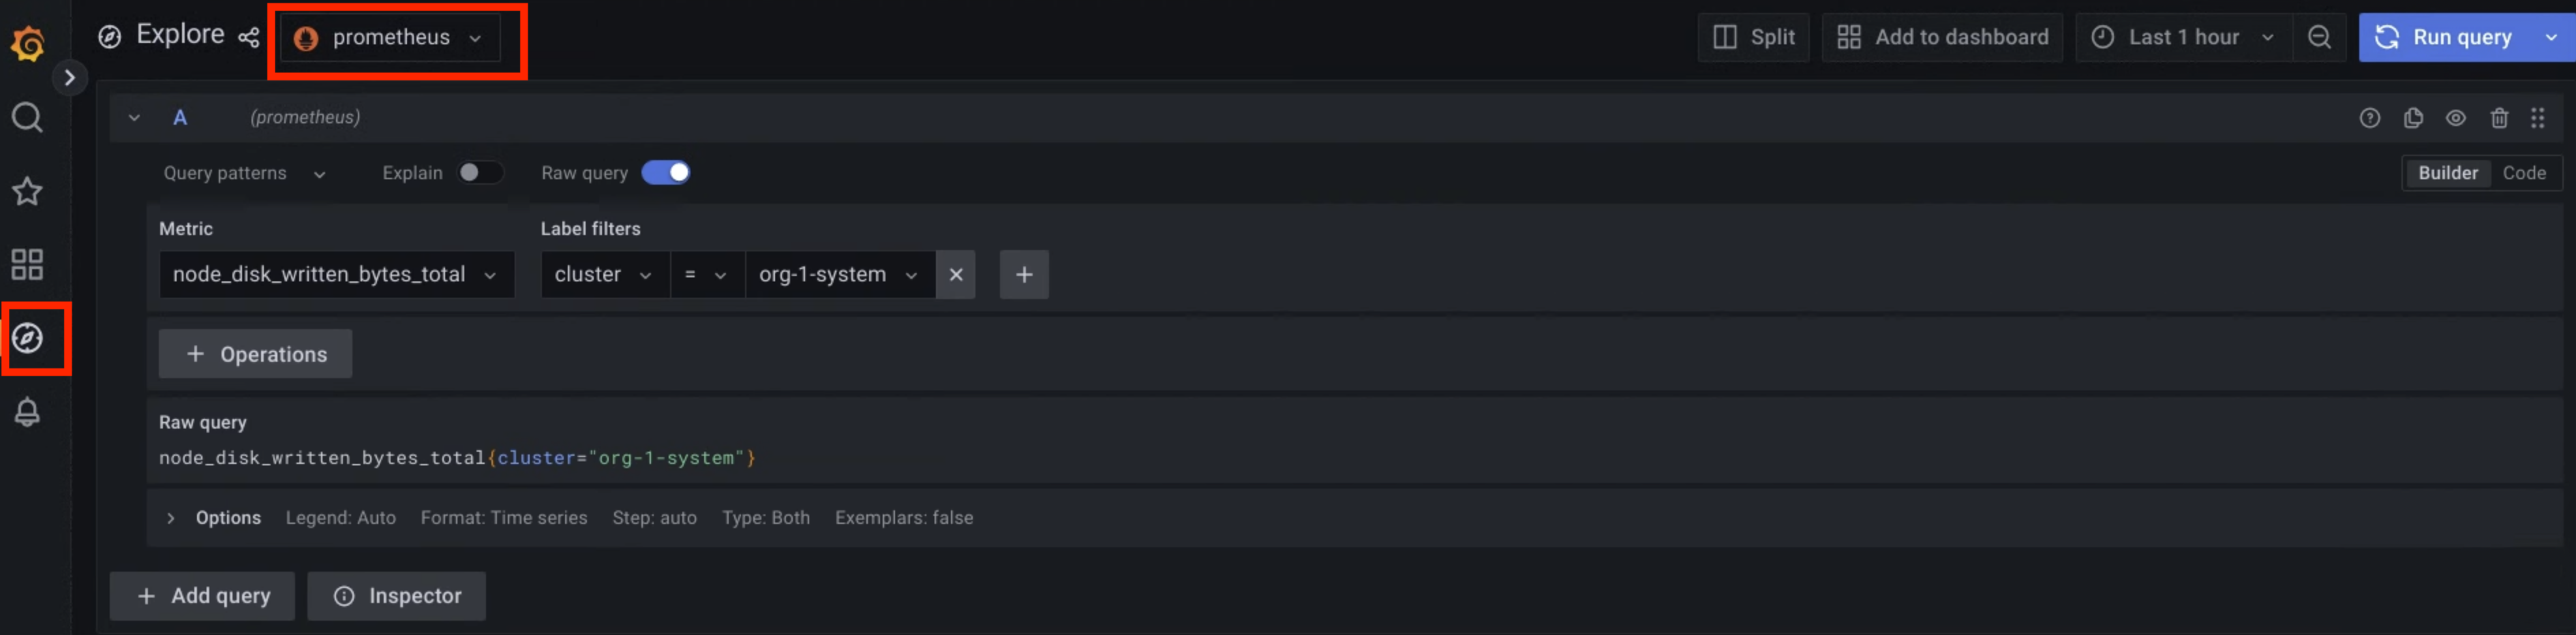
Figura 1. Opção de menu para consultar métricas na interface do usuário do Grafana.
Na figura 1, a opção prometheus exibe a interface que permite criar consultas do Grafana para recuperar métricas.
Para exemplos de valores de rótulos que podem ser usados para consultar métricas, consulte Exemplos de consultas e rótulos.
Endpoint do Cortex: zona única
Nesta seção, descrevemos como acessar suas métricas usando o Cortex.
Identificar o endpoint do Cortex
O URL a seguir é o endpoint da instância do Cortex do seu projeto:
https://GDC_URL/PROJECT_NAMESPACE/cortex/prometheus/
Substitua:
GDC_URL: o URL da sua organização no GDC.PROJECT_NAMESPACE: o namespace do projeto.Por exemplo, o endpoint do Cortex para o projeto
platform-obsna organizaçãoorg-1éhttps://org-1/platform-obs/cortex/prometheus/.
Autenticar a solicitação curl
- Baixe e instale a CLI gdcloud.
Defina a propriedade gdcloud
core/organization_console_url:gdcloud config set core/organization_console_url https://GDC_URLFaça login com o provedor de identidade configurado:
gdcloud auth loginUse seu nome de usuário e senha para autenticar e fazer login.
Quando o login for concluído, use o cabeçalho de autorização na solicitação curl com o comando
gdcloud auth print-identity-token. Para mais informações, consulte gdcloud auth.
Chamar o endpoint do Cortex
Siga estas etapas para acessar o endpoint do Cortex usando a ferramenta
curl:
- Autentique a solicitação
curl. Use
curlpara chamar o endpoint do Cortex e estenda o URL usando o formato de consulta da API HTTP para consultar métricas.Veja a seguir um exemplo de solicitação
curl:curl https://GDC_URL/PROJECT_NAME/cortex/prometheus/api/v1/query?query=my_metric{cluster="my-cluster"}&time=2015-07-01T20:10:51.781Z \ -H "Authorization: Bearer $(gdcloud auth print-identity-token \ --audiences=https://GDC_URL)"Você vai receber a saída após o comando. A resposta da API está no formato JSON.
Endpoint do Cortex: multizona
Nesta seção, descrevemos como acessar suas métricas usando o Cortex.
Identificar o endpoint do Cortex
O URL a seguir é o endpoint da instância do Cortex do seu projeto para consulta multizona:
https://GDC_URL/PROJECT_NAMESPACE/cortex/metrics
Substitua:
GDC_URL: o URL da sua organização no GDC.- Exemplo para org-1, zone1:
console.org-1.zone1.google.gdch.test - Substitua a organização e a zona do aplicativo.
- Exemplo para org-1, zone1:
PROJECT_NAMESPACE: o namespace do projeto.Por exemplo, o endpoint do Cortex para o projeto
project-1na organizaçãoorg-1éhttps://console.org-1.zone1.google.gdch.test/project-1/cortex/metrics..
Autenticar a solicitação curl
- Baixe e instale a CLI gdcloud.
Defina a propriedade gdcloud
core/organization_console_url:gdcloud config set core/organization_console_url https://GDC_URLFaça login com o provedor de identidade configurado:
gdcloud auth loginUse seu nome de usuário e senha para autenticar e fazer login.
Quando o login for concluído, use o cabeçalho de autorização na solicitação curl com o comando
gdcloud auth print-identity-token. Para mais informações, consulte gdcloud auth.
Chamar o endpoint do Cortex
Siga estas etapas para acessar o endpoint do Cortex usando a ferramenta
curl:
- Autentique a solicitação
curl. - Use
curlpara chamar o endpoint do Cortex e estenda o URL usando o formato de consulta da API HTTP para consultar métricas. Além dos parâmetros de consulta de URL do Prometheus, inclua o parâmetro de local para fornecer uma lista de zonas para consulta. - location={string}: lista de zonas separadas por
|- Se não for fornecido, a consulta será executada em todas as zonas disponíveis.Veja a seguir um exemplo de solicitação
curl POST:curl POST \ https://GDC_URL/PROJECT_NAME/cortex/metrics/api/v1/query_range" \ -H 'Content-Type: application/x-www-form-urlencoded' \ --data-urlencode 'query=pod_cpu_usage_total' \ --data-urlencode 'start=2025-07-21T16:00:00Z' \ --data-urlencode 'end=2025-07-21T16:15:00Z' \ --data-urlencode 'step=60s' \ --data-urlencode 'location=zone1|zone2' \ -H "Authorization: Bearer $(gdcloud auth print-identity-token \ --audiences=https://GDC_URL)"Veja a seguir um exemplo de solicitação
curl GET:curl -X GET \ https://GDC_URL/PROJECT_NAME/cortex/metrics/api/v1/query_range?query=pod_cpu_usage_total&start=2025-07-21T16:00:00Z&end=2025-07-21T16:15:00Z&step=1s&location=zone1|zone2" \ -H "Authorization: Bearer $(gdcloud auth print-identity-token \ --audiences=https://GDC_URL)"Você recebe a saída após o comando. A resposta da API está no formato JSON.
Exemplos de consultas e rótulos
É possível consultar métricas usando o nome da métrica e os pares de chave-valor para rótulos. Uma consulta PromQL tem a seguinte sintaxe:
metric_name{label_one="value", label_two="value"}
Os rótulos permitem diferenciar as características de uma métrica. Dessa forma, os autores de contêineres fazem com que as cargas de trabalho gerem métricas e adicionem tags para filtrar essas métricas.
Por exemplo, é possível ter uma métrica api_http_requests_total para contar o
número de solicitações HTTP recebidas. Em seguida, adicione um rótulo request_method a essa métrica, que usa um valor POST, GET ou PUT. Consequentemente, você
cria três fluxos de métricas para cada tipo de solicitação que pode receber. Nesse
caso, para encontrar o número de solicitações HTTP GET, execute a seguinte consulta:
api_http_requests_total{request_method="GET"}
Consulte Nomenclatura de métricas e rótulos para mais informações sobre métricas e rótulos.
Veja a seguir alguns dos rótulos padrão que o recurso personalizado MonitoringTarget adiciona. É possível usar esses rótulos padrão para consultar métricas:
_gdch_service: o nome curto do serviço.cluster: o nome do cluster.container_name: o nome do contêiner em um pod.namespace_name: o namespace do projeto.pod_name: o prefixo do nome do pod.
A tabela a seguir descreve os rótulos que o Prometheus adiciona automaticamente:
| Rótulo da métrica | Descrição |
|---|---|
job |
O nome interno do job de extração usado para coletar a métrica. Os jobs
criados pelo recurso personalizado MonitoringTarget têm um nome
com o seguinte padrão:obs-system/OBS_SHADOW_PROJECT_NAME/MONITORINGTARGET_NAME.MONITORINGTARGET_NAMESPACE/I/JI e J são números exclusivos determinados internamente
para evitar conflitos de nome. |
instance |
O $IP:$PORT do serviço descartado. Se um recurso de carga de trabalho tiver várias réplicas, use esse campo para diferenciá-las. |
O exemplo de código a seguir mostra o uso de pares de chave-valor para rótulos para consultar métricas diferentes e visualizar o uso da CPU coletado em um cluster do Kubernetes:
pod_cpu_usage_total{cluster="CLUSTER_NAME"}
Use a ferramenta de redefinição de rótulos de métricas para adicionar rótulos que não foram expostos inicialmente pelos
contêineres extraídos e renomeie as métricas produzidas. É necessário configurar o recurso personalizado MonitoringTarget para adicionar rótulos às métricas coletadas.
Especifique esses rótulos no campo metricsRelabelings do recurso personalizado.
Para mais informações, consulte
Métricas de rótulo.
Veja a seguir um exemplo de resposta recebida de um endpoint de métricas do Cortex:
          {
    "zone1": {
      "status": "success",
      "data": {
        "resultType": "matrix",
        "result": [
          {
            "metric": {
              "__name__": "pod_cpu_usage_total",
              "_gdch_project": "project-1",
              "cluster": "root-admin",
              "container_name": "otel-collector",
              "exported_instance": "localhost:2112",
              "exported_job": "workload-0",
              "ha_cluster": "root-admin-shard1",
              "instance": "172.192.1.74:3113",
              "job": "metrics-server-exporter.mon-system",
              "namespace": "mon-system",
              "namespace_name": "mon-system",
              "pod": "cortex-0",
              "pod_name": "metrics-server-exporter-695c9f848b-swzgq",
              "zone_id": "zone1"
            },
            "values": [
              [
                1753261200,
                "2.258621991"
              ],
              [
                1753261800,
                "1.029301454"
              ]
            ]
          }
        ]
      }
    },
    "zone2": {
      "status": "success",
      "data": {
        "resultType": "matrix",
        "result": [
          {
            "metric": {
              "__name__": "pod_cpu_usage_total",
              "_gdch_project": "project-1",
              "cluster": "root-admin",
              "container_name": "otel-collector",
              "exported_instance": "localhost:2112",
              "exported_job": "workload-0",
              "ha_cluster": "root-admin-shard1",
              "instance": "172.196.3.208:3113",
              "job": "metrics-server-exporter.mon-system",
              "namespace": "mon-system",
              "namespace_name": "mon-system",
              "pod": "cortex-0",
              "pod_name": "metrics-server-exporter-695c9f848b-kchfv",
              "zone_id": "zone2"
            },
            "values": [
              [
                1753261200,
                "1.814027424"
              ],
              [
                1753261800,
                "2.7767060260000003"
              ]
            ]
          }
        ]
      }
    }
  }
Como consultar a API HTTP
Visão geral do formato
As respostas da API são formatadas de forma consistente em JSON. As solicitações bem-sucedidas sempre recebem um código de status 2xx.
Para solicitações inválidas, os gerenciadores de API retornam um objeto de erro JSON com um dos seguintes códigos de status HTTP:
- 400 Bad Request: se os parâmetros essenciais estiverem ausentes ou forem fornecidos incorretamente.
- 503 Serviço indisponível: se as consultas excederem o limite de tempo ou forem canceladas.
Todos os dados coletados serão incluídos no campo "data" da resposta.
O formato do envelope de resposta JSON é o seguinte:
{
  "status": "success" | "error",
  "data": <data>,

  // Only set if status is "error". The data field may still hold
  // additional data.
  "errorType": "<string>",
  "error": "<string>",

  // Only set if there were warnings while executing the request.
  // There will still be data in the data field.
  "warnings": ["<string>"],
  // Only set if there were info-level annotations while executing the request.
  "infos": ["<string>"]
}
Consultas instantâneas
O endpoint a seguir avalia uma consulta instantânea em um único momento:
GET /api/v1/query
POST /api/v1/query
Os seguintes parâmetros de consulta de URL estão disponíveis para consultas de expressão do Prometheus:
query=<string>: a string de consulta da expressão do Prometheus.time=<rfc3339 | unix_timestamp>: um carimbo de data/hora de avaliação opcional, especificado como uma string RFC 3339 ou um carimbo de data/hora Unix. Se omitido, o horário atual do servidor será usado.timeout=<duration>: um tempo limite de avaliação opcional. O padrão é o valor da flag query.timeout, que também limita o valor de query.timeout.limit=<number>: um número máximo opcional de séries a serem retornadas. Isso trunca séries para matrizes e vetores, mas não afeta escalares ou strings. O valor 0 desativa esse limite.lookback_delta=<number>: um parâmetro opcional para substituir o período de lookback especificamente para essa consulta.
O horário atual do servidor será usado se o parâmetro de horário for omitido.
Para consultas maiores que podem exceder os limites de caracteres do URL, envie esses parâmetros usando o método POST. Verifique se o corpo da solicitação está codificado por URL e se o cabeçalho Content-Type está definido como application/x-www-form-urlencoded.
A seção de dados do resultado da consulta tem o seguinte formato:
{
  "resultType": "matrix" | "vector" | "scalar" | "string",
  "result": <value>
}
<value> se refere aos dados do resultado da consulta, que têm formatos variados dependendo do resultType.
O exemplo a seguir avalia a expressão up no horário 2015-07-01T20:10:51.781Z:
curl 'http://localhost:9090/api/v1/query?query=up&time=2015-07-01T20:10:51.781Z'
{
   "status" : "success",
   "data" : {
      "resultType" : "vector",
      "result" : [
         {
            "metric" : {
               "__name__" : "up",
               "job" : "prometheus",
               "instance" : "localhost:9090"
            },
            "value": [ 1435781451.781, "1" ]
         },
         {
            "metric" : {
               "__name__" : "up",
               "job" : "node",
               "instance" : "localhost:9100"
            },
            "value" : [ 1435781451.781, "0" ]
         }
      ]
   }
}
Consultas de intervalo
O endpoint a seguir avalia uma consulta de expressão em um período:
GET /api/v1/query_range
POST /api/v1/query_range
Os seguintes parâmetros de consulta de URL estão disponíveis para consultas de expressão do Prometheus:
query=<string>: a string de consulta da expressão do Prometheus.start=<rfc3339 | unix_timestamp>: carimbo de data/hora de início, inclusive.end=<rfc3339 | unix_timestamp>: carimbo de data/hora de término, inclusive.step=<duration | float>: largura da etapa de resolução da consulta no formato de duração ou número flutuante de segundos.timeout=<duration>: um tempo limite de avaliação opcional. O padrão é o valor da flag query.timeout, que também limita o valor de query.timeout.limit=<number>: um número máximo opcional de séries a serem retornadas. Isso trunca séries para matrizes e vetores, mas não afeta escalares ou strings. O valor 0 desativa esse limite.lookback_delta=<number>: um parâmetro opcional para substituir o período de lookback especificamente para essa consulta.
Para consultas maiores que podem exceder os limites de caracteres do URL, envie esses parâmetros usando o método POST. Verifique se o corpo da solicitação está codificado por URL e se o cabeçalho Content-Type está definido como application/x-www-form-urlencoded.
A seção de dados do resultado da consulta tem o seguinte formato:
{
  "resultType": "matrix",
  "result": <value>
}
O exemplo a seguir avalia a expressão up em um intervalo de 30 segundos com uma resolução de consulta de 15 segundos.
curl 'http://localhost:9090/api/v1/query_range?query=up&start=2015-07-01T20:10:30.781Z&end=2015-07-01T20:11:00.781Z&step=15s'
{
   "status" : "success",
   "data" : {
      "resultType" : "matrix",
      "result" : [
         {
            "metric" : {
               "__name__" : "up",
               "job" : "prometheus",
               "instance" : "localhost:9090"
            },
            "values" : [
               [ 1435781430.781, "1" ],
               [ 1435781445.781, "1" ],
               [ 1435781460.781, "1" ]
            ]
         },
         {
            "metric" : {
               "__name__" : "up",
               "job" : "node",
               "instance" : "localhost:9091"
            },
            "values" : [
               [ 1435781430.781, "0" ],
               [ 1435781445.781, "0" ],
               [ 1435781460.781, "1" ]
            ]
         }
      ]
   }
}
Nomenclatura de métricas e rótulos
Diretrizes de nomenclatura de métricas
Ao definir nomes de métricas, considere os seguintes princípios:
O nome de uma métrica DEVE incluir um prefixo de aplicativo de uma única palavra, que as bibliotecas de cliente às vezes chamam de "namespace". Esse prefixo identifica o domínio a que a métrica pertence. Para métricas específicas do aplicativo, o nome do aplicativo geralmente é usado como prefixo.
Exemplos:
- prometheus_notifications_total (específico do servidor do Prometheus)
- process_cpu_seconds_total (exportado por muitas bibliotecas de cliente)
- http_request_duration_seconds (para todas as solicitações HTTP)
O nome de uma métrica PRECISA representar uma única unidade (por exemplo, evite misturar segundos com milissegundos ou segundos com bytes).
O nome de uma métrica DEVE usar unidades de base (por exemplo, segundos, bytes, metros) em vez de unidades derivadas (por exemplo, milissegundos, megabytes, quilômetros).
O nome de uma métrica PRECISA incluir um sufixo de unidade no plural. Para contagens acumuladas, o sufixo "total" precisa ser usado além do sufixo da unidade, se aplicável.
Exemplos:
- http_request_duration_seconds
- node_memory_usage_bytes
- http_requests_total (para uma contagem cumulativa sem unidade)
- process_cpu_seconds_total (para uma contagem acumulada com unidade)
- foobar_build_info (para uma pseudométrica que fornece metadados sobre o binário em execução)
Um nome de métrica PODE ordenar os componentes para facilitar o agrupamento quando classificado lexicograficamente, desde que todas as outras regras sejam seguidas. As métricas relacionadas geralmente têm componentes de nome comuns colocados primeiro para garantir que sejam classificadas juntas.
Exemplos:
- prometheus_tsdb_head_truncations_closed_total
- prometheus_tsdb_head_truncations_established_total
- prometheus_tsdb_head_truncations_failed_total
- prometheus_tsdb_head_truncations_total
O nome de uma métrica DEVE representar de forma consistente a mesma "coisa sendo medida" lógica em todas as dimensões de rótulo.
Exemplos:
- duração da solicitação
- bytes de transferência de dados
- uso instantâneo de recursos como uma porcentagem
Diretrizes de nomenclatura de rótulos
Ao medir algo, use rótulos para distinguir as características. Exemplo:
- Para o total de solicitações HTTP da API (
api_http_requests_total), diferencie por tipo de operação, por exemplo,create,update,delete(tipos de solicitação:operation="create|update|delete"). - Para a duração da solicitação de API em segundos (
api_request_duration_seconds), diferencie por estágio da solicitação, por exemplo,extract,transform,load(estágios da solicitação:stage="extract|transform|load").
Evite incluir nomes de rótulos no próprio nome da métrica, porque isso cria redundância e pode causar confusão se esses rótulos forem agregados posteriormente.