


Descripción general
El servidor de historial persistente (PHS) de Managed Service para Apache Spark proporciona interfaces web para ver el historial de trabajos que se ejecutan en clústeres activos o borrados de Managed Service para Apache Spark. Está disponible en la versión de imagen 1.5 y posteriores de Managed Service para Apache Spark, y se ejecuta en un clúster de Managed Service para Apache Spark de un solo nodo. Proporciona interfaces web para los siguientes archivos y datos:
Archivos del historial de trabajos de MapReduce y Spark
Archivos del historial de trabajos de Flink (consulta Componente opcional de Flink de Dataproc para crear un clúster de Managed Service para Apache Spark y ejecutar trabajos de Flink)
Archivos de datos de Application Timeline creados por el servicio de Timeline de YARN v2 y almacenados en una instancia de Bigtable.
Registros de agregación de YARN
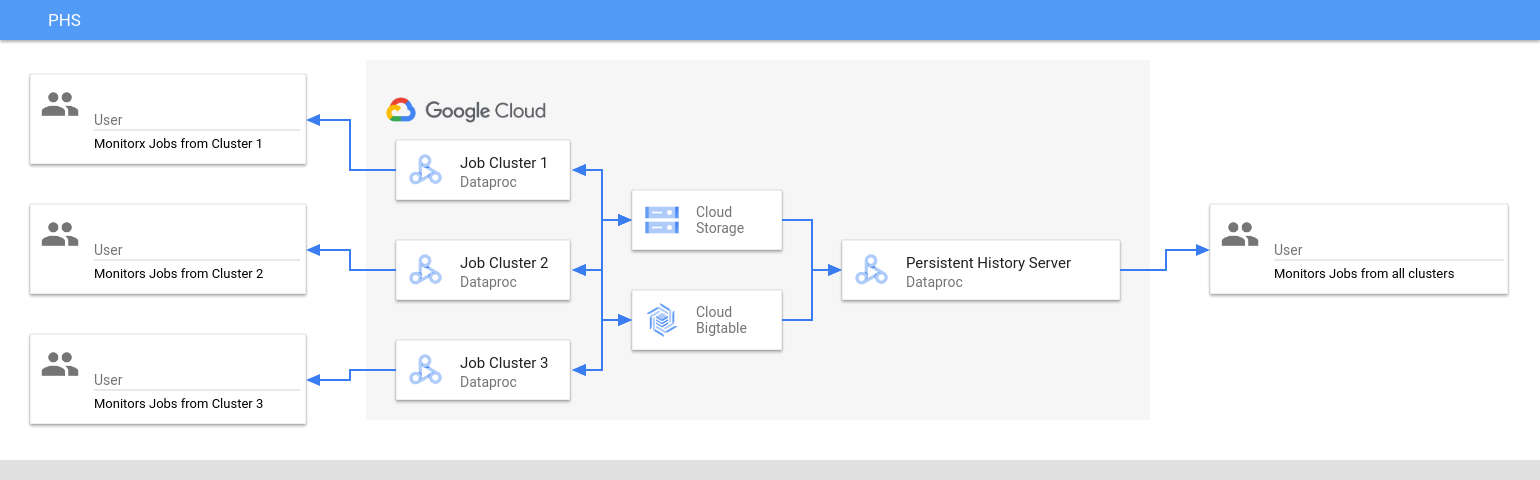
El servidor de historial persistente accede a los archivos del historial de trabajos de Spark y MapReduce, los archivos del historial de trabajos de Flink y los archivos de registro de YARN escritos en Cloud Storage durante el ciclo de vida de los clústeres de trabajos de Managed Service para Apache Spark, y los muestra.
Limitaciones
La versión de la imagen del clúster de PHS y la versión de la imagen de los clústeres de trabajos de Managed Service para Apache Spark deben coincidir. Por ejemplo, puedes usar un clúster de PHS de la versión de imagen 2.0 de Managed Service para Apache Spark para ver los archivos del historial de trabajos que se ejecutaron en clústeres de trabajos de la versión de imagen 2.0 de Managed Service para Apache Spark que se encontraban en el proyecto en el que se encuentra el clúster de PHS.
Un clúster de PHS no admite Kerberos ni la autenticación personal.
Crea un clúster de PHS de Managed Service para Apache Spark
Puedes ejecutar el siguiente comando
gcloud dataproc clusters create
en una terminal local o en
Cloud Shell con las siguientes marcas y
propiedades del clúster
para crear un clúster de un solo nodo del servidor de historial persistente de Managed Service para Apache Spark.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME: Especifica el nombre del clúster de PHS.
- PROJECT: Especifica el proyecto que se asociará con el clúster de PHS. Este proyecto debe ser el mismo que el asociado con el clúster que ejecuta tus trabajos (consulta Crea un clúster de trabajos de Dataproc).
- REGION: Especifica una región de Compute Engine en la que se ubicará el clúster de PHS.
--single-node: Un clúster de PHS es un clúster de nodo único de Dataproc.--enable-component-gateway: Esta marca habilita las interfaces web de la puerta de enlace de componentes en el clúster de PHS.- COMPONENT: Usa esta marca para instalar uno o más
componentes opcionales
en el clúster. Debes especificar el componente opcional
FLINKpara ejecutar el servicio web de HistoryServer de Flink en el clúster de PHS y ver los archivos del historial de trabajos de Flink. - PROPERTIES: Especifica una o más propiedades del clúster.
De manera opcional, agrega la marca --image-version para especificar la versión de la imagen del clúster de PHS. La versión de la imagen del PHS debe coincidir con la versión de la imagen de los clústeres de trabajos de Managed Service para Apache Spark. Consulta Limitaciones.
Notas:
- En los ejemplos de valores de propiedad de esta sección, se usa un carácter comodín "*" para permitir que el PHS coincida con varios directorios en el bucket especificado en el que escriben diferentes clústeres de trabajos (pero consulta Consideraciones sobre la eficiencia de los comodines).
- En los siguientes ejemplos, se muestran marcas
--propertiesseparadas para facilitar la legibilidad. La práctica recomendada cuando se usagcloud dataproc clusters createpara crear un clúster de Managed Service para Apache Spark es usar una marca--propertiespara especificar una lista de propiedades separadas por comas (consulta Formato de las propiedades del clúster).
Propiedades:
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: Agrega esta propiedad para especificar la ubicación de Cloud Storage en la que el PHS accederá a los registros de YARN escritos por los clústeres de trabajos.spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: Agrega esta propiedad para habilitar el historial persistente de trabajos de Spark. Esta propiedad especifica la ubicación en la que el PHS accederá a los registros del historial de trabajos de Spark escritos por los clústeres de trabajos.En los clústeres de Managed Service para Apache Spark 2.0 y versiones posteriores, también se deben establecer las siguientes dos propiedades para habilitar los registros del historial de Spark de PHS (consulta Opciones de configuración del servidor de historial de Spark). El valor
spark.history.custom.executor.log.urles un valor literal que contiene {{MARCADORES DE POSICIÓN}} para las variables que establecerá el servidor de historial persistente. Los usuarios no establecen estas variables. Pasa el valor de la propiedad como se muestra.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: Agrega esta propiedad para habilitar el historial de trabajos de MapReduce persistente. Esta propiedad especifica la ubicación de Cloud Storage en la que el PHS accederá a los registros del historial de trabajos de MapReduce escritos por los clústeres de trabajos.dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: Después de configurar Yarn Timeline Service v2, agrega esta propiedad para usar el clúster de PHS para ver los datos de Rutas en las interfaces web de YARN Application Timeline Service V2 y Tez (consulta Interfaces web de la puerta de enlace de componentes).flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: Usa esta propiedad para configurar elHistoryServerde Flink para supervisar una lista de directorios separados por comas.
Ejemplos de propiedades:
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
Crea un clúster de trabajos de Managed Service para Apache Spark
Puedes ejecutar el siguiente comando en una terminal local o en Cloud Shell para crear un clúster de trabajos de Managed Service para Apache Spark que ejecute trabajos y escriba archivos de historial de trabajos en un servidor de historial persistente (PHS).
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME: Especifica el nombre del clúster de trabajos.
- PROJECT: Especifica el proyecto asociado con el clúster de trabajos.
- REGION: Especifica la región de Compute Engine en la que se ubicará el clúster de trabajos.
--enable-component-gateway: Esta marca habilita las interfaces web de la puerta de enlace de componentes en el clúster de trabajos.- COMPONENT: Usa esta marca para instalar uno o más
componentes opcionales
en el clúster. Especifica el componente opcional
FLINKpara ejecutar trabajos de Flink en el clúster. PROPERTIES: Agrega una o más de las siguientes propiedades del clúster para establecer ubicaciones de Cloud Storage no predeterminadas relacionadas con el PHS y otras propiedades del clúster de trabajos.
Notas:
- En los ejemplos de valores de propiedad de esta sección, se usa un carácter comodín "*" para permitir que el PHS coincida con varios directorios en el bucket especificado en el que escriben diferentes clústeres de trabajos (pero consulta Consideraciones sobre la eficiencia de los comodines).
- En los siguientes ejemplos, se muestran marcas
--propertiesseparadas para facilitar la legibilidad. La práctica recomendada cuando se usagcloud dataproc clusters createpara crear un clúster de Managed Service para Apache Spark es usar una marca--propertiespara especificar una lista de propiedades separadas por comas (consulta Formato de las propiedades del clúster).
Propiedades:
yarn:yarn.nodemanager.remote-app-log-dir: De forma predeterminada, los registros de YARN agregados están habilitados en los clústeres de trabajos de Managed Service para Apache Spark y se escriben en el bucket temporal del clúster. Agrega esta propiedad para especificar una ubicación de Cloud Storage diferente en la que el clúster escribirá registros de agregación para que el servidor del historial persistente acceda a ellos.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
spark:spark.history.fs.logDirectoryyspark:spark.eventLog.dir: De forma predeterminada, los archivos del historial de trabajos de Spark se guardan en eltemp bucketdel clúster, en el directorio/spark-job-history. Puedes agregar estas propiedades para especificar diferentes ubicaciones de Cloud Storage para estos archivos. Si se usan ambas propiedades, deben apuntar a directorios en el mismo bucket.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
mapred:mapreduce.jobhistory.done-dirymapred:mapreduce.jobhistory.intermediate-done-dir: De forma predeterminada, los archivos del historial de trabajos de MapReduce se guardan en eltemp bucketdel clúster en los directorios/mapreduce-job-history/doney/mapreduce-job-history/intermediate-done. La ubicación intermedia demapreduce.jobhistory.intermediate-done-dires un almacenamiento temporal; los archivos intermedios se mueven a la ubicación demapreduce.jobhistory.done-dircuando se completa el trabajo de MapReduce. Puedes agregar estas propiedades para especificar diferentes ubicaciones de Cloud Storage para estos archivos. Si se usan ambas propiedades, deben apuntar a directorios en el mismo bucket.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
spark:spark.history.fs.gs.outputstream.type: Esta propiedad se aplica a los clústeres de versión de imagen2.0y2.1que usan la versión2.0.xdel conector de Cloud Storage (la versión predeterminada del conector para los clústeres de versión de imagen2.0y2.1). Controla cómo los trabajos de Spark envían datos a Cloud Storage. La configuración predeterminada esBASIC, que envía datos a Cloud Storage después de que se completa el trabajo. Cuando se establece enFLUSHABLE_COMPOSITE, los datos se copian en Cloud Storage a intervalos regulares mientras se ejecuta el trabajo, según lo establecido porspark:spark.history.fs.gs.outputstream.sync.min.interval.ms.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: Esta propiedad se aplica a los clústeres de versión de imagen2.0y2.1que usan la versión2.0.xdel conector de Cloud Storage (la versión predeterminada del conector para los clústeres de versión de imagen2.0y2.1). Controla la frecuencia en milisegundos con la que se transfieren los datos a Cloud Storage cuandospark:spark.history.fs.gs.outputstream.typese establece enFLUSHABLE_COMPOSITE. El intervalo de tiempo predeterminado es5000ms. El valor del intervalo de tiempo en milisegundos se puede especificar con o sin agregar el sufijoms.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
spark:spark.history.fs.gs.outputstream.sync.min.interval: Esta propiedad se aplica a los clústeres con la versión de imagen2.2y posteriores que usan la versión3.0.xdel conector de Cloud Storage (la versión predeterminada del conector para los clústeres con la versión de imagen2.2). Reemplaza la propiedadspark:spark.history.fs.gs.outputstream.sync.min.interval.msanterior y admite valores con sufijo de tiempo, comoms,sym. Controla la frecuencia con la que se transfieren los datos a Cloud Storage cuandospark:spark.history.fs.gs.outputstream.typese establece enFLUSHABLE_COMPOSITE.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
dataproc:yarn.atsv2.bigtable.instance: Después de configurar el servicio de línea de tiempo de Yarn v2, agrega esta propiedad para escribir datos de Rutas de la línea de tiempo de YARN en la instancia de Bigtable especificada para verlos en las interfaces web YARN Application Timeline Service V2 y Tez del clúster de PHS. Nota: La creación del clúster fallará si la instancia de Bigtable no existe.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
flink:jobhistory.archive.fs.dir: El JobManager de Flink archiva los trabajos de Flink completados subiendo la información de los trabajos archivados a un directorio del sistema de archivos. Usa esta propiedad para establecer el directorio de archivo enflink-conf.yaml.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
Usa PHS con cargas de trabajo por lotes de Spark
Para usar el servidor de historial persistente con Managed Service para Apache Spark Serverless para las cargas de trabajo por lotes de Spark, haz lo siguiente:
Selecciona o especifica el clúster de PHS cuando envíes una carga de trabajo por lotes de Spark.
Usa PHS con Managed Service para Apache Spark en Google Kubernetes Engine
Para usar el servidor de historial persistente con Managed Service para Apache Spark en GKE, haz lo siguiente:
Selecciona o especifica el clúster de PHS cuando crees un clúster virtual de Managed Service para Apache Spark en GKE.
Interfaces web de la puerta de enlace de componentes
En la consola de Google Cloud , en la página Clústeres de Managed Service para Apache Spark, haz clic en el nombre del clúster de PHS para abrir la página Detalles del clúster. En la pestaña Interfaces web, selecciona los vínculos de la puerta de enlace de componentes para abrir las interfaces web que se ejecutan en el clúster de PHS.

Interfaz web del servidor de historial de Spark
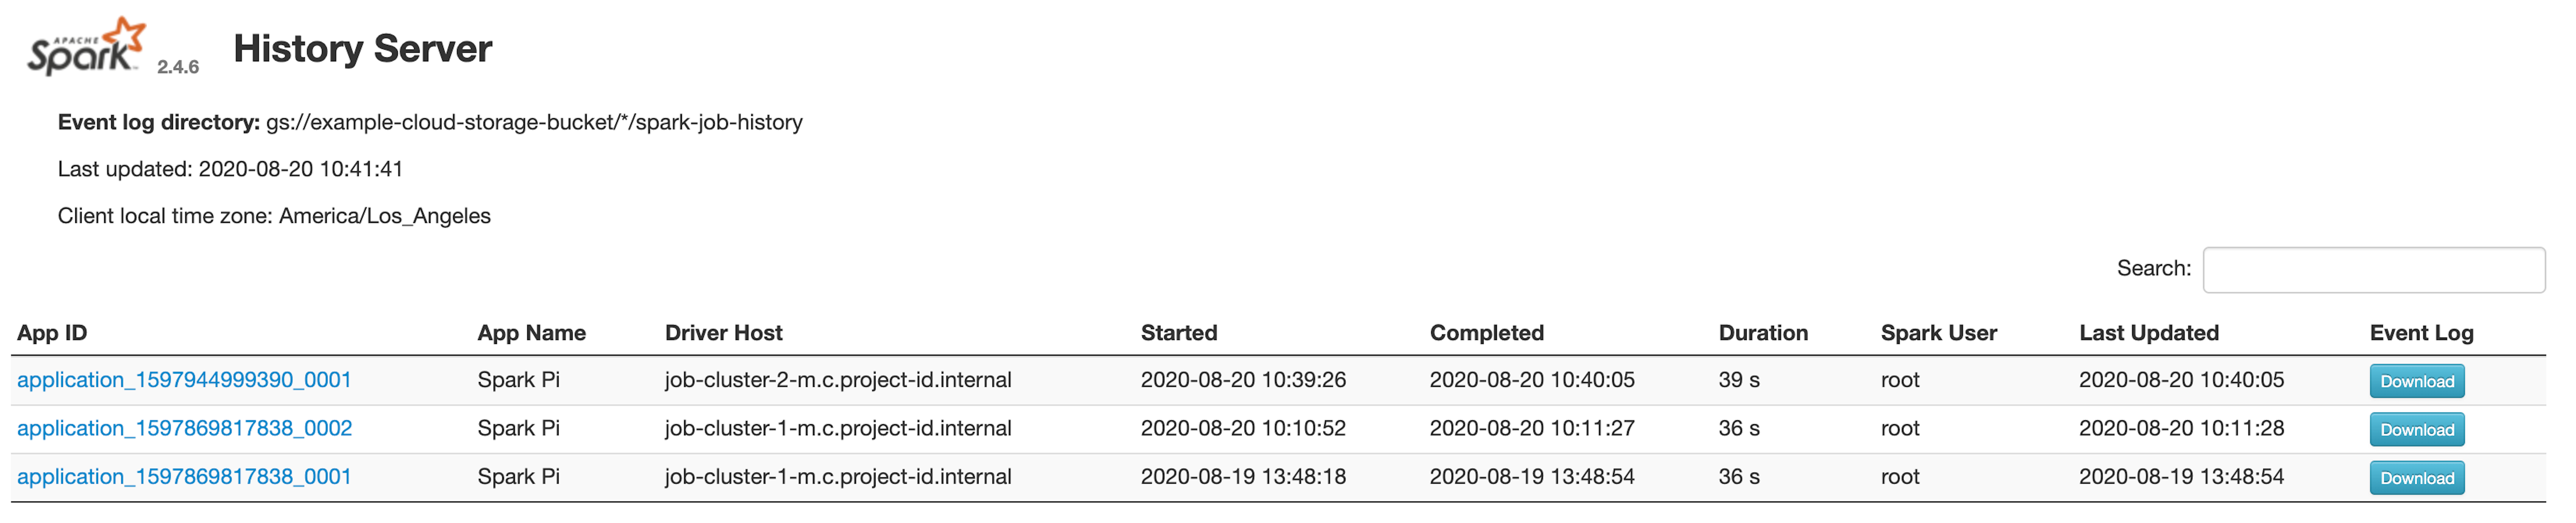
En la siguiente captura de pantalla, se muestra la interfaz web del servidor del historial de Spark con vínculos
a los trabajos de Spark que se ejecutan en job-cluster-1 y job-cluster-2 después de configurar
las ubicaciones de spark.history.fs.logDirectory y spark:spark.eventLog.dir de los clústeres de trabajos
y spark.history.fs.logDirectory del clúster de PHS de la siguiente manera:
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |
Búsqueda del nombre de la aplicación
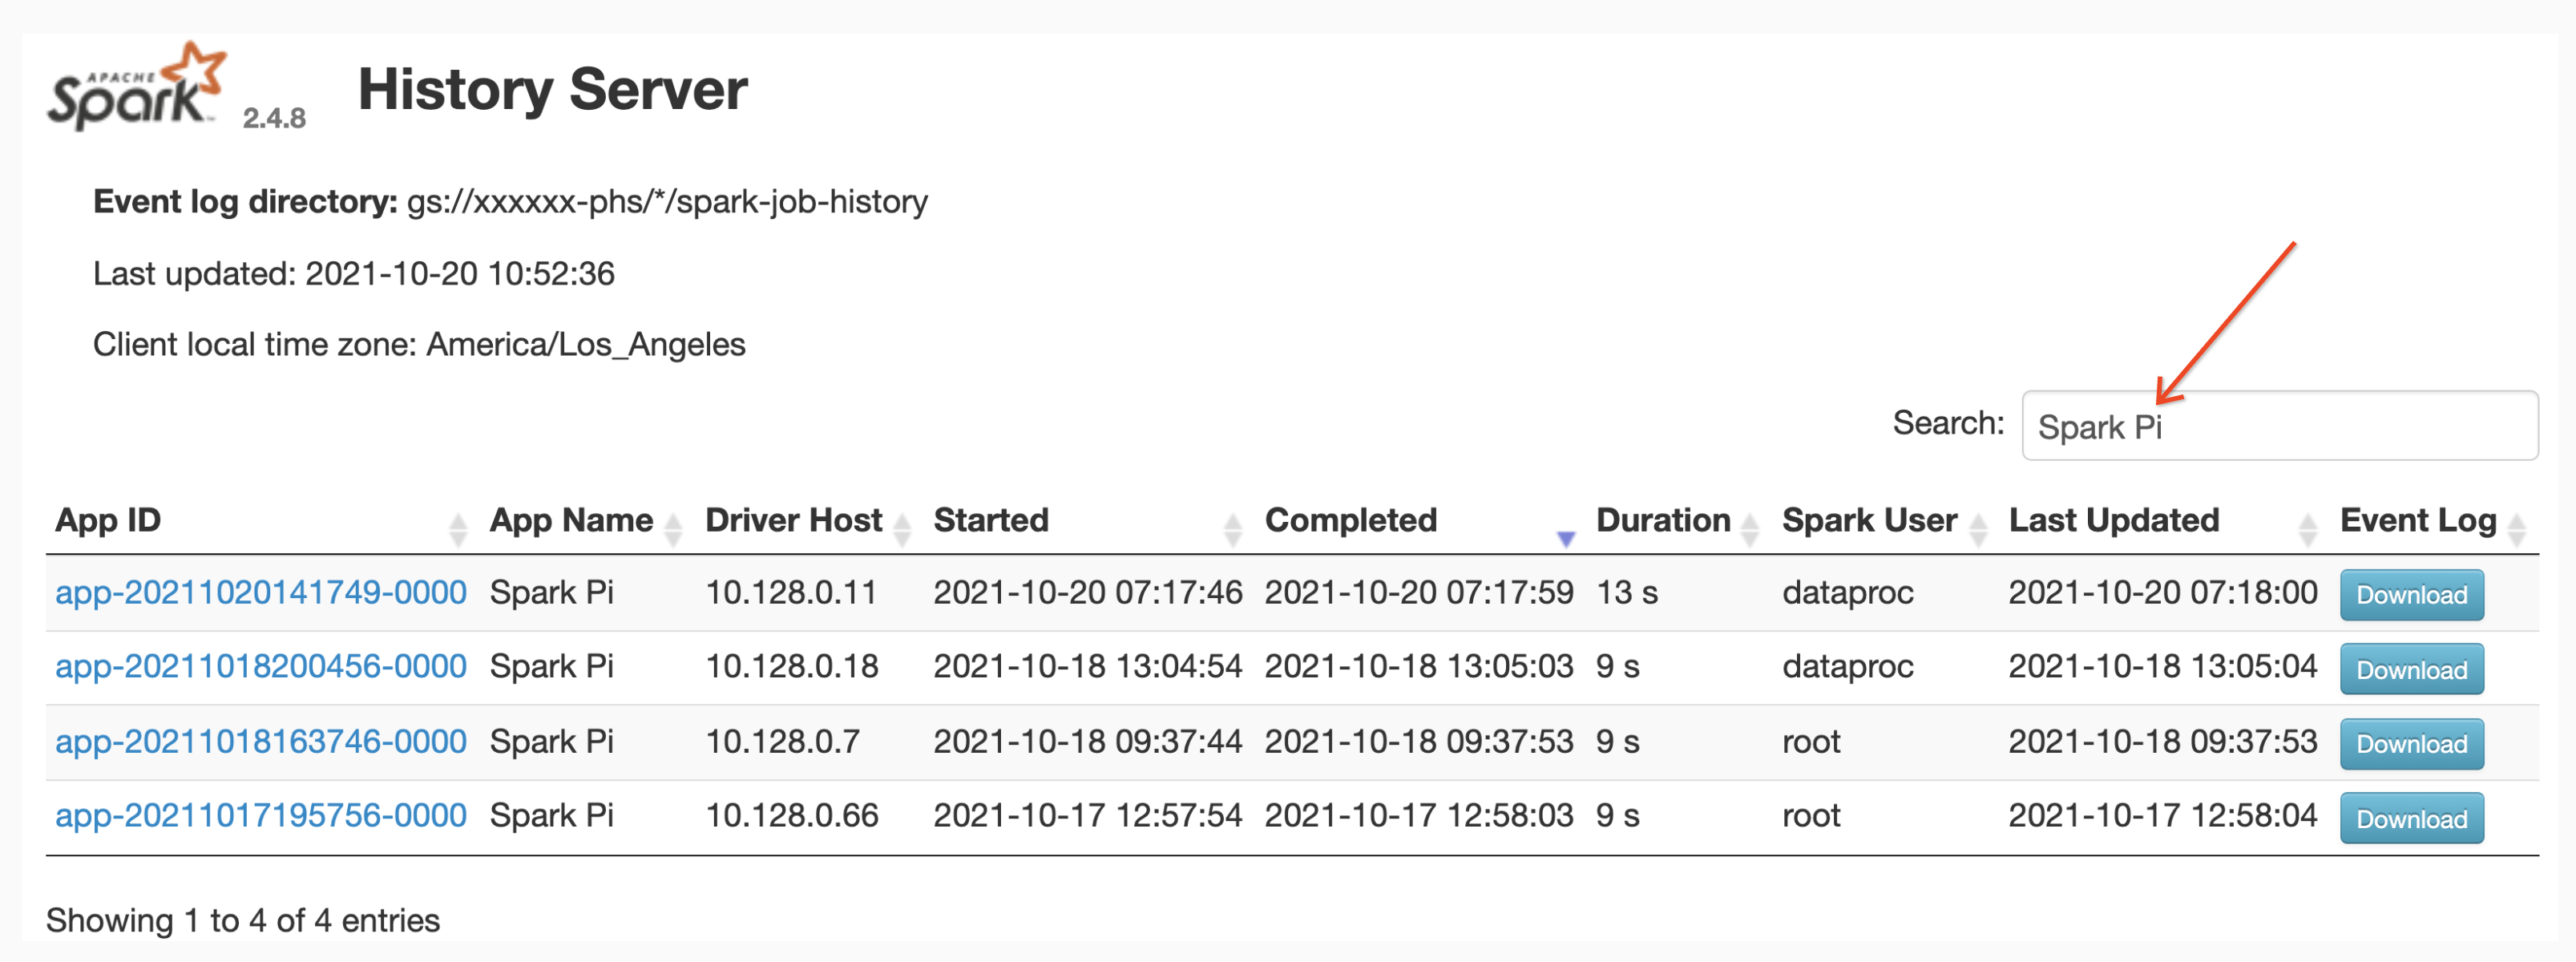
Puedes enumerar los trabajos por nombre de la app en la interfaz web del servidor de historial de Spark. Para ello, ingresa el nombre de una app en el cuadro de búsqueda. El nombre de la app se puede establecer de una de las siguientes maneras (enumeradas por prioridad):
- Configurar dentro del código de la aplicación cuando se crea el contexto de Spark
- Se establece con la propiedad spark.app.name cuando se envía el trabajo.
- Establecido por Managed Service para Apache Spark en el nombre completo del recurso de REST para
el trabajo (
projects/project-id/regions/region/jobs/job-id)
Los usuarios pueden ingresar un término de nombre de app o recurso en el cuadro Buscar para encontrar y enumerar trabajos.
Registros de eventos
La interfaz web del servidor de historial de Spark proporciona un botón Registro de eventos en el que puedes hacer clic para descargar los registros de eventos de Spark. Estos registros son útiles para examinar el ciclo de vida de la aplicación de Spark.
Trabajos de Spark
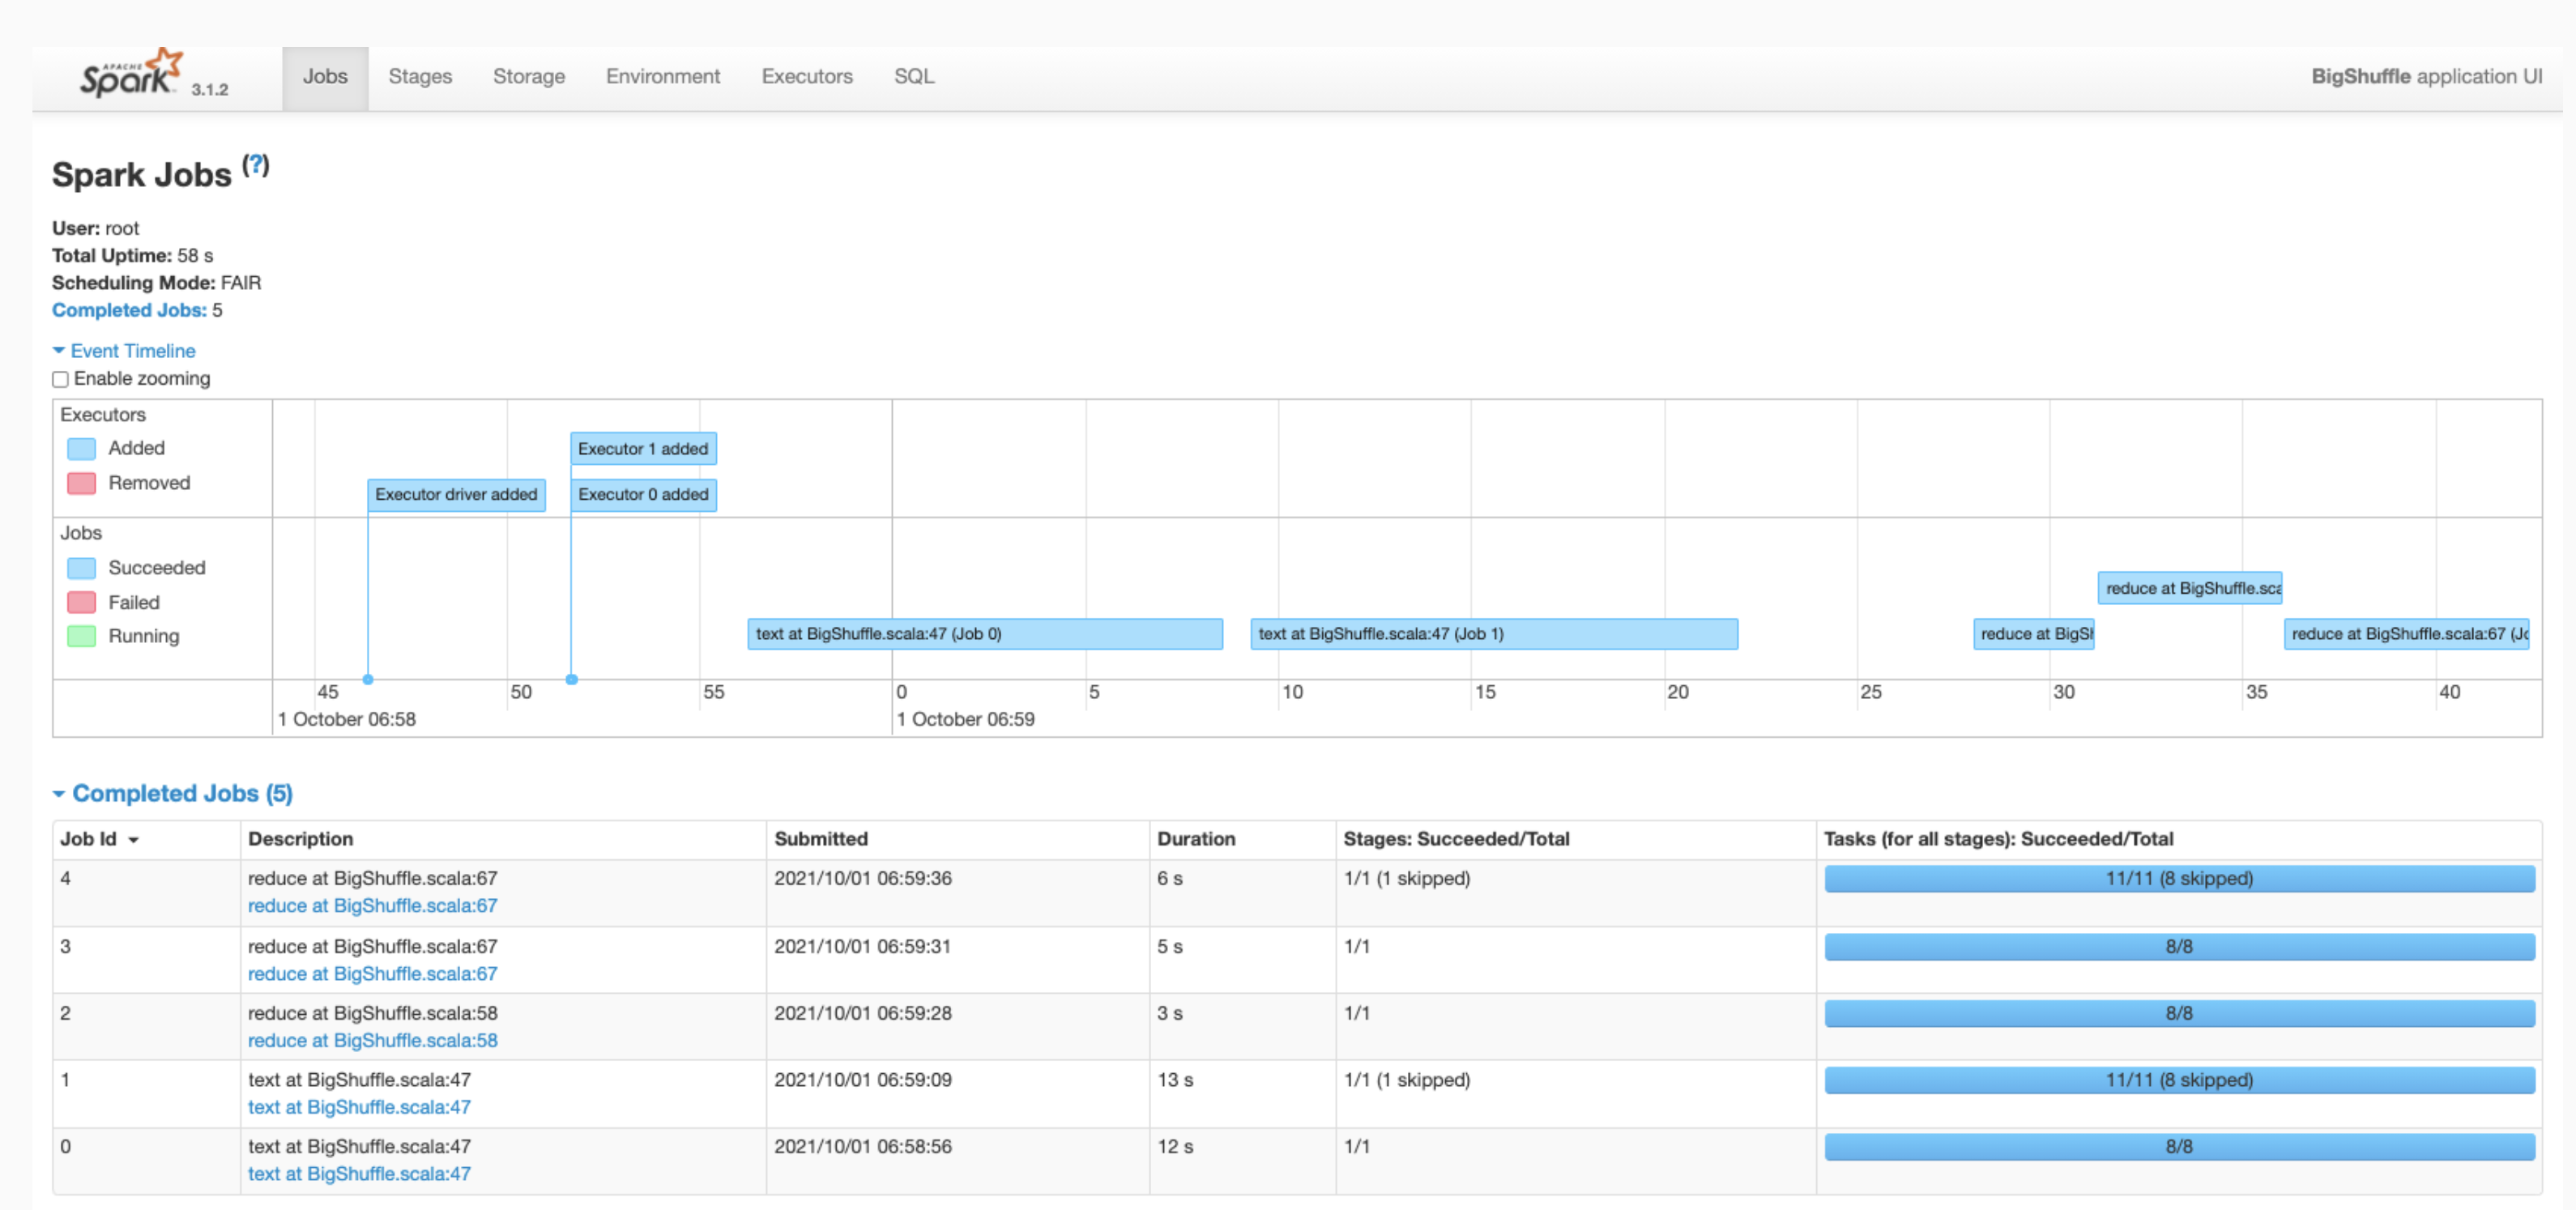
Las aplicaciones de Spark se dividen en varios trabajos, que se desglosan en varias etapas. Cada etapa puede tener varias tareas, que se ejecutan en nodos ejecutores (trabajadores).
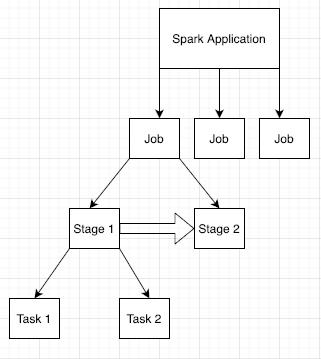
Haz clic en un ID de aplicación de Spark en la interfaz web para abrir la página Trabajos de Spark, que proporciona un cronograma de eventos y un resumen de los trabajos dentro de la aplicación.
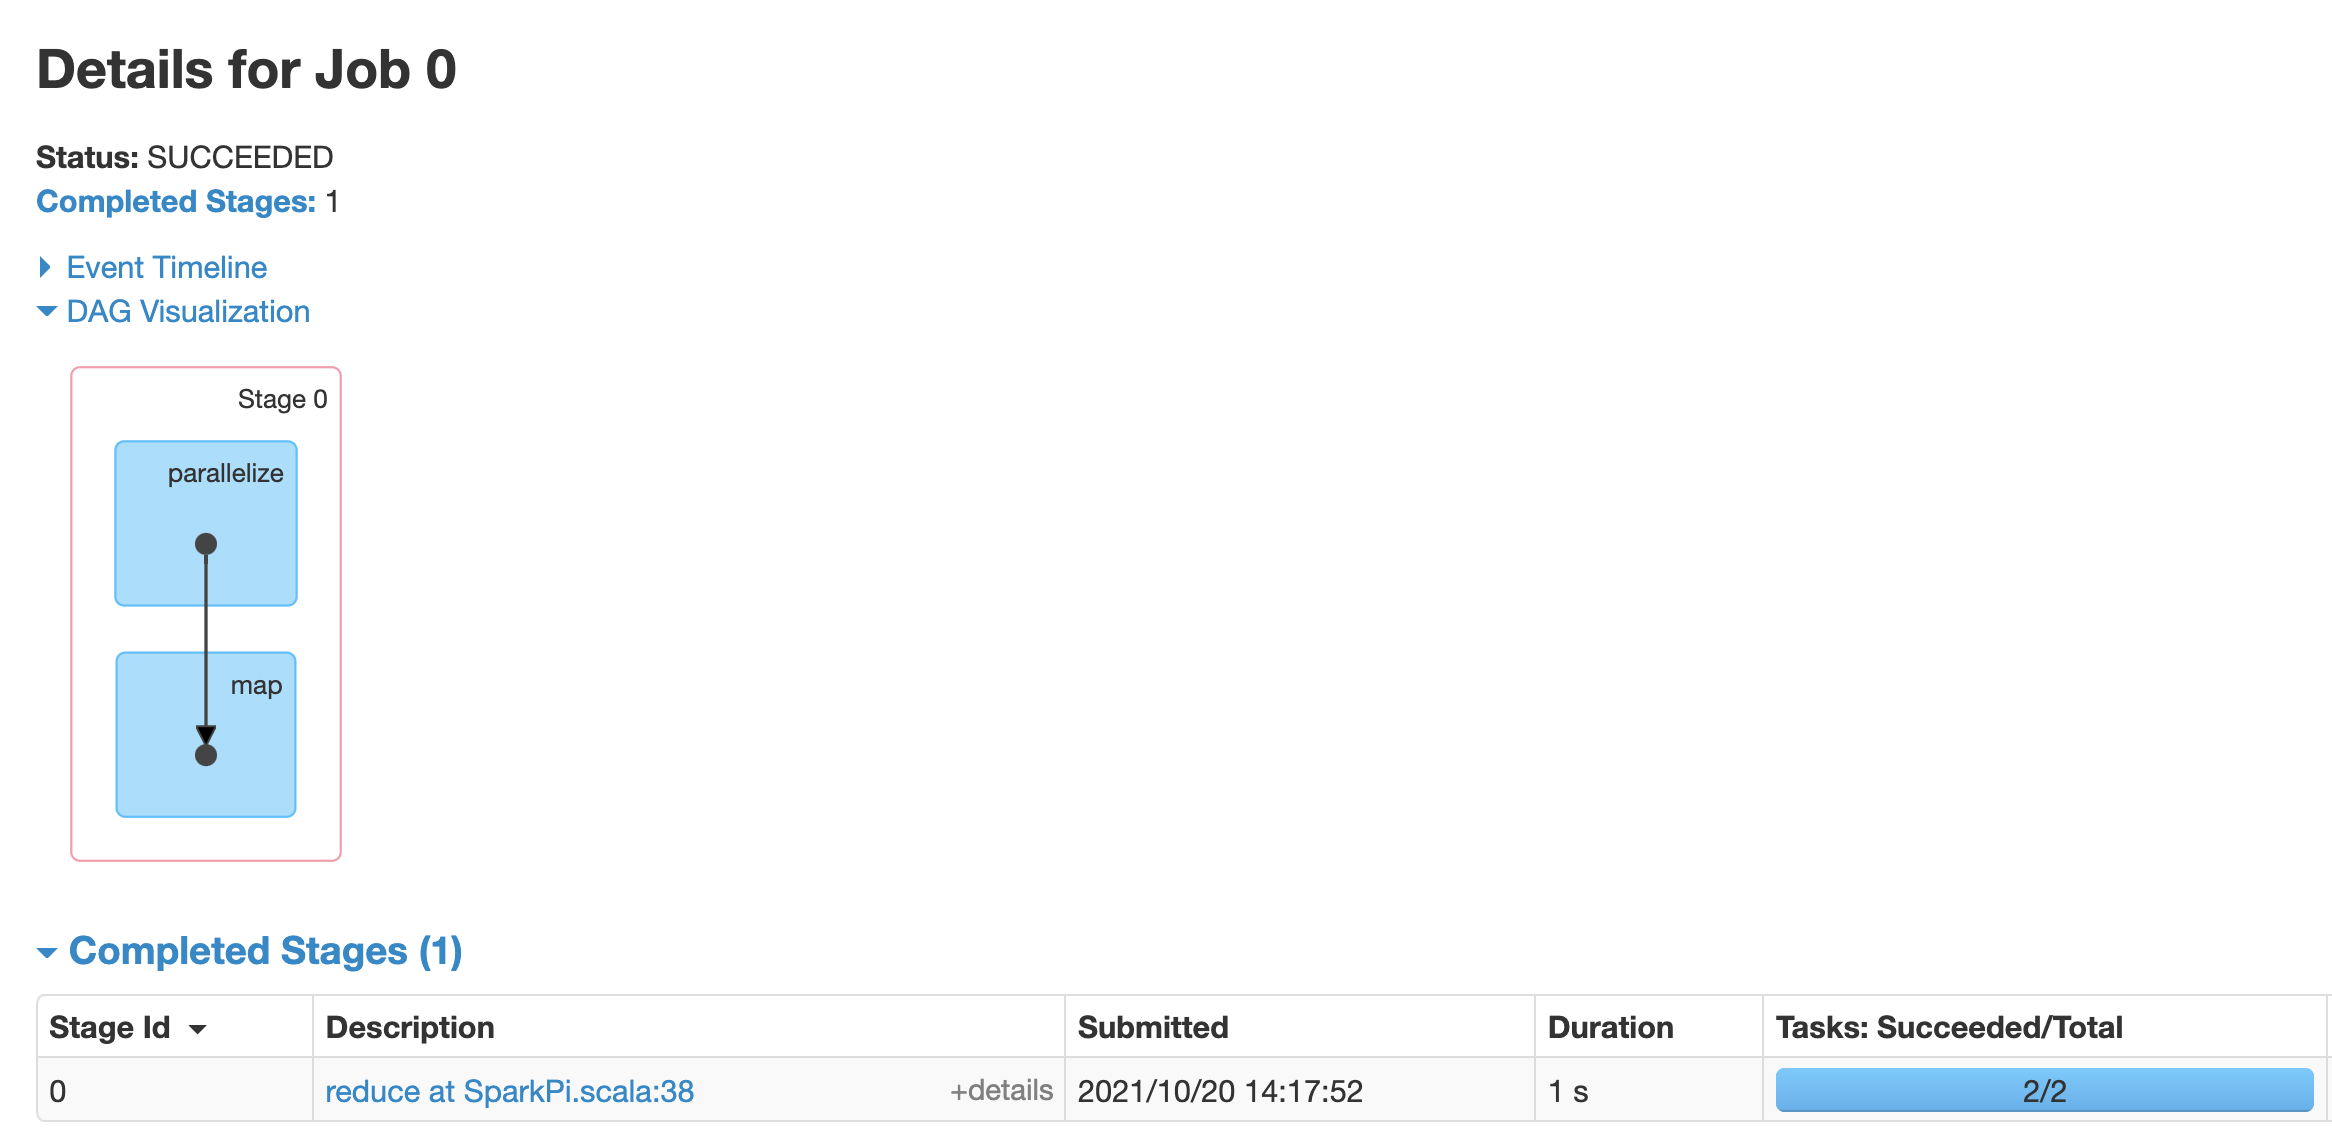
Haz clic en un trabajo para abrir una página de detalles de trabajo con un grafo acíclico dirigido (DAG) y el resumen de las etapas del trabajo.
Haz clic en una etapa o usa la pestaña Etapas para seleccionar una etapa y abrir la página de detalles de la etapa.
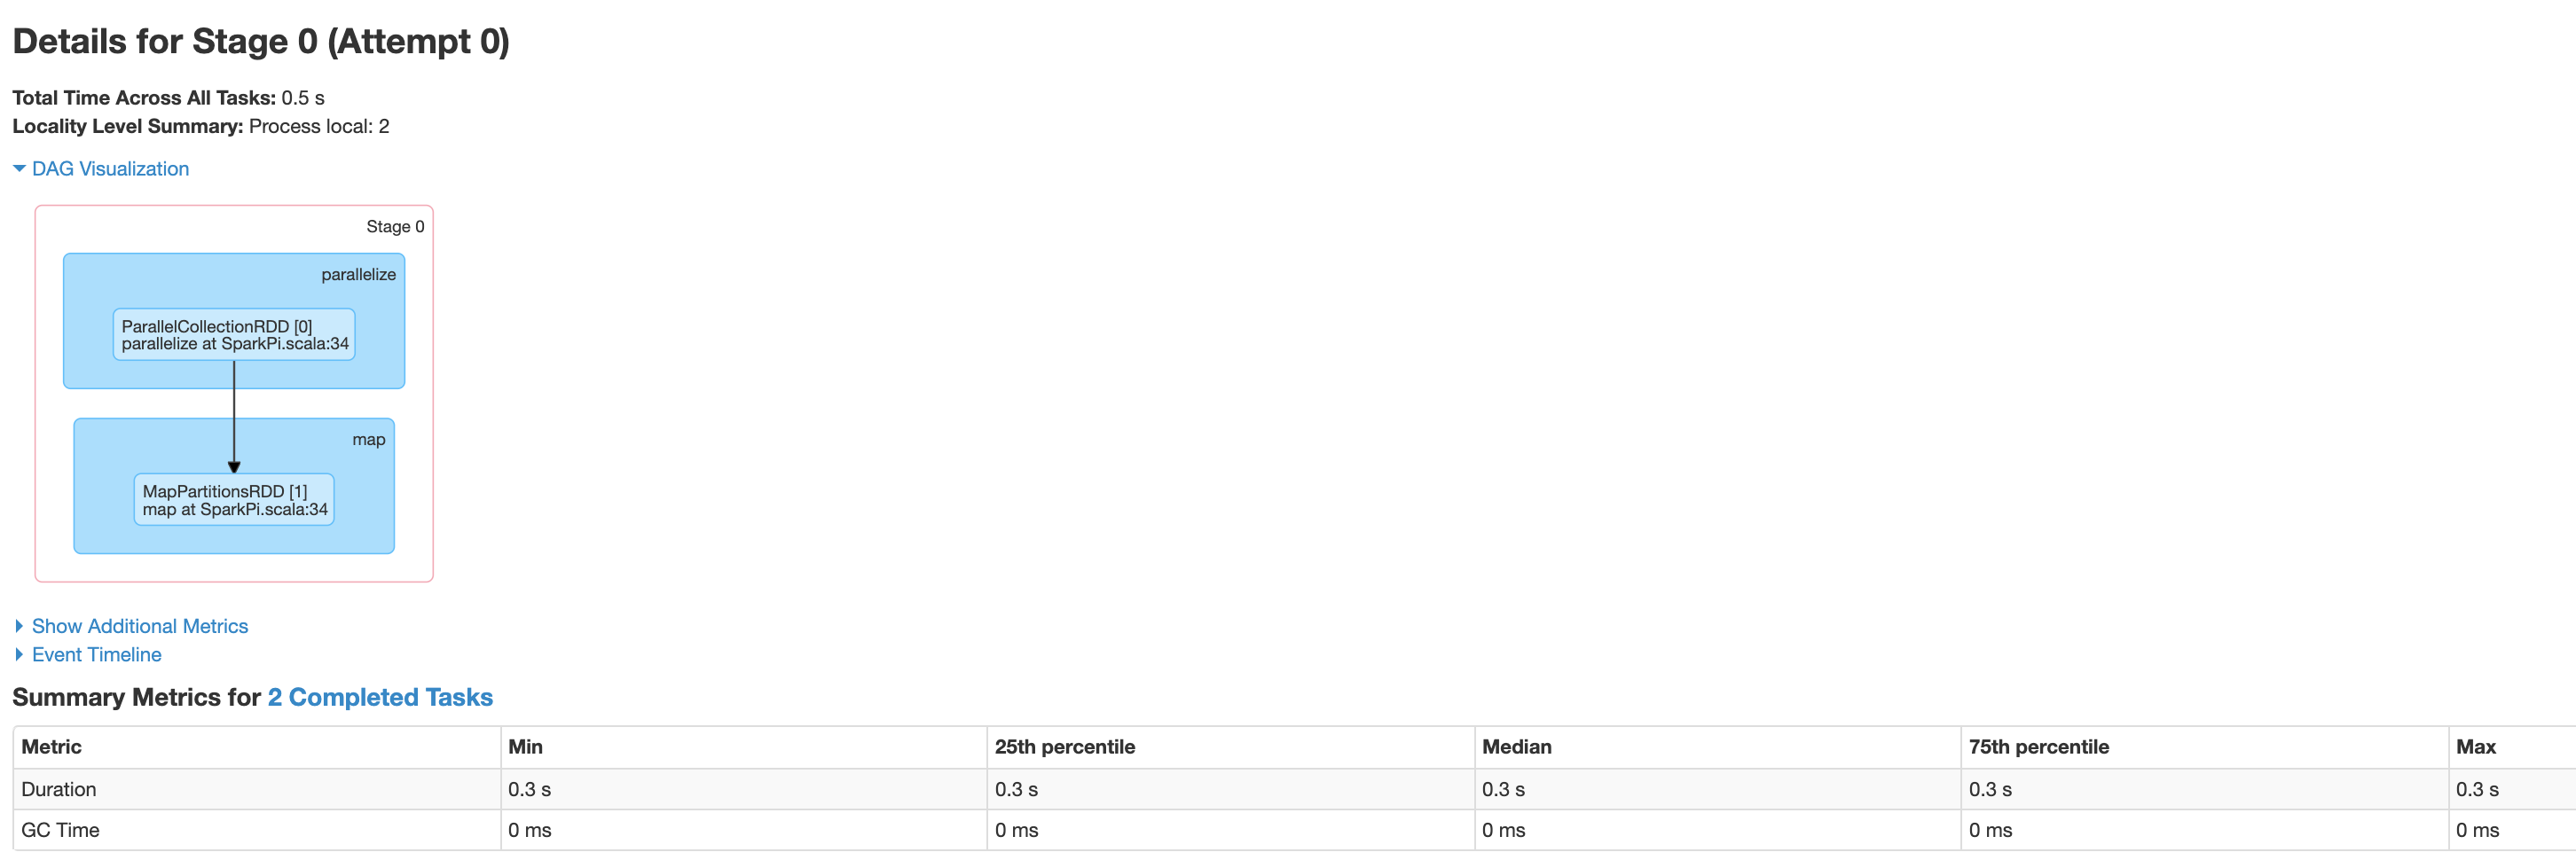
Los detalles de la etapa incluyen una visualización de DAG, un cronograma de eventos y métricas para las tareas dentro de la etapa. Puedes usar esta página para solucionar problemas relacionados con tareas suprimidas, retrasos del programador y errores de memoria insuficiente. El visualizador de DAG muestra la línea de código a partir de la cual se deriva la etapa, lo que te ayuda a hacer un seguimiento de los problemas hasta el código.
Haz clic en la pestaña Ejecutores para obtener información sobre los nodos del controlador y del ejecutor de la aplicación de Spark.
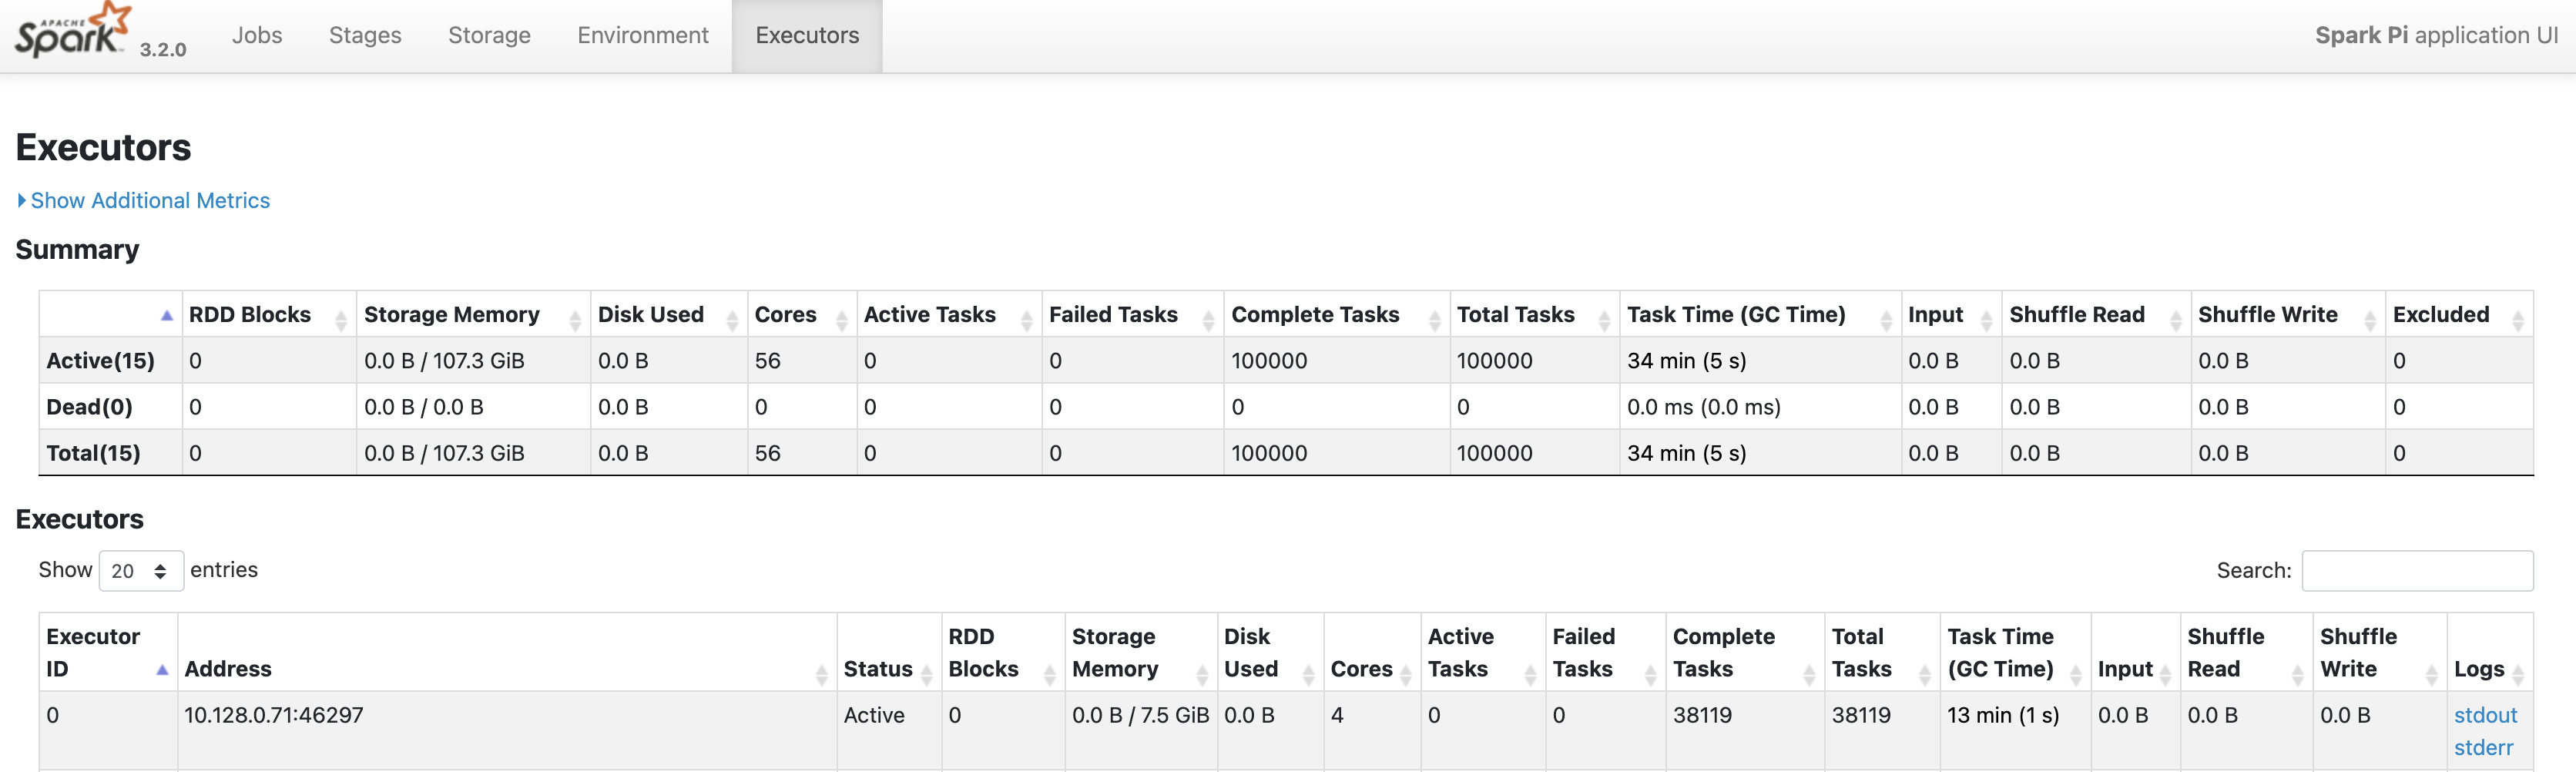
La información importante de esta página incluye la cantidad de núcleos y la cantidad de tareas que se ejecutaron en cada ejecutor.
Interfaz web de Tez
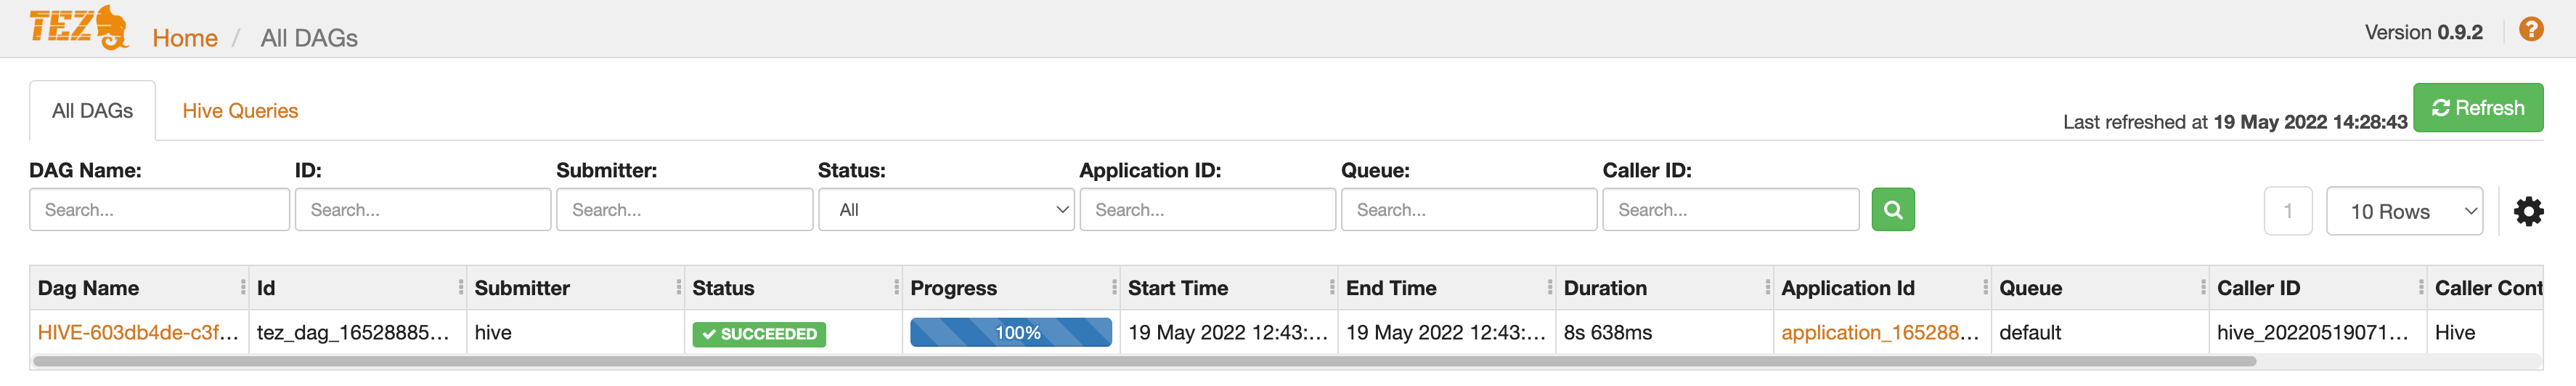
Tez es el motor de ejecución predeterminado para Hive y Pig en Managed Service para Apache Spark. Cuando envías un trabajo de Hive en un clúster de trabajos de Managed Service para Apache Spark, se inicia una aplicación de Tez.
Si configuraste Yarn Timeline Service v2
y estableciste la propiedad dataproc:yarn.atsv2.bigtable.instance cuando
creaste los clústeres de trabajos de PHS y Managed Service para Apache Spark, YARN escribe
los datos de cronograma de trabajos de Hive y Pig generados en la instancia de Bigtable
especificada para recuperarlos y mostrarlos en la interfaz web de Tez que se ejecuta en el
servidor de PHS.
Interfaz web de la versión 2 del cronograma de aplicaciones de YARN
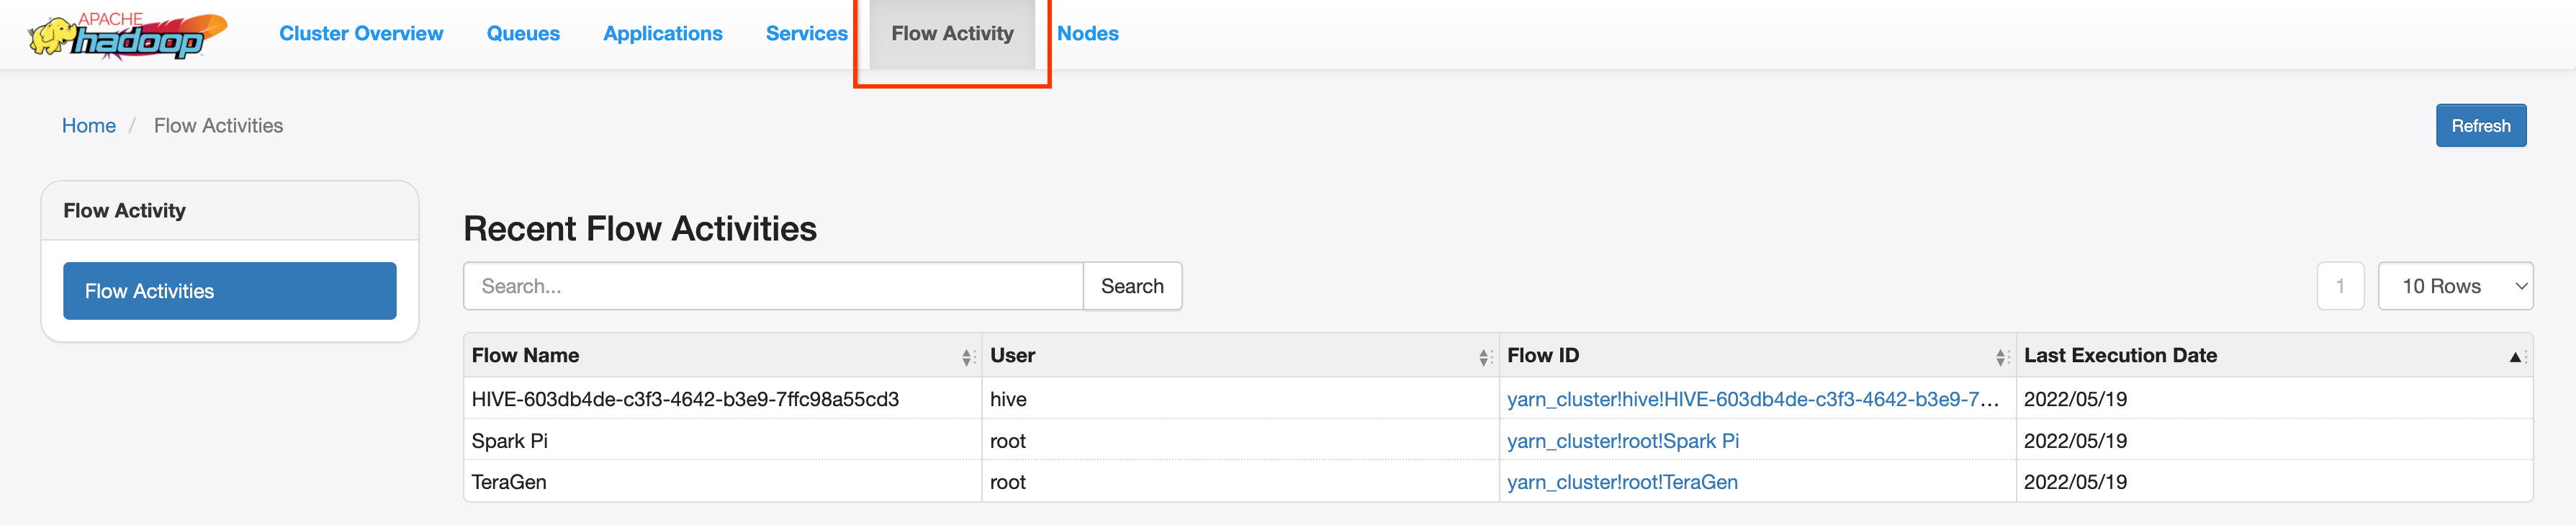
Si configuraste Yarn Timeline Service v2
y estableciste la propiedad dataproc:yarn.atsv2.bigtable.instance cuando
creaste los clústeres de trabajos de PHS y Managed Service para Apache Spark, YARN escribe
los datos de la cronología de trabajos generados en la instancia de Bigtable especificada para recuperarlos y
mostrarlos en la interfaz web de YARN Application Timeline Service que se ejecuta en el
servidor de PHS. Los trabajos de Managed Service para Apache Spark se enumeran en la pestaña Actividad del flujo
de la interfaz web.
Configura el servicio de cronograma de Yarn v2
Para configurar Yarn Timeline Service v2, configura una instancia de Bigtable y, si es necesario, verifica los roles de la cuenta de servicio de la siguiente manera:
Verifica los roles de la cuenta de servicio, si es necesario. La cuenta de servicio de VM predeterminada que usan las VMs del clúster de Dataproc tiene los permisos necesarios para crear y configurar la instancia de Bigtable para el servicio de cronograma de YARN. Si creas tu trabajo o clúster de PHS con una cuenta de servicio de VM personalizada, la cuenta debe tener el rol de Bigtable
AdministratoroBigtable User.
Esquema de tabla obligatorio
La compatibilidad de PHS de Managed Service para Apache Spark con
YARN Timeline Service v2
requiere un esquema específico creado en la
instancia de Bigtable. Managed Service para Apache Spark crea el esquema
necesario cuando se crea un clúster de trabajos o de PHS con la
propiedad dataproc:yarn.atsv2.bigtable.instance configurada para que apunte a la
instancia de Bigtable.
El siguiente es el esquema de instancia de Bigtable requerido:
| Tablas | Familias de columnas |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
Recolección de elementos no utilizados de Bigtable
Puedes configurar la recolección de elementos no utilizados de Bigtable basada en la antigüedad para las tablas de ATSv2:
Instala cbt (incluida la creación de
.cbrtc file).Crea la política de recolección de elementos no utilizados basada en la antigüedad de ATSv2:
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
Notas:
NUMBER_OF_DAYS: La cantidad máxima de días es 30d.