


O pushdown de transformação no Cloud Data Fusion permite executar transformações de pipeline no BigQuery em vez do Spark. Executar transformações diretamente no BigQuery ajuda a melhorar a velocidade de execução do pipeline e otimizar os custos de recursos de computação.
Para mais informações, consulte a visão geral do pushdown de transformação.
Antes de começar
A transformação de pushdown está disponível na versão 6.5.0 e em versões posteriores. Se o pipeline for executado em um ambiente de versão anterior, será possível fazer upgrade da instância para a versão mais recente.
Ativar o pushdown de transformação no pipeline
Console
Para ativar o pushdown de transformação em um pipeline implantado, faça o seguinte:
Acesse sua instância:
No console Google Cloud , acesse a página do Cloud Data Fusion.
Para abrir a instância no Cloud Data Fusion Studio, clique em Instâncias e em Ver instância.
Clique em Menu > Lista.
A guia do pipeline implantado é aberta.
Clique no pipeline implantado que você quer abrir no Pipeline Studio.
Clique em Configurar > Pushdown de transformação.
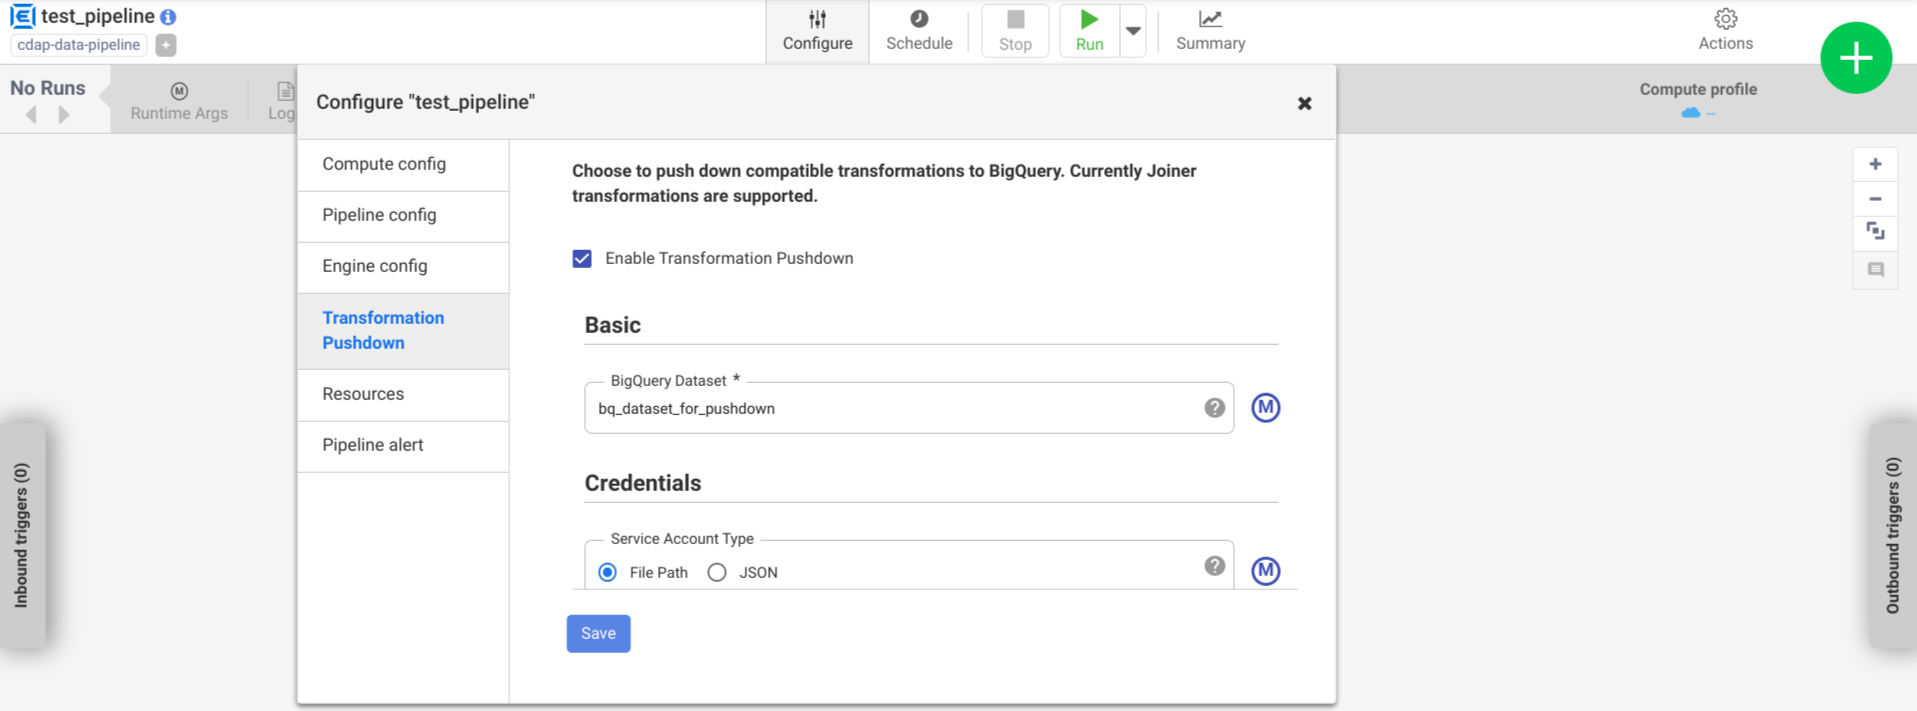
Clique em Ativar pushdown de transformação.
No campo Conjunto de dados, insira um nome de conjunto de dados do BigQuery.
Opcional: para usar uma macro, clique em M. Para mais informações, consulte Conjuntos de dados.
Opcional: configure as opções, se necessário.
Clique em Salvar.
Configurações opcionais
.| Propriedade | Compatível com macros | Versões compatíveis do Cloud Data Fusion | Descrição |
|---|---|---|---|
| Usar conexão | Não | 6.7.0 e mais recentes | Se uma conexão atual deve ser usada. |
| Conexão | Sim | 6.7.0 e mais recentes | O nome da conexão. Essa conexão fornece informações sobre o projeto e a conta de serviço. Opcional: use a macro da função ${conn(connection_name)}. |
| ID do projeto do conjunto de dados | Sim | 6.5.0 | Se o conjunto de dados estiver em um projeto diferente daquele em que o job do BigQuery é executado, insira o ID do projeto do conjunto de dados. Se nenhum valor for fornecido, por padrão, ele usará o ID do projeto em que o job é executado. |
| ID do projeto | Sim | 6.5.0 | O ID do projeto do Google Cloud . |
| Tipo de conta de serviço | Sim | 6.5.0 | Selecione uma destas opções:
|
| Caminho do arquivo da conta de serviço | Sim | 6.5.0 | O caminho no sistema de arquivos local para a chave da conta de serviço usada
para autorização. Ele é definido como auto-detect quando executado
em um cluster do Serviço Gerenciado para Apache Spark. Ao executar em outros clusters,
o arquivo precisa estar presente em todos os nós do cluster. O padrão é auto-detect. |
| JSON da conta de serviço | Sim | 6.5.0 | O conteúdo do arquivo JSON da conta de serviço. |
| Nome do bucket temporário | Sim | 6.5.0 | O bucket do Cloud Storage que armazena os dados temporários. Ele será criado automaticamente se não existir, mas não será excluído automaticamente. Os dados do Cloud Storage são excluídos depois de serem carregados no BigQuery. Se esse valor não for fornecido, um bucket exclusivo será criado e excluído após a conclusão da execução do pipeline. A conta de serviço precisa ter permissão para criar buckets no projeto configurado. |
| Local | Sim | 6.5.0 | O local em que o conjunto de dados do BigQuery é criado.
Esse valor será ignorado se o conjunto de dados ou o bucket temporário já
existir. O padrão é a multirregião US. |
| Nome da chave de criptografia | Sim | 6.5.1/0.18.1 | A chave de criptografia gerenciada pelo cliente (CMEK) que criptografa os dados gravados em qualquer bucket, conjunto de dados ou tabela criada pelo plug-in. Se o bucket, o conjunto de dados ou a tabela já existirem, esse valor será ignorado. |
| Manter as tabelas do BigQuery após a conclusão | Sim | 6.5.0 | Se é preciso reter todas as tabelas temporárias do BigQuery criadas durante a execução do pipeline para fins de depuração e validação. O padrão é Não. |
| TTL da tabela temporária (em horas) | Sim | 6.5.0 | Defina o TTL para tabelas temporárias do BigQuery, em
horas. Isso é útil como uma proteção contra falhas caso o pipeline seja
cancelado e o processo de limpeza seja interrompido (por exemplo, se
o cluster de execução for encerrado abruptamente). Definir esse valor como
0 desativa o TTL da tabela. O padrão é
72 (3 dias). |
| Prioridade de job | Sim | 6.5.0 | A prioridade usada para executar jobs do BigQuery. Selecione
uma destas opções:
|
| Estágios para forçar o pushdown | Sim | 6.7.0 | Estágios compatíveis para sempre executar no BigQuery. Cada nome de estágio precisa estar em uma linha separada. |
| Estágios para pular o pushdown | Sim | 6.7.0 | Estágios compatíveis que nunca serão executados no BigQuery. Cada nome de estágio precisa estar em uma linha separada. |
| Usar a API BigQuery Storage Read | Sim | 6.7.0 | Se a API BigQuery Storage Read deve ser usada ao extrair registros do BigQuery durante a execução do pipeline. Essa opção pode melhorar o desempenho do pushdown de transformação, mas gera custos extras. Isso requer que o Scala 2.12 esteja instalado no ambiente de execução. |
Monitorar as alterações no desempenho dos registros
Os registros de ambiente de execução do pipeline incluem mensagens que mostram as consultas SQL executadas no BigQuery. É possível monitorar quais estágios do pipeline são enviados ao BigQuery.
O exemplo a seguir mostra as entradas de registro quando a execução do pipeline começa. Os
registros indicam que as operações JOIN no pipeline foram enviadas para o BigQuery
para execução:
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'Users' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'Users'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'UserPurchases' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'Purchases'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'UserPurchases'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'MostPopularNames' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'FirstNameCounts'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'MostPopularNames'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@193] - Starting pull for dataset 'MostPopularNames'
O exemplo a seguir mostra os nomes de tabela que serão atribuídos a cada um dos conjuntos de dados envolvidos na execução de pushdown:
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset Purchases stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserDetails stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset FirstNameCounts stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserProfile stored in table <TABLE_ID>
Conforme a execução continua, os registros mostram a conclusão das etapas de push e,
por fim, a execução das operações JOIN. Exemplo:
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@235] - Executing join operation for dataset Users
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@118] - Creating table `<TABLE_ID>` using job: <JOB_ID> with SQL statement: SELECT `UserDetails`.id AS `id` , `UserDetails`.first_name AS `first_name` , `UserDetails`.last_name AS `last_name` , `UserDetails`.email AS `email` , `UserProfile`.phone AS `phone` , `UserProfile`.profession AS `profession` , `UserProfile`.age AS `age` , `UserProfile`.address AS `address` , `UserProfile`.score AS `score` FROM `your_project.your_dataset.<DATASET_ID>` AS `UserProfile` LEFT JOIN `your_project.your_dataset.<DATASET_ID>` AS `UserDetails` ON `UserProfile`.id = `UserDetails`.id
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@151] - Created BigQuery table `<TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@245] - Executed join operation for dataset Users
Quando todas as etapas forem concluídas, uma mensagem vai mostrar que a operação Pull foi
concluída. Isso indica que o processo de BigQuery Export foi acionado e os registros vão começar a ser lidos no pipeline após o início desse job de exportação. Exemplo:
DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@196] - Completed pull for dataset 'MostPopularNames'
Se a execução do pipeline encontrar erros, eles serão descritos nos registros.
Para detalhes sobre a execução das operações JOIN do BigQuery, como utilização de recursos, tempo de execução e causas de erro, é possível visualizar os dados do job do BigQuery usando o código da tarefa, que aparece nos registros do job.
Analisar métricas de pipeline
Para mais informações sobre as métricas que o Cloud Data Fusion fornece para a parte do pipeline que é executada no BigQuery, consulte Métricas de pipeline de pushdown do BigQuery.
A seguir
- Saiba mais sobre o pushdown de transformação no Cloud Data Fusion.