


Transformation Pushdown di Cloud Data Fusion memungkinkan Anda menjalankan transformasi pipeline di BigQuery, bukan Spark. Menjalankan transformasi langsung di BigQuery membantu Anda meningkatkan kecepatan eksekusi pipeline dan mengoptimalkan biaya resource komputasi.
Untuk mengetahui informasi selengkapnya, lihat Ringkasan Pushdown Transformasi.
Sebelum memulai
Transformation Pushdown tersedia di versi 6.5.0 dan yang lebih baru. Jika pipeline Anda berjalan di lingkungan yang lebih lama, Anda dapat mengupgrade instance ke versi terbaru.
Mengaktifkan Transformation Pushdown di pipeline Anda
Konsol
Untuk mengaktifkan Transformation Pushdown pada pipeline yang di-deploy, lakukan hal berikut:
Buka instance Anda:
In the Google Cloud console, go to the Cloud Data Fusion page.
To open the instance in the Cloud Data Fusion Studio, click Instances, and then click View instance.
Klik Menu > Daftar.
Tab pipeline yang di-deploy akan terbuka.
Klik pipeline yang di-deploy yang diinginkan untuk membukanya di Pipeline Studio.
Klik Configure > Transformation Pushdown.
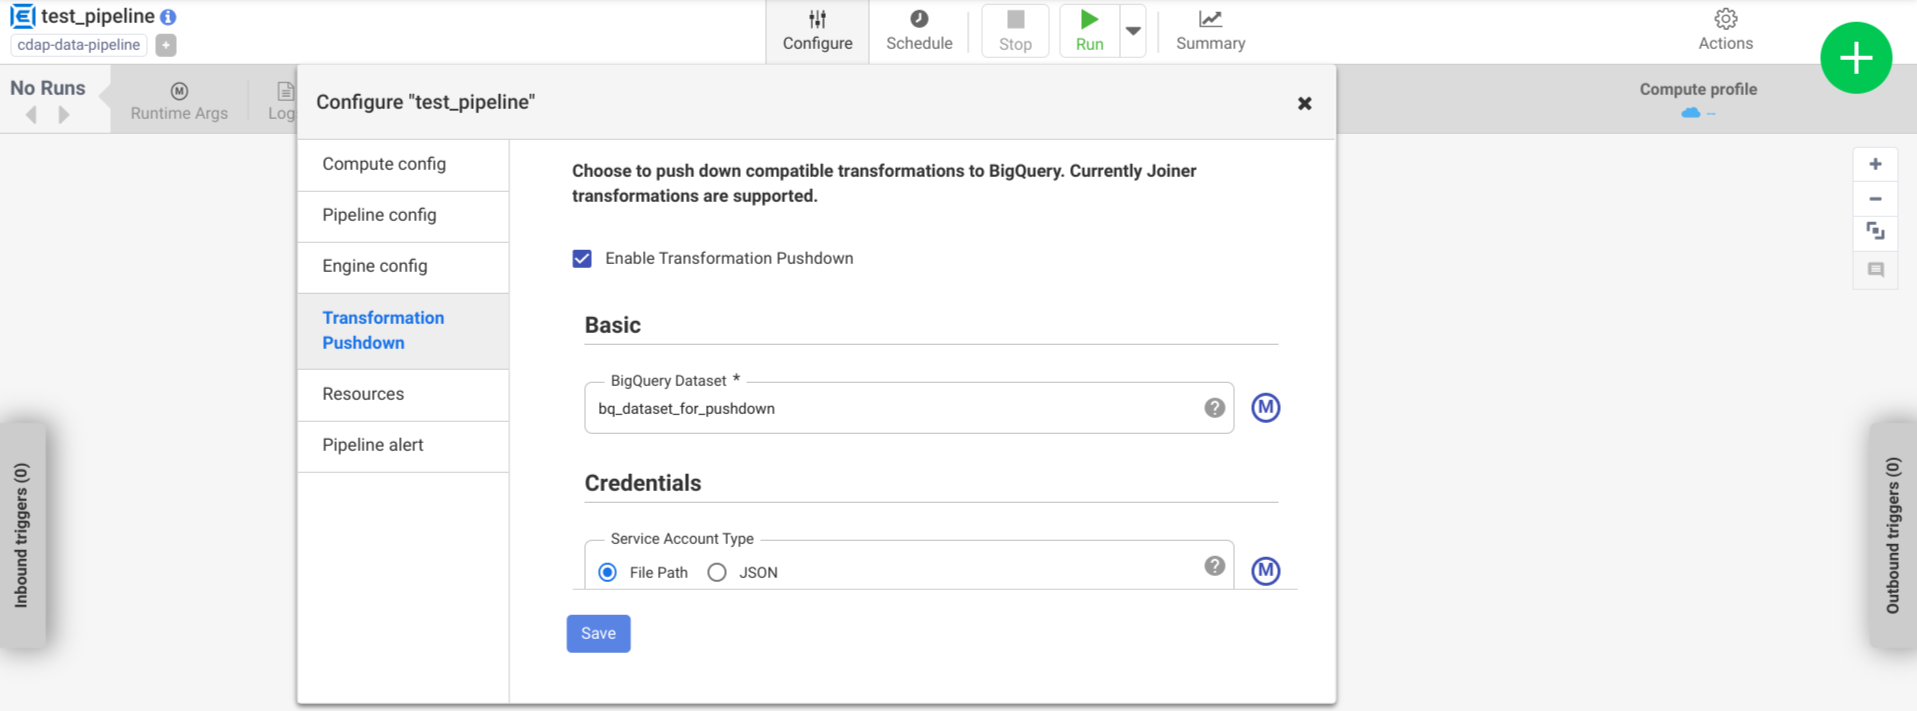
Klik Enable Transformation Pushdown.
Di kolom Dataset, masukkan nama set data BigQuery.
Opsional: Untuk menggunakan makro, klik M. Untuk mengetahui informasi selengkapnya, lihat Set data.
Opsional: Konfigurasikan opsi, jika diperlukan.
Klik Simpan.
Konfigurasi opsional
.| Properti | Mendukung makro | Versi Cloud Data Fusion yang didukung | Deskripsi |
|---|---|---|---|
| Gunakan koneksi | Tidak | 6.7.0 dan yang lebih baru | Apakah akan menggunakan koneksi yang ada. |
| Koneksi | Ya | 6.7.0 dan yang lebih baru | Nama koneksi. Koneksi ini memberikan informasi project dan akun layanan. Opsional: Gunakan fungsi makro, ${conn(connection_name)}. |
| Dataset Project ID | Ya | 6.5.0 | Jika set data berada dalam project yang berbeda dengan tempat tugas BigQuery dijalankan, masukkan project ID set data. Jika tidak ada nilai yang diberikan, secara default, nilai ini akan menggunakan project ID tempat tugas dijalankan. |
| Project ID | Ya | 6.5.0 | Project ID Google Cloud . |
| Jenis Akun Layanan | Ya | 6.5.0 | Pilih salah satu opsi berikut:
|
| Jalur File Akun Layanan | Ya | 6.5.0 | Jalur pada sistem file lokal ke kunci akun layanan yang digunakan
untuk otorisasi. Properti ini ditetapkan ke auto-detect saat berjalan di cluster Managed Service untuk Apache Spark. Saat berjalan di cluster lain, file harus ada di setiap node dalam cluster. Default-nya adalah
auto-detect. |
| JSON Akun Layanan | Ya | 6.5.0 | Konten file JSON akun layanan. |
| Nama Bucket Sementara | Ya | 6.5.0 | Bucket Cloud Storage yang menyimpan data sementara. Bucket ini akan otomatis dibuat jika belum ada, tetapi tidak akan otomatis dihapus. Data Cloud Storage akan dihapus setelah dimuat ke BigQuery. Jika nilai ini tidak diberikan, bucket unik akan dibuat, lalu dihapus setelah operasi pipeline selesai. Akun layanan harus memiliki izin untuk membuat bucket di project yang dikonfigurasi. |
| Lokasi | Ya | 6.5.0 | Lokasi tempat set data BigQuery dibuat.
Nilai ini diabaikan jika set data atau bucket sementara sudah ada. Defaultnya adalah multi-region US. |
| Nama Kunci Enkripsi | Ya | 6.5.1/0.18.1 | Kunci enkripsi yang dikelola pelanggan (CMEK) yang mengenkripsi data yang ditulis ke bucket, set data, atau tabel apa pun yang dibuat oleh plugin. Jika bucket, set data, atau tabel sudah ada, nilai ini akan diabaikan. |
| Mempertahankan Tabel BigQuery setelah Selesai | Ya | 6.5.0 | Apakah akan mempertahankan semua tabel sementara BigQuery yang dibuat selama operasi pipeline untuk tujuan proses debug dan validasi. Defaultnya adalah Tidak. |
| TTL Tabel Sementara (dalam jam) | Ya | 6.5.0 | Menetapkan TTL tabel untuk tabel sementara BigQuery, dalam jam. Hal ini berguna sebagai failsafe jika pipeline dibatalkan dan proses pembersihan terganggu (misalnya, jika cluster eksekusi dimatikan secara tiba-tiba). Menetapkan nilai ini ke 0 akan menonaktifkan TTL tabel. Defaultnya adalah
72 (3 hari). |
| Prioritas Tugas | Ya | 6.5.0 | Prioritas yang digunakan untuk menjalankan tugas BigQuery. Pilih
salah satu opsi berikut:
|
| Tahapan untuk memaksa pushdown | Ya | 6.7.0 | Tahapan yang didukung untuk selalu dijalankan di BigQuery. Setiap nama tahap harus berada di baris terpisah. |
| Tahapan untuk melewati pushdown | Ya | 6.7.0 | Tahapan yang didukung untuk tidak pernah dieksekusi di BigQuery. Setiap nama tahap harus berada di baris terpisah. |
| Menggunakan BigQuery Storage Read API | Ya | 6.7.0 | Apakah akan menggunakan BigQuery Storage Read API saat mengekstrak data dari BigQuery selama eksekusi pipeline. Opsi ini dapat meningkatkan performa Transformation Pushdown, tetapi menimbulkan biaya tambahan. Hal ini mengharuskan Scala 2.12 diinstal di lingkungan eksekusi. |
Memantau perubahan performa di log
Log runtime pipeline menyertakan pesan yang menampilkan kueri SQL yang dijalankan di BigQuery. Anda dapat memantau tahap mana dalam pipeline yang didorong ke BigQuery.
Contoh berikut menunjukkan entri log saat eksekusi pipeline dimulai. Log
menunjukkan bahwa operasi JOIN di pipeline Anda telah dikirim ke
BigQuery untuk dieksekusi:
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'Users' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'Users'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'UserPurchases' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'Purchases'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'UserPurchases'
  INFO  [Driver:i.c.p.g.b.s.BigQuerySQLEngine@190] - Validating join for stage 'MostPopularNames' can be executed on BigQuery: true
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@131] - Starting push for dataset 'FirstNameCounts'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@292] - Starting join for dataset 'MostPopularNames'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@193] - Starting pull for dataset 'MostPopularNames'
Contoh berikut menunjukkan nama tabel yang akan ditetapkan untuk setiap set data yang terlibat dalam eksekusi pushdown:
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset Purchases stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserDetails stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset FirstNameCounts stored in table <TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@145] - Executing Push operation for dataset UserProfile stored in table <TABLE_ID>
Saat eksekusi berlanjut, log akan menampilkan penyelesaian tahap push, dan
pada akhirnya eksekusi operasi JOIN. Contoh:
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserProfile'
  DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@133] - Completed push for dataset 'UserDetails'
  DEBUG [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@235] - Executing join operation for dataset Users
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@118] - Creating table `<TABLE_ID>` using job: <JOB_ID> with SQL statement: SELECT `UserDetails`.id AS `id` , `UserDetails`.first_name AS `first_name` , `UserDetails`.last_name AS `last_name` , `UserDetails`.email AS `email` , `UserProfile`.phone AS `phone` , `UserProfile`.profession AS `profession` , `UserProfile`.age AS `age` , `UserProfile`.address AS `address` , `UserProfile`.score AS `score` FROM `your_project.your_dataset.<DATASET_ID>` AS `UserProfile` LEFT JOIN `your_project.your_dataset.<DATASET_ID>` AS `UserDetails` ON `UserProfile`.id = `UserDetails`.id
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQueryJoinDataset@151] - Created BigQuery table `<TABLE_ID>
  INFO  [batch-sql-engine-adapter:i.c.p.g.b.s.BigQuerySQLEngine@245] - Executed join operation for dataset Users
Setelah semua tahap selesai, pesan akan menunjukkan bahwa operasi Pull telah
selesai. Hal ini menunjukkan bahwa proses BigQuery Export telah dipicu dan kumpulan data akan mulai dibaca ke dalam pipeline setelah tugas ekspor ini dimulai. Contoh:
DEBUG [batch-sql-engine-adapter:i.c.c.e.s.b.BatchSQLEngineAdapter@196] - Completed pull for dataset 'MostPopularNames'
Jika eksekusi pipeline mengalami error, error tersebut akan dijelaskan dalam log.
Untuk mengetahui detail tentang eksekusi operasi JOIN BigQuery, seperti pemakaian resource, waktu eksekusi, dan penyebab error, Anda dapat melihat data Tugas BigQuery menggunakan ID pekerjaan, yang muncul di log tugas.
Meninjau metrik pipeline
Untuk mengetahui informasi selengkapnya tentang metrik yang disediakan Cloud Data Fusion untuk bagian pipeline yang dijalankan di BigQuery, lihat Metrik pipeline pushdown BigQuery.
Langkah berikutnya
- Pelajari lebih lanjut Transformation Pushdown di Cloud Data Fusion.