


O ajuste do tratamento de pipelines no Cloud Data Fusion permite otimizar a velocidade de execução e evitar gargalos de tempo de execução. Entender esses conceitos ajuda a dimensionar a infraestrutura de maneira eficaz e reduzir os custos de computação nos fluxos de dados.
A performance do pipeline depende dos seguintes aspectos:
- O tamanho e as características dos dados
- A estrutura do pipeline
- Dimensionamento de cluster
- Plug-ins usados pelo pipeline do Cloud Data Fusion
Terminologia de tratamento de pipelines no Cloud Data Fusion
A terminologia a seguir se aplica ao tratamento de pipelines no Cloud Data Fusion.
- Tipo de máquina
- Tipo de máquinas virtuais (VMs) usadas (CPU, memória).
- Cluster
- Um grupo de VMs que trabalham juntas para lidar com tarefas de tratamento de dados em grande escala.
- Nós mestre e de worker
- Máquinas físicas ou virtuais que podem fazer o tratamento. Os nós mestre geralmente coordenam o trabalho. Os nós de trabalho executam executores que tratam dados. Eles têm características de máquina (quantidade de memória e número de vCores disponíveis para processos).
- vCores, núcleos ou CPUs
- Um recurso que faz a computação. Geralmente, os nós fornecem uma determinada quantidade de núcleos, e os executores solicitam uma ou algumas CPUs. Equilibre isso com a memória ou você poderá subutilizar o cluster.
- Driver
- Uma única VM que atua como coordenador central de todo o cluster. Ele gerencia tarefas, programa o trabalho em nós de trabalho e monitora o progresso do job.
- Executores
- Várias VMs que executam as tarefas de tratamento de dados reais, conforme instruído pelo driver. Os dados são particionados e distribuídos entre esses executores para tratamento paralelo. Para usar todos os executores, você precisa ter divisões suficientes.
- Divisões ou partições
- Um conjunto de dados é dividido em divisões (outras partições de nome) para tratar dados em paralelo. Se você não tiver divisões suficientes, não poderá usar todo o cluster.
Visão geral do ajuste de performance
Os pipelines são executados em clusters de máquinas. Quando você escolhe executar pipelines do Cloud Data Fusion em clusters do Serviço Gerenciado para Apache Spark (que é o provisionador recomendado), ele usa o YARN (Yet Another Resource Negotiator) nos bastidores. O Serviço Gerenciado para Apache Spark usa o YARN para gerenciamento de recursos no cluster. Quando você envia um pipeline do Cloud Data Fusion para um cluster do Serviço Gerenciado para Apache Spark, o job do Apache Spark subjacente aproveita o YARN para alocação de recursos e programação de tarefas.
Um cluster consiste em nós mestre e nós de trabalho. Os nós mestre geralmente são responsáveis por coordenar o trabalho, enquanto os nós de trabalho executam o trabalho real. Os clusters normalmente têm um pequeno número de nós mestre (um ou três) e um grande número de workers. O YARN é usado como o sistema de coordenação de trabalho. O YARN executa um serviço do Resource Manager no nó mestre e um serviço do gerenciador de nós em cada nó de trabalho. Os Resource Managers coordenam entre todos os gerenciadores de nós para determinar onde criar e executar contêineres no cluster.
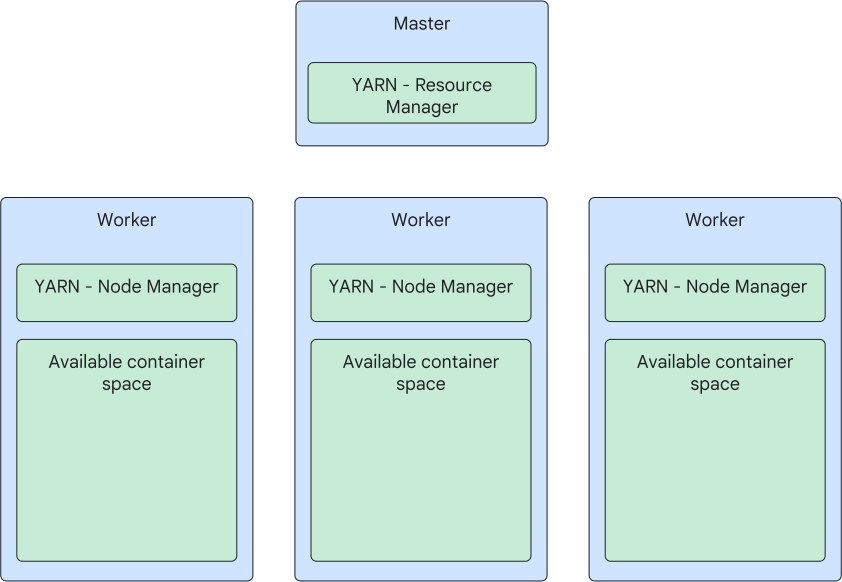
Em cada nó de trabalho, o gerenciador de nós reserva uma parte da memória e das CPUs da máquina disponíveis para executar contêineres YARN. Por exemplo, em um cluster do Serviço Gerenciado para Apache Spark, se os nós de trabalho forem VMs n1-standard-4 (4 CPUs, 15 GB de memória), cada gerenciador de nós reservará 4 CPUs e 12 GB de memória para executar contêineres YARN. Os 3 GB de memória restantes são deixados para os outros serviços do Hadoop em execução no nó.
Quando um pipeline é executado no YARN, ele inicia um driver de fluxo de trabalho de pipeline, um driver do Spark e muitos executores do Spark no Serviço Gerenciado para Apache Spark.
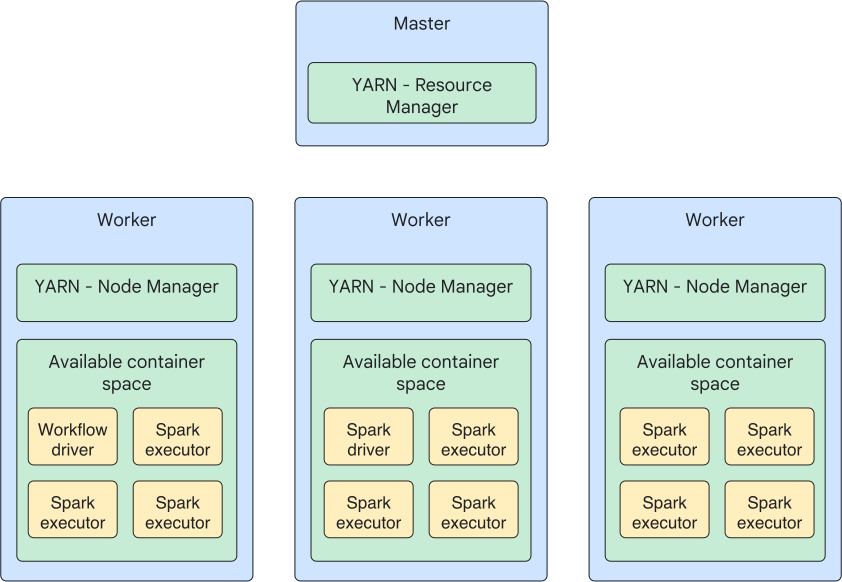
O driver de fluxo de trabalho é responsável por iniciar um ou mais programas do Spark que compõem um pipeline. O driver de fluxo de trabalho geralmente não faz muito trabalho. Cada programa do Spark executa um único driver do Spark e vários executores do Spark. O driver coordena o trabalho entre os executores, mas geralmente não realiza nenhum trabalho real. A maior parte do trabalho real é realizada pelos executores do Spark.
A seguir
- Saiba mais sobre o tratamento paralelo no Cloud Data Fusion.