


Mit der Bereitstellung von Anmeldedaten für den Lakehouse-Laufzeitkatalog können Sie den Cloud Storage-Zugriff an Abfrage-Engines delegieren und detaillierte IAM-Richtlinien (Identity and Access Management) auf Katalog-, Namespace- und Tabellenebene über die Google Cloud Console oder die Google Cloud CLI erzwingen. Die Bereitstellung von Anmeldedaten ist auch erforderlich, um die automatische Tabellenverwaltung für Hintergrundwartungsaufgaben wie Komprimierung, Ablauf von Snapshots und automatische Speicherbereinigung zu aktivieren.
Funktionsweise der Bereitstellung von Anmeldedaten
Wenn Sie die Bereitstellung von Anmeldedaten verwenden, ändert sich die Abfolge der Vorgänge geringfügig, um Richtlinien durchzusetzen, bevor auf den Speicher zugegriffen wird. Das folgende Diagramm zeigt, wie Abfrage-Engines eingeschränkte Speicher-Tokens aus dem Katalog abrufen, um Daten direkt in Cloud Storage sicher zu lesen und zu schreiben:
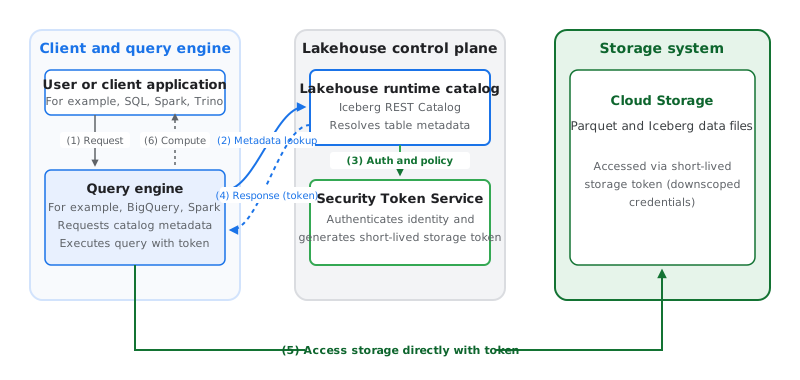
Die im vorherigen Diagramm dargestellte Abfolge von Vorgängen sieht so aus:
- Anfrage: Ein Nutzer sendet eine SQL-Anweisung, z. B. eine Abfrage, DML- oder DDL-Operation, an eine unterstützte Engine wie Apache Spark oder BigQuery.
- Metadatensuche: Die Engine sendet eine Anfrage an den Lakehouse-Laufzeitkatalog, um die Tabelle aufzulösen.
- Authentifizierung und Richtlinie: Der Katalog authentifiziert den Nutzer und prüft seine IAM-Berechtigungen für Lakehouse-Ressourcen.
- Antwort: Da die Bereitstellung von Anmeldedaten aktiviert ist, gibt der Katalog die Metadaten und ein kurzlebiges Speichertoken (Speicheranmeldedaten mit eingeschränktem Bereich) an die Engine zurück. Das Token ist auf die mit der Tabelle verknüpften Pfade beschränkt und auf die mindestens erforderlichen Berechtigungen reduziert (z. B. Lesezugriff für Abfragen, die keine Dateien schreiben müssen).
- Zugriff: Die Engine verwendet dieses Token, um die spezifischen autorisierten Dateien direkt aus Cloud Storage zu lesen oder in Cloud Storage zu schreiben.
- Compute: Die Engine verarbeitet die Daten oder führt den Vorgang aus und gibt die Ergebnisse zurück.
Wenn die automatische Tabellenverwaltung (gcp.biglake.table-management.enabled) aktiviert ist, werden Hintergrundwartungsaufgaben wie Komprimierung, Snapshot-Ablauf und automatische Speicherbereinigung über das automatisch bereitgestellte Dienstkonto des Katalogs authentifiziert, um sich direkt bei Cloud Storage zu authentifizieren und die zugrunde liegenden Datendateien zu aktualisieren.
Unterstützte Suchmaschinen
Wenn Sie die Bereitstellung von Anmeldedaten mit Abfrage-Engines verwenden möchten, müssen Sie den Apache Iceberg REST-Katalogendpunkt in Ihrem Lakehouse-Laufzeitkatalog so konfigurieren, dass die Bereitstellung von Anmeldedaten unterstützt wird. Die Bereitstellung von Anmeldedaten wird für Apache Hive-Katalogendpunkte nicht unterstützt.
- Open-Source-Engines: Unterstützte Engines wie Spark und Trino verwenden kurzlebige Speichertokens, die vom Katalog bereitgestellt werden. Ihre Clientanwendung muss die Unterstützung für die Bereitstellung von Anmeldedaten im
X-Iceberg-Access-Delegation-Header angeben. - BigQuery: BigQuery verwendet für den Zugriff auf Cloud Storage bereitgestellte Anmeldedaten anstelle von Endnutzer-Anmeldedaten.
Erforderliche Dienstkontoberechtigungen
Wenn die Bereitstellung von Anmeldedaten aktiviert ist, müssen die folgenden Dienstkonten die erforderlichen Rollen haben:
- Automatisch bereitgestelltes Dienstkonto für den Lakehouse-Laufzeitkatalog: Sie müssen diesem Konto die Rolle „Storage Object User“ (
roles/storage.objectUser) für alle zugehörigen Cloud Storage-Buckets zuweisen. Ohne diesen Zugriff können die bereitgestellten Anmeldedaten nicht auf den Speicher zugreifen oder darin schreiben. Wenn Sie die Google Cloud Console verwenden, wird diese Rolle durch Klicken auf Bucket-Berechtigungen festlegen bestätigt. Für die gcloud CLI, Terraform oder die API müssen Sie diese Rolle manuell zuweisen. - Dienstkonten für Abfrage-Engines: Dienstkonten, die Abfrage-Engine-Jobs ausführen (z. B. Managed Service for Apache Spark, Managed Service for Apache Spark oder Dataflow), benötigen die Rolle „BigLake-Bearbeiter“ (
roles/biglake.editor), um bereitgestellte Anmeldedaten mit Schreibberechtigung zu erhalten.
Nächste Schritte
- Katalog im Modus für die Bereitstellung von Anmeldedaten erstellen
- Anleitung zum Aktivieren der Bereitstellung von Anmeldedaten für einen vorhandenen Katalog mit derGoogle Cloud Console