


Mit dem Lakehouse-Laufzeitkatalog können Sie Daten in Apache Spark, Apache Hive und BigQuery freigeben, indem Sie einen serverlosen, einheitlichen Metastore bereitstellen. Diese vollständig verwaltete Metadatenebene macht separate, selbst gehostete Hive-Metastores für Open-Source-Arbeitslasten überflüssig.
Diese Integration ist für die Apache Spark-Kompatibilität mit ExternalCatalog optimiert und unterstützt eine Teilmenge der Hive-Metastore-Schnittstelle. Ob Ihre
Arbeitslasten von nicht unterstützten Funktionen wie Transaktionen, Komprimierungen oder
Kerberos abhängen, erfahren Sie im Funktionsvergleich und
unter Einschränkungen.
So wird Hive in den Lakehouse-Laufzeitkatalog eingebunden
Der Hive-Metastore-Endpunkt verwaltet Standard-Apache Hive- und Spark-Tabellen (mit Hive SerDes oder Spark-Datenquellen) anstelle von Apache Iceberg-Tabellen. Um die Verbindung Ihrer Spark-Jobs mit diesem Endpunkt zu vereinfachen, sind Managed Service for Apache Spark-Images mit den erforderlichen Clientbibliotheken und Abhängigkeiten vorkonfiguriert.
Die folgende Sequenz beschreibt, wie Spark eine Verbindung zum Metastore herstellt:
- Apache Spark stellt über die Standard-Apache Hive-Schnittstelle
IMetastoreClienteine Verbindung zu externen Metadatenkatalogen her. - Der Lakehouse-Laufzeitkatalog implementiert einen benutzerdefinierten
IMetastoreClient, um einen vollständig verwalteten Metastore-Dienst für Ihre Spark- und Hive-Metadaten bereitzustellen. - Vorkonfigurierte Managed Service for Apache Spark-Laufzeiten verwenden diesen benutzerdefinierten Client automatisch, um Metadatenvorgänge direkt an den Metastore weiterzuleiten.
Nach der Einrichtung können Sie Ihre mit Spark erstellten Tabellen direkt in BigQuery abfragen. Diese Integration unterstützt verschiedene Speicher formate wie Parquet, ORC, Avro und Delta Lake sowie bestimmte Datentyp zuordnungen zwischen Spark und BigQuery und kundenverwaltete Verschlüsselungsschlüssel (Customer-Managed Encryption Keys, CMEK) für in Cloud Storage gespeicherte Daten.
So wird der Hive-Katalogendpunkt in Google Cloud Dienste eingebunden
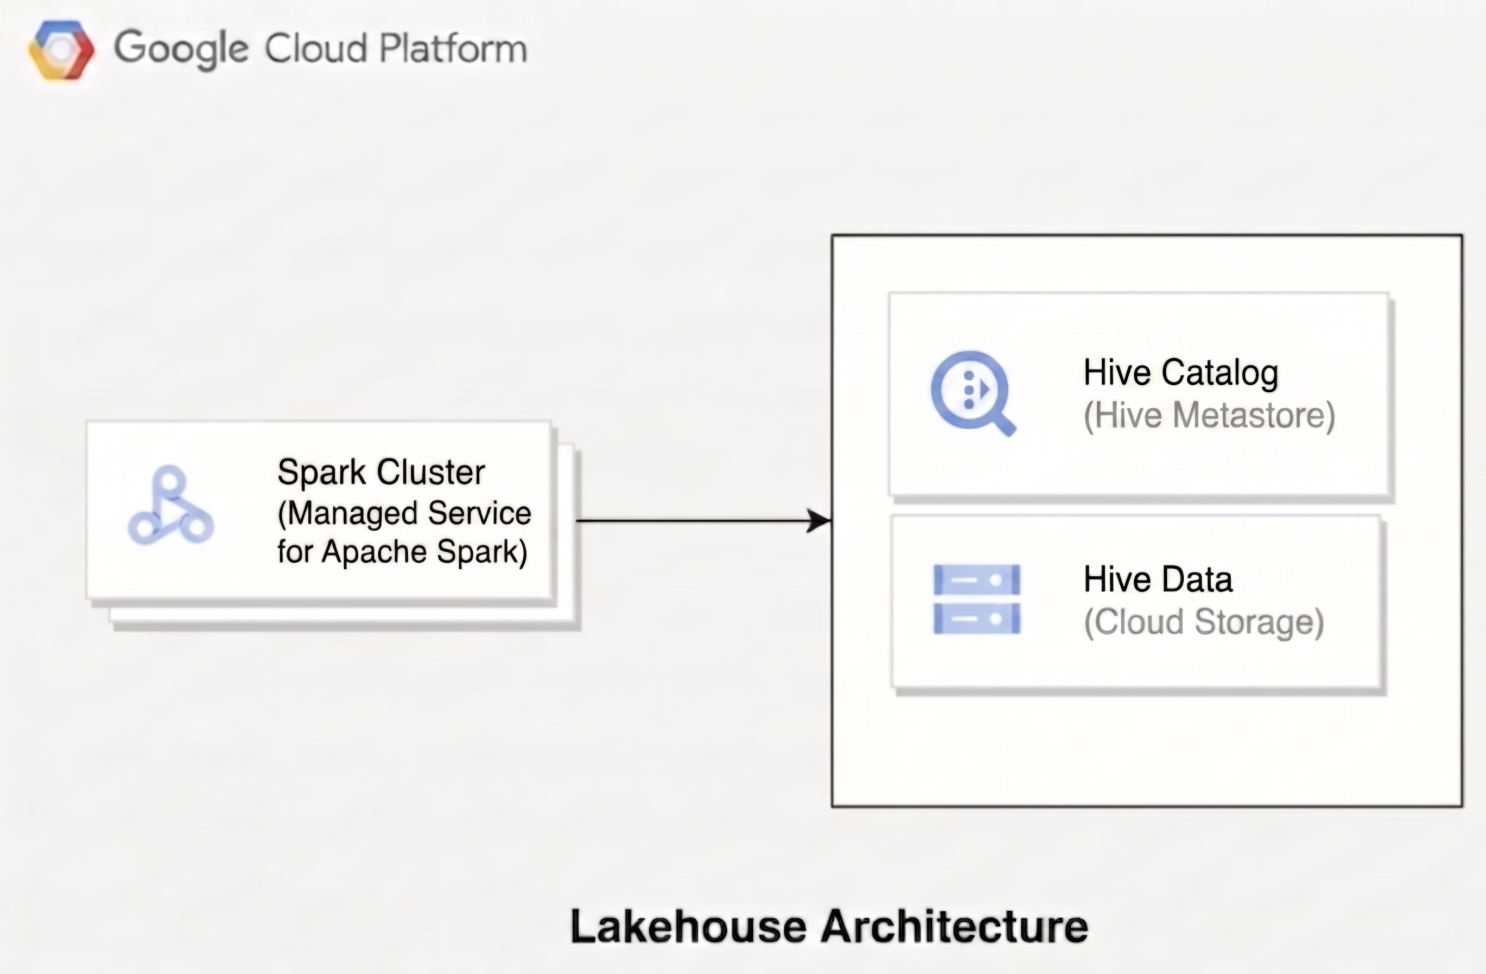
Informationen dazu, wie Borderless Lakehouse Ihre Daten verwaltet, finden Sie unter So wird die Hive-Katalogarchitektur in Google Cloud Dienste eingebunden. Anstatt selbst gehostete Metastores zu verwalten, stellen Ihre Open-Source-Arbeitslasten eine Verbindung zum Lakehouse-Laufzeitkatalog her, um Hive-Datenbank- und Tabellendefinitionen zu verwalten. Die zugrunde liegenden Datendateien werden direkt in Cloud Storage-Warehouse-Verzeichnissen gespeichert.
Das folgende Diagramm veranschaulicht, wie Compute-Engines wie Managed Service for Apache Spark den Lakehouse-Laufzeitkatalog verwenden, um Tabellenmetadaten zu verwalten, während sie zugrunde liegende Datendateien direkt in Hive lesen und schreiben.
Funktionsvergleich mit Hive-Metastore
In der folgenden Tabelle werden Entitäten und Vorgänge in Hive-Metastore und Lakehouse verglichen:
| Entität oder Vorgang | Hive-Metastore | Lakehouse-Laufzeitkatalog |
|---|---|---|
| Katalog | ✅ | ✅ |
| Datenbank (erstellen, löschen, aktualisieren) | ✅ | ✅ |
| Tabelle (erstellen, löschen, aktualisieren) | ✅ | ✅ |
| Partition (hinzufügen, löschen, aktualisieren) | ✅ | ✅ |
| Tabellenberechtigungen | ✅ | ✅ (über Identity and Access Management (IAM)) |
| Partitionsberechtigungen | ✅ | ✅ (über IAM) |
| Benutzerdefinierte Funktionen | ✅ | Nicht unterstützt |
| Bucketing-/Skewing-Spalten | ✅ | Nicht unterstützt |
| Tabellen- und Partitionsspaltenstatistiken | ✅ | Nicht unterstützt |
| Schlüsseleinschränkungen | ✅ | Nicht unterstützt |
| Delegierungstokens (Kerberos) | ✅ | Nicht unterstützt |
| Spaltenberechtigungen | ✅ | Nicht unterstützt |
| Rollen | ✅ | Nicht unterstützt |
| Workload Manager-Ressourcenpläne | ✅ | Nicht unterstützt |
| Transaktionen und Komprimierungen | ✅ | Nicht unterstützt |
Von Dataproc Metastore migrieren
Informationen zum Upgrade und zur Migration Ihrer Metadaten von Dataproc Metastore zum Lakehouse-Laufzeitkatalog finden Sie unter Metadaten von Dataproc Metastore zu Lakehouse migrieren.
Nächste Schritte
- Spark und Hive mit dem Lakehouse-Laufzeitkatalog verwenden.
- Spark mit Deltatabellen einrichten.
- Regionale Lakehouse-Endpunkte verwenden.