


Application Design Center の AI 事前トレーニング済み推論テンプレートを使用すると、Google Kubernetes Engine(GKE)インフラストラクチャをプロビジョニングし、モデル提供ワークロードをデプロイできます。AI 事前トレーニング済み推論 GKE クラスタ テンプレートを使用すると、高パフォーマンスの推論用に安全な限定公開 GKE クラスタを設定できます。その後、AI 事前トレーニング済み推論 GKE ワークロード テンプレート(プレビュー)を使用して、Helm チャートと vLLM サービング エンジンで事前トレーニング済みの Gemma モデルをデプロイできます。ワークロードは、GPU リソース リクエストと、CPU 使用率に基づいてスケーリングする HorizontalPodAutoscaler(HPA)を構成します。
たとえば、次のビジネスニーズに対応するために、クラスタ テンプレートとワークロード テンプレートをデプロイできます。
| 例 | ビジネスニーズ | 実装 |
|---|---|---|
| リアルタイム動画分析 | あるセキュリティ企業が、数百台のカメラからの動画ストリームを処理して、異常や特定のオブジェクトをリアルタイムで検出したいと考えています。 | GPU 対応ノードプールに動画処理モデルをデプロイします。GPU は、同時動画ストリームの高スループット、低レイテンシの要件を処理できます。 |
| 特殊なドキュメント処理 | ある保険会社は、レイアウトや手書きが異なる何千もの日次請求フォームから情報を自動的に抽出する必要があります。 | GKE クラスタを使用してカスタムモデルをホストし、処理中にデータが安全な環境から流出しないようにする。 |
| 大量のレコメンデーション エンジン | e コマース プラットフォームで、年末年始の買い物イベントのピーク時に、パーソナライズされたおすすめ商品をユーザーに提供する必要があります。 | Google Kubernetes Engine Gateway API を使用して、大量のユーザー トラフィックをレコメンデーション モデルにルーティングします。Gateway API は、レイテンシを低下させることなく、急激なトラフィック スパイクを処理できます。 |
アーキテクチャ
次の図は、テンプレートのコンポーネントと接続を示しています。
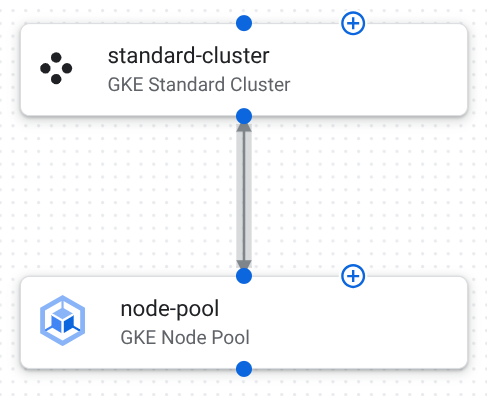
このテンプレートのコンポーネント構成は次のとおりです。
GKE Standard クラスタ: AI ワークロードが実行される安全なプライベート クラスタ。
次の表に、このテンプレートのクラスタ構成を示します。
構成 目的 node_locationsが["us-central1-a", "us-central1-b", "us-central1-c"]に設定されている。クラスタのノードを us-central1リージョンの 3 つのゾーンに分散することで、高可用性と復元力を確保します。enable_intranode_visibilityがtrueに設定されている。VPC フローログで同じノード内の Pod 間トラフィックを可視化できます。この可視性は、ネットワーク モニタリング、トラブルシューティング、セキュリティ分析に必要です。 gateway_api_configは{"channel":"CHANNEL_STANDARD"}を使用して有効にします。GKE Inference Gateway API を使用すると、Kubernetes Service への内向きトラフィックを管理できます。この API を使用すると、きめ細かいルーティング、高度なロード バランシング、一元化されたポリシーの適用を構成できます。 private_cluster_config.enable_private_endpointはfalseに設定されています。private_cluster_config.enable_private_nodesはtrueです。control_plane_endpoints_config.dns_endpoint_config.allow_external_trafficがtrueに設定されている。AI モデルが実行されるワーカーノードにプライベート IP アドレスが割り当てられるようにします。これにより、ノードが公共のインターネットから分離されます。GKE コントロール プレーンは、Virtual Private Cloud(VPC)ネットワークの外部からクラスタを管理できるように、一般公開されるように構成されています。 release_channelが{"channel":"REGULAR"}に設定されている。GKE クラスタが安定した予測可能な更新を受け取るようにし、新機能と信頼性のバランスを取ります。 GKE ノードプール: アプリケーションのコンテナを実行するワーカーノードのグループ。
次の表に、このテンプレートのノードプール構成を示します。
構成 目的 autoscaling.min_node_countは0に設定されています。autoscaling.max_node_countが3に設定されている(デフォルトは100)。AI ワークロードが実行されていないときにノードプールを完全にスケールダウンできるため、アイドル期間の費用を削減できます。スケーリングの上限は、費用とリソース消費の管理に役立ちます。 node_config.guest_acceleratorパラメータが追加されます。gpu_driver_installation_config.gpu_driver_version:が"LATEST"に設定されている。gpu_sharing_configはTIME_SHARINGで有効になっています。max_shared_clients_per_gpu:が2に設定されている。AI 推論タスクに NVIDIA L4 GPU を使用することを指定します。必要な GPU ドライバが自動的にインストールされます。複数の小規模なワークロードで単一の GPU を共有できます。 node_config.machine_typeが"g2-standard-8"に変更されました。このマシンタイプは、L4 GPU を補完するように特別に設計されています。vCPU(8 個)とメモリ(32 GB)は、GPU をサポートし、AI 推論アプリケーションを実行するために作成されています。 node_config.oauth_scopesにはhttps://www.googleapis.com/auth/cloud-platformが含まれます。ノードのサービス アカウントには Google Cloud サービスへの広範なアクセス権があり、ロギング、モニタリング、コンテナ イメージの pull などのタスクで API を操作できます。 node_config.shielded_instance_config.enable_secure_bootがtrueに設定されている。セキュアブートは、ブートローダーとカーネルの実行前に暗号署名を検証することで、ブートレベルのマルウェアからノードを保護します。
Helm チャートの構成
次の表に、GKE で AI 推論サービスをデプロイしてスケーリングするためにカスタマイズされた Helm チャートの構成を示します。
| 構成 | 目的 |
|---|---|
replicaCount: 1 |
1 つの初期レプリカを作成します。 |
image.repository: vllm/vllm-openai |
大規模言語モデル(LLM)推論用に最適化されたライブラリである vLLM イメージを使用し、OpenAI 互換の API を使用して公開します。 |
model.id: google/gemma-7b-it |
Gemma 7B の指示チューニング済みモデルを、サービングするモデルとして定義します。 |
model.hfSecret: hf-secret |
モデルが、安全な認証情報管理のために Kubernetes Secret を使用した認証を必要とすることを示します。 |
resources.limits、requests(nvidia.com/gpu: "1") |
各 Pod が専用の GPU を取得できるようにします。 |
nodeSelector.cloud.google.com/gke-accelerator: nvidia-l4 |
AI モデル Pod が、費用対効果に優れた高パフォーマンスの推論に最適な NVIDIA L4 GPU を搭載した GKE Standard ノードにのみスケジュールされるようにします。 |
hpa.enabled: true |
HorizontalPodAutoscaler を有効にします。これにより、アプリケーションは targetCPUUtilizationPercentage: 80% に基づいて Pod の数(minReplicas: 1~maxReplicas: 10)を自動スケーリングできます。ピーク負荷時のパフォーマンスと、使用率が低いときの費用対効果を確保します。 |
tensorParallelSize: 1 |
モデルが単一の Pod 内の複数の GPU に分割されていないことを示します。 |
maxModelLen: 512 |
Gemma 7B モデルが処理できる最大シーケンス長を制御します。 |
service.type: ClusterIP |
サービスは、クラスタ内での内部アクセス用に構成されています。 |
pdb.enabled: true と minAvailable: 1 |
高可用性を確保するために、Pod Disruption Budget が有効になっている。ノードのメンテナンスなどの自発的な中断中も、AI モデルのレプリカが少なくとも 1 つは使用可能な状態を維持します。 |
AI アプリケーションを作成する
AI 事前トレーニング済み推論 GKE クラスタとワークロード テンプレートを使用して、AI アプリケーションをデプロイします。
AI インフラストラクチャをデプロイする
AI 事前トレーニング済み推論 GKE クラスタ テンプレートを構成してデプロイし、AI ワークロードが実行される基盤となるインフラストラクチャを作成します。
AI 事前トレーニング済み推論 GKE クラスタ テンプレートを複製してデプロイします。
選択したデプロイ プロジェクトに GKE クラスタが作成されます。
コンポーネントを構成します。詳しくは以下をご覧ください。
[デプロイ] をクリックします。数分後にアプリケーションがデプロイされます。
[アプリケーションの詳細] パネルで、[出力] タブをクリックします。
アプリケーションの cluster_id を特定します。この情報は、Helm チャートをデプロイするときに使用します。
AI ワークロードをデプロイする
AI 事前トレーニング済み推論 GKE ワークロード テンプレートを使用して、作成したクラスタに AI ワークロードをデプロイします。AI ワークロード構成を含む Helm チャートをデプロイします。
[Google カタログ] ページの [AI 事前トレーニング済み推論 GKE ワークロード] テンプレートで、[新しいアプリケーションを作成] をクリックします。
[名前] フィールドに、アプリケーションの一意の名前を入力します。
[GKE Deployment Target] 領域で、次の操作を行います。
[プロジェクト リスト] から、AI Pre-trained Inference GKE cluster アプリケーションから GKE クラスタをデプロイしたプロジェクトを選択します。
[リージョン] リストから、GKE クラスタをデプロイしたリージョンを選択します。
[クラスタ] リストから、デプロイされた GKE クラスタを選択します。
[Namespace] リストから、GKE クラスタをデプロイした Namespace を入力します。名前を変更していない場合は、「
default」と入力します。[アプリケーションを作成] をクリックします。
アプリケーションが作成され、構成ファイルが表示されます。
[Helm チャート] パネルで、次の操作を行います。
構成の詳細を確認します。
省略可: 独自のニーズに合わせて構成をカスタマイズします。
Helm チャートをクラスタにデプロイするには、[デプロイ] をクリックします。
詳しい手順については、アプリケーションをデプロイするをご覧ください。
数分後、Helm チャート構成が GKE クラスタにデプロイされます。
次のステップ
- テンプレートを複製してカスタマイズする方法については、クイックスタート: Google テンプレートをカスタマイズしてデプロイするをご覧ください。
- アプリケーション テンプレートを設計して、独自の構成を定義します。
- Google Cloud アーキテクチャ フレームワークで、一般的なアーキテクチャのベスト プラクティスを確認する。