


當您在修改其他變數時,將輸送量隨時間繪製成圖表,通常會看到輸送量增加,直到輸送量達到資源耗盡的程度為止。
下圖顯示一般的處理量調度資源圖表。隨著用戶端數量增加,工作負載和輸送量也會增加,直到所有資源耗盡為止。
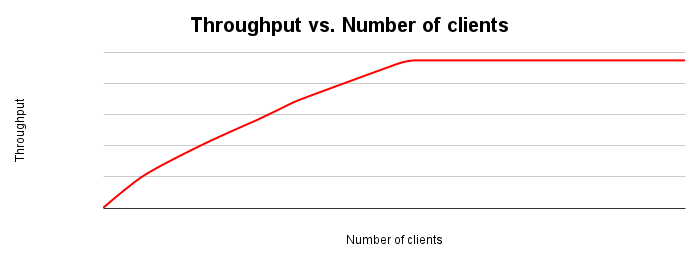
理想情況下,當系統負載增加一倍時,處理量也應增加一倍。在實際情況中,資源會發生爭用,導致處理量增幅較小。在某個時間點,資源耗盡或爭用會導致輸送量趨於平緩,甚至減少。如果您要最佳化處理量,請務必找出這個關鍵點,因為這會引導您調整應用程式或資料庫系統,以提高處理量。
處理量趨於平穩或下降的常見原因包括:
- 資料庫伺服器的 CPU 資源耗盡
- 用戶端 CPU 資源耗盡,因此資料庫伺服器不會收到更多工作
- 資料庫鎖定爭用
- 資料超過 Postgres 緩衝區集區大小時的 I/O 等待時間
- 儲存引擎使用率導致的 I/O 等待時間
- 將資料傳回用戶端時,網路頻寬出現瓶頸
延遲時間和輸送量成反比。延遲時間越長,處理量就越低。這很符合直覺。瓶頸開始出現時,作業時間會變長,系統每秒執行的作業數量也會減少。
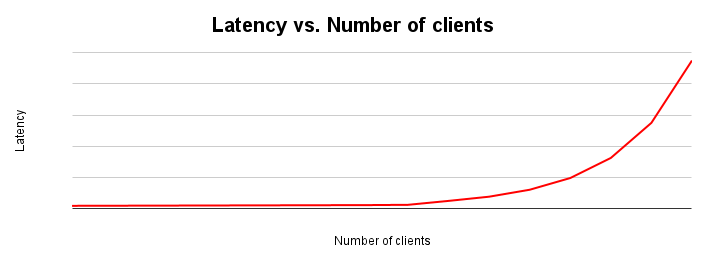
延遲時間擴充圖表顯示延遲時間如何隨著系統負載增加而變化。在因資源爭用而發生摩擦之前,延遲會保持相對恆定。這條曲線的轉折點通常對應於處理量縮放圖中的處理量曲線趨平。
評估延遲的另一種實用方式是使用直方圖。在這個表示法中,我們會將延遲時間分組到值區中,並計算每個值區中的要求數量。
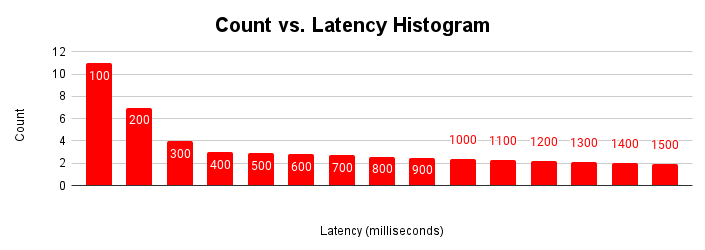
這個延遲時間直方圖顯示,大多數要求都在 100 毫秒內完成,且延遲時間超過 100 毫秒。瞭解延遲時間較長的請求原因,有助於解釋應用程式效能的變化。延遲時間增加的長尾效應,與一般延遲時間縮放圖中延遲時間增加,以及輸送量圖趨於平緩的情況相符。
如果應用程式有多種模態,延遲時間直方圖就非常實用。模式是一組正常的操作條件。舉例來說,應用程式大部分時間都在存取緩衝區快取中的頁面。應用程式通常會更新現有資料列,但可能有多種模式。有時,應用程式會從儲存空間擷取頁面、插入新資料列,或發生鎖定爭用。
當應用程式隨著時間推移遇到這些不同的作業模式時,延遲時間直方圖會顯示這些多重模態。
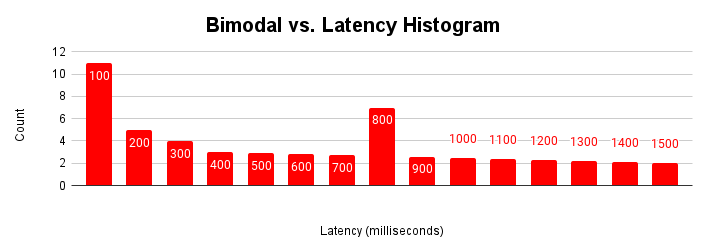
這張圖顯示典型的雙峰直方圖,其中大部分要求都在 100 毫秒內處理完畢,但另一個要求叢集則需要 401 到 500 毫秒。瞭解第二種模態的原因,有助於提升應用程式的效能。也可以有超過兩種模式。
第二種模式可能是因為正常的資料庫作業、異質基礎架構和拓撲,或是應用程式行為。以下提供幾個範例:
- 大部分資料存取作業都是從 PostgreSQL 緩衝區集區進行,但有些作業是從儲存空間進行
- 部分用戶端與資料庫伺服器之間的網路延遲時間差異
- 根據輸入內容或時間執行不同作業的應用程式邏輯
- 偶發性鎖定爭用
- 用戶端活動量暴增