


כדי לשמור על פעולות רציפות של מסד הנתונים AlloyDB Omni ולמזער את זמן ההשבתה, חשוב לוודא שההגדרה של Patroni לזמינות גבוהה היא אמינה ואיכותית. בדף הזה מוסבר איך לבדוק את אשכול Patroni, כולל תרחישי כשל שונים, עקביות הרפליקציה ומנגנוני יתירות כשל.
בדיקת ההגדרה של Patroni
מתחברים לכל אחד ממופעי patroni (
alloydb-patroni1, alloydb-patroni2אוalloydb-patroni3) ועוברים לתיקיית patroni של AlloyDB Omni.cd /alloydb/
בודקים את היומנים של Patroni.
sudo journalctl -u patroni
הערכים האחרונים צריכים לשקף מידע על צומת Patroni. אמורה להופיע הודעה דומה לזו שכאן למטה.
May 16 15:10:29 alloydb-patroni1 patroni[1234]: 2024-06-12 15:10:29,020 INFO: no action. I am (patroni1), the leader with the lock
May 16 15:10:39 alloydb-patroni1 patroni[1234]: 2024-06-12 15:10:39,010 INFO: no action. I am (patroni1), the leader with the lock
May 16 15:10:49 alloydb-patroni1 patroni[1234]: 2024-06-12 15:10:49,007 INFO: no action. I am (patroni1), the leader with the lock
מתחברים לכל מופע שמריץ Linux שיש לו קישוריות לרשת למופע Patroni הראשי,
alloydb-patroni1, ומקבלים מידע על המופע. יכול להיות שתצטרכו להתקין את הכליjqעל ידי הפעלתsudo dnf install jq.curl -s http://alloydb-patroni1:8008/patroni | jq .
הפלט אמור להיראות כך:
{
  "state": "running",
  "postmaster_start_time": "2024-05-16 14:12:30.031673+00:00",
  "role": "master",
  "server_version": 150005,
  "xlog": {
    "location": 83886408
  },
  "timeline": 1,
  "replication": [
    {
      "usename": "alloydbreplica",
      "application_name": "patroni2",
      "client_addr": "10.172.0.40",
      "state": "streaming",
      "sync_state": "async",
      "sync_priority": 0
    },
    {
      "usename": "alloydbreplica",
      "application_name": "patroni3",
      "client_addr": "10.172.0.41",
      "state": "streaming",
      "sync_state": "async",
      "sync_priority": 0
    }
  ],
  "dcs_last_seen": 1715870011,
  "database_system_identifier": "7369600155531440151",
  "patroni": {
    "version": "3.3.0",
    "scope": "my-patroni-cluster",
    "name": "patroni1"
  }
}
כשמבצעים קריאה לנקודת קצה ל-API של Patroni HTTP בצומת Patroni, נחשפים פרטים שונים על המצב וההגדרה של מופע PostgreSQL מסוים שמנוהל על ידי Patroni, כולל מידע על מצב האשכול, ציר הזמן, מידע על WAL ובדיקות תקינות שמציינות אם הצמתים והאשכול פועלים בצורה תקינה.
בדיקת ההגדרה של HAProxy
במחשב עם דפדפן וקישוריות לרשת של צומת HAProxy, עוברים לכתובת הבאה:
http://haproxy:7000. לחלופין, אתם יכולים להשתמש בכתובת ה-IP החיצונית של מכונת HAProxy במקום בשם המארח שלה.המסך אמור להיראות כמו בצילום המסך הבא.
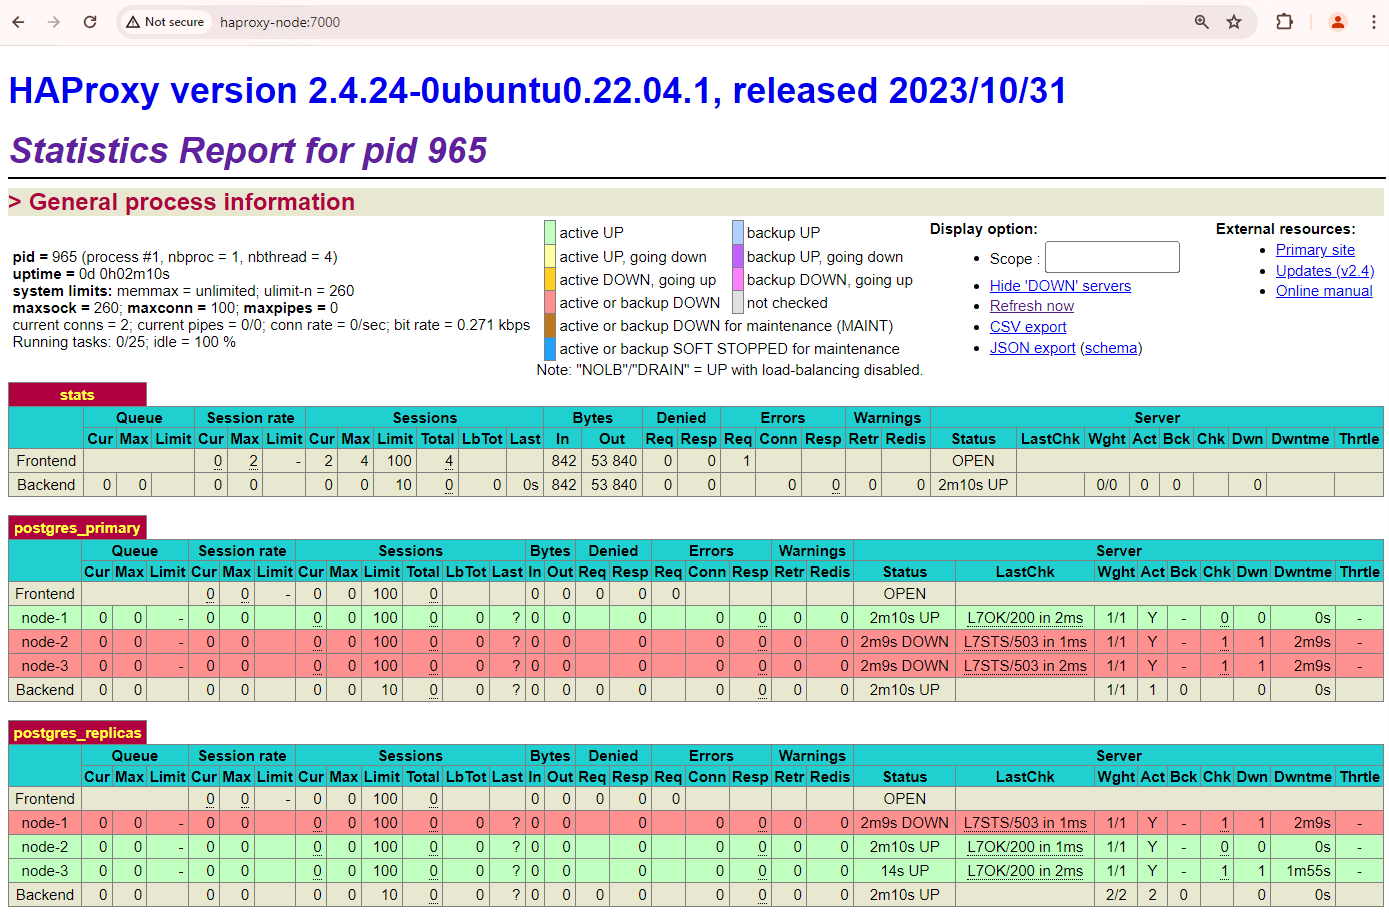
איור 1. דף הסטטוס של HAProxy שבו מוצגים סטטוס התקינות וזמן האחזור של צמתי Patroni.
בלוח הבקרה של HAProxy אפשר לראות את סטטוס התקינות ואת זמן האחזור של צומת Patroni הראשי,
patroni1, ושל שתי הרפליקות,patroni2ו-patroni3.אפשר להריץ שאילתות כדי לבדוק את נתוני השכפול באשכול. מלקוח כמו pgAdmin, מתחברים לשרת מסד הנתונים הראשי דרך HAProxy ומריצים את השאילתה הבאה.
SELECT
      pid, usename, application_name, client_addr, state, sync_state
FROM
      pg_stat_replication;
אמורה להופיע דיאגרמה דומה לזו שכאן למטה, שמראה ש-
patroni2ו-patroni3מעבירים סטרימינג מ-patroni1.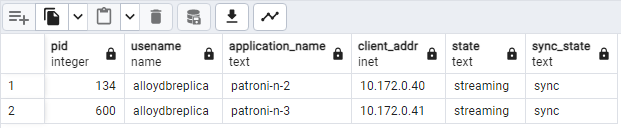
איור 2. פלט של pg_stat_replication שמציג את מצב הרפליקציה של צומתי Patroni.
בדיקת מעבר אוטומטי לגיבוי (failover)
בקטע הזה, באשכול של שלושת הצמתים, אנחנו מדמים הפסקת חשמל בצומת הראשי על ידי עצירת הקונטיינר הפועל של Patroni שמחובר אליו. אפשר לעצור את שירות Patroni בצומת הראשי כדי לדמות הפסקה, או לאכוף כמה כללי חומת אש כדי לעצור את התקשורת לצומת הזה.
במכונה הראשית של Patroni, עוברים לתיקייה AlloyDB Omni Patroni.
cd /alloydb/
עוצרים את הקונטיינר.
sudo systemctl stop patroni
הפלט שיוצג יהיה דומה לזה שמופיע בהמשך. כך אפשר לוודא שהקונטיינר והרשת הופסקו.
patroni.service - Runner for Patroni
   Loaded: loaded (/etc/systemd/system/patroni.service; enabled; vendor preset: disabled)
   Active: inactive (dead) since ...
מרעננים את לוח הבקרה של HAProxy ורואים איך מתבצע מעבר הגיבוי האוטומטי.
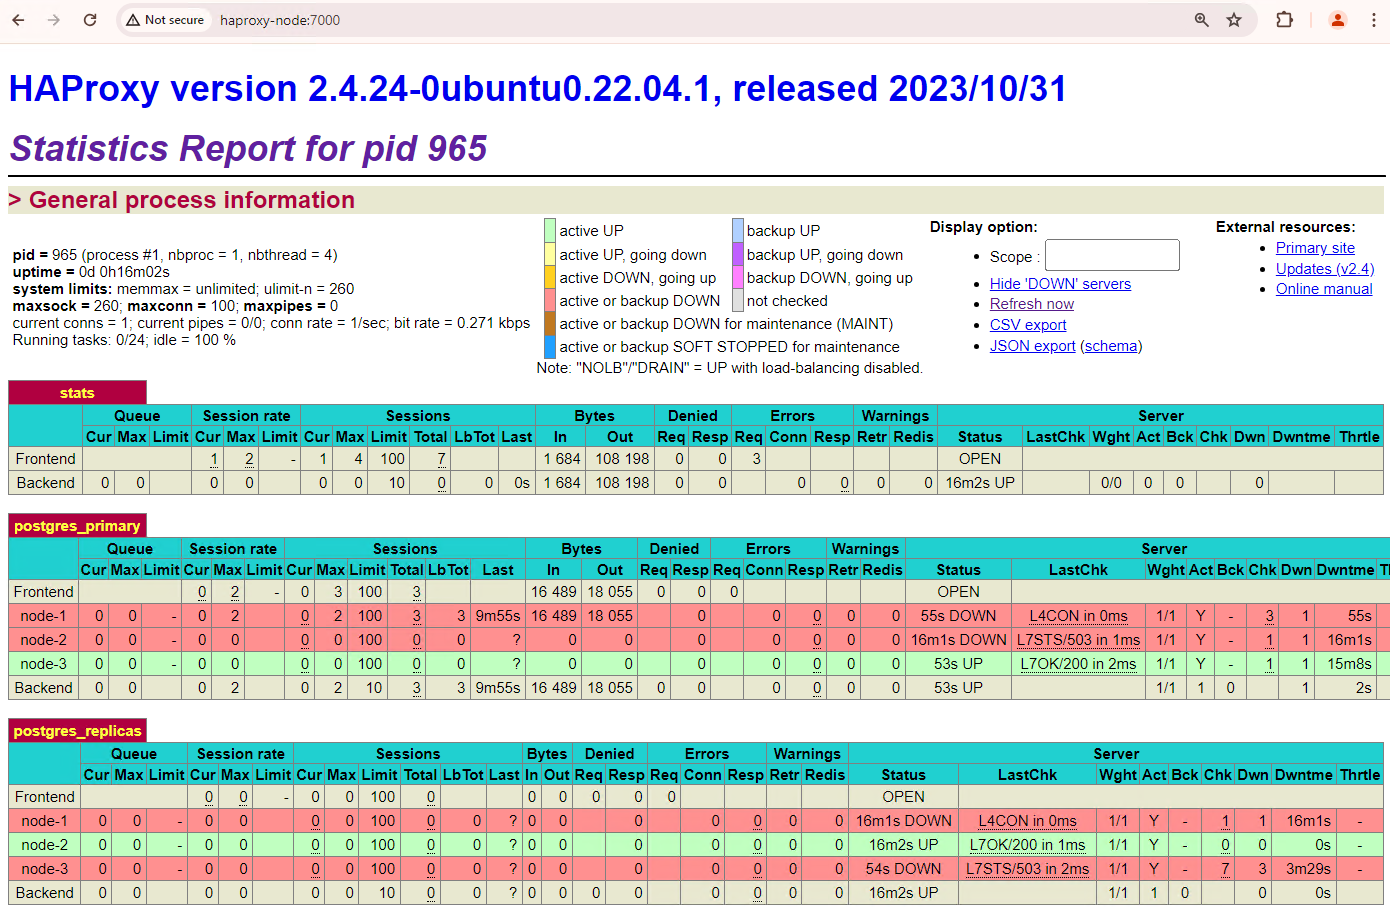
איור 3. לוח הבקרה של HAProxy שבו מוצג מעבר לגיבוי בעת כשל מהצומת הראשי לצומת ההמתנה.
מכונה
patroni3הפכה למכונה הראשית החדשה, ו-patroni2היא הרפליקה היחידה שנותרה. השרת הראשי הקודם,patroni1, מושבת ובדיקות התקינות שלו נכשלות.Patroni מבצע ומנהל את יתירות הכשל באמצעות שילוב של מעקב, קונצנזוס ותזמור אוטומטי. ברגע שהצומת הראשי לא מצליח לחדש את החכירה שלו בתוך פרק זמן קצוב, או אם הוא מדווח על כשל, הצמתים האחרים באשכול מזהים את המצב הזה באמצעות מערכת הקונצנזוס. הצמתים הנותרים מתואמים כדי לבחור את הרפליקה המתאימה ביותר לקידום כעותק הראשי החדש. אחרי שבוחרים רפליקה מועמדת, Patroni מקדם את הצומת הזה לראשי על ידי החלת השינויים הנדרשים, כמו עדכון ההגדרות של PostgreSQL והפעלה מחדש של רשומות WAL שנותרו. לאחר מכן, הצומת הראשי החדש מעדכן את מערכת הקונצנזוס לגבי הסטטוס שלו, והרפליקות האחרות מגדירות את עצמן מחדש כדי לעקוב אחרי הצומת הראשי החדש, כולל החלפת מקור השכפול ואולי גם השלמת פערים עם טרנזקציות חדשות. HAProxy מזהה את המכונה הראשית החדשה ומפנה את החיבורים של הלקוחות בהתאם, כדי להבטיח הפרעה מינימלית.
מלקוח כמו pgAdmin, מתחברים לשרת של מסד הנתונים דרך HAProxy ובודקים את נתוני הרפליקציה באשכול אחרי יתירות כשל.
SELECT
      pid, usename, application_name, client_addr, state, sync_state
FROM
      pg_stat_replication;
אמורה להופיע דיאגרמה דומה לזו שכאן למטה, שבה רואים שרק
patroni2משדר עכשיו.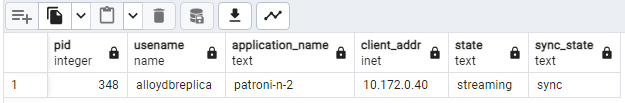
איור 4. פלט של pg_stat_replication שמציג את מצב הרפליקציה של צומתי Patroni אחרי יתירות כשל.
האשכול עם שלושת הצמתים יכול לשרוד עוד הפסקת חשמל אחת. אם מפסיקים את הצומת הראשי הנוכחי,
patroni3, מתבצעת העברה אוטומטית נוספת.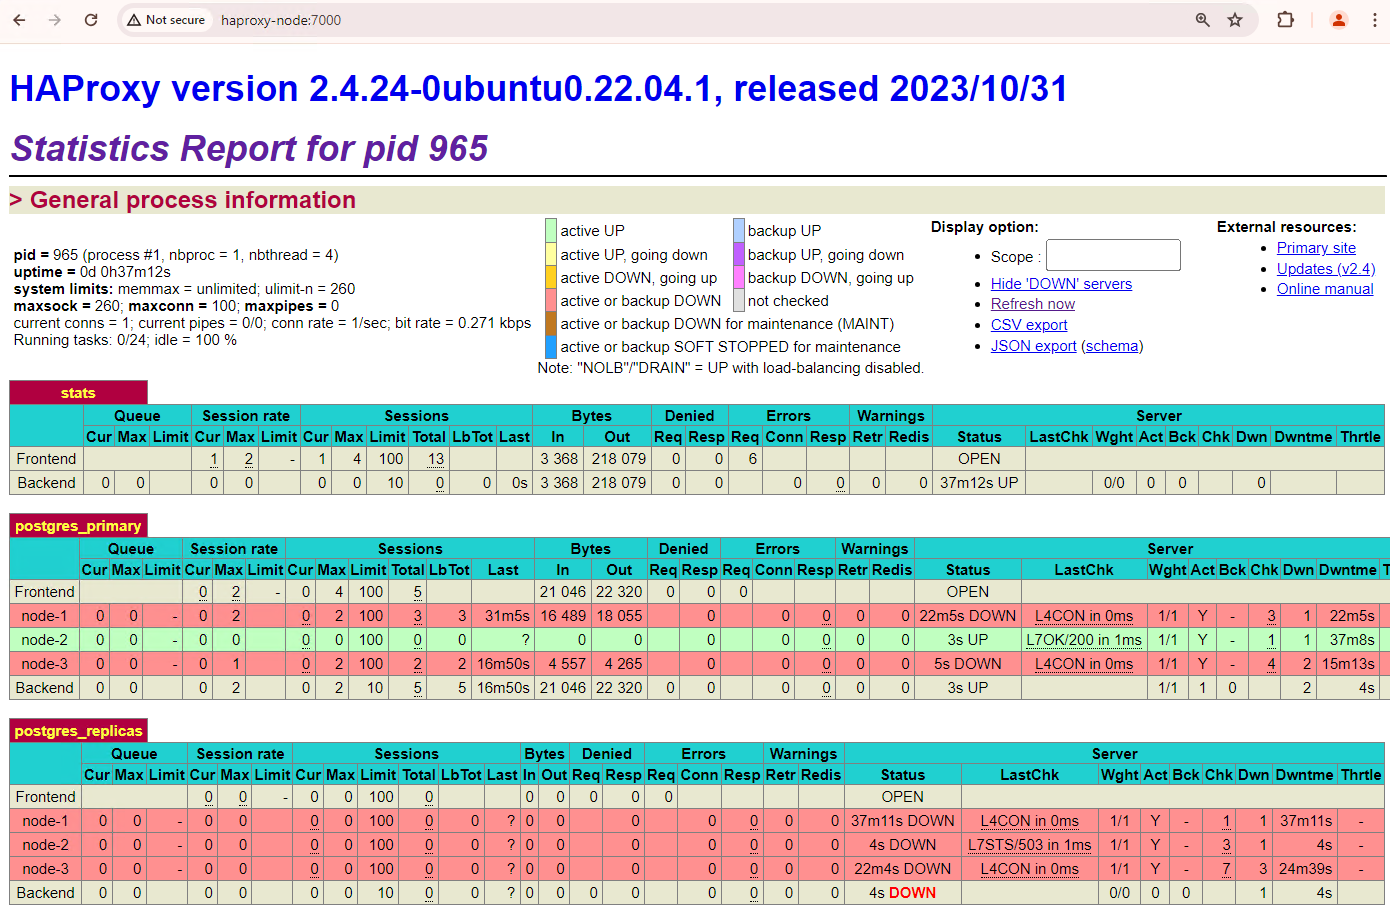
איור 5. לוח הבקרה של HAProxy שבו מוצג מעבר הגיבוי מהצומת הראשי,
patroni3, לצומת ההמתנה,patroni2.
שיקולים לגבי גיבוי
חזרה למצב הקודם היא התהליך שבו מחזירים את צומת המקור הקודם אחרי שהתרחשה יתירות כשל. בדרך כלל לא מומלץ להשתמש במנגנון חלופי אוטומטי באשכול של מסדי נתונים עם זמינות גבוהה, בגלל כמה בעיות קריטיות, כמו שחזור חלקי, סיכון לתרחישים של פיצול מוח (split-brain) ועיכוב ברפליקציה.
באשכול Patroni, אם תפעילו את שני הצמתים שבהם דימיתם הפסקה, הם יצטרפו מחדש לאשכול כרפליקות במצב המתנה.
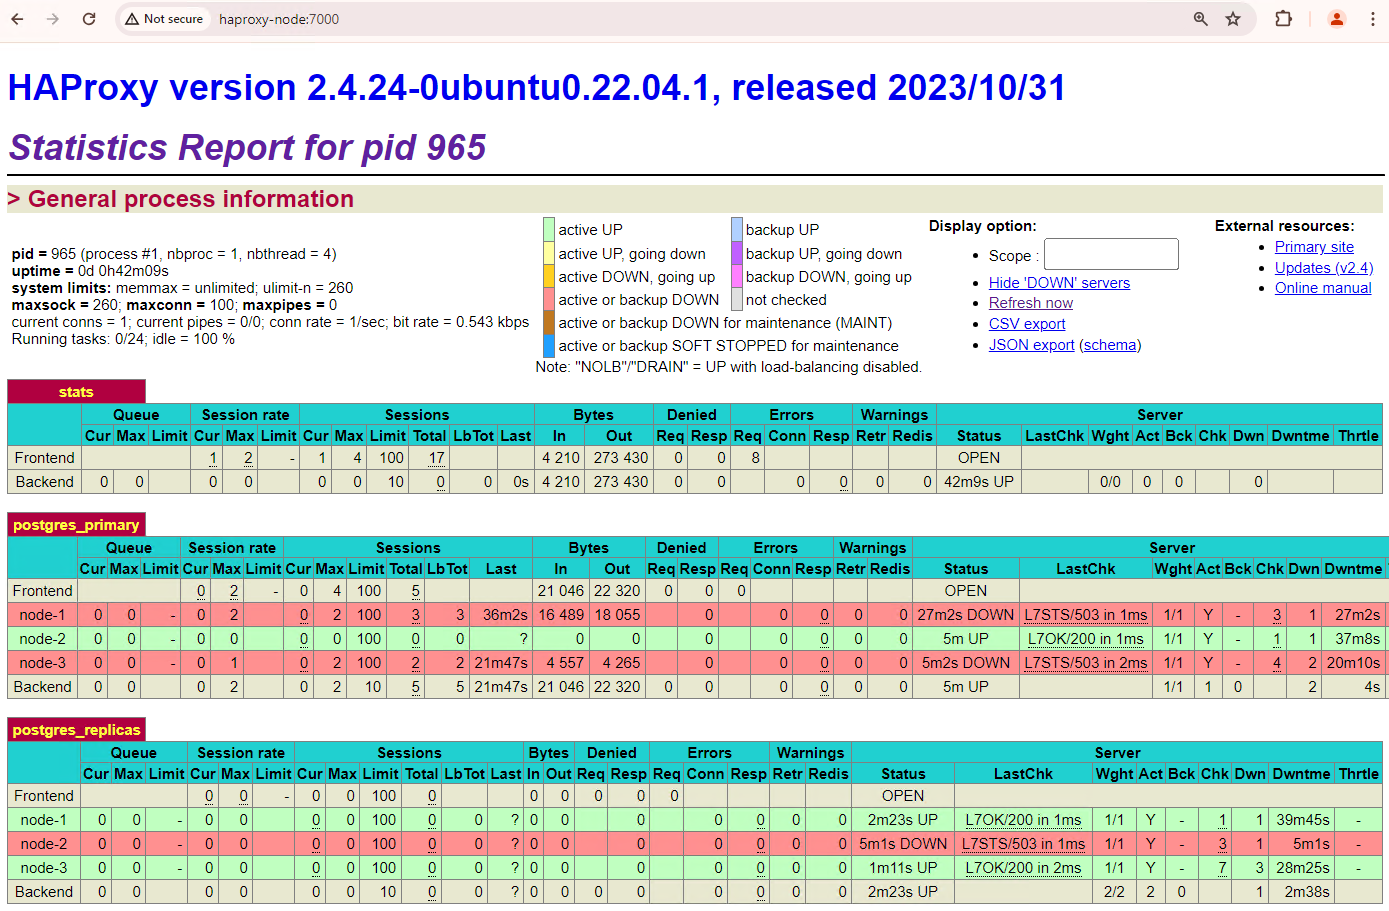
איור 6. לוח הבקרה של HAProxy שבו מוצג השחזור של patroni1 ו-patroni3 כצמתים במצב המתנה.
עכשיו patroni1 ו-patroni3 משוכפלים מהמכונה הראשית הנוכחית patroni2.
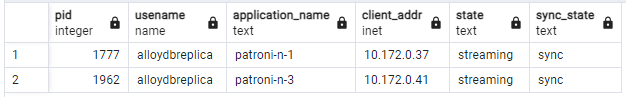
איור 7. פלט של pg_stat_replication שמציג את מצב הרפליקציה של צומתי Patroni אחרי החזרה למצב הקודם.
אם רוצים לחזור באופן ידני לשרת הראשי המקורי, אפשר לעשות זאת באמצעות ממשק שורת הפקודה patronictl. אם תבחרו במעבר ידני לגיבוי, תוכלו להבטיח תהליך שחזור אמין, עקבי ומאומת ביסודיות, ולשמור על התקינות והזמינות של מערכות מסדי הנתונים.