


כדי לזהות ולנתח צווארי בקבוק בביצועי השאילתות, לבדוק את תוכניות לביצוע שאילתה ולעקוב אחרי בקשות עם זמן אחזור גבוה במכונות AlloyDB ל-PostgreSQL, אתם יכולים להשתמש במרכז הבקרה Query Insights. לסקירה כללית של התכונה, ראו סקירה כללית של תובנות לגבי שאילתות.
אתם יכולים להיעזר ב-Gemini Cloud Assist כדי לעקוב אחרי המשאבים של AlloyDB ולפתור בעיות שקשורות אליהם. למידע נוסף, קראו את המאמר מעקב ופתרון בעיות בעזרת Gemini.
לפני שמתחילים
אם אתם או משתמשים אחרים צריכים לראות את התוכנית לביצוע השאילתה או לבצע מעקב מקצה לקצה, אתם צריכים הרשאות ספציפיות של ניהול זהויות והרשאות גישה (IAM). אתם יכולים ליצור תפקיד בהתאמה אישית ולהוסיף לו את הרשאות ה-IAM הנדרשות. אחרי שיוצרים את התפקיד, אפשר להוסיף אותו לכל חשבון משתמש שמשתמש בתובנות לגבי שאילתות כדי לפתור בעיות. איך יוצרים תפקיד בהתאמה אישית
לתפקיד בהתאמה אישית צריכה להיות הרשאת ה-IAM הבאה: cloudtrace.traces.get.
פתיחת לוח הבקרה של תובנות לגבי שאילתות
כדי לפתוח את לוח הבקרה של תובנות לגבי שאילתות:
- ברשימת האשכולות והמכונות, לוחצים על מכונה.
- לוחצים על Go to Query insights for more in-depth info on queries and performance מתחת לתרשים המדדים בדף הסקירה הכללית של האשכול, או בוחרים בכרטיסייה Query insights בחלונית הניווט הימנית.
בדף הבא, אתם יכולים להשתמש באפשרויות הבאות כדי לסנן את התוצאות:
- בורר המופעים. מאפשר לבחור את המכונה הראשית או את המכונות של מאגר הקריאה באשכול. כברירת מחדל, המכונה הראשית נבחרת. הפרטים שמוצגים הם נתונים מצטברים של כל המכונות המחוברות של מאגר הקריאה והצמתים שלהן.
- מסד נתונים. מסנן את עומס השאילתות במסד נתונים ספציפי או בכל מסדי הנתונים.
- משתמש. מסנן את עומס השאילתות מחשבונות משתמשים ספציפיים.
- כתובת הלקוח. מסנן את עומס השאילתות מכתובת IP ספציפית.
- טווח תאריכים. מסנן את עומס השאילתות לפי טווחי תאריכים, כמו שעה, יום, שבוע או טווח בהתאמה אישית.
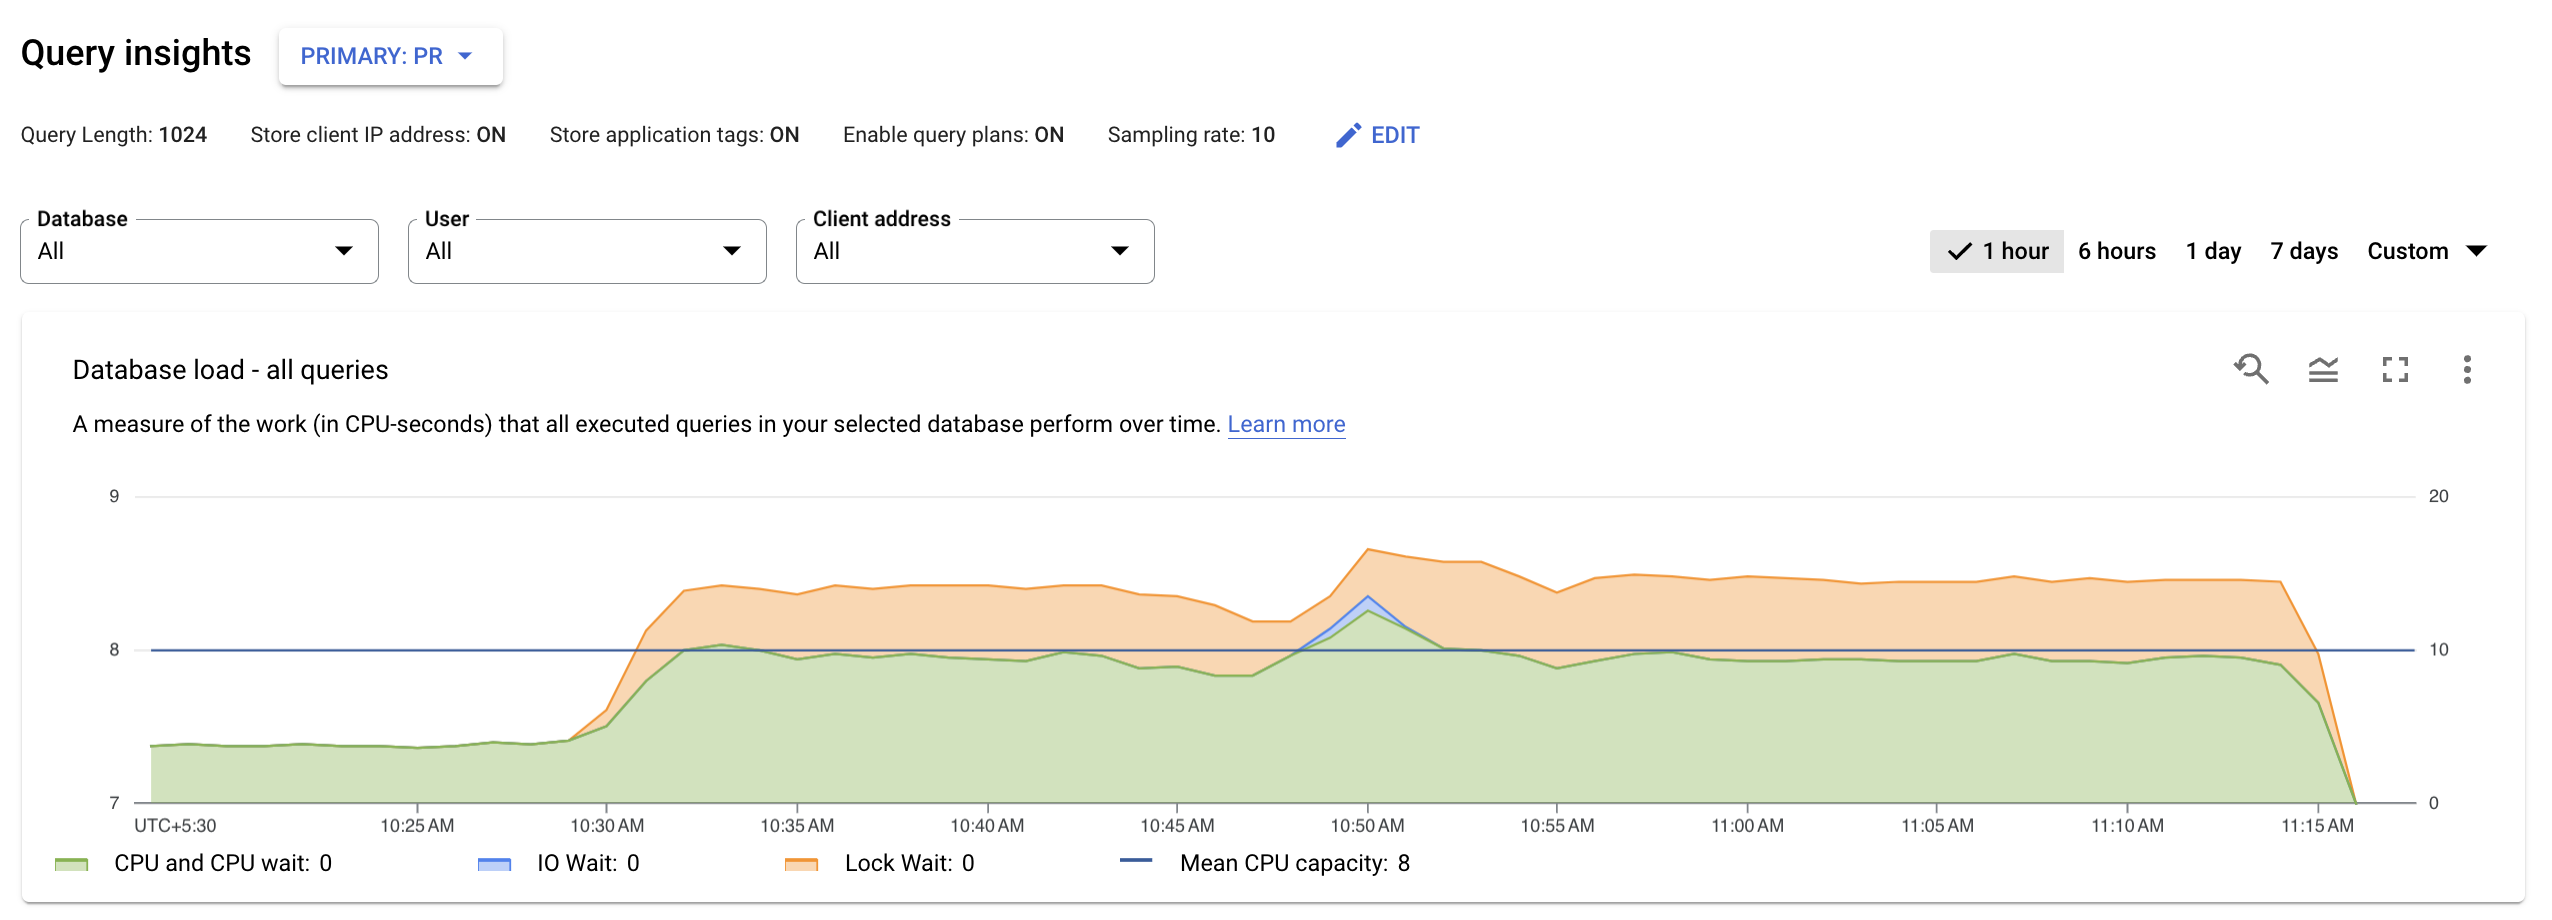
עריכת ההגדרות של תובנות לגבי שאילתות
כברירת מחדל, תובנות לגבי שאילתות מופעלות במכונות AlloyDB. אתם יכולים לערוך את הגדרות ברירת המחדל של תובנות לגבי שאילתות.
כדי לערוך את ההגדרות של Query Insights במכונה של AlloyDB:
המסוף
נכנסים לדף Clusters במסוף Google Cloud .
לוחצים על אשכול בעמודה Resource Name.
בחלונית הניווט שמימין, לוחצים על Query insights.
בוחרים באפשרות Primary או Read pool מהרשימה Query insights ולוחצים על Edit.
עורכים את השדות של Query insights:
כדי לשנות את מגבלת ברירת המחדל של 1,024 בייטים באורך השאילתות לניתוח ב-AlloyDB, בשדה Query lengths מזינים מספר בין 256 ל-4,500.
המכונה תופעל מחדש אחרי שתערכו את השדה הזה.
הערה: מגבלות אורך שאילתה גבוהות יותר דורשות יותר זיכרון.
כדי להתאים אישית את קבוצות התכונות של תובנות לגבי שאילתות, משנים את האפשרויות הבאות:
דגימה של תוכנית לביצוע שאילתה: מסמנים את התיבה הזו כדי להציג באופן חזותי את הפעולות שבוצעו כדי להשלים דגימה של שאילתה. תדירות הדגימה קובעת את המספר המקסימלי של שאילתות ש-AlloyDB יכול לדגום בכל דקה למכונה לכל צומת.
בשדה תדירות הדגימה המקסימלית, מזינים מספר מ-1 עד 20. כברירת מחדל, תדירות הדגימה מוגדרת ל-5. כדי להשבית את דגימת תוכנית לביצוע שאילתה, מבטלים את הסימון בתיבה Query plan sampling.
שמירת כתובות ה-IP של הלקוחות: מסמנים את התיבה הזו כדי לדעת מאיפה מגיעות השאילתות, ולקבץ את המידע הזה כדי להריץ מדדים.
Store application tags: מסמנים את התיבה הזו כדי לדעת אילו אפליקציות מתויגות שולחות בקשות, ולקבץ את המידע הזה כדי להריץ מדדים. מידע נוסף על תגי אפליקציות זמין במפרט.
לוחצים על Update instance.
gcloud
כדי להפעיל את התובנות לגבי שאילתות במכונה של AlloyDB באמצעות פקודות של Google Cloud CLI:
- התקינו את ה-CLI של Google Cloud.
- כדי לאתחל את ה-CLI של gcloud, הריצו את הפקודה הבאה:
gcloud init
אם אתם משתמשים במעטפת מקומית, צרו פרטי כניסה לאימות מקומי בחשבון המשתמש:
gcloud auth application-default login
אם אתם משתמשים ב-Cloud Shell, אתם לא צריכים לעשות את זה.
למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
הנה דוגמה:
gcloud alloydb instances update INSTANCE \
--cluster=CLUSTER \
--project=PROJECT \
--region=REGION \
--insights-config-query-string-length=QUERY_LENGTH \
--insights-config-query-plans-per-minute=QUERY_PLANS \
--insights-config-record-application-tags \
--insights-config-record-client-address
מחליפים את מה שכתוב בשדות הבאים:
-
INSTANCE: המזהה של המכונה שרוצים לעדכן -
CLUSTER: המזהה של אשכול המכונה -
PROJECT: מזהה הפרויקט של האשכול -
REGION: האזור של האשכול, למשלus-central1 -
QUERY_LENGTH: אורך השאילתה, בין 256 ל-4,500 -
QUERY_PLANS: מספר התוכניות לביצוע שאילתות שצריך להגדיר בכל דקה.
אפשר גם להשתמש באחד או יותר מהדגלים האופציונליים הבאים:
-
--insights-config-query-string-length: מגדיר את מגבלת ברירת המחדל של אורך השאילתה לערך שצוין, בין 256 ל-4,500 בייטים. אורך השאילתה שמוגדר כברירת מחדל הוא 1,024 בייטים. שאילתות ארוכות יותר שימושיות יותר לשאילתות ניתוח, אבל הן גם דורשות יותר זיכרון. כדי לשנות את אורך השאילתה, צריך להפעיל מחדש את המכונה. אפשר להוסיף תגים לשאילתות שחורגות ממגבלת האורך. -
--insights-config-query-plans-per-minute: כברירת מחדל, נלכדות עד חמש דגימות של תוכניות לביצוע שאילתות בכל דקה בכל מסדי הנתונים במכונה. צריך לשנות את הערך הזה למספר בין 1 ל-20. כדי להשבית את הדגימה, מזינים 0. הגדלת תדירות הדגימה עשויה לספק יותר נקודות על הגרף, אבל עלולה להוסיף תקורה לביצועים. -
--insights-config-record-client-address: מאחסן את כתובות ה-IP של הלקוחות שמהן מגיעות השאילתות, ועוזר לכם לקבץ את הנתונים האלה כדי להריץ עליהם מדדים. השאילתות מגיעות מיותר ממארח אחד. בדיקת התרשימים של השאילתות מכתובות ה-IP של הלקוחות יכולה לעזור לזהות את מקור הבעיה. אם אתם לא רוצים לאחסן את כתובות ה-IP של הלקוחות, השתמשו ב---no-insights-config-record-client-address. -
--insights-config-record-application-tags: מאחסן תגי אפליקציות שעוזרים לכם לקבוע אילו ממשקי API ונתיבי MVC (מודל-תצוגה-בקרה) שולחים בקשות, ולקבץ את הנתונים כדי להריץ עליהם מדדים. כדי להשתמש באפשרות הזו, צריך להוסיף הערות לשאילתות עם קבוצה ספציפית של תגים. אם אתם לא רוצים לאחסן תגי אפליקציות, השתמשו ב---no-insights-config-record-application-tags.
Terraform
כדי להגדיר את Query Insights באמצעות Terraform, משתמשים במשאב google_alloydb_instance.
הנה דוגמה:
  query_insights_config {
    query_string_length = QUERY_STRING_LENGTH_VALUE
    record_application_tags = RECORD_APPLICATION_TAG_VALUE
    record_client_address = RECORD_CLIENT_ADDRESS_VALUE
    query_plans_per_minute = QUERY_PLANS_PER_MINUTE_VALUE5
  }
מחליפים את מה שכתוב בשדות הבאים:
-
QUERY_STRING_LENGTH_VALUE: אורך מחרוזת השאילתה. ערך ברירת המחדל הוא1024. כל מספר שלם בין 256 ל-4,500 הוא תקין. -
RECORD_APPLICATION_TAG_VALUE: תג של אפליקציית הקלטה למכונה. ערך ברירת המחדל הואtrue. -
RECORD_CLIENT_ADDRESS_VALUE: תיעוד כתובת הלקוח של מכונה. ערך ברירת המחדל הואtrue.
QUERY_PLANS_PER_MINUTE_VALUE: מספר תוכניות הביצוע של השאילתות שתועדו על ידי Insights לדקה, לכל השאילתות ביחד. ערך ברירת המחדל הוא5. כל מספר שלם בין 0 ל-20 הוא תקין.במאמר פקודות בסיסיות ב-Terraform מוסבר איך מוסיפים או מסירים הגדרות אישיות ב-Terraform.
ההגדרה של המכונה לדוגמה עם ההגדרה שנוספה של Query Insights אמורה להיראות כך:
resource "google_alloydb_instance" "instance_name" {
provider = "google-beta"
cluster       = google_alloydb_cluster.default.name
instance_id   = "instance_id"
instance_type = "PRIMARY"

machine_config {
 cpu_count = 8
}

query_insights_config {
query_string_length = 1024
record_application_tags = false
record_client_address = false
query_plans_per_minute = 5
}

depends_on = [google_alloydb_instance.default]
}
REST v1
בדוגמה הזו מגדירים את הגדרות הניראות במופע של AlloyDB. רשימה מלאה של הפרמטרים לקריאה הזו מופיעה במאמר Method: projects.locations.clusters.instances.patch.
כדי להגדיר את Query Insights, משנים את השדות האופציונליים לפי הצורך. רשימה מלאה של השדות לקריאה הזו מופיעה במאמר QueryInsightsInstanceConfig.
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הערכים בשדות הבאים:
-
CLUSTER_ID: המזהה של האשכול שאתם יוצרים. הוא חייב להתחיל באות קטנה באנגלית, ויכול לכלול אותיות קטנות, מספרים ומקפים. -
PROJECT_ID: מזהה הפרויקט שבו רוצים למקם את האשכול. -
LOCATION_ID: המזהה של אזור האשכול. -
INSTANCE_ID: השם של המכונה הראשית שרוצים ליצור.
כדי לשנות את הגדרות המכונה, משתמשים בבקשת PATCH הבאה:
PATCH https://alloydb.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/clusters/CLUSTER_ID/instances/INSTANCE_ID?updateMask=observabilityConfig.enabled
גוף בקשת ה-JSON שמגדיר את כל שדות התצפית נראה כך:
{
  "queryStringLength": integer,
  "recordApplicationTags": boolean,
  "recordClientAddress": boolean,
  "queryPlansPerMinute": integer
}
שיפור ביצועי השאילתות
התכונה "תובנות לגבי שאילתות" מאפשרת לפתור בעיות בשאילתות ב-AlloyDB כדי לחפש בעיות בביצועים. בלוח הבקרה של Query Insights מוצג עומס השאילתות על סמך הגורמים שבחרתם. עומס השאילתות הוא מדד של העבודה הכוללת של כל השאילתות במכונה בטווח התאריכים שנבחר.
תובנות לגבי שאילתות עוזרות לכם לזהות ולנתח בעיות בביצועים של שאילתות. כדי לפתור בעיות בשאילתות באמצעות תובנות לגבי שאילתות, פועלים לפי השלבים הבאים:
- הצגת העומס על מסד הנתונים של כל השאילתות
- מזהים שאילתה או תג בעייתיים.
- בודקים את השאילתה או התג כדי לזהות בעיות.
- בדיקת מעקב שנוצר על ידי שאילתה לדוגמה
הצגת העומס על מסד הנתונים בכל השאילתות
בלוח הבקרה של תובנות לגבי שאילתות ברמה העליונה מוצג התרשים Database load — all top queries באמצעות נתונים מסוננים. עומס השאילתות במסד הנתונים הוא מדד של העבודה (בשניות מעבד) שהשאילתות שבוצעו במסד הנתונים שנבחר מבצעות לאורך זמן. כל שאילתה שפועלת משתמשת במשאבי מעבד (CPU), במשאבי קלט/פלט (IO) או במשאבי נעילה, או ממתינה להם. עומס השאילתות במסד הנתונים הוא היחס בין משך הזמן שלוקח לכל השאילתות להסתיים בחלון זמן נתון לבין הזמן שחלף בפועל.
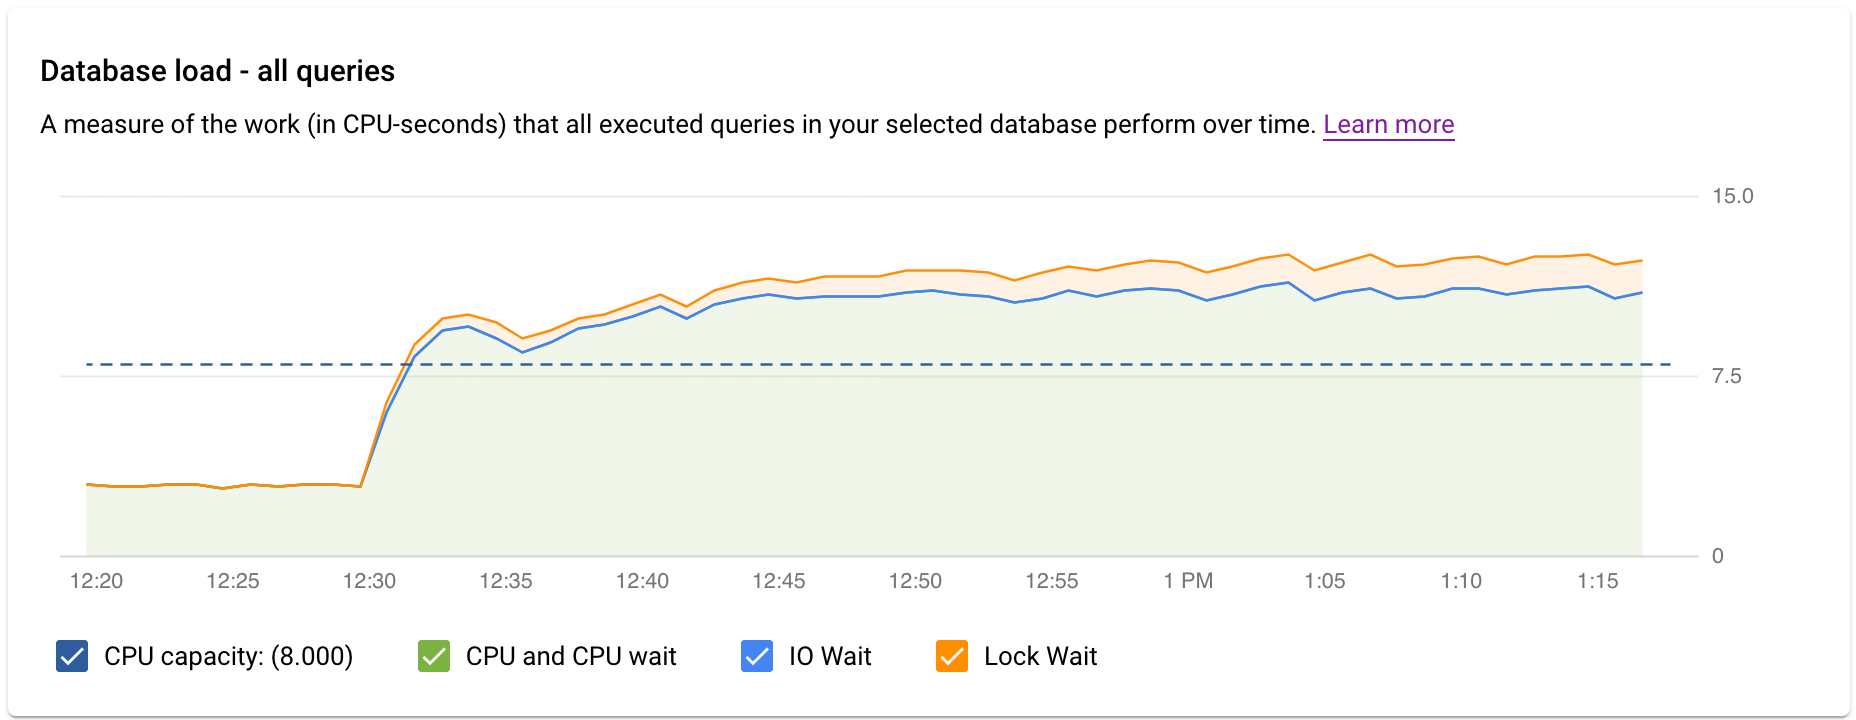
הקווים הצבעוניים בתרשים מציגים את עומס השאילתות, שמחולק לארבע קטגוריות:
- קיבולת המעבד (CPU): מספר המעבדים שזמינים במכונה.
CPU and CPU Wait: היחס בין הזמן שנדרש לשאילתות במצב פעיל לבין הזמן בפועל. המתנות ל-IO ולנעילה לא חוסמות שאילתות במצב פעיל. המשמעות של המדד הזה היא שהשאילתה משתמשת במעבד (CPU) או ממתינה למתזמן של Linux כדי לתזמן את תהליך השרת שמריץ את השאילתה, בזמן שתהליכים אחרים משתמשים במעבד (CPU).
הערה: העומס על המעבד (CPU) מביא בחשבון גם את זמן הריצה וגם את זמן ההמתנה לתזמון של תהליך השרת שפועל על ידי מתזמן Linux. כתוצאה מכך, העומס על המעבד יכול לחרוג מהקו של מספר הליבות המקסימלי.
IO Wait: היחס בין הזמן שנדרש לשאילתות שממתינות ל-IO לבין הזמן בפועל. ההמתנה לקלט/פלט כוללת המתנה לקריאת קלט/פלט והמתנה לכתיבת קלט/פלט. טבלת האירועים של PostgreSQL. אם אתם רוצים פירוט של המידע על המתנות לקלט/פלט, תוכלו לראות אותו ב-Cloud Monitoring. מידע נוסף זמין במאמר תרשימי מדדים.
המתנה לנעילה: היחס בין הזמן שנדרש לשאילתות שממתינות לנעילות לבין הזמן בפועל. הוא כולל את Lock Waits, LwLock Waits ו-Buffer pin Lock waits. אם אתם רוצים פירוט של המידע על המתנות לנעילה, תוכלו לראות אותו ב-Cloud Monitoring. מידע נוסף זמין במאמר תרשימי מדדים.
בשלב הבא, בודקים את התרשים ומשתמשים באפשרויות הסינון כדי לענות על השאלות הבאות:
- האם עומס השאילתות גבוה? האם יש עלייה חדה בגרף או שהוא עולה לאורך זמן? אם לא רואים עומס גבוה, הבעיה היא לא בשאילתות.
- כמה זמן העומס גבוה? האם הוא גבוה רק עכשיו? או שהיא גבוהה כבר הרבה זמן? כדי לגלות כמה זמן הבעיה נמשכת, אפשר להשתמש בבחירת הטווח כדי לבחור תקופות שונות. אפשר גם להגדיל את התצוגה כדי לראות חלון זמן שבו נצפו עליות חדות בעומס השאילתות. אפשר להקטין את התצוגה כדי לראות עד שבוע אחד בציר הזמן.
- מה גורם לעומס הגבוה? אתם יכולים לבחור אפשרויות כדי לבחון את קיבולת המעבד (CPU), את המעבד ואת ההמתנה למעבד, את ההמתנה לנעילה או את ההמתנה לקלט/פלט (IO). התרשים של כל אחת מהאפשרויות האלה מוצג בצבע שונה, כדי שתוכלו לראות באיזו מהן העומס הוא הגבוה ביותר. הקו הכחול הכהה בתרשים מציג את הקיבולת המקסימלית של המעבד במערכת. כך אפשר להשוות בין עומס השאילתות לבין קיבולת המערכת המקסימלית של המעבד (CPU). ההשוואה הזו עוזרת לכם לדעת אם למכונה חסרים משאבי מעבד (CPU).
- באיזה מסד נתונים יש עומס? כדי למצוא את מסדי הנתונים עם העומסים הגבוהים ביותר, בוחרים מסדי נתונים שונים מהתפריט הנפתח Databases.
- האם משתמשים או כתובות IP ספציפיים גורמים לעומסים גבוהים יותר? כדי להשוות בין המשתמשים והכתובות שגורמים לעומסים גבוהים יותר, בוחרים משתמשים וכתובות שונים מהתפריטים הנפתחים.
סינון העומס על מסד הנתונים
בקטעים Queries ו-Tags אפשר לסנן או למיין את עומס השאילתות לפי שאילתה שנבחרה או לפי תג של שאילתת SQL.
סינון לפי שאילתות
בטבלה QUERIES מוצגת סקירה כללית של השאילתות שגורמות לעומס השאילתות הגבוה ביותר. בטבלה מוצגות כל השאילתות המנורמלות בחלון הזמן ובאפשרויות שנבחרו במרכז הבקרה של התובנות לגבי שאילתות.
כברירת מחדל, השאילתות בטבלה ממוינות לפי זמן הביצוע הכולל בחלון הזמן שבחרתם.
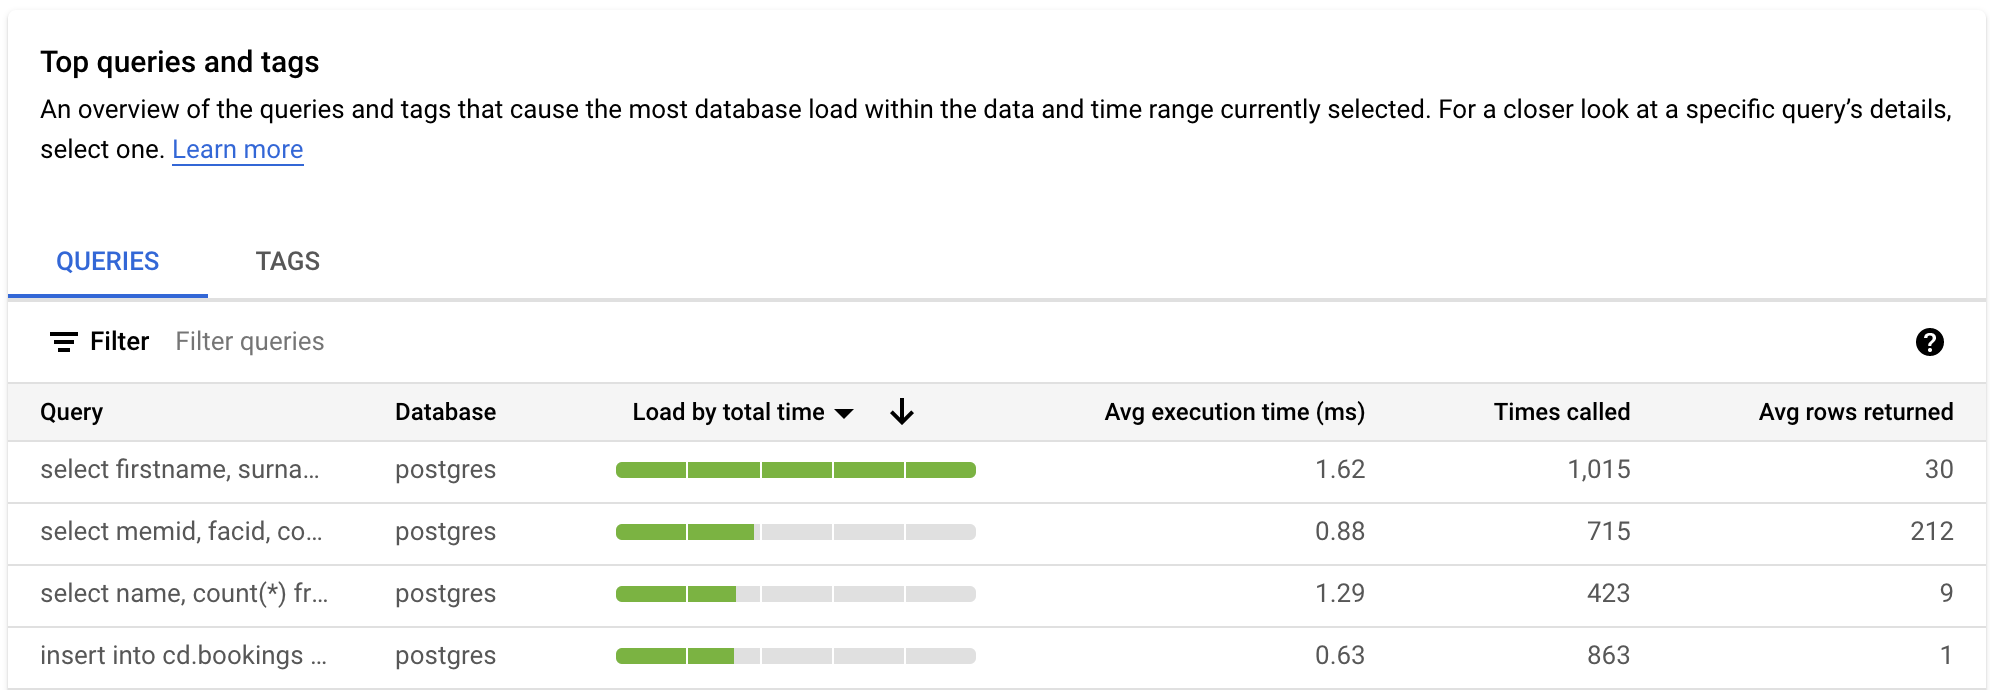
כדי לסנן את הטבלה, בוחרים מאפיין מתוך שאילתות סינון. כדי למיין את הטבלה, בוחרים כותרת של עמודה. בטבלה מוצגים המאפיינים הבאים:
מחרוזת השאילתה. מחרוזת השאילתה המנורמלת. כברירת מחדל, בתובנות לגבי שאילתות מוצגים רק 1,024 תווים במחרוזת השאילתה.
שאילתות עם התווית
UTILITY COMMANDבדרך כלל כוללות פקודותBEGIN,COMMITו-EXPLAINאו פקודות wrapper.מסד נתונים. מסד הנתונים שהשאילתה הופעלה עליו.
Load by total time/Load by CPU/Load by IO wait/Load by lock wait. האפשרויות האלה מאפשרות לסנן שאילתות ספציפיות כדי למצוא את העומס הגדול ביותר לכל אפשרות.
זמן ביצוע ממוצע (באלפיות השנייה). הזמן הכולל שלוקח לכל משימות המשנה בכל ה-workers המקבילים להשלים את השאילתה. מידע נוסף זמין במאמר זמן הביצוע הממוצע ומשך הזמן.
מספר השיחות. מספר הפעמים שהאפליקציה קראה לשאילתה.
מספר השורות הממוצע שנשלפו. המספר הממוצע של שורות שנשלפו בשאילתה.
בתובנות לגבי שאילתות מוצגות שאילתות מנורמלות, כלומר הערכים הקבועים המילוליים מוחלפים ב-$1, $2 וכן הלאה. לדוגמה:
UPDATE
  "demo_customer"
SET
  "customer_id" = $1::uuid,
  "name" = $2,
  "address" = $3,
  "rating" = $4,
  "balance" = $5,
  "current_city" = $6,
  "current_location" = $7
WHERE
  "demo_customer"."id" = $8
המערכת מתעלמת מהערך של הקבוע כדי שתובנות לגבי שאילתות יוכלו לצבור שאילתות דומות ולהסיר פרטים אישיים מזהים (PII) שהקבוע עשוי להציג.
סינון לפי תגי שאילתות
כדי לפתור בעיות באפליקציה, קודם צריך להוסיף תגים לשאילתות ה-SQL.
התכונה "תובנות לגבי שאילתות" מספקת מעקב שמתמקד באפליקציות, כדי לאבחן בעיות בביצועים של אפליקציות שנוצרו באמצעות ORM.
אם אתם אחראים על כל מחסנית האפליקציות, התכונה "תובנות לגבי שאילתות" מאפשרת לכם לעקוב אחרי שאילתות מתצוגת האפליקציה. תיוג שאילתות עוזר למצוא בעיות במבנים ברמה גבוהה יותר, כמו שימוש בלוגיקה עסקית, במיקרו-שירות או במבנה אחר. אפשר לתייג שאילתות לפי הלוגיקה העסקית, למשל באמצעות התגים "תשלום", "מלאי", "ניתוח עסקי" או "משלוח". לאחר מכן תוכלו למצוא את עומס השאילתות שנוצר על ידי הסוגים השונים של הלוגיקה העסקית. לדוגמה, יכול להיות שתראו אירועים לא צפויים, כמו עלייה חדה בשימוש בתג של ניתוח נתונים עסקיים בשעה 13:00. או שאתם עשויים לראות עלייה לא צפויה בשירות תשלומים שהיה פופולרי בשבוע הקודם.
התגים של עומס השאילתות מספקים פירוט של עומס השאילתות של התג שנבחר לאורך זמן.
כדי לחשב את עומס מסד הנתונים לתג, התובנות לגבי שאילתות משתמשות במשך הזמן של כל שאילתה שמשתמשת בתג שבחרתם. התובנות לגבי שאילתות מחשבות את זמן הסיום בגבולות הדקה באמצעות זמן שעון קיר.
בלוח הבקרה של Query Insights, לוחצים על TAGS כדי להציג את טבלת התגים. בטבלה TAGS, התגים ממוינים לפי העומס הכולל שלהם לפי הזמן הכולל.
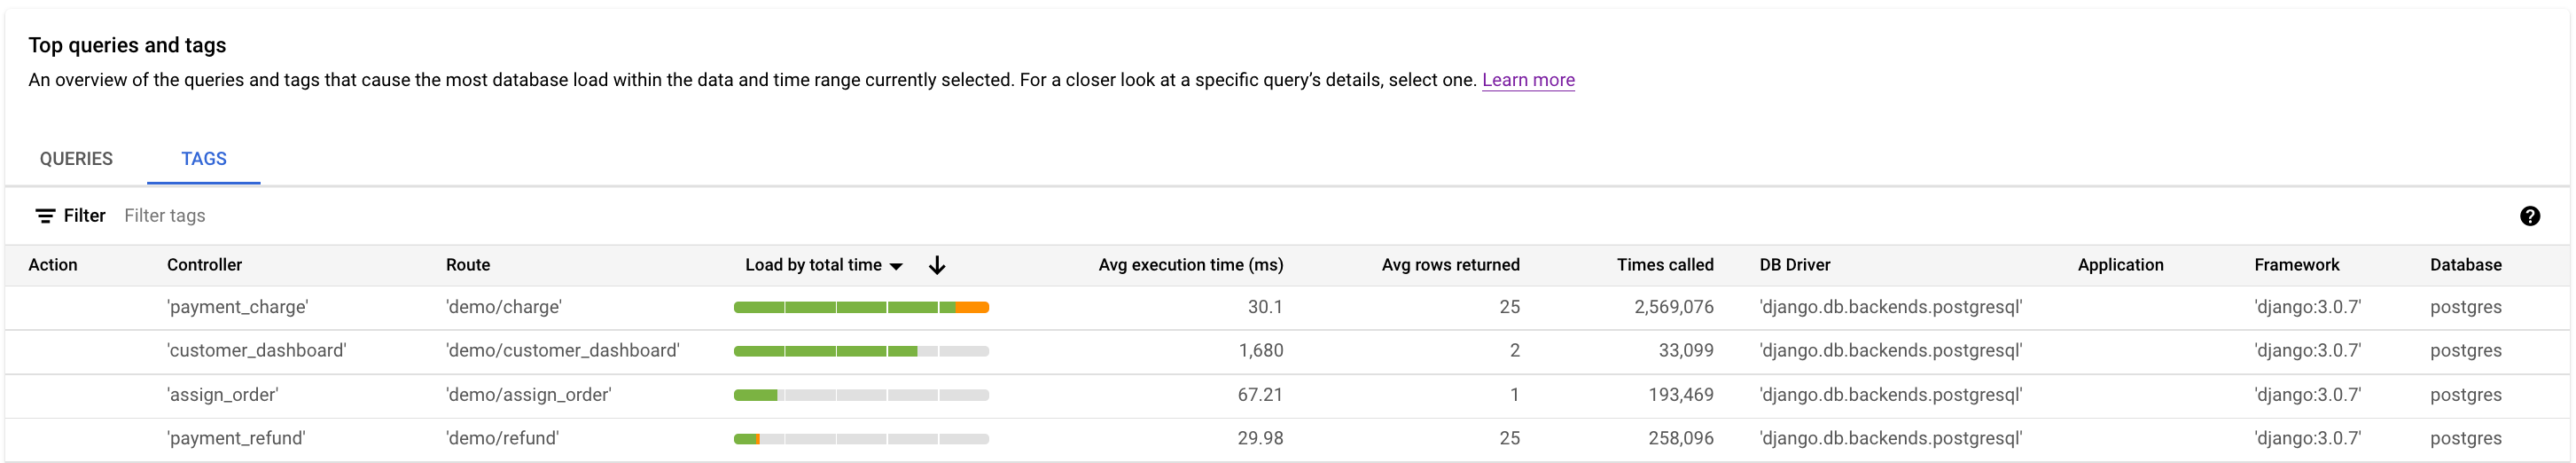
כדי למיין את הטבלה, בוחרים מאפיין מתוך סינון שאילתות או לוחצים על כותרת של עמודה. בטבלה מוצגים המאפיינים הבאים:
- פעולה, בקר, מסגרת, מסלול, אפליקציה, מנהל התקן של מסד נתונים. כל מאפיין שהוספתם לשאילתות מוצג כעמודה. כדי לסנן לפי תגים, צריך להוסיף לפחות אחד מהמאפיינים האלה.
- Load by total time/Load by CPU/Load by IO wait/Load by lock wait. האפשרויות האלה מאפשרות לסנן שאילתות ספציפיות כדי למצוא את העומס הגדול ביותר לכל אפשרות.
- זמן ביצוע ממוצע (באלפיות השנייה). הזמן הכולל שלוקח לכל משימות המשנה בכל ה-workers המקבילים להשלים את השאילתה. מידע נוסף זמין במאמר זמן הביצוע הממוצע ומשך הזמן.
- מספר השיחות. מספר הפעמים שהאפליקציה קראה לשאילתה.
- מספר השורות הממוצע שנשלפו. המספר הממוצע של שורות שנשלפו בשאילתה.
- מסד נתונים. מסד הנתונים שהשאילתה הופעלה עליו.
בדיקה של שאילתה או תג ספציפיים
כדי לקבוע אם שאילתה או תג הם שורש הבעיה, מבצעים את הפעולות הבאות בכרטיסייה Queries או בכרטיסייה Tags, בהתאמה:
- לוחצים על הכותרת Load by total time כדי למיין את הרשימה בסדר יורד.
- לוחצים על השאילתה או התג שנראה שיש להם את העומס הגבוה ביותר, ושלוקח להם יותר זמן מהאחרים.
נפתח מרכז בקרה שבו מוצגים הפרטים של השאילתה או התג שנבחרו.
אם בחרתם שאילתה, תוצג סקירה כללית של השאילתה שנבחרה:
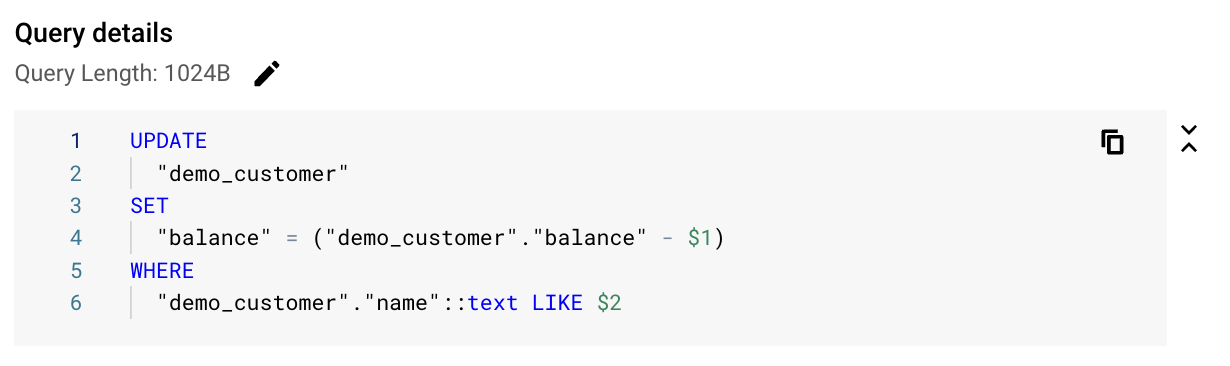
אם בחרתם תג, תוצג סקירה כללית של התג שנבחר.
בדיקת העומס של שאילתה או תג ספציפיים
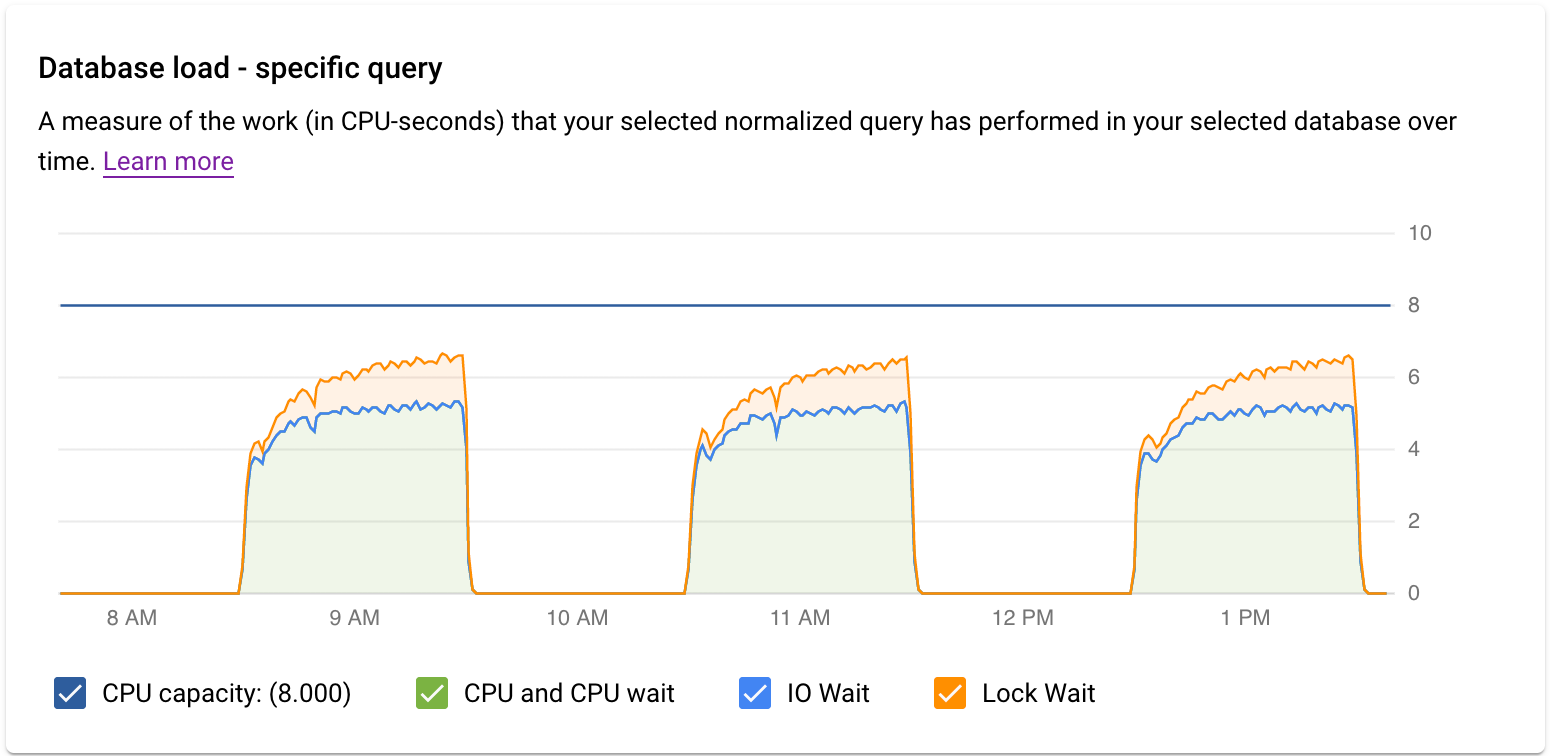
בתרשים Database load — specific query מוצג מדד של העבודה (בשניות מעבד) שהשאילתה המנורמלת שבחרתם ביצעה בשאילתה שבחרתם לאורך זמן. כדי לחשב את העומס, המערכת משתמשת במשך הזמן שלוקח לשאילתות המנורמלות להסתיים בגבולות הדקה של זמן השעון. בחלק העליון של הטבלה מוצגים 1, 024 התווים הראשונים של השאילתה המנורמלת (שממנה הוסרו ערכים מילוליים מטעמי צבירה ופרטים אישיים מזהים). כמו בתרשים של סך כל השאילתות, אפשר לסנן את העומס של שאילתה ספציפית לפי Database, User ו-Client Address. עומס השאילתות מחולק ל-CPU capacity, CPU and CPU Wait, IO Wait ו-Lock Wait.
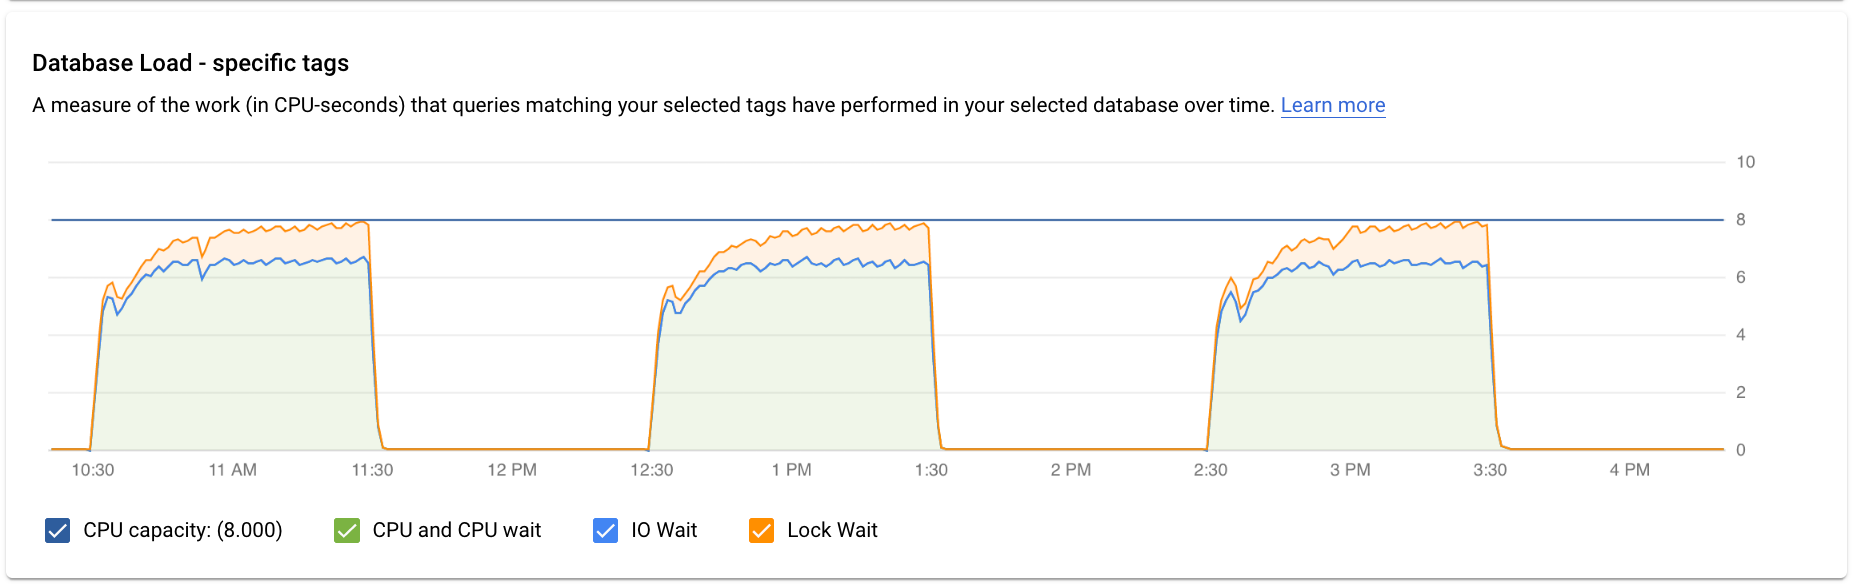
בתרשים Database load — specific tags מוצגת מידת העבודה (בשניות מעבד) שבוצעה לאורך זמן במסד הנתונים שנבחר, על ידי שאילתות שתואמות לתגים שנבחרו. כמו בתרשים של סך כל השאילתות, אפשר לסנן את העומס של תג ספציפי לפי Database, User ו-Client Address.
בדיקת זמן האחזור
בתרשים Latency אפשר לבדוק את זמן האחזור של השאילתה או התג. זמן אחזור הוא משך הזמן שנדרש להשלמת השאילתה המנורמלת, בזמן אמת. בלוח הבקרה של זמן האחזור מוצגים זמני האחזור באחוזונים ה-50, ה-95 וה-99, כדי לזהות התנהגויות חריגות.
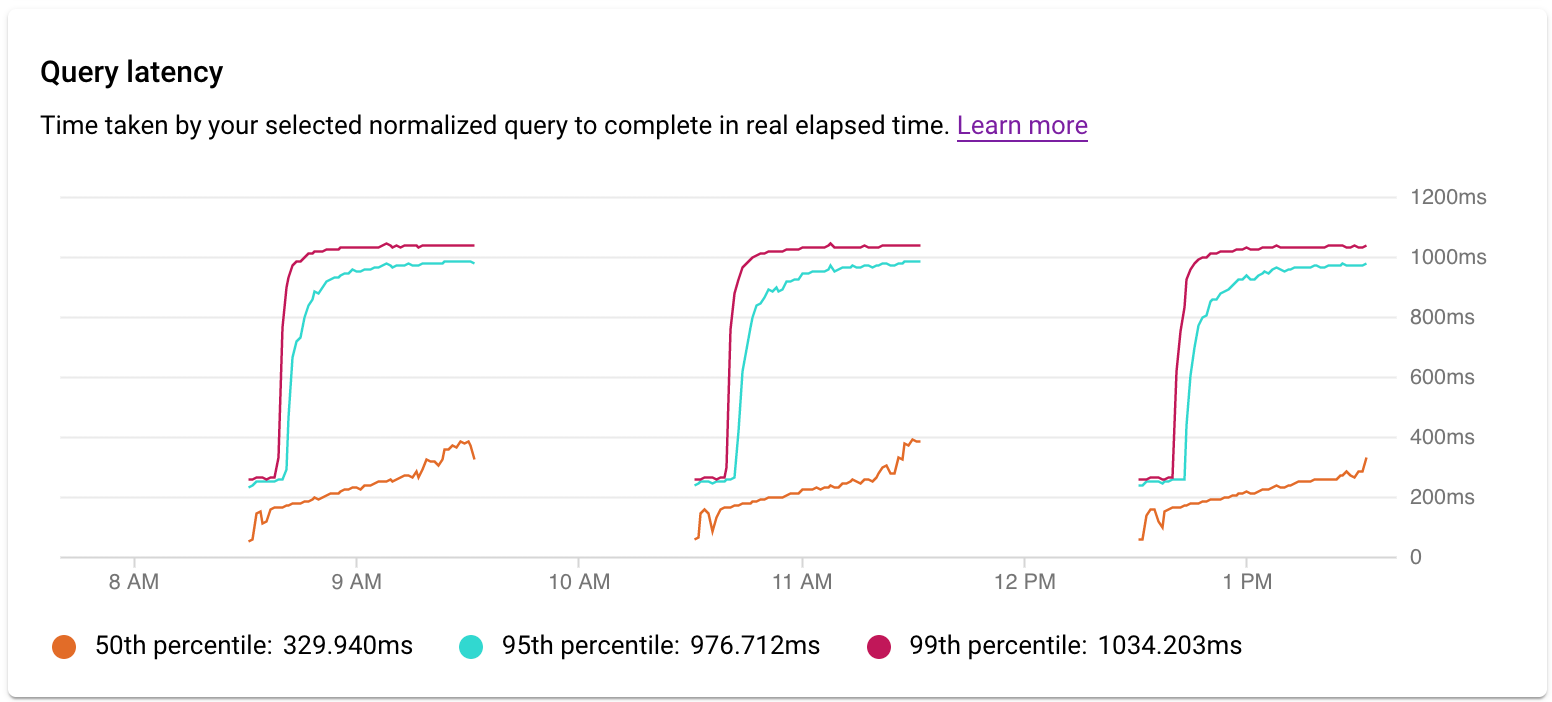
זמן האחזור של שאילתות מקבילות נמדד בזמן אמת, למרות שעומס השאילתות יכול להיות גבוה יותר בגלל שימוש במספר ליבות להרצת חלק מהשאילתה.
כדי לצמצם את הבעיה, נסו לבדוק את הדברים הבאים:
- מה גורם לעומס הגבוה? בוחרים אפשרויות כדי לבדוק את קיבולת המעבד, המעבד וההמתנה למעבד, ההמתנה לנעילה או ההמתנה ל-IO.
- כמה זמן העומס גבוה? האם הוא גבוה רק עכשיו? או שהוא גבוה כבר הרבה זמן? משנים את טווחי התאריכים כדי למצוא את התאריך והשעה שבהם הביצועים של העומס התחילו לרדת.
- האם היו עליות חדות בזמן האחזור? אתם יכולים לשנות את חלון הזמן כדי לבחון את זמן האחזור ההיסטורי של השאילתה המנורמלת.
אחרי שמוצאים את האזורים והשעות שבהם העומס הכי גבוה, אפשר להמשיך לחקור.
בדיקת זמן האחזור באשכול
בתרשים P99 latency on the same query across the cluster אפשר לבדוק את זמן האחזור של P99 בשאילתה או בתג במכונות שבאשכול.
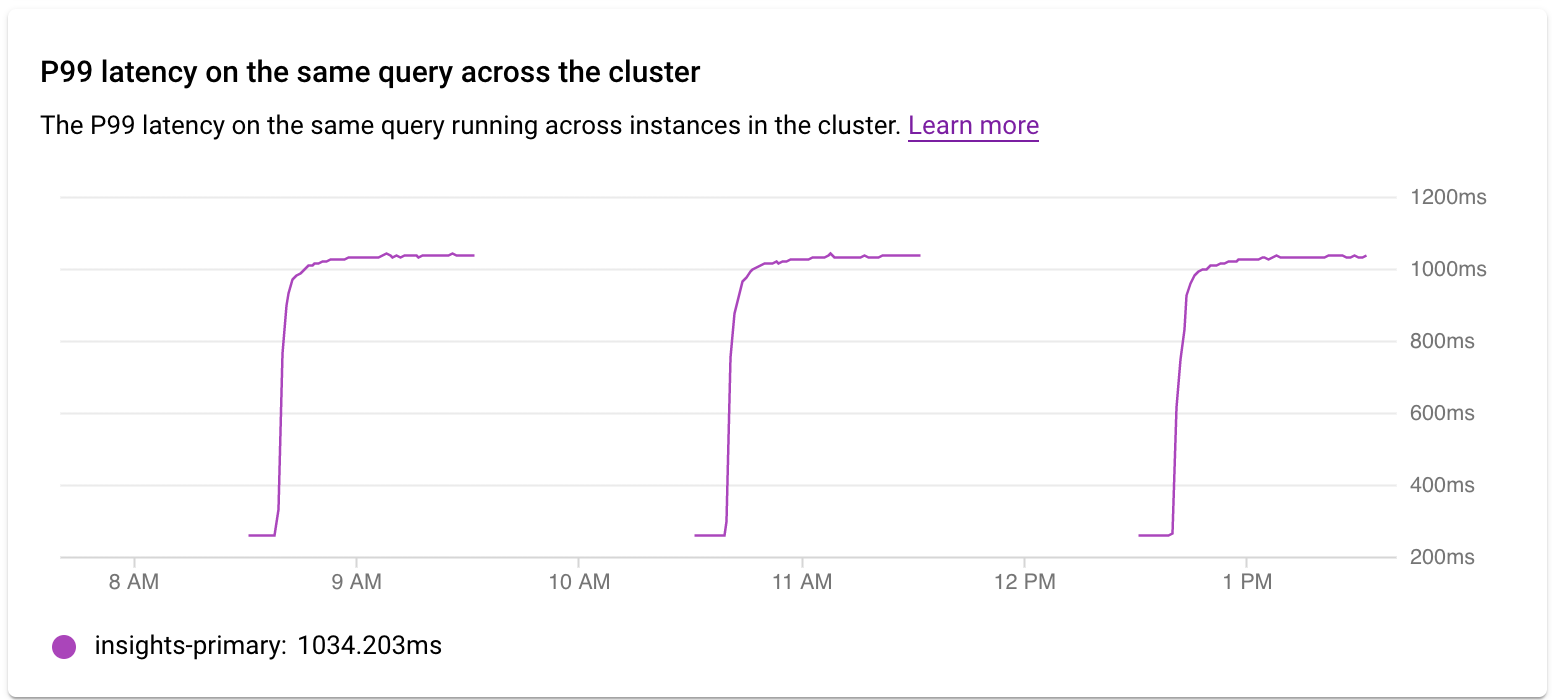
בדיקת הפעולות בתוכנית לביצוע שאילתה שנדגמה
תוכנית לביצוע שאילתה לוקחת דגימה מהשאילתה ומפרקת אותה לפעולות נפרדות. הוא מסביר ומנתח כל פעולה בשאילתה. בתרשים Query plan samples מוצגות כל התוכניות לביצוע שאילתות שפועלות בזמנים מסוימים, ומשך הזמן שלקח לכל תוכנית לפעול.
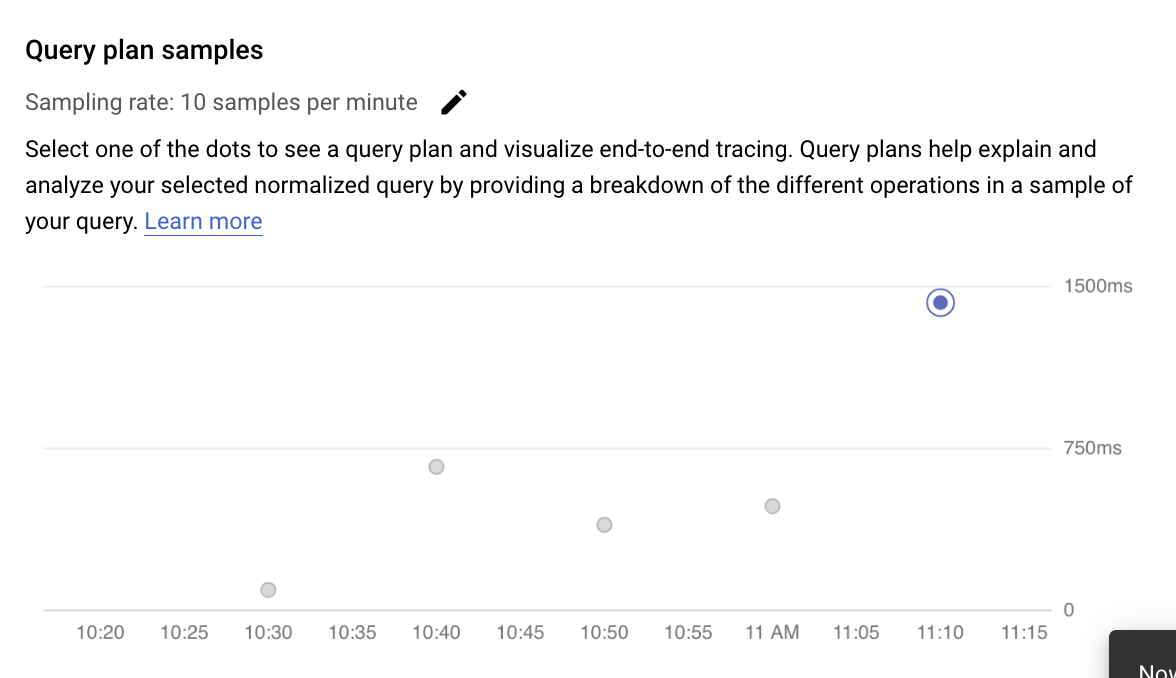
כדי לראות את הפרטים של תוכנית לביצוע שאילתה לדוגמה, לוחצים על הנקודות בתרשים Sample query plans. ברוב השאילתות, אבל לא בכולן, יש תצוגה של תוכניות לביצוע שאילתות לדוגמה. שימו לב ש-AlloyDB ל-PostgreSQL דוגם שאילתות באופן אוטומטי. ככל שמריצים שאילתה יותר פעמים, כך גדל הסיכוי שהיא תידגם. אם אתם צריכים לראות עוד תוכניות לדוגמה לביצוע שאילתות, פעלו לפי ההוראות בקטע עריכת ההגדרות של תובנות לגבי שאילתות כדי להגדיל את קצב הדגימה המקסימלי.
כשמציגים את הפרטים המורחבים של תוכנית לביצוע שאילתה, רואים מודל של כל הפעולות בתוכנית. בכל פעולה מוצגים זמן האחזור, השורות שהוחזרו והעלות של הפעולה. כשבוחרים פעולה, אפשר לראות פרטים נוספים, כמו בלוקים משותפים של היטים, סוג הסכימה, הלולאות בפועל, שורות התוכנית ועוד.
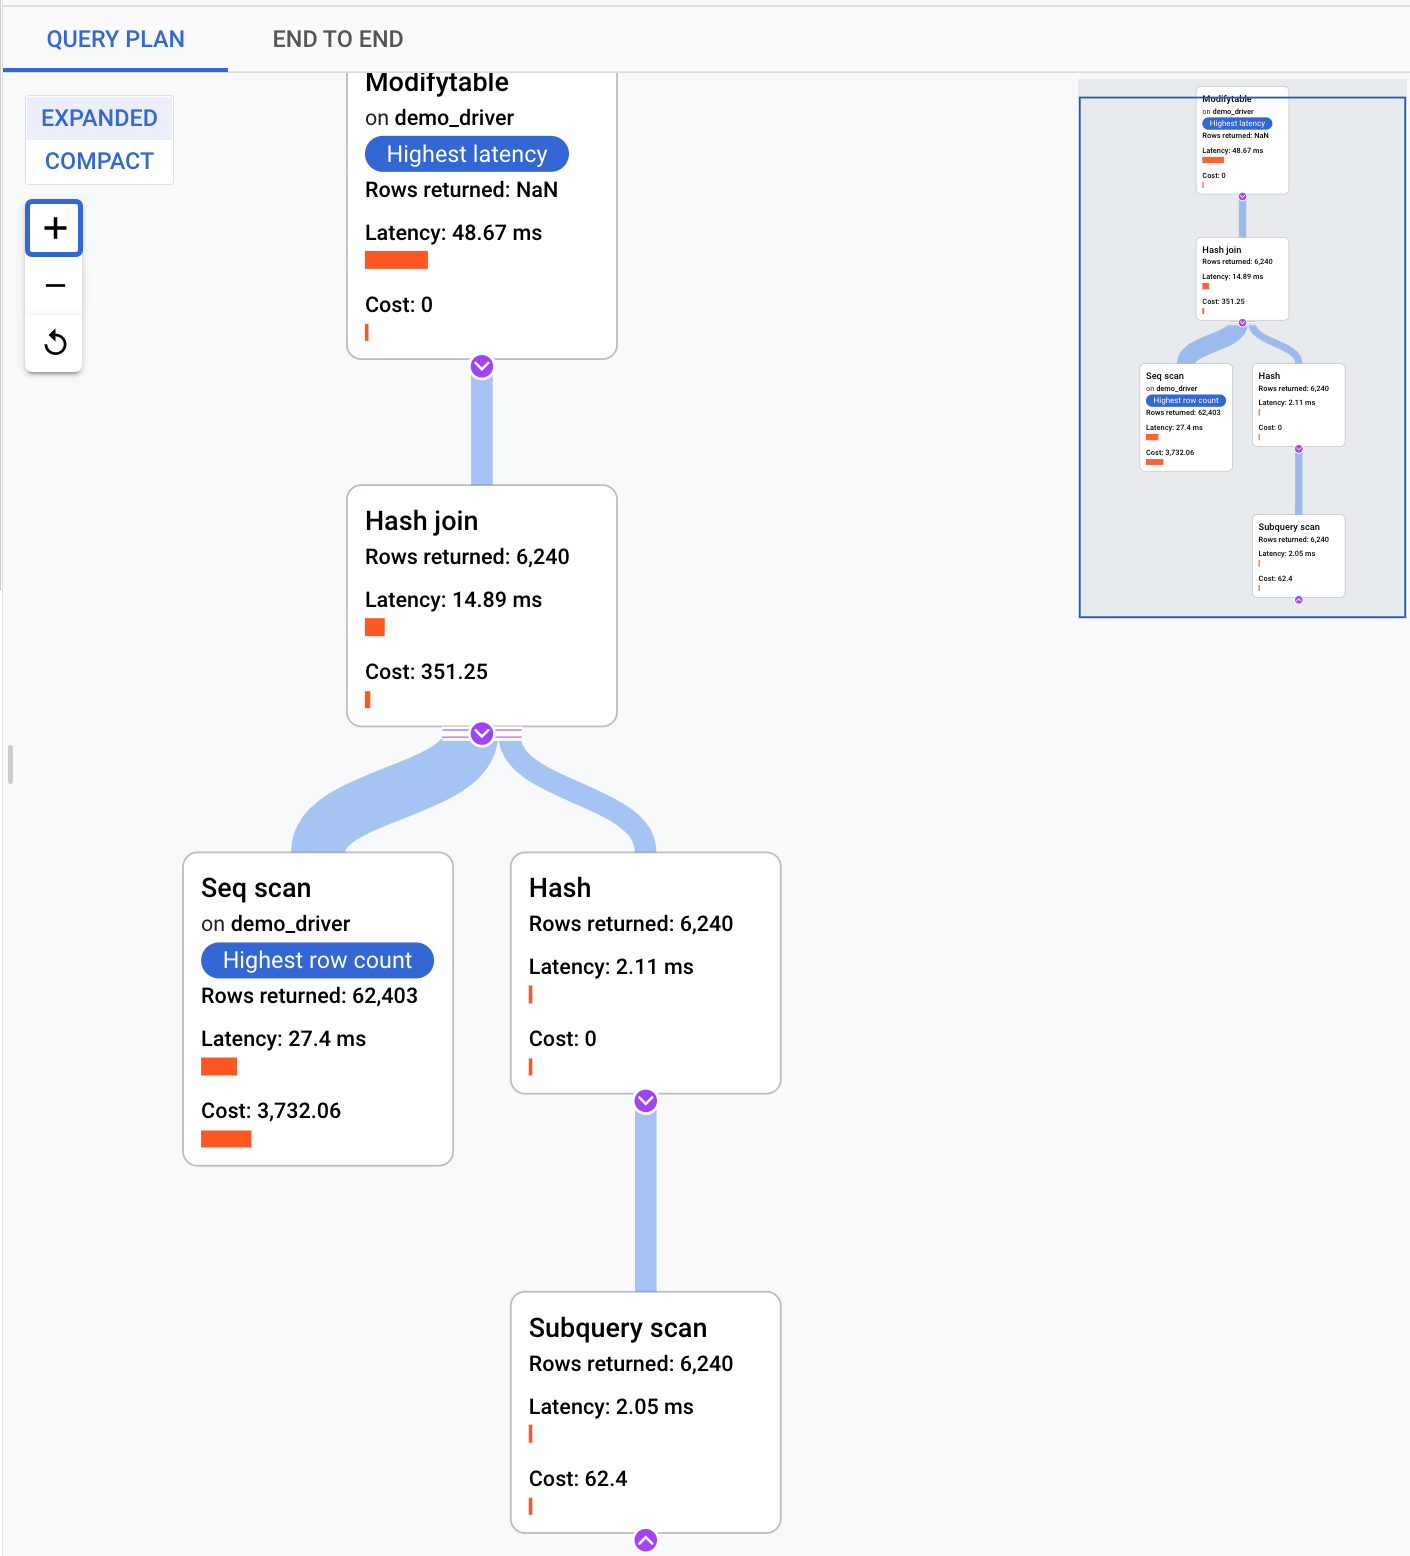
כדי לצמצם את הבעיה, נסו לענות על השאלות הבאות:
- מהי צריכת המשאבים?
- איך הוא קשור לשאילתות אחרות?
- האם הרגלי הצריכה משתנים לאורך זמן?
בדיקת מעקב שנוצר על ידי שאילתה לדוגמה
בנוסף לצפייה בתוכנית לדוגמה לביצוע שאילתה, אתם יכולים להשתמש בתובנות לגבי שאילתות כדי לצפות במעקב מקצה לקצה אחרי אפליקציה בהקשר של שאילתה לדוגמה. המעקב הזה יכול לעזור לכם לזהות את המקור של שאילתה בעייתית, על ידי הצגת הפעילות במסד הנתונים של בקשה ספציפית. בנוסף, רשומות ביומן שהאפליקציה שולחת ל-Cloud Logging במהלך הבקשה מקושרות למעקב, מה שעוזר לכם בחקירה.
כדי להציג את המעקב בהקשר:
בחלונית Sample Query, לוחצים על הכרטיסייה End-to-end Trace. בכרטיסייה הזו מוצג תרשים גאנט שמפרט את הטווחים, שהם רשומות של פעולות ספציפיות, של המעקב שנוצר על ידי השאילתה.
כדי לראות פרטים נוספים על כל span, כמו מאפיינים ומטא-נתונים, לוחצים על ה-span.
אפשר גם לראות את המעקב בדף Trace Explorer. כדי לעשות את זה, לוחצים על View in Cloud Trace. במאמר חיפוש וחקירה של נתוני מעקב מוסבר איך משתמשים בדף Trace Explorer כדי לחקור את נתוני המעקב.
הוספת תגים לשאילתות SQL
תיוג שאילתות SQL מפשט את פתרון הבעיות באפליקציה. אתם יכולים להשתמש ב-sqlcommenter כדי להוסיף תגים לשאילתות SQL באופן אוטומטי באמצעות מיפוי אובייקטי-יחסי (ORM) או באופן ידני.
שימוש ב-sqlcommenter עם ORM
כשמשתמשים ב-ORM במקום לכתוב שאילתות SQL ישירות, יכול להיות שלא תמצאו את קוד האפליקציה שגורם לבעיות בביצועים. יכול להיות שגם תתקשו לנתח איך קוד האפליקציה משפיע על ביצועי השאילתות. כדי לפתור את הבעיה הזו, בתובנות לגבי שאילתות יש ספריית קוד פתוח שנקראת sqlcommenter, שהיא ספריית אינסטרומנטציה של ORM. הספרייה הזו שימושית למפתחים שמשתמשים ב-ORM ולאדמינים, כדי לזהות איזה קוד אפליקציה גורם לבעיות בביצועים.
אם אתם משתמשים ב-ORM וב-sqlcommenter ביחד, התגים נוצרים באופן אוטומטי בלי שתצטרכו לשנות או להוסיף קוד בהתאמה אישית לאפליקציה.
אפשר להתקין את sqlcommenter בשרת של האפליקציה. ספריית הכלים מאפשרת להפיץ למסד הנתונים את המידע על האפליקציה שקשור למסגרת ה-MVC, יחד עם השאילתות כהערת SQL. מסד הנתונים אוסף את התגים האלה ומתחיל לתעד ולצבור נתונים סטטיסטיים לפי תגים, שהם אורתוגונליים לנתונים סטטיסטיים שנצברו על ידי שאילתות מנורמלות. התגים מוצגים בתובנות לגבי שאילתות, כדי שתוכלו לדעת איזו אפליקציה גורמת לעומס השאילתות. המידע הזה עוזר לכם למצוא את קוד האפליקציה שגורם לבעיות בביצועים.
כשבודקים את התוצאות ביומנים של מסד נתוני SQL, הן מופיעות כך:
SELECT * from USERS /*action='run+this',
controller='foo%3',
traceparent='00-01',
tracestate='rojo%2'*/
התגים הנתמכים כוללים את שם הבקר, הנתיב, המסגרת והפעולה.
קבוצת ה-ORM ב-sqlcommenter נתמכת בשפות תכנות שונות:
| Python |
|
| Java |
|
| Ruby |
|
| Node.js |
|
מידע נוסף על sqlcommenter ועל השימוש בו ב-ORM framework זמין במאמרי העזרה של sqlcommenter ב-GitHub.
שימוש ב-sqlcommenter להוספת תגים באופן ידני
אם אתם לא משתמשים ב-ORM, אתם צריכים להוסיף באופן ידני תגי sqlcommenter לשאילתות ה-SQL. בשאילתה, צריך להוסיף לכל הצהרת SQL הערה שמכילה צמד מפתח/ערך שעבר סריאליזציה. צריך להשתמש לפחות באחד מהמקשים הבאים:
action=''controller=''framework=''route=''application=''db driver=''
התובנות לגבי שאילתות לא כוללות את כל המפתחות האחרים. במסמכי התיעוד של sqlcommenter מוסבר מהו הפורמט הנכון של הערת SQL.
זמן ומשך הביצוע
המדד Avg execution time (ms) בתובנות לגבי שאילתות מדווח על משך הזמן הכולל שלוקח לכל משימות המשנה להשלים את השאילתה בכל ה-workers המקבילים. המדד הזה יכול לעזור לכם לבצע אופטימיזציה של ניצול המשאבים המצטבר של מסדי הנתונים, על ידי איתור ואופטימיזציה של שאילתות שיוצרות את התקורה הגבוהה ביותר של המעבד (CPU).
כדי לראות את הזמן שחלף, אפשר למדוד את משך הזמן של שאילתה על ידי הפעלת הפקודה \timing בלקוח psql. הוא מודד את הזמן שחולף בין קבלת השאילתה לבין שליחת התגובה משרת PostgreSQL. המדד הזה יכול לעזור לכם לנתח למה שאילתה מסוימת נמשכת יותר מדי זמן, ולהחליט אם לבצע אופטימיזציה כדי שהיא תרוץ מהר יותר.
אם שאילתה הושלמה בשרשור יחיד על ידי משימה אחת, משך הזמן וזמן הביצוע הממוצע נשארים זהים.
הפעלת תכונות מתקדמות של תובנות לגבי שאילתות ב-AlloyDB
התכונות המתקדמות של תובנות לגבי שאילתות בלוח הבקרה של AlloyDB משולבות בלוח הבקרה הרגיל של תובנות לגבי שאילתות. מידע נוסף על הפעלת תכונות מתקדמות של תובנות לגבי שאילתות זמין במאמר שיפור הביצועים של שאילתות באמצעות תכונות מתקדמות של תובנות לגבי שאילתות.
המאמרים הבאים
- סקירה כללית של תובנות לגבי שאילתות
- איך משפרים את ביצועי השאילתות באמצעות תכונות מתקדמות של תובנות לגבי שאילתות ב-AlloyDB
- מדדים של AlloyDB
- הבלוג של SQL Commenter: Introducing Sqlcommenter: ספריית קוד פתוח לאינסטרומנטציה אוטומטית של ORM
- בלוג הדרכה: הפעלת תיוג שאילתות באמצעות Sqlcommenter