


Load Balancing mit Hochverfügbarkeit für VCF-Appliances
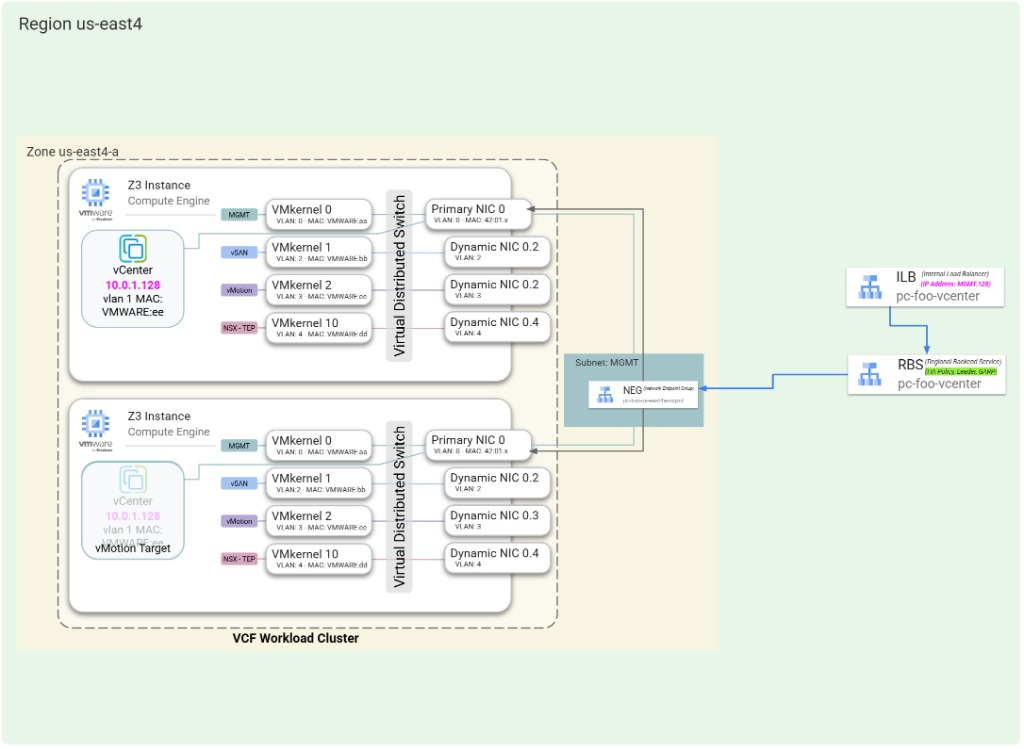
In diesem Dokument wird erläutert, wie regionale interne Load Balancer und zonale Netzwerk-Endpunktgruppen (NEGs) in der VMware-Lösung in Google Cloud Layer-2-Hochverfügbarkeit, VM-Mobilität (vMotion) und automatisiertes Failover für VMware Cloud Foundation (VCF)-Verwaltungs-Appliances bereitstellen, die im Virtual Private Cloud (VPC)-Underlay bereitgestellt werden, wie im folgenden Diagramm dargestellt (zum Vergrößern klicken):
Warum Underlay-Appliances einen Load Balancer erfordern
In lokalen Rechenzentren sind virtuelle Verwaltungsmaschinen wie vCenter Server, SDDC Manager und geclusterte NSX Manager-Knoten auf physische Layer-2-Broadcast-Domänen angewiesen. Wenn eine Appliance ein Failover durchführt oder mithilfe von vMotion zwischen ESXi-Hosts migriert, sendet die Appliance ein GARP-Paket (Gratuitous ARP), um die MAC-Adresstabellen physischer ToR-Switches (Top-of-Rack) zu aktualisieren, sodass die IP-Adresse über physische Server hinweg verschoben wird.
Ein Google Cloud VPC-Netzwerk ist ein geroutetes, softwaredefiniertes Layer-3-Netzwerk (SDN) mit den folgenden Verhaltensweisen:
- Jede IP-Adresse ist programmatisch an eine bestimmte virtuelle Netzwerkschnittstelle (vNIC) von Compute Engine in der SDN-Weiterleitungstabelle gebunden.
- Die VPC-Routingebene ist nicht auf das MAC-Learning des physischen Switches angewiesen, um Layer-3-Traffic an Floating-IP-Adressen weiterzuleiten.
- Wenn eine Underlay-Verwaltungs-VM auf einen anderen Bare-Metal-ESXi-Host verschoben wird, ist für die VPC-Routingtabelle ein expliziter Mechanismus erforderlich, um den Traffic für die IP-Adresse dieser Appliance an die neue Hostschnittstelle weiterzuleiten.
Um die IP-Mobilität ohne manuelle Routenaktualisierungen oder VM-Neuadressierung zu unterstützen, stellt die VMware-Lösung für jede Floating-Underlay-Verwaltungs-Appliance einen regionalen internen Passthrough-Network-Load-Balancer bereit, der mit Fast IP Move (GARP_RA) konfiguriert ist.
Komponenten der Hochverfügbarkeitsarchitektur
Jede Netzwerk-Appliance in der VMware-Lösung verwendet eine dreistufigeGoogle Cloud -Load-Balancing-Architektur, um Hochverfügbarkeit und vMotion-Mobilität zu unterstützen:
Zonale Netzwerk-Endpunktgruppen (NEGs)
- Konstruktionstyp: Zonale NEGs vom Typ
GCE_VM_IP_DEDICATED_BACKEND, die im Ziel-VPC-Subnetz konfiguriert sind. - Funktion: Eine dedizierte NEG in jeder Zone gruppiert die primären oder dynamischen Netzwerkschnittstellen aller Bare-Metal-ESXi-Instanzen, die zur vMotion-Mobilitätsdomain des Clusters gehören.
- Wiederverwendbarkeit: Alle Load Balancer für die zugrunde liegende Appliance innerhalb desselben Clusters und Subnetzes nutzen einen einzigen Satz zonaler NEGs gemeinsam.
Regionaler Backend-Dienst mit schneller IP-Verschiebung
- Konstruktionstyp: Regionaler Backend-Dienst (
loadBalancingScheme: INTERNAL,protocol: UNSPECIFIED), der auf die zonalen NEGs des Clusters verweist. - Failover-Richtlinie (
haPolicy): MitfastIPMove: GARP_RAkonfiguriert. - Funktion: Weist die Google Cloud Andromeda-Datenebene an, das Broadcast-fähige Subnetz auf GARP- und Router Advertisement-Frames (RA) zu überwachen, die von der Verwaltungs-Appliance-VM ausgegeben werden, und den aktiven Backend-Host dynamisch zu aktualisieren.
Regionaler interner Passthrough-Network Load Balancer
- Konstruktionstyp: Regionale interne Weiterleitungsregel, die mit der reservierten virtuellen IP-Adresse (VIP) der Appliance konfiguriert ist.
- Funktion: Dient als persistenter IP-Endpunkt für die Verwaltungs-Appliance oder die Cluster-VIP. Administratoren, Arbeitslasten und andere VCF-Komponenten stellen eine Verbindung zu dieser VIP-Adresse her.
Hochverfügbarkeit des Underlay-Netzwerks mit dedizierten NEGs
Wenn mehrere Netzwerkschnittstellen (z. B. die primäre nic0-Schnittstelle und mit VLAN-Tags versehene dynamische NICs) mit demselben VPC-Netzwerk verbunden sind, können Standard-GCE_VM_IP-NEGs nicht auf beliebige Unterschnittstellen abzielen. Stattdessen verwendet die VMware-Lösung GCE_VM_IP_DEDICATED_BACKEND-NEGs, die so funktionieren:
- Automatisches Schnittstellen-Targeting: Hängt automatisch die spezifische primäre vNIC oder dynamische NIC an, die dem Subnetz der NEG entspricht.
- Einzelne NEG pro Zone: Ein regionaler Backend-Dienst, der mit
GCE_VM_IP_DEDICATED_BACKEND-NEGs konfiguriert ist, kann nur eine NEG pro Zone enthalten. - Anforderung an die interne Hochverfügbarkeitsrichtlinie:
GCE_VM_IP_DEDICATED_BACKEND-NEGs werden nur mit regionalen Backend-Diensten unterstützt, die für interne Passthrough-Network Load Balancer (loadBalancingScheme: INTERNAL) konfiguriert sind, diehaPolicyverwenden.
Einschränkungen der HA-Richtlinie für Broadcast-Subnetze
Wenn Sie haPolicy-Backend-Dienste in Subnetzen mit aktiviertem ARP-Broadcasting und MAC-Learning bereitstellen, gelten die folgenden Regeln:
- Load-Balancing-Schema: Es werden nur interne Passthrough-Network-Load-Balancer (
INTERNAL) unterstützt. - Subnetzausrichtung: Alle Backend-NEGs in allen Zonen für einen bestimmten Backend-Dienst müssen zum selben VPC-Subnetz gehören.
- Zuordnung von Weiterleitungsregeln: Ein Backend-Dienst, der mit Broadcast-NEGs konfiguriert ist, kann nur von einer Weiterleitungsregel referenziert werden.
- Unveränderlicher Backend-Subnetztyp: Sie müssen Backends in einem ARP-Broadcast-Subnetz anhängen, wenn Sie den Backend-Dienst erstellen. Sie können sie später nicht durch Backends in Nicht-Broadcast-Subnetzen ersetzen.
Gegenseitige Inanspruchnahme von HA-Richtlinien verhindern
In einem Subnetz mit aktiviertem ARP-Broadcast kann eine Hostschnittstelle, die zu einem Backend-Dienst mit HA-Richtlinie gehört, vorübergehend die Führung für eine nicht zugehörige HA-Richtlinie übernehmen, wenn sie einen GARP-Frame für die VIP der Weiterleitungsregel dieser Richtlinie sendet.
Um unbeabsichtigte Cross-Claiming-Vorgänge zu verhindern, müssen Sie für alle Backend-Dienste mit Hochverfügbarkeitsrichtlinie, die in diesem Subnetz ausgeführt werden, genau dieselben ESXi-Host-Backends (alle Hosts in der zonalen NEG des Clusters) angeben.
Nächste Schritte
- Informationen zum Overlay-Routing und zur Hochverfügbarkeit von NSX Edge finden Sie unter NSX-Overlay- und Edge-Routing.
- Informationen zum Konfigurieren des Appliance-Netzwerks mithilfe der Console finden Sie unter Knoten bereitstellen und Appliance-Netzwerk mithilfe der Console konfigurieren.
- Informationen zum Hinzufügen von VCF-Verwaltungs-Appliances an Tag 2 finden Sie unter VCF-Appliances mit Terraform hinzufügen.