


TPU7x (Ironwood)
In questa pagina viene descritta l'architettura e le configurazioni disponibili per TPU7x, l'ultima TPU disponibile su Google Cloud. TPU7x è la prima release della famiglia Ironwood,la TPU di settima generazione di Google Cloud. La generazione Ironwood è progettata per l'addestramento e l'inferenza dell'AI su larga scala.
Con un'impronta di 9216 chip per pod, TPU7x condivide molte somiglianze con TPU v5p. TPU7x offre prestazioni elevate per modelli densi e MoE su larga scala, pre-addestramento, campionamento e inferenza con decodifica intensiva.
Per utilizzare TPU7x, puoi utilizzare Google Kubernetes Engine (GKE) o Compute Engine. Per maggiori informazioni sull'utilizzo delle TPU con GKE, consulta Informazioni sulle TPU in GKE.
Puoi anche utilizzare TPU7x e GKE con la modalità All Capacity. La modalità All Capacity è disponibile tramite una prenotazione in modalità All Capacity, che ti offre l'accesso completo a tutta la capacità prenotata (senza trattenute) e la visibilità completa della topologia hardware, dello stato di utilizzo e dello stato di integrità della TPU. Per saperne di più, consulta la panoramica della modalità All Capacity.
Architettura di sistema
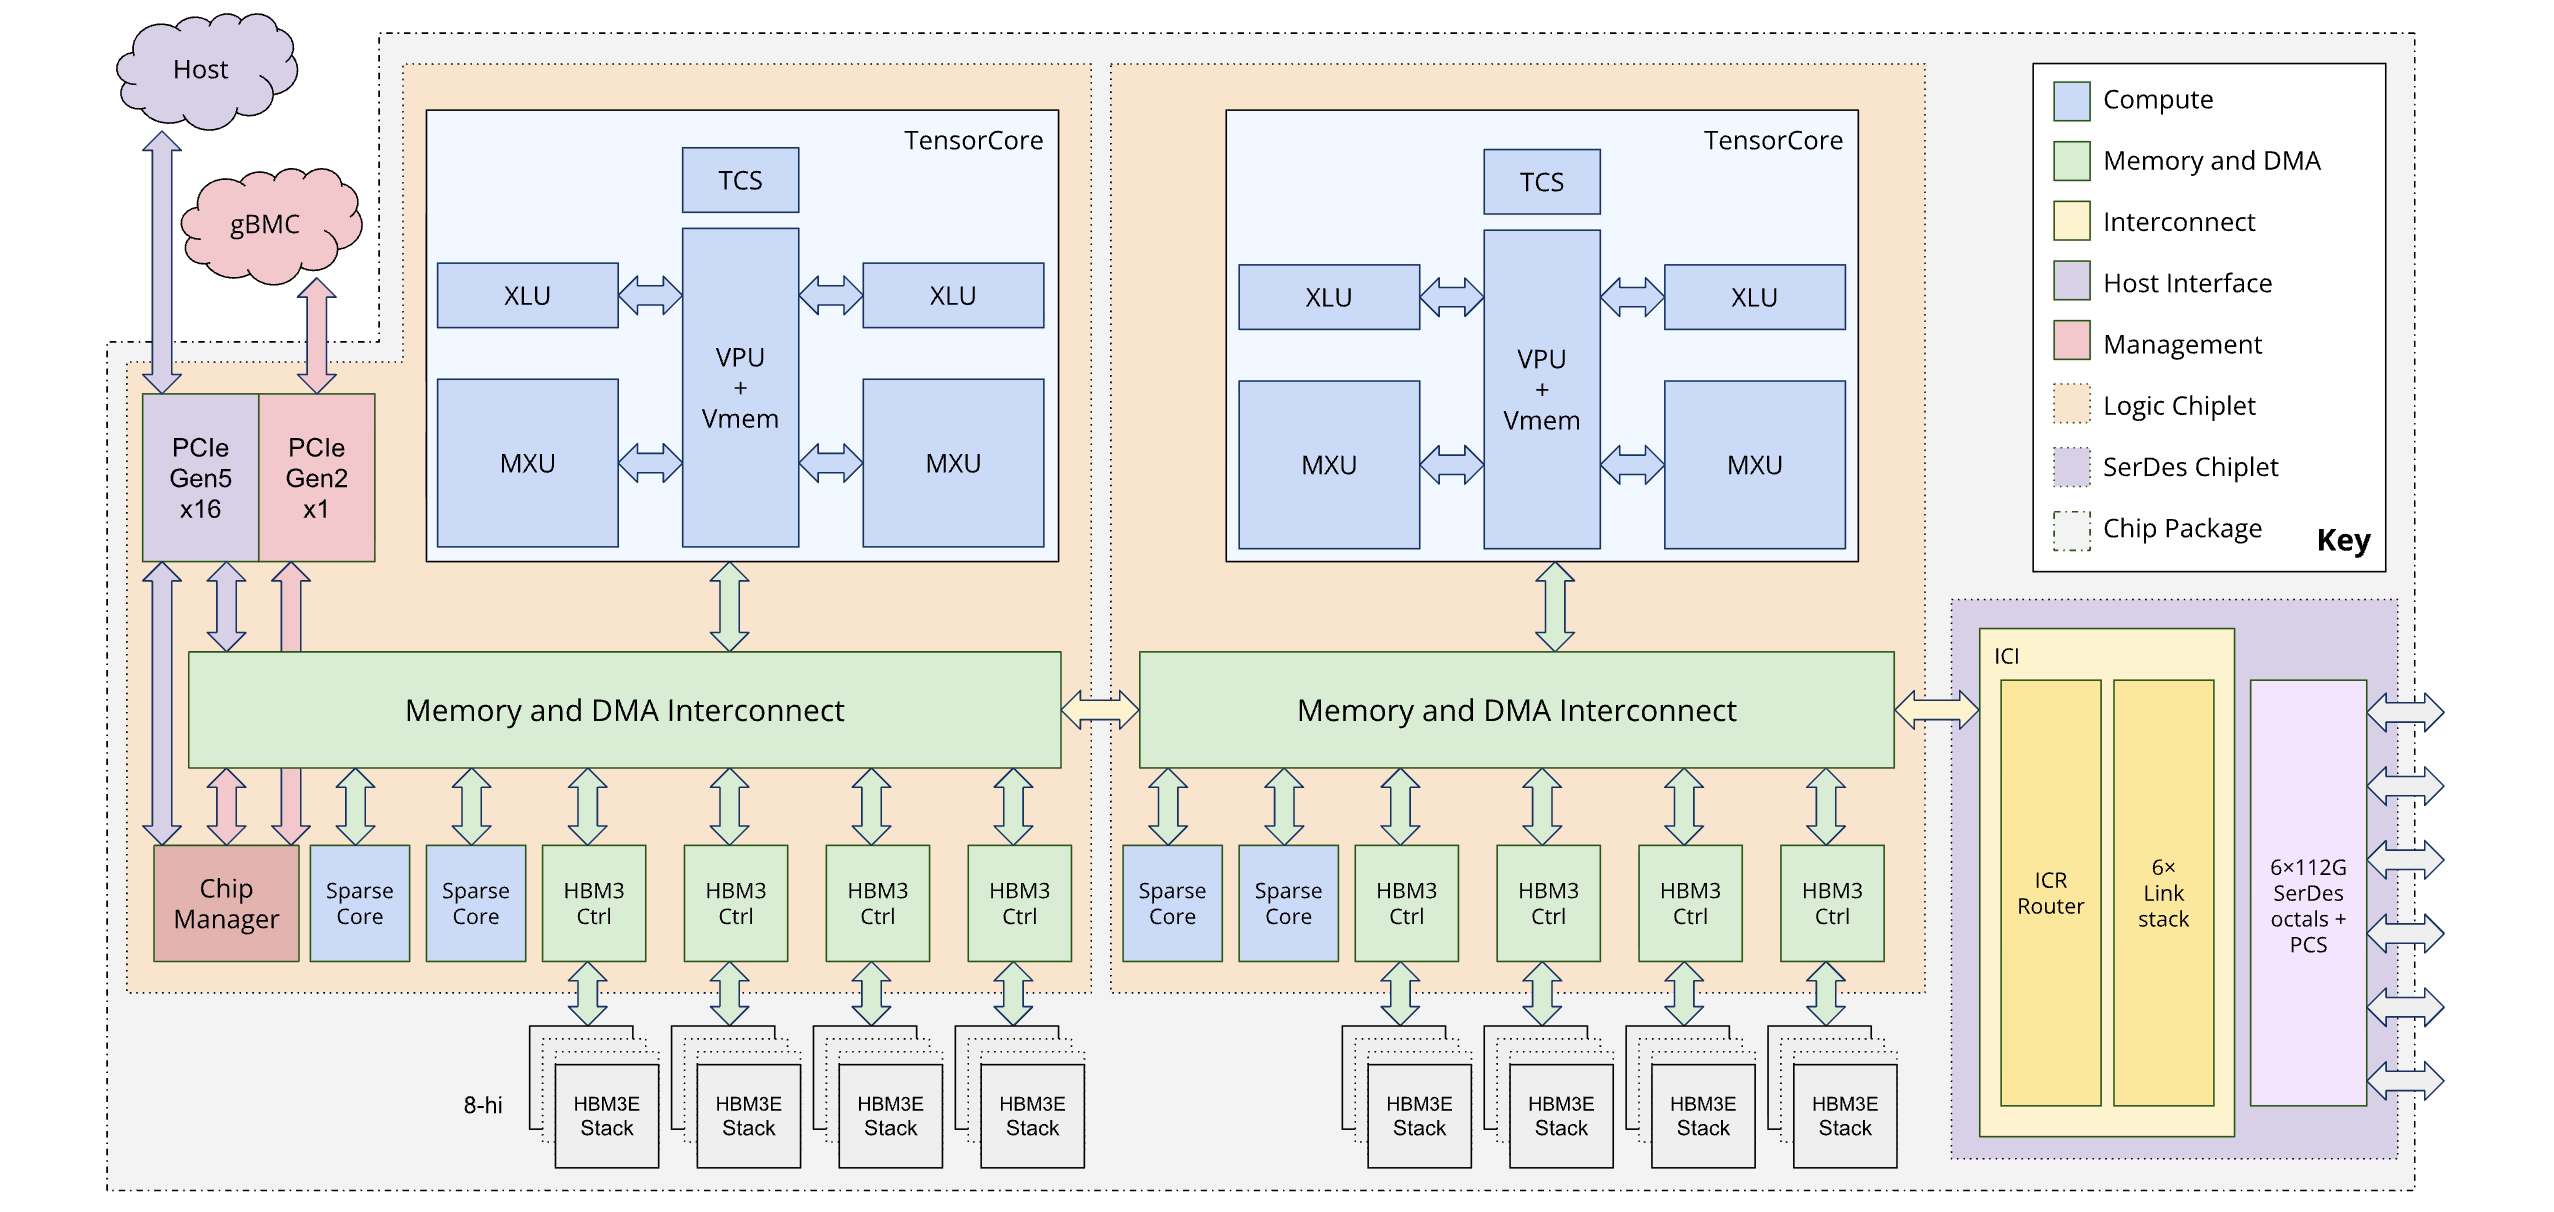
Ogni chip TPU7x contiene due TensorCore e quattro SparseCore. La tabella seguente mostra le specifiche principali e i relativi valori per TPU7x rispetto alle generazioni precedenti.
| Specifica | v5p | v6e (Trillium) | TPU7x (Ironwood) |
|---|---|---|---|
| Numero di chip per pod | 8960 | 256 | 9216 |
| Picco di computing per chip (BF16) (TFLOP) | 459 | 918 | 2307 |
| Calcolo di picco per chip (FP8) (TFLOP) | 459 | 918 | 4614 |
| Capacità HBM per chip (GiB) | 95 | 32 | 192 |
| Larghezza di banda HBM per chip (GBps) | 2765 | 1638 | 7380 |
| Numero di vCPU (VM a 4 chip) | 208 | 180 | 224 |
| RAM (GB) (VM a 4 chip) | 448 | 720 | 960 |
| Numero di TensorCore per chip | 2 | 1 | 2 |
| Numero di SparseCore per chip | 4 | 2 | 4 |
| Larghezza di banda Inter-Chip Interconnect (ICI) bidirezionale per chip (GBps) | 1200 | 800 | 1200 |
| Larghezza di banda della rete del data center (DCN) per chip (Gbps) | 50 | 100 | 100 |
Il seguente diagramma illustra l'architettura di Ironwood:
Gerarchia della memoria
TPU7x è dotato di un sistema di memoria multilivello e la gestione del movimento dei dati tra questi livelli è fondamentale per le prestazioni:
- Memoria a larghezza di banda elevata (HBM): ogni chip è dotato di 192 GB di HBM, con una larghezza di banda di circa 7,37 TB/s. L'elevata capacità HBM consente dimensioni dei batch elevate, il che può migliorare il throughput. Tuttavia, nonostante le sue dimensioni, l'HBM può comunque essere un collo di bottiglia, in particolare per le operazioni vettoriali con vincoli di memoria o per i pattern di accesso ai dati inefficienti.
- Memoria vettoriale (VMEM): la VMEM è una SRAM (memoria ad accesso casuale statica) on-chip più piccola con una larghezza di banda significativamente più elevata per l'unità di moltiplicazione a matrice (MXU) rispetto all'HBM. Questa memoria funge da blocco note ad alta velocità per i kernel personalizzati. La dimensione di questo buffer è un parametro regolabile. L'ottimizzazione della dimensione del buffer è fondamentale per l'ottimizzazione dei kernel Pallas personalizzati, poiché le dimensioni dei blocchi sono spesso limitate dalla VMEM disponibile.
- Memoria host e PCIe: ogni gruppo di quattro chip TPU è connesso a un host CPU utilizzando una rete PCIe. Sebbene questa connessione abbia una larghezza di banda molto inferiore rispetto all'HBM, la memoria principale dell'host può essere utilizzata per l'offload delle attivazioni o degli stati dell'ottimizzatore per liberare l'HBM, una tecnica particolarmente utile per gestire la pressione della memoria nei modelli di grandi dimensioni.
Per saperne di più sulla gestione efficiente dello spostamento dei dati tra i livelli della gerarchia della memoria TPU7x, consulta Ottimizzazioni delle prestazioni di Ironwood.
Architettura dual-chiplet
Il modello di programmazione Ironwood ti consente di accedere a due chiplet TPU anziché a un'architettura con un singolo core logico (nota anche come MegaCore) utilizzata nelle generazioni precedenti (TPU v4 e v5p). Questa modifica migliora l'efficienza e l'efficacia in termini di costi della produzione del chip. Sebbene ciò rappresenti un cambiamento architetturale, il nuovo design garantisce la possibilità di riutilizzare i modelli software esistenti con modifiche minime.
Le TPU Ironwood sono composte da due chiplet distinti, ciascuno con il proprio spazio di memoria dedicato. Questo è un cambiamento rispetto allo spazio di memoria unificato dell'architettura MegaCore.
Composizione dei chiplet: ogni chiplet è un'unità autonoma con un TensorCore, due SparseCore e 96 GB di memoria con larghezza di banda elevata (HBM).
Interconnessione ad alta velocità: i due chiplet sono collegati da un'interfaccia die-to-die (D2D) sei volte più veloce di un collegamento inter-chip interconnect (ICI) 1D. La comunicazione tra chiplet viene gestita utilizzando operazioni collettive.
Esposizione del modello di programmazione e del framework
Il modello di programmazione per Ironwood è simile a quello delle generazioni di TPU precedenti alla v4, come TPU v3. La nuova architettura viene esposta nei seguenti modi:
Due dispositivi per chip:framework come JAX espongono ogni chip Ironwood come due "dispositivi" separati, uno per ogni chiplet.
Specifica del chiplet:puoi specificare quale chiplet utilizzare per un calcolo. JAX aggiunge una quarta dimensione alla specifica della topologia per distinguere i chiplet. Questo design ti consente di riutilizzare i modelli software esistenti con modifiche minime.
Per ulteriori informazioni su come ottenere prestazioni ottimali con l'architettura dual-chiplet, consulta Suggerimenti sul rendimento per l'architettura dual-chiplet di Ironwood
Configurazioni supportate
I chip TPU7x hanno una connessione diretta ai chip vicini più prossimi in 3 dimensioni, il che si traduce in una mesh 3D di connessioni di rete. Le sezioni più grandi di 64 chip sono costituite da uno o più "cubi" di chip 4x4x4.
I chip TPU7x hanno una topologia di interconnessione toroidale 3D. Questa topologia consente alle sezioni di fare lo scale up fino a 9216 chip. Ha una larghezza di banda bidirezionale di 200 GBps per asse per la comunicazione tra i chip all'interno di un pod.
La tabella seguente mostra le forme comuni di sezioni 3D supportate per TPU7x:
| Topologia | Chip TPU | Hosting | VM | Cubes | Ambito |
|---|---|---|---|---|---|
| 2x2x1 | 4 | 1 | 1 | 1/16 | Host singolo |
| 2x2x2 | 8 | 2 | 2 | 1/8 | Multi-host |
| 2x2x4 | 16 | 4 | 4 | 1/4 | Multi-host |
| 2x4x4 | 32 | 8 | 8 | 1/2 | Multi-host |
| 4x4x4 | 64 | 16 | 16 | 1 | Multi-host |
| 4x4x8 | 128 | 32 | 32 | 2 | Multi-host |
| 4x8x8 | 256 | 64 | 64 | 4 | Multi-host |
| 8x8x8 | 512 | 128 | 128 | 8 | Multi-host |
| 8x8x16 | 1024 | 256 | 256 | 16 | Multi-host |
| 8x16x16 | 2048 | 512 | 512 | 32 | Multi-host |
VM TPU7x
Ogni macchina virtuale (VM) TPU7x contiene 4 chip. Ogni VM ha accesso a due nodi NUMA. Per saperne di più sui nodi NUMA, consulta Non-uniform memory access su Wikipedia.
Tutte le sezioni TPU7x utilizzano VM full-host con 4 chip. Le specifiche tecniche di una VM TPU7x sono:
- Numero di vCPU per VM: 224
- RAM per VM: 960 GB
- Numero di nodi NUMA per VM: 2
Modelli supportati
Un modello supportato viene ottimizzato e convalidato per l'hardware TPU7x. Puoi eseguire il deployment e l'esecuzione dei modelli supportati senza modifiche al codice. I modelli supportati sono configurati per sfruttare le funzionalità di TPU v7x, tra cui l'architettura dual-chiplet, le interconnessioni ad alta larghezza di banda (ICI), l'HBM e il calcolo a precisione mista (come FP8 e BF16).
Google e la community open source gestiscono ricette, configurazioni e assistenza pre-ottimizzate per i workload di addestramento e inferenza su TPU7x.
Modelli ottimizzati per l'addestramento
I modelli ottimizzati per l'addestramento includono ricette preconfigurate e iperparametri ottimizzati per i framework di addestramento distribuito. Queste formule configurano strategie di parallelismo ottimali (tra cui parallelismo di dati, tensori, pipeline e contesto) per massimizzare il throughput e l'efficienza di scalabilità tra topologie TPU7x a host singolo e multi-slice.
Per trovare ricette di addestramento, guide e benchmark delle prestazioni per i modelli supportati su TPU7x, consulta le seguenti risorse:
- Ricette di addestramento TPU per TPU7x: il repository GitHub ufficiale contenente ricette di addestramento pre-ottimizzate, configurazioni di precisione (FP8 e BF16), benchmark dei tempi di passaggio e metriche di throughput per i modelli aperti più diffusi su TPU7x.
- Repository MaxText: un framework di addestramento LLM open source ad alte prestazioni scritto in JAX e ottimizzato per Cloud TPU.
- Addestra un modello utilizzando TPU7x: una guida per il provisioning delle risorse TPU7x e il deployment dei workload di addestramento con MaxText.
- TorchTitan su TPU: un framework open source basato su TorchTitan di PyTorch, adattato per addestrare modelli di grandi dimensioni su Cloud TPU.
Modelli ottimizzati per l'inferenza
I modelli ottimizzati per l'inferenza sono convalidati per l'erogazione su TPU7x con vLLM e SGLang utilizzando i backend JAX e PyTorch (TorchTPU). Questi modelli vengono testati per verificarne la correttezza, l'accuratezza numerica e il throughput di distribuzione utilizzando il parallelismo dei tensori e i kernel TPU personalizzati scritti in Pallas e Tokamax.
Per trovare ricette di distribuzione e strumenti di deployment per i modelli supportati su TPU7x, consulta le seguenti risorse:
- Ricette di inferenza TPU per TPU7x: ricette di distribuzione, configurazioni e manifest di deployment pre-ottimizzati per TPU7x.
- vLLM su TPU: l'erogazione con il backend
vllm-jaxper i modelli JAX e il backendvllm-torchtpuper i modelli PyTorch. - SGLang su TPU:
disponibile con il backend
sglang-jaxper i modelli JAX e il backendsglang-torchtpuper i modelli PyTorch. - Matrice di supporto dei modelli vLLM TPU v7x: risultati dei test automatici notturni per i test delle unità, la correttezza e lo stato del benchmark su TPU7x.
- Esegui l'inferenza su Cloud TPU: una guida per configurare l'erogazione del modello su un singolo host su Cloud TPU.
Hyperdisk
Per impostazione predefinita, il disco di avvio della VM per TPU7x è Hyperdisk bilanciato. Puoi collegare altri dischi alla VM TPU per avere spazio di archiviazione aggiuntivo. I seguenti tipi di dischi sono supportati su TPU7x:
- Hyperdisk bilanciato
- Hyperdisk ML
Per saperne di più su Hyperdisk, consulta la panoramica di Hyperdisk. Per saperne di più sulle opzioni di archiviazione per Cloud TPU, consulta Opzioni di archiviazione per i dati di Cloud TPU.
Passaggi successivi
- Utilizza TPU7x con GKE
- Utilizza TPU7x con la modalità All Capacity
- Utilizza la piattaforma Google Cloud ML Diagnostics per ottimizzare e diagnosticare i tuoi workload
- Esegui un workload di addestramento utilizzando una recipe ottimizzata per TPU7x
- Esegui un microbenchmark TPU7x
- Ottimizzazioni delle prestazioni di Ironwood
- Addestra modelli di machine learning su larga scala su GKE con il controllo delle versioni multilivello