


Creazione di AI di produzione su Cloud TPU con JAX
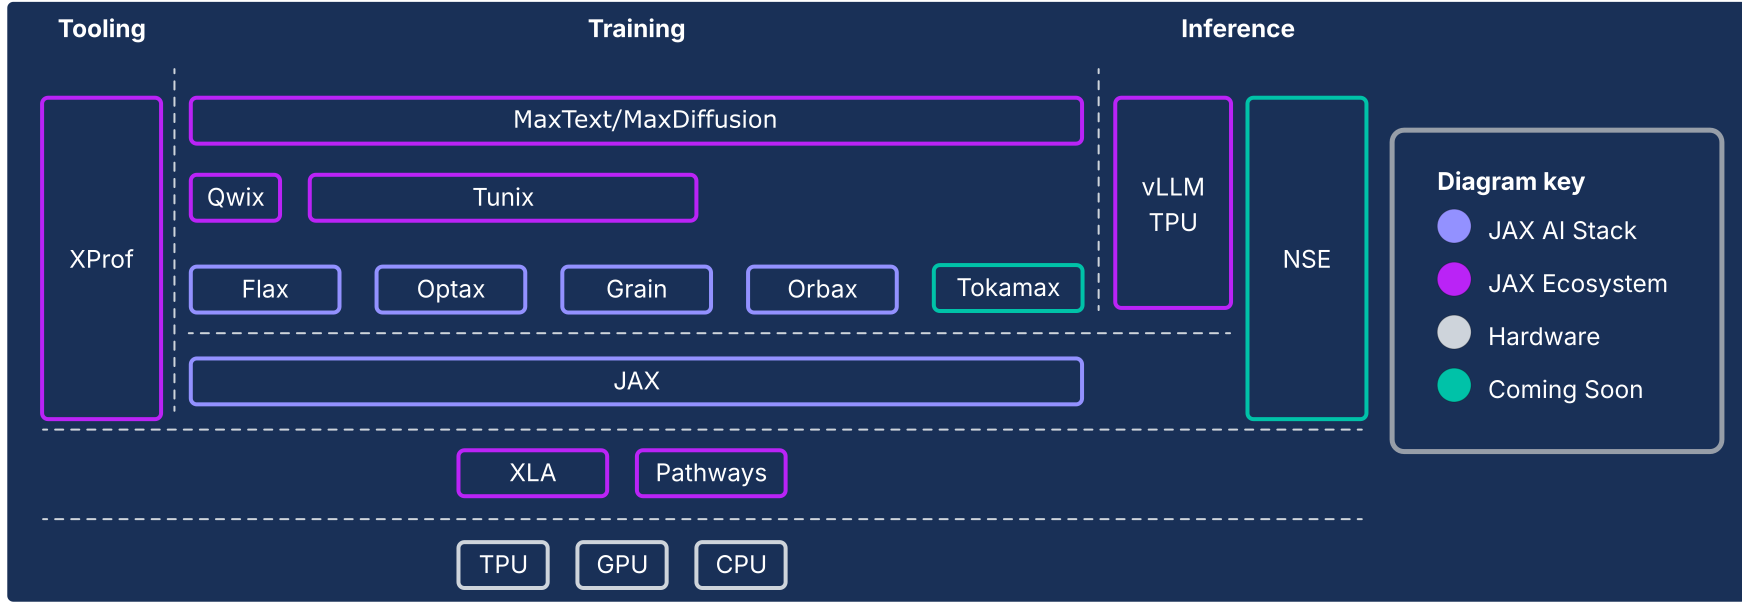
Lo stack JAX AI estende il core numerico JAX con una raccolta di librerie componibili supportate da Google, trasformandolo in una piattaforma open source end-to-end solida per il machine learning su larga scala. Pertanto, lo stack JAX AI è costituito da un ecosistema completo e solido che copre l'intero ciclo di vita del ML:
Base su scala industriale: lo stack JAX AI è progettato per una scalabilità massiccia, sfruttando ML Pathways per orchestrare l'addestramento su decine di migliaia di chip e Orbax per un checkpoint asincrono resiliente e ad alto throughput, consentendo l'addestramento di modelli allo stato dell'arte di livello di produzione.
Toolkit completo e pronto per la produzione: lo stack JAX AI fornisce un set completo di librerie per l'intero processo di sviluppo: Flax per la creazione di modelli flessibili, Optax per strategie di ottimizzazione componibili e Grain per le pipeline di dati deterministiche essenziali per esecuzioni su larga scala riproducibili.
Prestazioni specializzate di picco: per ottenere il massimo utilizzo dell'hardware, lo stack JAX AI offre librerie specializzate, tra cui Tokamax per kernel personalizzati all'avanguardia, Qwix per la quantizzazione non invasiva che aumenta la velocità di addestramento e inferenza e XProf per la profilazione delle prestazioni integrata nell'hardware.
Percorso completo verso la produzione: lo stack JAX AI offre una transizione fluida dalla ricerca al deployment. Ciò include MaxText come riferimento scalabile per l'addestramento dei foundation model, Tunix per l'apprendimento per rinforzo (RL) e l'allineamento allo stato dell'arte e una soluzione di inferenza unificata con vLLM-JAX e il runtime di pubblicazione JAX.
La filosofia dello stack JAX AI è quella di componenti a basso accoppiamento, ognuno dei quali svolge bene un'attività. Anziché essere un framework ML monolitico, JAX ha un ambito ristretto e si concentra su operazioni efficienti sugli array e trasformazioni dei programmi. L'ecosistema si basa su questo framework di base per fornire un'ampia gamma di funzionalità, relative sia all'addestramento di modelli ML sia ad altri tipi di workload, come il computing scientifico.
Questo sistema di componenti a basso accoppiamento ti consente di selezionare e combinare le librerie nel modo migliore per soddisfare i tuoi requisiti. Dal punto di vista dell'ingegneria del software, questa architettura consente anche di aggiornare in modo iterativo le funzionalità che tradizionalmente verrebbero considerate componenti del framework di base (ad esempio, pipeline di dati e checkpoint) senza il rischio di destabilizzare il framework di base o di essere coinvolti nei cicli di rilascio. Dato che la maggior parte delle funzionalità è implementata nelle librerie anziché nelle modifiche a un framework monolitico, la libreria numerica di base è più durevole e adattabile ai futuri cambiamenti nel panorama tecnologico.
Le sezioni seguenti forniscono una panoramica tecnica dello stack JAX AI, delle sue funzionalità chiave, delle decisioni di progettazione alla base e di come si combinano per creare una piattaforma durevole per i workload ML moderni.
JAX AI Stack e altri componenti dell'ecosistema
| Componente | Funzione / Descrizione |
|---|---|
| Core e componenti di JAX AI Stack1 | |
| JAX | Calcolo di array orientato all'acceleratore e trasformazione del programma (JIT, grad, vmap, pmap). |
| Flax | Libreria flessibile per la creazione di reti neurali per la creazione e la modifica intuitive dei modelli. |
| Optax | Una libreria di trasformazioni componibili per l'elaborazione e l'ottimizzazione dei gradienti. |
| Orbax | Libreria di checkpointing distribuito "Any-scale" per la resilienza dell'addestramento su larga scala. |
| Grana | Una libreria di pipeline di dati di input scalabile, deterministica e con checkpoint. |
| JAX AI Stack - Infrastruttura | |
| XLA | Compilatore di machine learning open source per TPU, CPU e GPU. |
| Pathways | Runtime distribuito per l'orchestrazione del calcolo su decine di migliaia di chip. |
| JAX AI Stack - Avanzato Sviluppo | |
| Pallas | Un'estensione JAX per la scrittura di kernel personalizzati di basso livello e ad alte prestazioni implementati in Python. |
| Tokamax | Una libreria curata di kernel personalizzati ad alte prestazioni e allo stato dell'arte (ad esempio, Attention). |
| Qwix | Una libreria completa e non invasiva per la quantizzazione (PTQ, QAT, QLoRA). |
| Stack JAX AI - Applicazione | |
| MaxText / MaxDiffusion | Framework di riferimento scalabili e di punta per l'addestramento di foundation model (ad esempio LLM e Diffusion). |
| Tunix | Un framework per il post-addestramento e l'allineamento allo stato dell'arte (RLHF, DPO). |
| vLLM-JAX | Una soluzione di inferenza LLM ad alte prestazioni che utilizza l'integrazione integrata del framework vLLM. |
| XProf | Un profiler approfondito e integrato nell'hardware per l'analisi delle prestazioni a livello di sistema. |
1Incluso nel pacchetto Python jax-ai-stack.
Figura 1: i componenti dello stack e dell'ecosistema JAX AI
L'imperativo dell'architettura: prestazioni oltre i framework
Man mano che le architetture dei modelli convergono, ad esempio sui transformer Mixture of Experts (MoE) multimodali, la ricerca delle massime prestazioni sta portando all'emergere dei megakernel. Un megakernel è in pratica l'intero forward pass (o una gran parte) di un modello specifico, codificato manualmente utilizzando un'API di livello inferiore come l'SDK CUDA sulle GPU NVIDIA. Questo approccio consente di ottenere il massimo utilizzo dell'hardware sovrapponendo in modo aggressivo calcolo, memoria e comunicazione. Un lavoro recente della community di ricerca ha dimostrato che questo approccio può generare significativi miglioramenti del throughput, in alcuni casi superiori al 22%, per l'inferenza su GPU. Questa tendenza non si limita all'inferenza; le prove suggeriscono che alcuni sforzi di addestramento su larga scala hanno coinvolto il controllo hardware di basso livello per ottenere significativi guadagni di efficienza.
Se questa tendenza accelera, tutti i framework di alto livello così come esistono oggi rischiano di diventare meno rilevanti, poiché l'accesso di basso livello all'hardware è ciò che conta in ultima analisi per le prestazioni su architetture mature e stabili. Questo rappresenta una sfida per tutti i moderni stack di ML: come fornire un controllo hardware di livello esperto senza sacrificare la produttività e la flessibilità di un framework di alto livello.
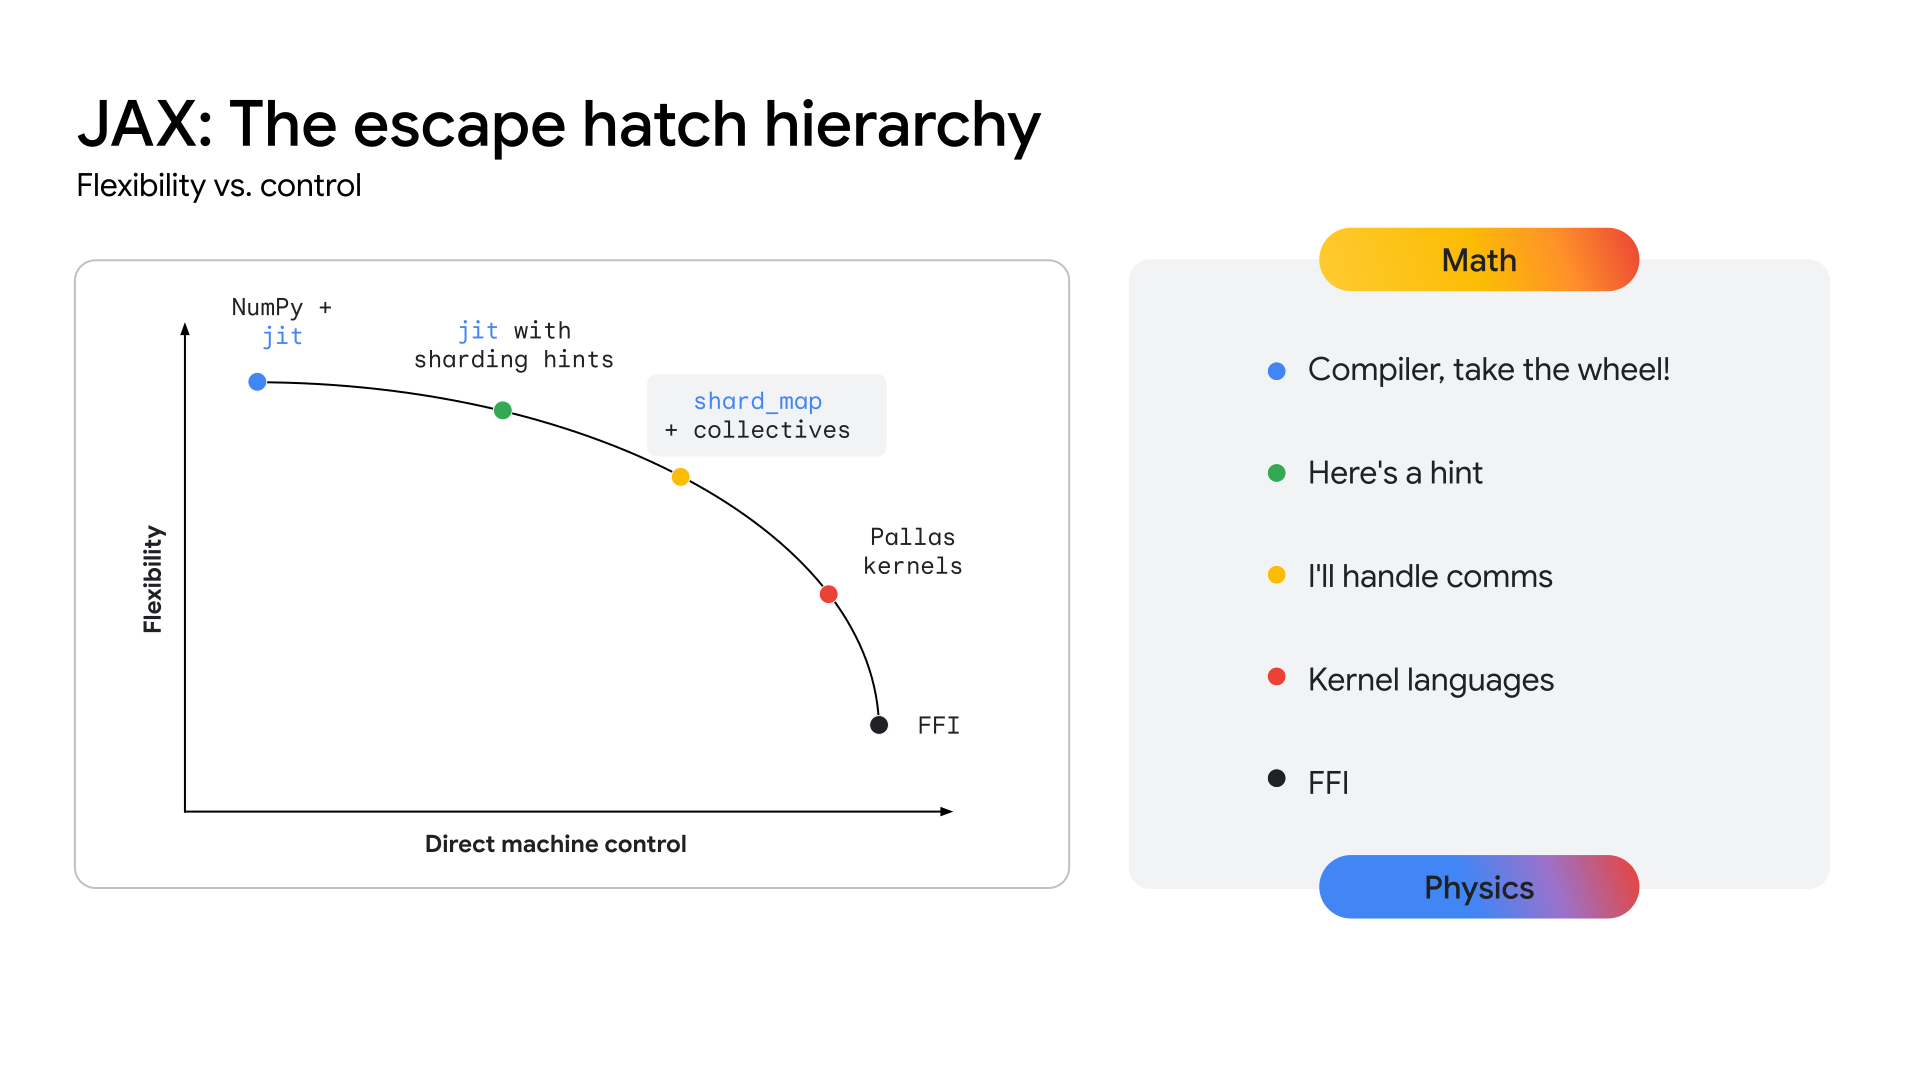
Affinché le TPU forniscano un percorso chiaro verso questo livello di prestazioni, l'ecosistema deve esporre un livello API più vicino all'hardware, consentendo lo sviluppo di questi kernel altamente specializzati. Lo stack JAX è progettato per risolvere questo problema offrendo un continuum di astrazione (vedi Figura 2), dalle ottimizzazioni automatizzate di alto livello del compilatore XLA al controllo manuale granulare della libreria di creazione di kernel Pallas.
Figura 2: il continuum di astrazione di JAX
Lo stack JAX AI principale
Il JAX AI Stack di base è costituito da cinque librerie chiave che forniscono le fondamenta per lo sviluppo dei modelli:
JAX: una base per la trasformazione di programmi componibili e ad alte prestazioni
JAX è una libreria Python per il calcolo di array orientato agli acceleratori e la trasformazione dei programmi, progettata per il calcolo numerico ad alte prestazioni e il machine learning su larga scala. Con il suo modello di programmazione funzionale e l'API simile a NumPy, JAX fornisce una solida base per le librerie di livello superiore.
Con il suo design incentrato sul compilatore, JAX promuove intrinsecamente la scalabilità sfruttando XLA (consulta la sezione XLA) per l'analisi, l'ottimizzazione e il targeting hardware aggressivi dell'intero programma. L'enfasi di JAX sulla programmazione funzionale (ad esempio, le funzioni pure) rende le trasformazioni del programma di base più gestibili e, soprattutto, componibili.
Queste trasformazioni di base possono essere combinate e abbinate per ottenere prestazioni elevate e scalabilità dei workload in base alle dimensioni del modello, alle dimensioni del cluster e ai tipi di hardware:
- jit: compilazione just-in-time di funzioni Python in eseguibili XLA ottimizzati e fusi.
- grad: differenziazione automatica, che supporta la modalità forward e reverse, nonché le derivate di ordine superiore.
- vmap: vettorizzazione automatica, che consente l'elaborazione in batch e il parallelismo dei dati senza interruzioni e senza modificare la logica della funzione.
- pmap / shard_map: parallelizzazione automatica su più dispositivi (ad esempio core TPU), che costituisce la base per l'addestramento distribuito.
L'integrazione perfetta con il modello GSPMD (General-purpose SPMD) di XLA consente a JAX di parallelizzare automaticamente i calcoli su pod di TPU di grandi dimensioni con modifiche minime al codice. Nella maggior parte dei casi, la scalabilità richiede solo annotazioni di sharding di alto livello.
Flax: creazione flessibile di reti neurali
Flax semplifica la creazione, il debug e l'analisi delle reti neurali in JAX fornendo un approccio intuitivo e orientato agli oggetti per la creazione di modelli. Sebbene l'API funzionale di JAX sia potente, offre un'astrazione basata su livelli più familiare per gli sviluppatori abituati a framework come PyTorch, senza alcuna penalizzazione delle prestazioni.
Questo design semplifica la modifica o la combinazione dei componenti del modello addestrato.
Tecniche come LoRA e la quantizzazione richiedono definizioni di modelli manipolabili,
che l'API NNX di Flax fornisce tramite un'interfaccia Pythonic. NNX incapsula lo stato del modello, riducendo il carico cognitivo dell'utente e consentendo l'attraversamento e la modifica programmatica della gerarchia del modello.
Punti di forza principali:
- API intuitiva orientata agli oggetti: semplifica la creazione dei modelli e consente casi d'uso avanzati come la sostituzione dei sottomoduli e l'inizializzazione parziale.
- Coerenza con Core JAX: Flax fornisce trasformazioni elevate che sono completamente compatibili con il paradigma funzionale di JAX, offrendo le prestazioni complete di JAX con una maggiore facilità d'uso per gli sviluppatori.
Optax: strategie di ottimizzazione ed elaborazione dei gradienti componibili
Optax è una libreria di elaborazione e ottimizzazione dei gradienti per JAX. È progettato per fornire ai creatori di modelli componenti di base che possono essere ricombinati in modi personalizzati per addestrare modelli di deep learning, tra le altre applicazioni. Si basa sulle funzionalità della libreria JAX di base per fornire una libreria ad alte prestazioni ben testata di funzioni di perdita e ottimizzatore e tecniche associate che possono essere utilizzate per addestrare i modelli ML.
Motivazione
Il calcolo e la minimizzazione delle perdite sono alla base dell'addestramento dei modelli di ML. Con il suo supporto per la differenziazione automatica, la libreria JAX di base fornisce le funzionalità numeriche per addestrare i modelli, ma non fornisce implementazioni standard di ottimizzatori popolari (ad esempio, RMSProp o Adam) o perdite (ad esempio, CrossEntropy o MSE). Sebbene sia possibile implementare queste funzioni (e alcuni sviluppatori avanzati sceglieranno di farlo), un bug in un'implementazione dell'ottimizzatore introdurrebbe problemi di qualità del modello difficili da diagnosticare. Anziché lasciare che l'utente implementi queste parti critiche, Optax fornisce implementazioni di questi algoritmi testate per verificarne la correttezza e le prestazioni.
Il campo della teoria dell'ottimizzazione rientra pienamente nell'ambito della ricerca, ma il suo ruolo centrale nell'addestramento lo rende anche una parte indispensabile dell'addestramento dei modelli ML di produzione. Una libreria che svolge questo ruolo deve essere abbastanza flessibile da consentire iterazioni di ricerca rapide, ma anche abbastanza solida e performante da essere affidabile per l'addestramento dei modelli di produzione. Dovrebbe anche fornire implementazioni ben testate di algoritmi all'avanguardia che corrispondono alle equazioni standard. La libreria Optax, grazie alla sua architettura componibile modulare e all'enfasi sul codice leggibile corretto, è progettata per raggiungere questo obiettivo.
Design
Optax è progettato per migliorare la velocità della ricerca e la transizione dalla ricerca alla produzione fornendo implementazioni leggibili, ben testate ed efficienti degli algoritmi di base. Optax ha utilizzi che vanno oltre il contesto del deep learning, tuttavia in questo contesto può essere visto come una raccolta di funzioni di perdita, algoritmi di ottimizzazione e trasformazioni del gradiente ben noti, implementati in modo puramente funzionale in linea con la filosofia di JAX. La raccolta di perdite e ottimizzatori ben noti consente agli utenti di iniziare con facilità e sicurezza.
L'approccio modulare adottato da Optax consente di concatenare più ottimizzatori seguiti da altre trasformazioni comuni (ad esempio, il clipping del gradiente) e di eseguirne il wrapping utilizzando tecniche comuni come MultiStep o Lookahead per ottenere strategie di ottimizzazione potenti con poche righe di codice. L'interfaccia flessibile ti consente di ricercare nuovi algoritmi di ottimizzazione e di utilizzare potenti tecniche di ottimizzazione di secondo ordine come Shampoo o Muon.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
Lo snippet di codice precedente mostra come configurare un ottimizzatore con un tasso di apprendimento personalizzato, il clipping del gradiente e l'accumulo del gradiente.
Punti di forza principali
- Libreria completa: fornisce una libreria completa di perdite, ottimizzatori e algoritmi con un focus su correttezza e leggibilità.
- Trasformazioni modulari concatenabili: questa API flessibile ti consente di creare strategie di ottimizzazione potenti e complesse in modo dichiarativo, senza modificare il ciclo di addestramento.
- Funzionale e scalabile: le implementazioni puramente funzionali si integrano perfettamente con i meccanismi di parallelizzazione di JAX (ad esempio pmap), consentendoti di utilizzare lo stesso codice per scalare da un singolo host a cluster di grandi dimensioni.
Orbax / TensorStore: checkpointing distribuito su larga scala
Orbax è una libreria di checkpoint per JAX progettata per qualsiasi scala, dall'addestramento distribuito su un singolo dispositivo a quello su larga scala. Il suo obiettivo è unificare le implementazioni di checkpointing frammentate e offrire funzionalità di prestazioni critiche, come il checkpointing asincrono e multilivello, a un pubblico più ampio. Orbax consente la resilienza necessaria per job di addestramento di grandi dimensioni e fornisce un formato flessibile per la pubblicazione dei checkpoint.
A differenza dei sistemi di checkpoint e ripristino generalizzati che acquisiscono snapshot dell'intero stato del sistema, il checkpointing ML con Orbax conserva in modo selettivo solo le informazioni essenziali per riprendere l'addestramento: pesi del modello, stato dell'ottimizzatore e stato del caricatore di dati. Questo approccio mirato riduce al minimo i tempi di inattività dell'acceleratore. Orbax ci riesce sovrapponendo le operazioni di I/O al calcolo, una funzionalità fondamentale per workload di grandi dimensioni. Il tempo di inattività degli acceleratori viene ridotto alla durata del trasferimento di dati dal dispositivo all'host, che può essere ulteriormente sovrapposto al passaggio di addestramento successivo, rendendo il checkpoint quasi senza costi dal punto di vista delle prestazioni.
In sostanza, Orbax utilizza TensorStore per la lettura e la scrittura parallele ed efficienti dei dati degli array. L'API Orbax astrae questa complessità, offrendo un'interfaccia facile da usare per la gestione dei PyTrees, che sono la rappresentazione standard dei modelli in JAX.
Punti di forza principali:
- Adozione diffusa: con milioni di download mensili, Orbax funge da mezzo comune per la condivisione di artefatti ML.
- Semplifica le complessità: Orbax elimina le complessità del checkpointing distribuito, tra cui il salvataggio asincrono, l'atomicità e i dettagli del file system.
- Flessibilità: oltre a offrire API per casi d'uso comuni, Orbax ti consente di personalizzare il tuo workflow per gestire requisiti specializzati.
- Prestazioni e scalabilità: funzionalità come il checkpoint asincrono, un formato di archiviazione efficiente (OCDBT) e strategie di caricamento dei dati intelligenti garantiscono la scalabilità di Orbax per le esecuzioni di addestramento che coinvolgono decine di migliaia di nodi.
Grain: pipeline di dati di input deterministiche e scalabili
Grain è una libreria Python per la lettura e l'elaborazione dei dati per l'addestramento e la valutazione dei modelli JAX. È flessibile, veloce e deterministico e supporta funzionalità avanzate come il checkpointing, essenziali per l'addestramento di workload di grandi dimensioni. Supporta formati di dati e backend di archiviazione comuni e fornisce anche un'API flessibile per estendere il supporto a formati e backend specifici dell'utente che non sono supportati in modo nativo. Sebbene Grain sia progettato principalmente per funzionare con JAX, è indipendente dal framework, non richiede JAX per l'esecuzione e può essere utilizzato anche con altri framework.
Motivazione
Data pipelines costituiscono una parte fondamentale dell'infrastruttura di addestramento: devono essere flessibili in modo che le trasformazioni comuni possano essere espresse in modo efficiente e abbastanza performanti da poter mantenere gli acceleratori sempre occupati. Inoltre, devono essere in grado di supportare più formati di archiviazione e backend. A causa dei tempi di passaggio più elevati, l'addestramento di modelli di grandi dimensioni su larga scala impone alla pipeline di dati requisiti aggiuntivi rispetto a quelli richiesti dai normali workload di addestramento, incentrati principalmente sul determinismo e sulla riproducibilità2. La libreria Grain è progettata con un'architettura flessibile che soddisfa queste esigenze.
2 Nella sezione 5.1 del paper su PaLM, gli autori osservano di aver rilevato picchi di perdita molto elevati nonostante l'abilitazione del gradient clipping. La soluzione è stata rimuovere i batch di dati problematici e riavviare l'addestramento da un checkpoint precedente al picco di perdita. Questo è possibile solo con una configurazione di addestramento completamente deterministica e riproducibile.
Design
A livello più alto, esistono due modi per strutturare una pipeline di input: come cluster separato di worker di dati o collocando i worker di dati sugli host che gestiscono gli acceleratori. Grain sceglie quest'ultima opzione per una serie di motivi.
Gli acceleratori sono combinati con host potenti che in genere rimangono inattivi durante le fasi di addestramento, il che li rende una scelta naturale per l'esecuzione della pipeline di dati di input. Questa implementazione offre ulteriori vantaggi: semplifica la visualizzazione dello sharding dei dati fornendo una visualizzazione coerente dello sharding tra input e calcolo. Si potrebbe sostenere che l'inserimento del worker di dati sull'host dell'acceleratore rischi di saturare la CPU dell'host, ma ciò non preclude l'offload delle trasformazioni ad alta intensità di calcolo su un altro cluster utilizzando le RPC3.
Per quanto riguarda l'API, con un'implementazione Python pura che supporta più processi e un'API flessibile, Grain ti consente di implementare trasformazioni di dati arbitrariamente complesse componendo le fasi della pipeline in base a paradigmi di trasformazione ben compresi.
In modo predefinito, Grain supporta formati di dati ad accesso casuale efficienti come ArrayRecord e Bagz, oltre ad altri formati di dati popolari come Parquet e TFDS. Grain include il supporto per la lettura da file system locali e da Cloud Storage per impostazione predefinita. Oltre a supportare i formati di archiviazione e i backend più diffusi, un'astrazione pulita del livello di archiviazione ti consente di aggiungere il supporto o di eseguire il wrapping delle origini dati esistenti per renderle compatibili con la libreria Grain.
3È così che devono funzionare le pipeline di dati multimodali: i tokenizer di immagini e audio, ad esempio, sono modelli che vengono eseguiti nei propri cluster sui propri acceleratori e le pipeline di input effettuano chiamate RPC per convertire gli esempi di dati in stream di token.
Punti di forza principali
- Inserimento dei dati deterministico: la collocazione del worker dei dati con l'acceleratore e l'accoppiamento con uno shuffle globale stabile e iteratori con checkpoint consentono di creare checkpoint dello stato del modello e della pipeline di dati insieme in uno snapshot coerente utilizzando Orbax, migliorando il determinismo del processo di addestramento.
- API flessibili per consentire trasformazioni dei dati efficaci: un'API di trasformazioni Python pura e flessibile ti consente di eseguire trasformazioni dei dati estese all'interno della pipeline di elaborazione degli input.
- Supporto estensibile per più formati e backend: un'API origini dati estensibile supporta formati di archiviazione e backend più diffusi e consente di aggiungere il supporto per nuovi formati e backend.
- Potente interfaccia di debug: gli strumenti di visualizzazione della pipeline di dati e una modalità di debug ti consentono di esaminare, eseguire il debug e ottimizzare le prestazioni delle pipeline di dati.
Lo stack JAX AI esteso
Oltre allo stack di base, un ricco ecosistema di librerie specializzate fornisce l'infrastruttura, gli strumenti avanzati e le soluzioni a livello di applicazione necessari per lo sviluppo ML end-to-end.
Infrastruttura di base: compilatori e runtime
XLA: il motore indipendente dall'hardware e incentrato sul compilatore
Motivazione
XLA o Accelerated Linear Algebra è il compilatore specifico per il dominio di Google, che è ben integrato in JAX e supporta dispositivi hardware TPU, CPU e GPU. XLA è stato progettato per essere un generatore di codice indipendente dall'hardware, destinato a TPU, GPU e CPU.
Il design incentrato sul compilatore del compilatore XLA è una scelta architettonica fondamentale che crea un vantaggio duraturo in un panorama di ricerca in rapida evoluzione. Al contrario, l'approccio incentrato sul kernel prevalente in altri ecosistemi si basa su librerie ottimizzate manualmente per le prestazioni. Sebbene questo approccio sia molto efficace per architetture di modelli stabili e consolidate, crea un collo di bottiglia per l'innovazione. Quando nuove ricerche introducono architetture innovative, l'ecosistema deve attendere che vengano scritti e ottimizzati nuovi kernel. Tuttavia, il nostro design incentrato sul compilatore può spesso generalizzare nuovi pattern, fornendo un percorso ad alte prestazioni per la ricerca all'avanguardia fin dal primo giorno.
Design
XLA funziona compilando JIT (Just-In-Time) i grafici di calcolo generati da JAX durante il processo di tracciamento (ad esempio, quando una funzione è decorata con @jax.jit).
Questa compilazione segue una pipeline multifase:
- Grafico di calcolo JAX
- High-Level Optimizer (HLO)
- Low-Level Optimizer (LLO)
- Codice hardware
- Dal grafo JAX a HLO: il grafo di calcolo JAX viene convertito nella rappresentazione HLO di XLA. A questo livello elevato, vengono applicate ottimizzazioni potenti e indipendenti dall'hardware, come la fusione degli operatori e una gestione efficiente della memoria. Il dialetto StableHLO funge da interfaccia durevole e con controllo delle versioni per questa fase.
- Da HLO a LLO: dopo le ottimizzazioni di alto livello, i backend specifici dell'hardware prendono il sopravvento, riducendo la rappresentazione HLO in un LLO orientato alla macchina.
- Da LLO a codice hardware: l'LLO viene infine compilato in un codice macchina altamente efficiente. Per le TPU, questo codice viene raggruppato in pacchetti Very Long Instruction Word (VLIW) che vengono inviati direttamente all'hardware.
Per la scalabilità, il design di XLA è incentrato sul parallelismo. Utilizza algoritmi per sfruttare al massimo le unità di moltiplicazione di matrici (MXU) su un chip. Tra i chip, XLA utilizza SPMD (Single Program Multiple Data), una tecnica di parallelizzazione basata su compilatore che utilizza un singolo programma su tutti i dispositivi. Questo potente modello viene esposto tramite le API JAX, consentendoti di gestire il parallelismo di dati, modelli o pipeline con annotazioni di sharding di alto livello.
Per pattern di parallelismo più complessi, è possibile anche il modello Multiple Program Multiple Data (MPMD) e librerie come PartIR:MPMD consentono agli utenti JAX di fornire anche annotazioni MPMD.
Punti di forza principali
- Compilazione: la compilazione just-in-time del grafico di calcolo consente di ottimizzare il layout della memoria, l'allocazione del buffer e la gestione della memoria. Le alternative, come le metodologie basate su kernel, scaricano questo onere sullo sviluppatore. Nella maggior parte dei casi, XLA può ottenere prestazioni eccellenti senza compromettere la velocità di sviluppo.
- Parallelismo: XLA implementa diverse forme di parallelismo con SPMD, che viene esposto a livello di JAX. In questo modo, puoi esprimere strategie di sharding, consentendo la sperimentazione e la scalabilità dei modelli su migliaia di chip.
Pathways: un runtime unificato per il computing distribuito su larga scala
Pathways offre astrazioni per l'addestramento e l'inferenza distribuiti con tolleranza di errore e recupero integrati, consentendo ai ricercatori di ML di programmare come se utilizzassero una singola macchina potente.
Motivazione
Per poter addestrare ed eseguire il deployment di modelli di grandi dimensioni, sono necessari da centinaia a migliaia di chip. Questi chip sono distribuiti su numerosi rack e macchine host. Un job di addestramento è un programma sincrono su larga scala che richiede che tutti questi chip e i rispettivi host lavorino in tandem su calcoli XLA parallelizzati (sharded). Nel caso di modelli linguistici di grandi dimensioni, che potrebbero richiedere più di decine di migliaia di chip, questo servizio deve essere in grado di estendersi su più pod in un fabric di data center, oltre a utilizzare fabric di interconnessione interchip (ICI) e interconnessione on-chip (OCI) all'interno di un pod.
Design
ML Pathways è il sistema che utilizziamo per coordinare i calcoli distribuiti tra host e chip TPU. È progettato per la scalabilità e l'efficienza su centinaia di migliaia di acceleratori. Per l'addestramento su larga scala, fornisce un singolo client Python per più job pod, l'integrazione di Megascale XLA, il servizio di compilazione e Python remoto. Supporta anche il parallelismo tra sezioni e la tolleranza di prerilascio, consentendo il recupero automatico dai prerilasci delle risorse.
Pathways incorpora collettivi cross-host ottimizzati che consentono ai grafici di calcolo XLA di estendersi oltre un singolo pod di TPU. Estende il supporto di XLA per il parallelismo di dati, modelli e pipeline per lavorare oltre i confini delle sezioni TPU utilizzando la rete di data center (DCN) tramite l'integrazione di un runtime distribuito che gestisce la comunicazione DCN con le primitive di comunicazione XLA.
Punti di forza principali
L'architettura a controller singolo, integrata con JAX, è un'astrazione chiave. Consente ai ricercatori di esplorare varie strategie di sharding e parallelismo per l'addestramento e il deployment, scalando facilmente fino a decine di migliaia di chip.
Sviluppo avanzato: prestazioni, dati ed efficienza
Pallas: scrittura di kernel personalizzati ad alte prestazioni in JAX
Sebbene JAX sia un framework incentrato sul compilatore, in alcune situazioni potresti voler avere un controllo granulare sull'hardware per ottenere le massime prestazioni. Pallas è un'estensione di JAX che consente di scrivere kernel personalizzati per GPU e TPU. Mira a fornire un controllo preciso sul codice generato, combinato con l'ergonomia di alto livello del tracciamento JAX e dell'API jax.numpy.
Pallas espone un modello di parallelismo basato su griglia in cui una funzione kernel definita dall'utente viene avviata su una griglia multidimensionale di gruppi di lavoro paralleli. Consente la gestione esplicita della gerarchia della memoria, permettendoti di definire il modo in cui i tensori vengono suddivisi e trasferiti tra una memoria più lenta e più grande (ad esempio, HBM) e una memoria on-chip più veloce e più piccola (ad esempio, VMEM su TPU, memoria condivisa su GPU), utilizzando mappe di indici per associare le posizioni della griglia a blocchi di dati specifici. Pallas può ridurre la stessa definizione del kernel per l'esecuzione efficiente sia sulle TPU di Google che su varie GPU, compilando i kernel in una rappresentazione intermedia adatta all'architettura di destinazione: Mosaic per le TPU o utilizzando tecnologie come Triton per le GPU. Con Pallas, puoi scrivere kernel ad alte prestazioni che specializzano blocchi come l'attenzione per ottenere le migliori prestazioni del modello sull'hardware di destinazione senza dover fare affidamento su toolkit specifici del fornitore.
Tokamax: una libreria selezionata di kernel all'avanguardia
Se Pallas è uno strumento per la creazione di kernel, Tokamax è una libreria di kernel di acceleratori personalizzati allo stato dell'arte che supportano sia TPU che GPU. Tokamax si basa su JAX e Pallas e ti consente di sfruttare tutta la potenza del tuo hardware. Inoltre, fornisce strumenti per creare e ottimizzare automaticamente i kernel personalizzati.
Motivazione
JAX, con le sue radici in XLA, è un framework incentrato sul compilatore, tuttavia esiste un insieme ristretto di casi in cui potresti dover assumere il controllo diretto dell'hardware per ottenere le massime prestazioni4. I kernel personalizzati sono fondamentali per ottenere le migliori prestazioni dalle costose risorse degli acceleratori ML, come TPU e GPU. Sebbene siano ampiamente utilizzati per consentire l'esecuzione ad alte prestazioni di operatori chiave come Attention, la loro implementazione richiede una profonda comprensione sia del modello che dell'architettura hardware di destinazione. Tokamax fornisce un'unica fonte autorevole di kernel selezionati, ben testati e ad alte prestazioni, insieme a una solida infrastruttura condivisa per lo sviluppo, la manutenzione e la gestione del ciclo di vita. Una libreria di questo tipo può anche fungere da implementazione di riferimento su cui basarti e da personalizzare in base alle tue esigenze. In questo modo puoi concentrarti sulle attività di modellazione senza doverti preoccupare dell'infrastruttura.
4Si tratta di un paradigma consolidato che ha un precedente nel mondo delle CPU, dove il codice compilato costituisce la maggior parte del programma e gli sviluppatori utilizzano funzioni intrinseche o assembly inline per ottimizzare le sezioni critiche per le prestazioni.
Design
Per ogni kernel, Tokamax fornisce un'API comune che può essere supportata da più implementazioni. Ad esempio, i kernel TPU possono essere implementati tramite la riduzione XLA standard o esplicitamente con Pallas/Mosaic-TPU. I kernel GPU possono essere implementati tramite l'abbassamento XLA standard, con Mosaic-GPU o Triton. Per impostazione predefinita, l'API Tokamax sceglie l'implementazione più nota per una determinata configurazione, determinata dai risultati memorizzati nella cache delle esecuzioni periodiche di ottimizzazione automatica e benchmarking, anche se puoi scegliere implementazioni specifiche, se necessario. Nel tempo, potrebbero essere aggiunte nuove implementazioni per sfruttare meglio le funzionalità specifiche delle nuove generazioni di hardware e ottenere prestazioni ancora migliori.
Un componente chiave della libreria Tokamax, oltre ai kernel stessi, è l'infrastruttura di supporto che consente di scrivere kernel personalizzati. Ad esempio, l'infrastruttura di ottimizzazione automatica consente di definire un insieme di parametri configurabili (ad esempio, le dimensioni dei tile) su cui Tokamax può eseguire un'analisi esaustiva per determinare e memorizzare nella cache le migliori impostazioni ottimizzate possibili. Le regressioni notturne ti proteggono da problemi imprevisti di prestazioni e numerici causati da modifiche all'infrastruttura del compilatore sottostante o ad altre dipendenze.
Punti di forza principali
- Esperienza sviluppatore senza interruzioni: una libreria unificata e curata fornisce implementazioni note, buone e ad alte prestazioni dei kernel chiave, con espressioni chiare delle generazioni di hardware supportate e delle prestazioni previste, sia in modo programmatico sia nella documentazione. In questo modo si riducono al minimo la frammentazione e l'abbandono.
- Flessibilità e gestione del ciclo di vita: puoi scegliere diverse implementazioni, anche modificandole nel tempo, se opportuno. Ad esempio, se il compilatore XLA migliora il supporto per determinate operazioni e non richiede più kernel personalizzati, esiste un percorso di ritiro e migrazione.
- Estensibilità: puoi implementare i tuoi kernel sfruttando un'infrastruttura condivisa ben supportata, in modo da concentrarti su funzionalità e ottimizzazioni a valore aggiunto. Le implementazioni standard chiaramente create fungono da punto di partenza per gli utenti, che possono imparare da queste ed estenderle.
Qwix: quantizzazione completa e non invasiva
Qwix è una libreria di quantizzazione completa per lo stack JAX AI, che supporta sia gli LLM che altri tipi di modelli in tutte le fasi, tra cui l'addestramento (Quantization Aware Training (QAT), Quantization Technique (QT), Quantized Low-Rank Adaptation (QLoRA)) e l'inferenza Post Training Quantization (PTQ), con target sia XLA che runtime on-device.
Motivazione
Le librerie di quantizzazione esistenti, in particolare nell'ecosistema PyTorch, spesso hanno scopi limitati (ad esempio, solo PTQ o solo QLoRA). Questo panorama frammentato ti costringe a cambiare strumento, impedendo un utilizzo coerente del codice e una corrispondenza numerica precisa tra addestramento e inferenza. Inoltre, molte soluzioni richiedono modifiche sostanziali al modello, accoppiando strettamente la logica del modello alla logica di quantizzazione.
Design
La filosofia di progettazione di Qwix enfatizza una soluzione completa e, soprattutto, un'integrazione dei modelli non invasiva. È progettato con un design gerarchico ed estensibile basato su API funzionali riutilizzabili.
Questa integrazione non invasiva viene ottenuta tramite un meccanismo di intercettazione progettato meticolosamente che reindirizza le funzioni JAX alle loro controparti quantizzate. In questo modo puoi integrare i tuoi modelli senza alcuna modifica, disaccoppiando completamente il codice di quantizzazione dalle definizioni dei modelli.
L'esempio seguente mostra l'applicazione della quantizzazione w4a4 (un peso a 4 bit, un'attivazione a 4 bit) agli strati MLP di un LLM e della quantizzazione w8 (un peso a 8 bit) all'embedder. Per modificare la formula di quantizzazione, devi solo aggiornare l'elenco delle regole.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
Punti di forza principali
- Soluzione completa: Qwix è ampiamente applicabile in numerosi scenari di quantizzazione, garantendo un utilizzo coerente del codice tra addestramento e inferenza.
- Integrazione dei modelli non invasiva: come mostra l'esempio, puoi integrare i modelli con una sola riga di codice. In questo modo, puoi utilizzare gli iperparametri su molti schemi di quantizzazione per trovare il miglior compromesso tra qualità e prestazioni.
- Federato con altre librerie: Qwix si integra perfettamente con lo stack JAX AI. Ad esempio, Tokamax si adatta automaticamente per utilizzare versioni quantizzate dei kernel, senza codice utente aggiuntivo, quando il modello viene quantizzato con Qwix.
- Adatto alla ricerca: le API di base e l'architettura estensibile di Qwix consentono ai ricercatori di esplorare nuovi algoritmi e facilitano i confronti diretti con strumenti di benchmark e valutazione integrati.
Il livello di applicazione: addestramento e allineamento
Addestramento dei foundation model: MaxText e MaxDiffusion
MaxText e MaxDiffusion sono i framework di addestramento dei modelli LLM e di diffusione di punta di Google. Questi repository contengono una selezione di implementazioni altamente ottimizzate di modelli open-weights popolari. Hanno un duplice scopo: fungono sia da codebase di addestramento del modello pronta all'uso sia da riferimento su cui gli sviluppatori di foundation model possono basarsi.
Motivazione
L'interesse per l'addestramento dei modelli di AI generativa sta crescendo rapidamente in tutto il settore. La popolarità dei modelli aperti ha accelerato questa tendenza, fornendo architetture collaudate. L'addestramento e l'adattamento di questi modelli richiedono prestazioni elevate, efficienza, scalabilità per un numero elevato di chip e un codice chiaro e comprensibile. MaxText e MaxDiffusion sono soluzioni complete che possono essere utilizzate su TPU o GPU e sono progettate per soddisfare queste esigenze.
Design
MaxText e MaxDiffusion sono codebase di modelli di base progettati tenendo conto della leggibilità e delle prestazioni. Sono strutturati con componenti riutilizzabili e ben testati: definizioni di modelli che utilizzano kernel personalizzati (come Tokamax) per le massime prestazioni, un'imbracatura di addestramento per l'orchestrazione e il monitoraggio e un potente sistema di configurazione che consente di controllare dettagli come lo sharding e la quantizzazione (utilizzando Qwix) tramite un'interfaccia intuitiva. Sono incorporate funzionalità di affidabilità avanzate, come il checkpointing multilivello, per garantire un goodput sostenuto.
MaxText e MaxDiffusion utilizzano le migliori librerie JAX della categoria Qwix, Tunix, Orbax e Optax per fornire funzionalità di base. Queste librerie forniscono un'infrastruttura solida e scalabile, riducendo l'overhead di sviluppo e consentendoti di concentrarti sull'attività di modellazione. Per l'inferenza, il codice del modello viene condiviso per consentire una distribuzione efficiente e scalabile.
Punti di forza principali
- Prestazioni integrate: con un'infrastruttura di addestramento configurata per un "goodput" (throughput utile) elevato e implementazioni dei modelli ottimizzate per un MFU (Model Flops Utilization) elevato, MaxText e MaxDiffusion offrono prestazioni elevate su larga scala fin da subito.
- Progettati per la scalabilità: sfruttando la potenza dello stack JAX AI (in particolare Pathways), questi framework ti consentono di scalare senza problemi da decine di chip a decine di migliaia di chip.
- Base solida per i creatori di modelli di base: le implementazioni leggibili e di alta qualità fungono da solido punto di partenza per gli sviluppatori, che possono utilizzarle come soluzione end-to-end o come implementazione di riferimento per le proprie personalizzazioni.
Post-addestramento e allineamento: il framework Tunix
Tunix offre algoritmi di apprendimento per rinforzo (RL) open source all'avanguardia, insieme a un framework e un'infrastruttura solidi, fornendo un percorso semplificato per gli sviluppatori per sperimentare tecniche di post-addestramento degli LLM, tra cui il fine-tuning supervisionato (SFT) e l'allineamento utilizzando JAX e TPU.
Motivazione
Il post-addestramento è un passaggio fondamentale per sbloccare il vero potenziale degli LLM. La fase di apprendimento per rinforzo (RL) è particolarmente cruciale per lo sviluppo di capacità di allineamento e ragionamento. Lo sviluppo open source in questo ambito si è basato quasi esclusivamente su PyTorch e GPU, lasciando un divario fondamentale per le soluzioni JAX e TPU. Tunix (Tune-in-JAX) è una libreria JAX-native ad alte prestazioni progettata per colmare questa lacuna.
Design
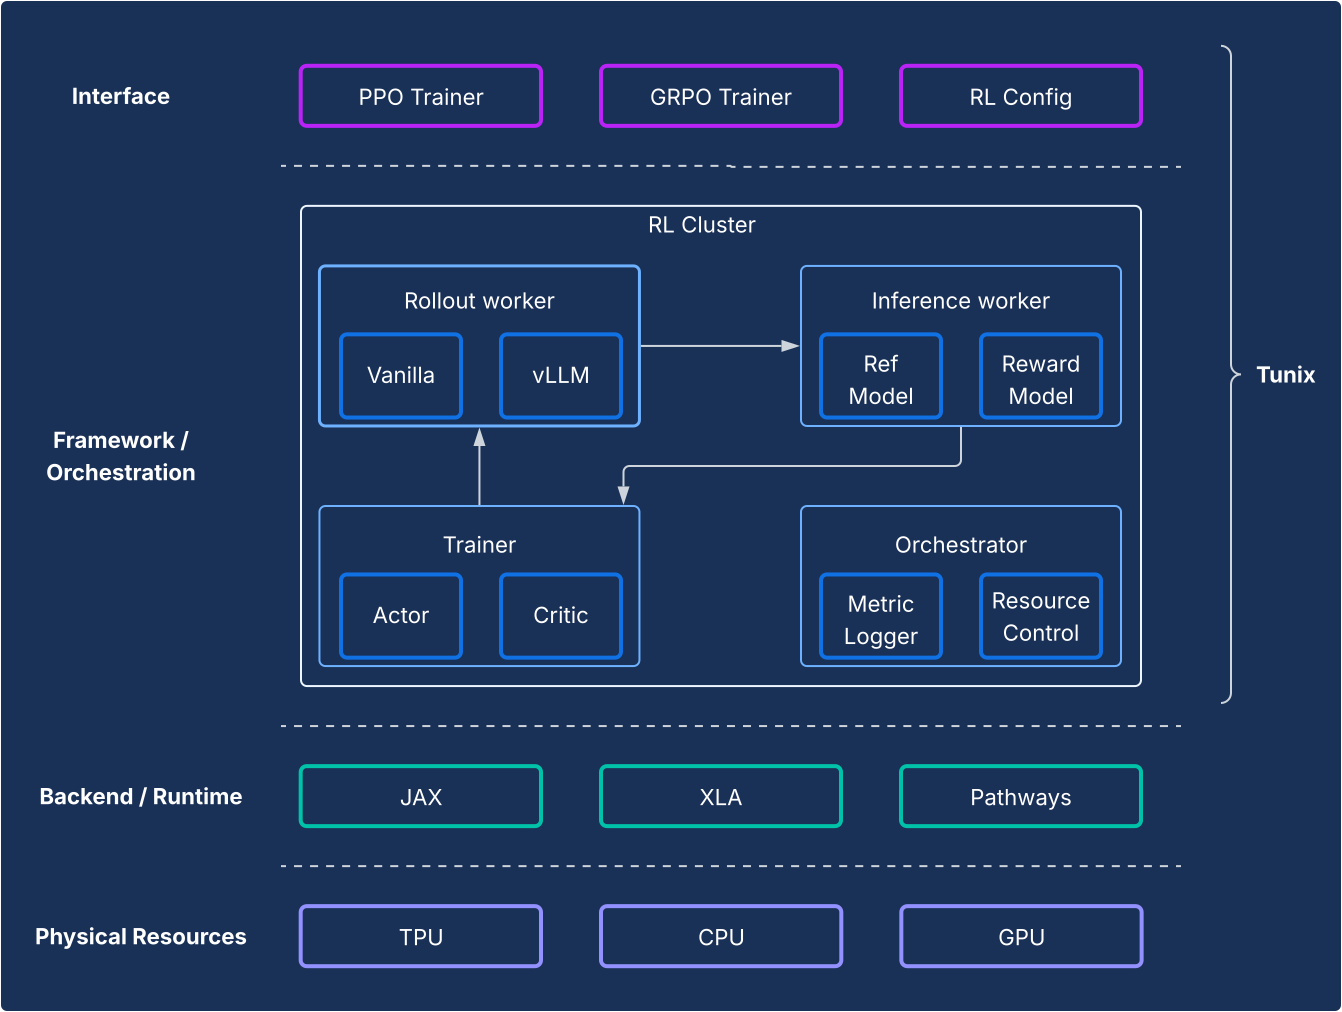
Dal punto di vista del framework, Tunix consente una configurazione allo stato dell'arte che separa chiaramente gli algoritmi di RL dall'infrastruttura. Offre un'API leggera simile a un client che nasconde la complessità dell'infrastruttura RL, consentendoti di sviluppare nuovi algoritmi. Tunix fornisce soluzioni pronte all'uso per algoritmi popolari, tra cui Proximal Policy Optimization (PPO), Direct Preference Optimization (DPO) e altri.
Dal punto di vista dell'infrastruttura, Tunix è integrato con Pathways, consentendo un'architettura a controller singolo che rende accessibile l'addestramento RL multi-nodo. Per quanto riguarda l'addestramento, Tunix supporta in modo nativo l'addestramento efficiente dei parametri (ad esempio, LoRA) e sfrutta lo sharding JAX e XLA (General and Scalable Parallelization for ML Computation Graph, GSPMD) per generare un grafico di calcolo ad alte prestazioni. Supporta modelli open source popolari come Gemma e Llama out of the box.
Punti di forza principali
- Semplicità: fornisce un'API di alto livello simile a un client che astrae le complessità dell'infrastruttura distribuita sottostante.
- Efficienza degli sviluppatori: Tunix accelera il ciclo di vita di ricerca e sviluppo con algoritmi e "ricette" integrati, fornendo un modello funzionante e consentendo di eseguire iterazioni rapidamente.
- Prestazioni e scalabilità: Tunix consente un'infrastruttura di addestramento altamente efficiente e scalabile in orizzontale sfruttando Pathways come controller unico nel backend.
Il livello di applicazione: produzione e inferenza
Una sfida storica per l'adozione di JAX è stato il percorso dalla ricerca alla produzione. Lo stack JAX AI ora offre una storia di produzione matura e su due fronti che offre sia la compatibilità con l'ecosistema sia le prestazioni di JAX.
Inferenza LLM ad alte prestazioni: la soluzione vLLM-JAX
vLLM-JAX è il backend di inferenza ad alte prestazioni di Google progettato per eseguire in modo efficiente i modelli linguistici di grandi dimensioni (LLM) JAX su Cloud TPU. Integra il framework vLLM open source con l'ecosistema JAX e TPU di Google. Per l'erogazione di modelli PyTorch con vLLM su TPU, consulta PyTorch su Cloud TPU.
Motivazione
Il settore è in rapida evoluzione, con una crescente domanda di soluzioni di inferenza semplici, ad alte prestazioni e facili da usare. Gli sviluppatori spesso devono affrontare sfide significative dovute a strumenti complessi e incoerenti, prestazioni non ottimali e compatibilità limitata dei modelli. Lo stack vLLM risolve questi problemi fornendo una piattaforma unificata, intuitiva e ad alte prestazioni.
Design
Questa soluzione estende il framework vLLM, anziché reinventarlo. vLLM-JAX è un motore di gestione degli LLM open source altamente ottimizzato, noto per il suo throughput elevato, ottenuto utilizzando funzionalità chiave come PagedAttention (che gestisce le cache KV come la memoria virtuale per ridurre al minimo la frammentazione) e Continuous Batching (che aggiunge dinamicamente le richieste al batch per migliorare l'utilizzo).
vLLM-JAX si basa su questa base e sviluppa componenti principali per la gestione delle richieste, la pianificazione e la gestione della memoria. Introduce un backend basato su JAX che funge da ponte, traducendo il grafo computazionale e le operazioni di memoria di vLLM in codice eseguibile su TPU. Questo backend gestisce le interazioni con i dispositivi, l'esecuzione del modello JAX e le specifiche della gestione della cache KV sull'hardware TPU. Incorpora ottimizzazioni specifiche per le TPU, come meccanismi di attenzione efficienti (ad esempio, sfruttando i kernel JAX Pallas per l'attenzione con pagine irregolari) e la quantizzazione, tutti personalizzati per l'architettura TPU.
Punti di forza principali
- Zero costi di onboarding/offboarding per gli utenti: gli utenti possono adottare questa soluzione senza problemi significativi. Dal punto di vista dell'esperienza utente, l'elaborazione delle richieste di inferenza sulle TPU dovrebbe essere la stessa delle GPU. L'interfaccia a riga di comando per avviare il server, accettare i prompt e restituire gli output è condivisa.
- Adozione completa dell'ecosistema: questo approccio utilizza e contribuisce all'interfaccia e all'esperienza utente di vLLM, garantendo compatibilità e facilità d'uso.
- Fungibilità tra TPU e GPU: la soluzione funziona in modo efficiente sia su TPU che su GPU, offrendoti flessibilità.
- Economico (miglior rapporto prestazioni/costo): ottimizza le prestazioni per fornire il miglior rapporto prestazioni/costo per i modelli più diffusi.
Pubblicazione JAX: serializzazione Orbax e motore di pubblicazione Neptune
Per i modelli diversi dagli LLM o per gli utenti che desiderano una pipeline completamente nativa di JAX, la libreria di serializzazione Orbax e il sistema Neptune Serving Engine (NSE) forniscono una soluzione di distribuzione end-to-end ad alte prestazioni.
Motivazione
In passato, i modelli JAX spesso si basavano su un percorso tortuoso per la produzione, ad esempio venivano inseriti in grafi TensorFlow e ne veniva eseguito il deployment utilizzando TensorFlow Serving. Questo approccio ha introdotto limitazioni e inefficienze significative, costringendo gli sviluppatori a interagire con un ecosistema separato e rallentando l'iterazione. Un sistema di gestione dedicato nativo di JAX è fondamentale per la sostenibilità, la riduzione della complessità e l'ottimizzazione delle prestazioni.
Design
Questa soluzione è costituita da due componenti principali, come illustrato nel seguente diagramma.
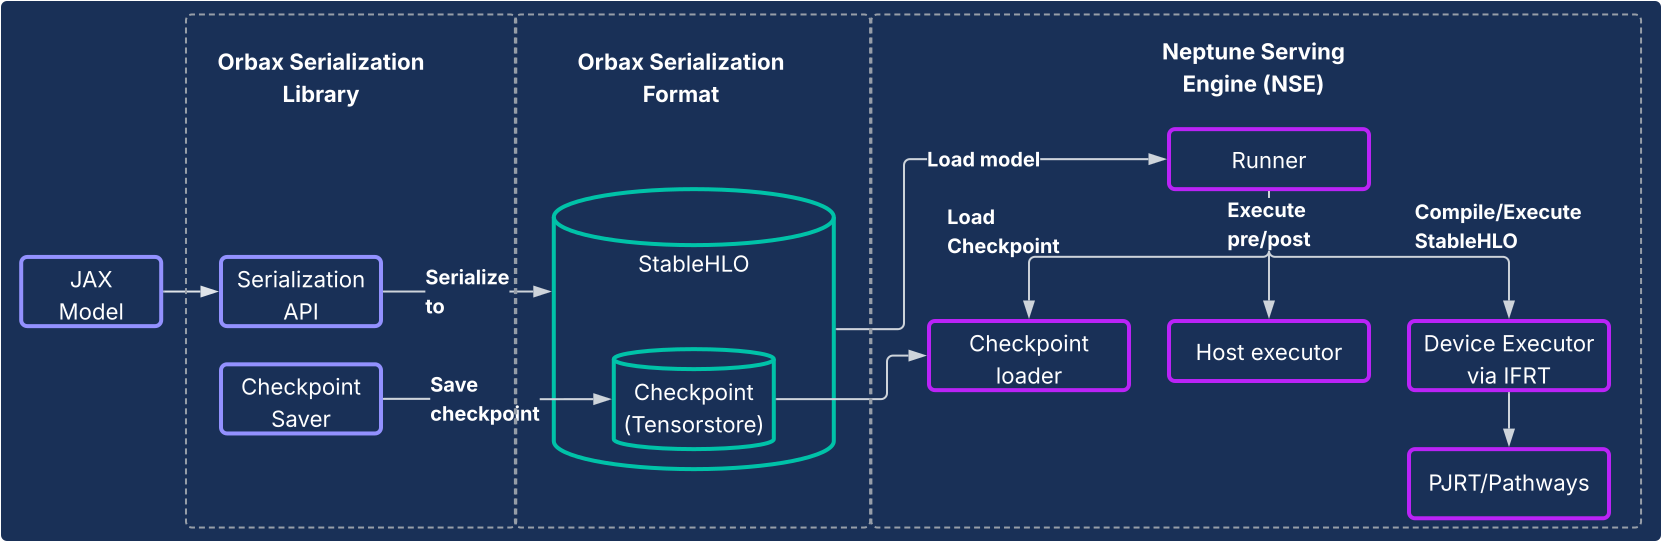
- Libreria di serializzazione Orbax: fornisce API facili da usare per la serializzazione dei modelli JAX in un nuovo e solido formato di serializzazione Orbax. Questo formato è ottimizzato per il deployment in produzione. Rappresenta direttamente i calcoli del modello JAX utilizzando StableHLO, consentendo di rappresentare il grafico di calcolo in modo nativo. Inoltre, utilizza TensorStore per archiviare i pesi, consentendo un caricamento rapido dei checkpoint per l'erogazione.
- Neptune Serving Engine (NSE): si tratta del motore di gestione flessibile e ad alte prestazioni (in genere distribuito come binario C++) progettato per eseguire in modo nativo i modelli JAX nel formato Orbax. NSE offre funzionalità essenziali per la produzione, come il caricamento rapido dei modelli, l'erogazione simultanea ad alta velocità effettiva con batching integrato, il supporto di più versioni dei modelli e l'erogazione su host singolo e multiplo (sfruttando PJRT e Pathways). Utilizza il motore di pubblicazione Neptune per:
- Modelli non LLM: è una soluzione per uso generico ideale per workload come sistemi di suggerimenti, modelli di diffusione e altri modelli di AI.
- LLM di piccole dimensioni e distribuzione "one-shot": è progettato per modelli non autoregressivi o modelli più piccoli che vengono distribuiti in modo "unario", in cui l'intero output viene generato in un unico passaggio senza la necessità di una gestione complessa dello stato come una cache KV.
In breve, Neptune Serving Engine colma il divario per la gestione dell'ampia varietà di modelli che non sono modelli linguistici autoregressivi di grandi dimensioni, fornendo una soluzione nativa per TPU ad alte prestazioni per l'ecosistema ML più ampio.
Punti di forza principali
- Pubblicazione nativa di JAX: la soluzione è creata in modo nativo per JAX, eliminando l'overhead tra framework nella serializzazione e nella pubblicazione dei modelli. In questo modo, il caricamento del modello è rapido e l'esecuzione è ottimizzata su CPU, GPU e TPU.
- Deployment in produzione semplificato: i modelli serializzati forniscono un percorso di deployment ermetico che non è influenzato dalla deviazione delle dipendenze Python e consente controlli di integrità del modello in fase di runtime. In questo modo, il percorso di messa in produzione dei modelli JAX è semplice e intuitivo.
- Esperienza di sviluppo migliorata: eliminando la necessità di un wrapping del framework ingombrante, questa soluzione riduce significativamente le dipendenze e la complessità del sistema, accelerando l'iterazione per gli sviluppatori JAX.
Analisi e profilazione a livello di sistema
XProf: profilazione delle prestazioni approfondita e integrata nell'hardware
XProf è uno strumento di profilazione e analisi delle prestazioni che fornisce una visibilità approfondita su vari aspetti dell'esecuzione dei workload di ML, consentendoti di eseguire il debug e ottimizzare le prestazioni. È profondamente integrato negli ecosistemi JAX e TPU.
Motivazione
Da un lato, i workload ML stanno diventando sempre più complessi. Dall'altro, si assiste a un'esplosione di funzionalità hardware specializzate destinate a questi workload. Abbinare i due in modo efficace per garantire prestazioni ed efficienza massime è fondamentale, dati gli enormi costi dell'infrastruttura ML. Ciò richiede una visibilità approfondita sia del workload sia dell'hardware, presentata in modo da essere rapidamente utilizzabile. XProf è eccellente in questo.
Design
XProf è composto da due componenti principali: raccolta e analisi.
- Raccolta: XProf acquisisce informazioni da varie fonti: annotazioni nel codice JAX, modelli di costo per le operazioni all'interno del compilatore XLA e funzionalità di profilazione hardware create appositamente all'interno della TPU. Questa raccolta può essere attivata in modo programmatico o on demand, generando un artefatto completo dell'evento.
- Analisi: XProf elabora i dati raccolti e crea una suite di potenti visualizzazioni, accessibili con un browser.
Punti di forza principali
Il vero potere di XProf deriva dalla sua profonda integrazione con lo stack completo, che fornisce un'ampiezza e una profondità di analisi che rappresentano un vantaggio tangibile dell'ecosistema JAX/TPU co-progettato.
- Progettato in collaborazione con la TPU: XProf sfrutta le funzionalità hardware progettate specificamente per una raccolta di profili senza interruzioni, consentendo un overhead di raccolta inferiore all'1%. In questo modo, la profilazione diventa una parte leggera e iterativa dello sviluppo.
- Ampiezza e profondità dell'analisi: XProf produce un'analisi approfondita su più assi. I suoi strumenti includono:
- Visualizzatore di tracce: una visualizzazione cronologica delle operazioni di esecuzione su diverse unità hardware (ad esempio TensorCore).
- Profilo operazione HLO: suddivide il tempo totale impiegato in diverse categorie di operazioni.
- Visualizzatore della memoria:mostra i dettagli delle allocazioni della memoria in base alle diverse operazioni durante la finestra profilata.
- Analisi Roofline: ti aiuta a identificare se operazioni specifiche sono limitate dal calcolo o dalla memoria e quanto sono lontane dalle capacità di picco dell'hardware.
- Visualizzatore di grafi: fornisce una visualizzazione del grafo HLO completo eseguito dall'hardware.
Una prospettiva comparativa: lo stack JAX/TPU come scelta convincente
Il panorama moderno del machine learning offre molte toolchain eccellenti e mature. JAX AI Stack offre un insieme unico e convincente di vantaggi per gli sviluppatori che si concentrano sul machine learning su larga scala e ad alte prestazioni, derivanti direttamente dal suo design modulare e dalla profonda co-progettazione dell'hardware.
Sebbene molti framework offrano un'ampia gamma di funzionalità, JAX AI Stack fornisce differenziatori specifici e potenti in aree chiave del ciclo di vita dello sviluppo:
- Un'esperienza di sviluppo più semplice e potente:il paradigma di trasformazione del gradiente concatenabile di Optax consente strategie di ottimizzazione più potenti e flessibili che vengono dichiarate una sola volta, anziché essere gestite in modo imperativo nel loop di addestramento. A livello di sistema, l'interfaccia più semplice con un singolo controller di Pathways elimina la complessità dell'addestramento multislice, una semplificazione significativa per i ricercatori.
- Progettato per una resilienza su larga scala: lo stack JAX è progettato per l'addestramento su larga scala. Orbax offre funzionalità di "resilienza dell'addestramento su larga scala", come il checkpointing di emergenza e multilivello. A questo si aggiunge Grain, che offre un supporto completo per la riproducibilità con shuffle globali deterministici e caricatori di dati con checkpoint. La possibilità di creare un checkpoint atomico dello stato della pipeline di dati (Grain) con lo stato del modello (Orbax) è una funzionalità fondamentale per garantire la riproducibilità nei job a lunga esecuzione.
- Un ecosistema completo ed end-to-end: lo stack fornisce una soluzione end-to-end coesa. Gli sviluppatori possono utilizzare MaxText come riferimento SOTA per l'addestramento, Tunix per l'allineamento e seguire un percorso chiaro e duplice verso la produzione con vLLM-JAX (per la compatibilità con vLLM) e NSE (per le prestazioni di JAX).
Sebbene molti stack siano simili dal punto di vista del software di alto livello, il fattore decisivo è spesso rappresentato da prestazioni/TCO, ed è qui che la progettazione congiunta di JAX e TPU offre un vantaggio evidente. Questo vantaggio in termini di prestazioni/TCO è un risultato diretto dell'integrazione verticale tra software e hardware TPU. La capacità del compilatore XLA di unire le operazioni in modo specifico per l'architettura TPU o per il profiler XProf di utilizzare hook hardware per la profilazione con un overhead inferiore all'1% sono vantaggi tangibili di questa integrazione profonda.
Per le organizzazioni che adottano questo stack, la natura completa dello stack JAX AI riduce al minimo i costi di migrazione. Per i clienti che utilizzano architetture di modelli aperti molto diffuse, il passaggio da altri framework a MaxText è spesso una questione di configurazione dei file di configurazione. Inoltre, la capacità dello stack di importare formati di checkpoint popolari come safetensors consente di eseguire la migrazione dei checkpoint esistenti senza dover eseguire un costoso riaddestramento.
La seguente tabella fornisce una mappatura dei componenti forniti dallo stack JAX AI e dei loro equivalenti in altri framework o librerie.
| Funzione | JAX | Alternative/equivalenti in altri framework5 |
| Compilatore / runtime | XLA | Inductor, eager |
| Addestramento MultiPod | Pathways | Strategie Torch Lightning, Ray Train, Monarch (nuovo). |
| Framework principale | JAX | PyTorch |
| Creazione di modelli | Modelli Flax, Max* | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| Ottimizzatori e perdite | Optax | torch.optim.*, torch.nn.*Loss |
| Caricatori di dati | Grana | Ray Data, caricatori di dati HuggingFace |
| Checkpointing | Orbax | Checkpointing distribuito PyTorch, checkpointing NeMo |
| Quantizzazione | Qwix | TorchAO, bitsandbytes |
| Creazione di kernel e implementazioni note | Pallas / Tokamax | Triton/Helion, Liger-kernel, TransformerEngine |
| Post-addestramento / ottimizzazione | Tunix | VERL, NeMoRL |
| Profilazione | XProf | Profiler PyTorch, sistemi NSight, NSight Compute |
| Addestramento del foundation model | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| Inferenza LLM | vLLM | SGLang |
| Inferenza non LLM | NSE | Triton Inference Server, RayServe |
5 Alcuni degli equivalenti qui riportati non sono sempre confronti reali perché altri framework tracciano i confini delle API in modo diverso rispetto a JAX. L'elenco degli equivalenti non è esaustivo e vengono spesso introdotte nuove librerie.
Conclusioni: una piattaforma durevole e pronta per la produzione per il futuro dell'AI
I dati forniti nella tabella precedente illustrano una conclusione evidente: questi stack hanno i loro punti di forza e di debolezza in un numero limitato di aree, ma nel complesso sono molto simili dal punto di vista del software. Entrambi gli stack forniscono soluzioni pronte all'uso per il pre-addestramento, l'adattamento post-addestramento e il deployment dei modelli di base.
Lo stack JAX AI offre una soluzione convincente e solida per l'addestramento e il deployment di modelli ML su qualsiasi scala. Sfrutta una profonda integrazione verticale tra software e hardware TPU per offrire prestazioni e un costo totale di proprietà leader della categoria.
Basandosi su sistemi interni collaudati, lo stack si è evoluto per fornire affidabilità e scalabilità intrinseche, consentendo agli utenti di sviluppare ed eseguire il deployment anche dei modelli più grandi in tutta sicurezza. Il suo design modulare e componibile, basato sulla filosofia dello stack JAX AI, offre agli utenti una libertà e un controllo senza precedenti, consentendo loro di personalizzare lo stack in base alle proprie esigenze specifiche senza i vincoli di un framework monolitico.
Con XLA e Pathways che forniscono una base scalabile e a tolleranza di errore, JAX che fornisce una libreria numerica performante ed espressiva, potenti librerie di sviluppo di base come Flax, Optax, Grain e Orbax, strumenti di prestazioni avanzati come Pallas, Tokamax e Qwix e un livello di applicazione e produzione solido in MaxText, vLLM e NSE, lo stack JAX AI fornisce una base duratura su cui gli utenti possono costruire e portare rapidamente la ricerca allo stato dell'arte in produzione.