


Architettura TPU
Le Tensor Processing Unit (TPU) sono circuiti integrati specifici per le applicazioni (ASIC) progettati da Google per accelerare i workload di machine learning. Puoi utilizzare le TPU tramite Compute Engine, Google Kubernetes Engine e Vertex AI.
Le TPU sono progettate per eseguire rapidamente operazioni con matrici, il che le rende ideali per i workload di machine learning. Puoi eseguire workload di machine learning sulle TPU utilizzando framework come PyTorch e JAX.
Come funzionano le TPU?
Per capire come funzionano le TPU, è utile comprendere in che modo altri acceleratori affrontano le sfide computazionali dell'addestramento dei modelli di ML.
Come funziona una CPU
Una CPU è un processore per uso generico basato sull'architettura di Von Neumann. Ciò significa che una CPU funziona con software e memoria in questo modo:
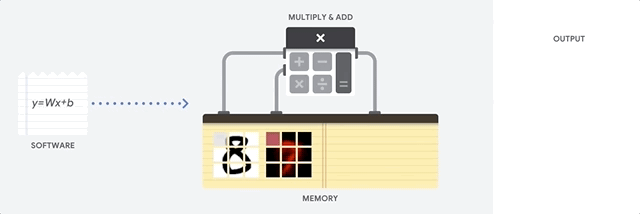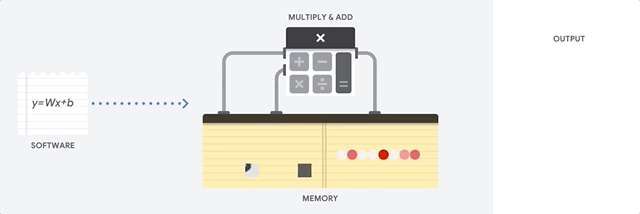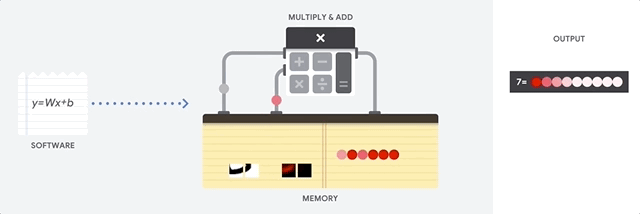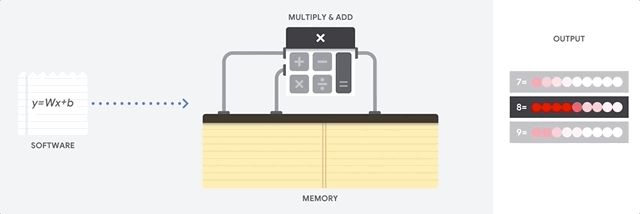
Il vantaggio principale delle CPU è la loro flessibilità. Puoi caricare qualsiasi tipo di software su una CPU per molti tipi diversi di applicazioni. Ad esempio, puoi utilizzare una CPU per l'elaborazione di testi su un PC, il controllo dei motori di un razzo, l'esecuzione di transazioni bancarie o la classificazione di immagini con una rete neurale.
Una CPU carica i valori dalla memoria, esegue un calcolo sui valori e memorizza il risultato nella memoria per ogni calcolo. L'accesso alla memoria è lento rispetto alla velocità di calcolo e può limitare il throughput totale delle CPU. Questo è spesso definito collo di bottiglia di von Neumann.
Come funziona una GPU
Per ottenere un throughput più elevato, le GPU contengono migliaia di unità aritmetico-logiche (ALU) in un unico processore. Una GPU moderna contiene in genere tra 2500 e 5000 ALU. Il gran numero di processori consente di eseguire migliaia di moltiplicazioni e addizioni contemporaneamente.
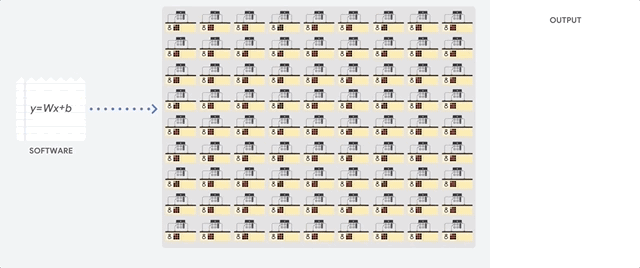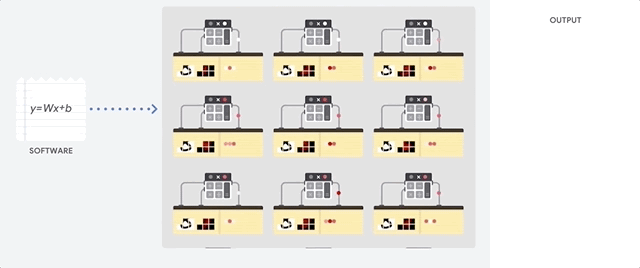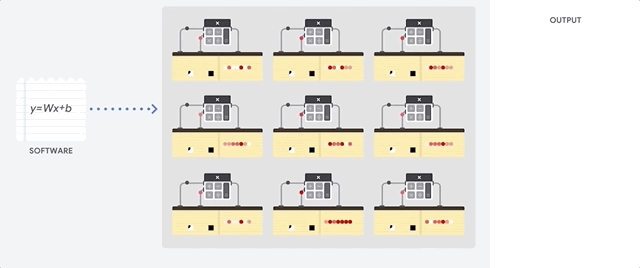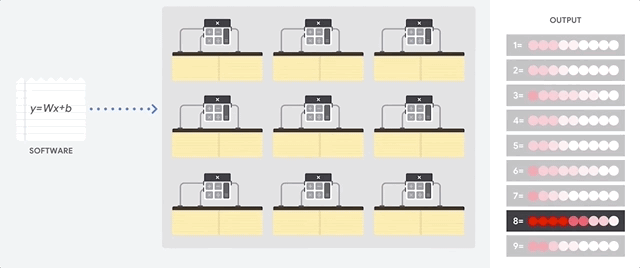
Questa architettura GPU funziona bene su applicazioni con un parallelismo massiccio, come le operazioni con matrici in una rete neurale. In effetti, su un tipico workload di addestramento per il deep learning, una GPU può fornire un throughput di un ordine di grandezza superiore rispetto a una CPU.
Tuttavia, la GPU è comunque un processore per uso generico che deve supportare molte applicazioni e software diversi. Pertanto, le GPU hanno lo stesso problema delle CPU. Per ogni calcolo nelle migliaia di ALU, una GPU deve accedere ai registri o alla memoria condivisa per leggere gli operandi e archiviare i risultati dei calcoli intermedi.
Come funziona una TPU
Google ha progettato le Cloud TPU come processori di matrici specializzati per i workload delle reti neurali. Le TPU non possono eseguire elaboratori di testi, controllare motori a razzo o eseguire transazioni bancarie, ma possono gestire rapidamente le enormi operazioni di matrice utilizzate nelle reti neurali.
L'attività principale delle TPU è l'elaborazione delle matrici, che è una combinazione di operazioni di moltiplicazione e accumulo. Le TPU contengono migliaia di accumulatori di moltiplicazione collegati direttamente tra loro per formare una grande matrice fisica. Questa è chiamata architettura systolic array. Cloud TPU v3, contengono due array sistolici di 128 x 128 ALU su un singolo processore.
L'host TPU trasmette i dati in una coda di inserimento. La TPU carica i dati dalla coda di inserimento e li archivia nella memoria a larghezza di banda elevata (HBM). Al termine del calcolo, la TPU carica i risultati nella coda di outfeed. L'host TPU legge quindi i risultati dalla coda di outfeed e li archivia nella memoria dell'host.
Per eseguire le operazioni sulle matrici, la TPU carica i parametri dalla memoria HBM nell'unità di moltiplicazione matriciale (MXU).
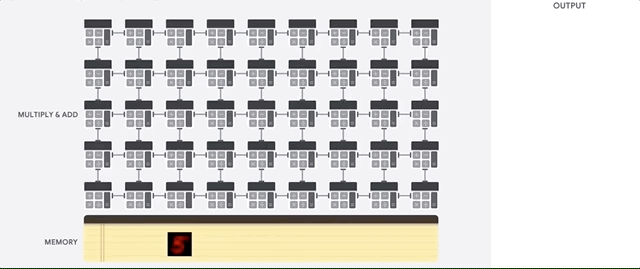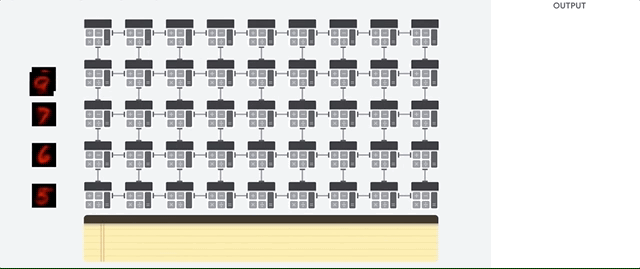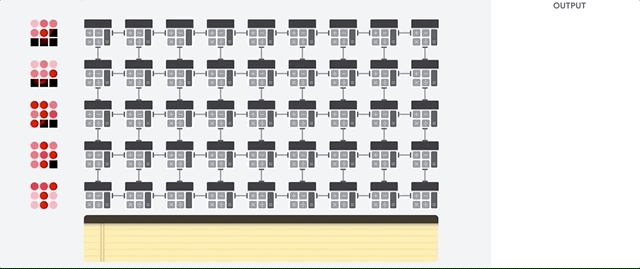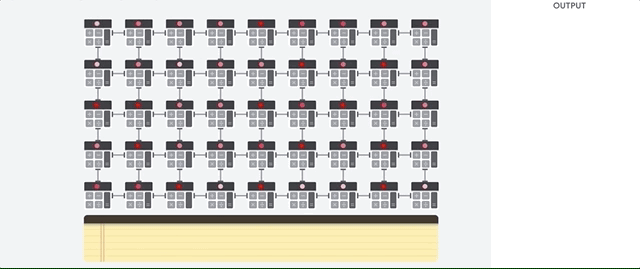
Quindi, la TPU carica i dati dalla memoria HBM. Man mano che viene eseguita ogni moltiplicazione, il risultato viene passato al moltiplicatore-accumulatore successivo. L'output è la somma di tutti i risultati della moltiplicazione tra i dati e i parametri. Durante il processo di moltiplicazione delle matrici non è necessario l'accesso alla memoria.

Di conseguenza, le TPU possono raggiungere un throughput di calcolo elevato sui calcoli delle reti neurali.
Architettura del sistema TPU
Le sezioni seguenti descrivono i concetti chiave di un sistema TPU. Per ulteriori informazioni sui termini comuni del machine learning, consulta il Glossario del machine learning.
Se non hai mai utilizzato Cloud TPU, consulta la home page della documentazione di TPU.
Chip TPU
Un chip TPU contiene uno o più TensorCore. Il numero di TensorCore dipende dalla versione del chip TPU. Ogni TensorCore è composto da una o più unità di moltiplicazione di matrici (MXU), un'unità vettoriale e un'unità scalare. Per saperne di più sui TensorCore, consulta Un supercomputer specifico per il dominio per l'addestramento di reti neurali profonde.
Un'MXU è composta da 256 x 256 (TPU v6e e TPU7x) o 128 x 128 (versioni TPU precedenti alla v6e) moltiplicatori-accumulatori in un array sistolico. Le MXU forniscono la maggior parte della potenza di calcolo in un TensorCore. Ogni MXU 128 x 128 (TPU v5p e versioni precedenti) esegue 16.000 operazioni di moltiplicazione e accumulo per ciclo. Ogni MXU 256 x 256 (TPU v6e e TPU7x) esegue 128.000 operazioni di moltiplicazione-accumulo bfloat16 per ciclo. Tutte le moltiplicazioni accettano input bfloat16, nonché formati di precisione inferiore sulle generazioni supportate (come numeri interi a 8 bit su TPU v5e e v6e e FP8 su TPU v5p e TPU7x), mentre gli accumuli vengono eseguiti nel formato numerico FP32.
L'unità vettoriale viene utilizzata per calcoli generali, come attivazioni e softmax. L'unità scalare viene utilizzata per il flusso di controllo, il calcolo degli indirizzi di memoria e altre operazioni di manutenzione.
pod di TPU
Un pod di TPU è un insieme contiguo di TPU raggruppate su una rete specializzata. Il numero di chip TPU in un pod di TPU dipende dalla versione di TPU.
Sezione
Una sezione è una raccolta di chip che si trovano tutti all'interno dello stesso pod di TPU, collegati da interconnessioni inter-chip (ICI) ad alta velocità. Le sezioni sono descritte in termini di chip o TensorCore, a seconda della versione della TPU.
Topologia
La topologia definisce la disposizione fisica delle TPU all'interno di una sezione TPU. Le sezioni TPU hanno topologie bidimensionali (2D) o tridimensionali (3D), a seconda della versione della TPU. Specifica una topologia come numero di chip TPU in ogni dimensione, come segue:
- Topologie 3D: definisci la topologia come una tupla di 3 elementi (
{A}x{B}x{C}), ad esempio4x4x4. Il prodotto di{A}x{B}x{C}definisce il numero di chip TPU nella sezione. Se utilizzi una topologia con più di 64 chip, i valori che assegni a{A},{B}e{C}devono soddisfare le seguenti condizioni:{A},{B}e{C}devono essere multipli di quattro.- I valori assegnati devono seguire questo pattern:
{A}≤{B}≤{C}. Ad esempio,4x4x8o8x8x8.
- Topologie 2D: definisci la topologia come una tupla di 2 elementi (
{A}x{B}), ad esempio2x4. Il prodotto di{A}x{B}definisce il numero di chip TPU nella sezione.
Una topologia a host singolo si riferisce a una topologia con chip TPU di un singolo host di computing. Ad esempio, per TPU7x, ogni host è connesso a quattro chip. Uno slice 2x2x1 ha quattro chip collegati a un singolo host, quindi 2x2x1 è una topologia a host singolo.
Una topologia multi-host si riferisce a una topologia con chip TPU di più di un host di computing. Ad esempio, per TPU7x, 2x2x2 (otto chip da due host) e
slice più grandi sono topologie multi-host.
Multislice e single slice a confronto
Multislice è un gruppo di slice che estende la connettività TPU oltre le connessioni inter-chip interconnect (ICI) e sfrutta la rete di data center (DCN) per trasmettere dati oltre uno slice. I dati all'interno di ogni sezione vengono comunque trasmessi tramite ICI. Utilizzando questa connettività ibrida, Multislice consente il parallelismo tra gli slice e ti permette di utilizzare un numero maggiore di core TPU per un singolo job rispetto a quello che può contenere un singolo slice.
Le TPU possono essere utilizzate per eseguire un job su una o più sezioni. Per ulteriori dettagli, consulta l'introduzione a Multislice.
Cubo TPU
Una topologia 4x4x4 di 64 chip TPU interconnessi. Questo vale solo per le topologie 3D (a partire da TPU v4). All'interno di un cubo, i chip TPU adiacenti sono collegati tramite collegamenti inter-chip interconnect (ICI) in rame ad alta velocità. Per formare sezioni multi-cubo in un pod di TPU (per TPU v4, v5p e TPU7x), i link di confine di ogni cubo 4x4x4 sono connessi tramite link ottici e switch di circuiti ottici (OCS) riconfigurabili in una topologia di toro 3D o toro 3D intrecciato.
SparseCore
Gli SparseCore sono processori di flussi di dati che accelerano i modelli utilizzando operazioni sparse. Un caso d'uso principale è l'accelerazione dei modelli di suggerimenti, che si basano molto sugli embedding. v5p e TPU7x hanno quattro SparseCore per chip, mentre v6e ne ha due per chip. Per una spiegazione approfondita di come utilizzare gli SparseCore, consulta Approfondimento su SparseCore per i modelli di embedding di grandi dimensioni (LEM). Puoi controllare il modo in cui il compilatore XLA utilizza gli SparseCore utilizzando i flag XLA. Per ulteriori informazioni, consulta i flag XLA TPU.
Resilienza ICI di Cloud TPU
La resilienza ICI contribuisce a migliorare la tolleranza ai guasti dei collegamenti ottici e degli switch di circuiti ottici (OCS) che collegano le TPU tra i cubi. (Le connessioni ICI all'interno di un cubo utilizzano collegamenti in rame che non sono interessati). La resilienza ICI consente di instradare le connessioni ICI intorno agli errori OCS e ICI ottici. Di conseguenza, migliora la disponibilità della pianificazione delle sezioni TPU, con il compromesso di un peggioramento temporaneo delle prestazioni ICI.
Per Cloud TPU v4, v5p e TPU7x, la resilienza ICI è abilitata per impostazione predefinita per le sezioni di un cubo o più grandi, ad esempio:
- v5p-128 quando specifichi il tipo di acceleratore
- 4x4x4 quando specifichi la configurazione dell'acceleratore
Versioni TPU
L'architettura esatta di un chip TPU dipende dalla versione della TPU che utilizzi. Ogni versione di TPU supporta anche dimensioni e configurazioni di sezioni diverse. Per maggiori informazioni sull'architettura di sistema e sulle configurazioni supportate, consulta le seguenti pagine:
Architettura cloud TPU
Google Cloud rende disponibili le TPU come risorse di computing tramite le VM TPU. Puoi utilizzare le TPU per i tuoi workload tramite Compute Engine, Google Kubernetes Engine e Vertex AI. Le sezioni seguenti descrivono i componenti chiave dell'architettura cloud TPU.
Architettura VM TPU
L'architettura VM TPU ti consente di connetterti direttamente alla VM collegata fisicamente al dispositivo TPU tramite SSH. Una VM TPU, nota anche come worker, è una macchina virtuale che esegue Linux e ha accesso alle TPU sottostanti. Hai accesso root alla VM, quindi puoi eseguire codice arbitrario. Puoi accedere ai log di debug e ai messaggi di errore del compilatore e del runtime.

Host singolo, multi-host e sub-host
Un host TPU è una VM eseguita su un computer fisico connesso all'hardware TPU. I workload TPU possono utilizzare uno o più host.
Un workload a host singolo è limitato a una singola VM TPU. Un workload multi-host distribuisce l'addestramento su più VM TPU. Un workload sub-host non utilizza tutti i chip di una VM TPU.
Visualizzatore della topologia TPU
Il visualizzatore della topologia TPU è uno strumento che ti consente di visualizzare il layout fisico delle TPU e della relativa infrastruttura di networking associata all'interno di un data center fisico. Utilizza lo strumento per comprendere il layout dell'infrastruttura fisica per diverse generazioni e topologie di TPU.