


PyTorch sur Cloud TPU
PyTorch sur Cloud TPU vous permet d'entraîner, d'ajuster et de diffuser des modèles Open Source sur du matériel Cloud TPU à l'aide de la sémantique PyTorch standard, d'API distribuées et des outils de l'écosystème que vous utilisez déjà, y compris Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec et Ray.
À la base de la pile se trouve TorchTPU, un backend Open Source natif de PyTorch, développé conjointement avec l'équipe PyTorch de Meta. TorchTPU fournit des bibliothèques, des frameworks et des outils pour chaque étape du cycle de vie du machine learning, de l'exécution de l'environnement d'exécution de base et des kernels personnalisés à l'inférence en production, à l'entraînement à grande échelle et à l'orchestration de clusters.
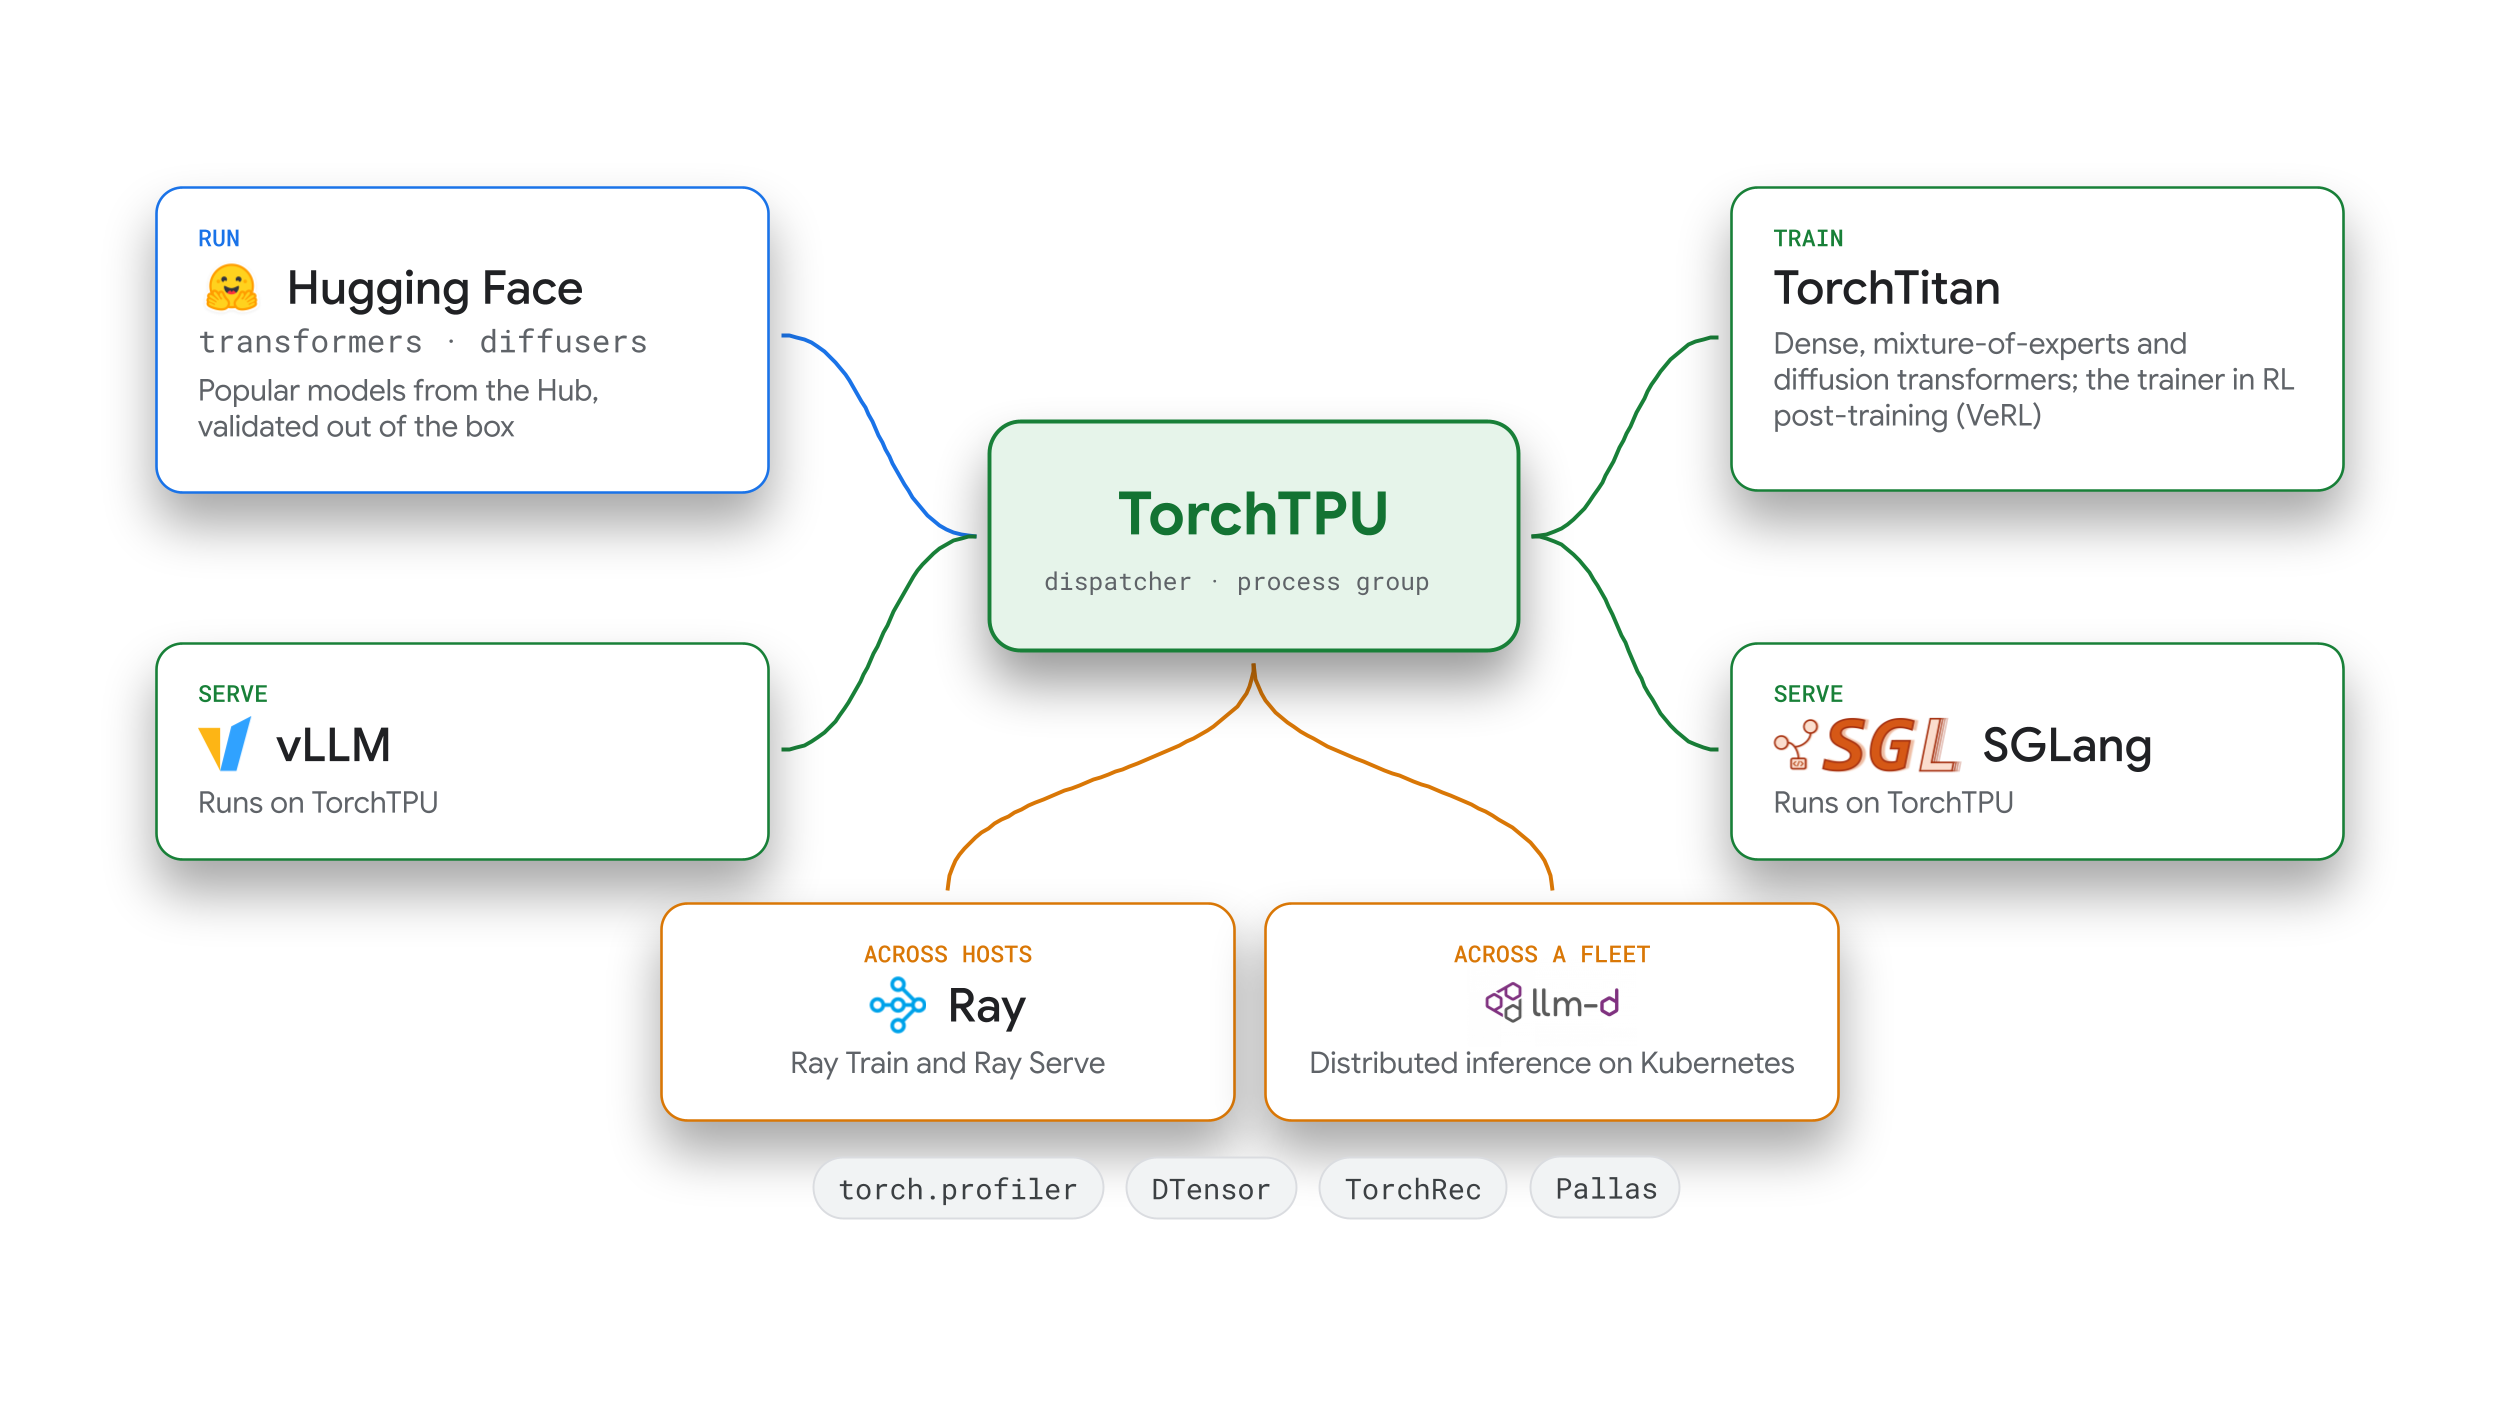
Commencer
- Exécuter des modèles PyTorch sur des TPU : commencez par TorchTPU et la documentation TorchTPU.
- Mettre en service des LLM et des modèles multimodaux : utilisez vLLM-TorchTPU ou SGLang-TorchTPU.
- Router les requêtes sur un parc Kubernetes : utilisez llm-d.
- Pré-entraîner ou affiner des modèles de fondation : utilisez TorchTitan sur TPU (ou TorchRec pour les modèles de recommandation).
- Mettre à l'échelle les pipelines de traitement des données, d'entraînement, de RL et de diffusion : utilisez Ray.
- Intégrez, profilez et ajustez des modèles avec votre assistant de codage : utilisez la suite d'agents TPU (preview).
TorchTPU : backend natif PyTorch pour Cloud TPU
TorchTPU fournit le backend de l'appareil, l'intégration du compilateur de graphes et les API de kernel personnalisées pour PyTorch sur Cloud TPU. Développé avec l'équipe PyTorch, TorchTPU vous permet de déboguer des modèles de manière interactive en mode hâtif, de compiler le code du modèle avec torch.compile et d'effectuer un scaling sur plusieurs tranches avec torch.distributed (tpu_dist).
Pour installer TorchTPU et exécuter une opération de tenseur sur un Cloud TPU :
pip install torch_tpu
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
Motivation
Bien que les Cloud TPU aient toujours été associés à JAX et TensorFlow, l'exécution de PyTorch sur les TPU nécessitait auparavant l'enregistrement de graphes de tenseurs paresseux (PyTorch/XLA), ce qui impliquait souvent d'ajouter du code pour marquer les régions compilables. TorchTPU exécute les opérations de manière hâtive par défaut à l'aide du modèle d'exécution standard de PyTorch (un processus par appareil). Les charges de travail et les bibliothèques existantes s'exécutent donc sans réécriture structurelle.
Conception
TorchTPU apporte à PyTorch une compatibilité native avec les TPU, selon trois objectifs de conception :
- Sémantique PyTorch standard : exécute un processus par appareil et préserve les vues de tenseur PyTorch et les mutations sur place sans dépendance d'exécution JAX.
- Exécution hâtive par défaut : les modèles PyTorch standards s'exécutent immédiatement en mode hâtif pour le débogage interactif et l'inspection étape par étape.
- Optimisations du compilateur et du noyau : en plus de l'exécution eager opérateur par opérateur, TorchTPU fournit la fusion d'opérateurs en mode eager, l'intégration de
torch.compileavec des limites de forme dynamiques pour réduire les recompilations, et des API de noyau personnalisées.
Pour la compilation de graphes, torch.compile capture le graphe de calcul PyTorch avec TorchDynamo et le compile en code machine TPU via OpenXLA et StableHLO. Les opérations collectives s'exécutent au niveau du groupe de processus torch.distributed (tpu_dist).
Principaux points forts
- Compatibilité avec les opérateurs, les modèles et Hugging Face : TorchTPU est compatible avec les opérateurs PyTorch (ATen) standards dans les passes avant et arrière, et est testé en continu avec les modèles Hugging Face populaires. Vous pouvez déployer des modèles dans Transformers v5 en transmettant
device_map="tpu", exécuter des pipelines Diffusers avec le mode hâtif,torch.compileet le parallélisme des tenseurs, et profiler les charges de travail avectorch.profilerdans TensorBoard et XProf. - Scaling d'une seule puce à plusieurs tranches : le backend
tpu_distest compatible avecDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2) etDTensor. De plus,torch.tpu.distributed.topology_aware_meshmappe les dimensions de parallélisme sur les interconnexions TPU physiques. - Modes d'exécution eager configurables : fournit trois modes d'exécution eager :
Strict(par défaut) : distribue les opérateurs individuellement et de manière asynchrone, avec une sémantique PyTorch impérative standard.Debug: s'exécute de manière synchrone avec la vérification des limites des Tensors.DeferAndFuse: fusionne les séquences d'opérateurs hâtifs pour réduire le trafic de la mémoire à haut débit (HBM).
- Compilation et mise en cache de graphes complets :
torch.compile(backend="tpu")compile les graphes en exécutables TPU et les met en cache entre les processus, les hôtes et les redémarrages de jobs. - Noyaux TPU personnalisés : vous pouvez appeler des noyaux Pallas personnalisés, y compris des noyaux qui communiquent directement entre les puces, en tant que fonctions PyTorch standards, utiliser des noyaux prédéfinis de la bibliothèque Tokamax ou créer des noyaux portables basés sur des tuiles avec Helion.
Pour en savoir plus, consultez la documentation TorchTPU, posez des questions sur le forum de discussion PyTorch sur TPU ou signalez des problèmes sur GitHub.
Inférence et diffusion en production
Pour le déploiement en production, PyTorch sur Cloud TPU s'intègre aux moteurs d'inférence Open Source et à l'infrastructure de diffusion distribuée native de Kubernetes.
vLLM-TorchTPU et SGLang-TorchTPU : moteurs d'inférence
vLLM-TorchTPU et SGLang-TorchTPU sont des backends TorchTPU pour les moteurs d'inférence vLLM et SGLang. Les deux backends exécutent des modèles ouverts tels que Qwen, DeepSeek, GLM, Kimi, GPT-OSS et Gemma 4. Pour en savoir plus, consultez l'article de blog Annonce des nouveaux moteurs d'inférence vLLM et SGLang sur TPU.
Motivation
La diffusion de charges de travail de raisonnement, multimodales et utilisant des outils nécessite souvent des définitions de modèles personnalisées, des méthodes de décodage spéculatif et des schémas de quantification. La création des backends vLLM et SGLang sur TorchTPU vous permet de personnaliser et de déboguer votre pile de diffusion directement dans PyTorch.
Conception
Les deux backends conservent les planificateurs vLLM et SGLang standards, les gestionnaires de cache KV et les serveurs d'API, tout en utilisant l'exécution TorchTPU et les opérateurs Pallas personnalisés sous-jacents. La plupart des modèles exécutent leurs définitions de modèle PyTorch standards, tandis que les blocs nécessitant beaucoup de ressources de calcul appellent des kernels Pallas dans le graphe compilé afin que les kernels spécifiques au matériel puissent être mis à jour indépendamment.
Principaux points forts
- Parallélisme, quantification et décodage spéculatif : compatible avec le parallélisme des tenseurs, des données, des experts, des pipelines et du contexte entre les hôtes, ainsi qu'avec les entrées multimodales (images et vidéos) et d'embedding. Les méthodes de décodage spéculatif compatibles incluent la prédiction multitoken (MTP), EAGLE-3, DFlash, DSpark et la correspondance n-gramme. Les formats de quantification compatibles incluent les caches KV 8 bits (
FP8) et les points de contrôle de modèle à virgule flottante 8 bits (FP8) et 4 bits (MXFP4etNVFP4). - Mise en cache des préfixes à deux niveaux, appel d'outils et sortie structurée : la mise en cache automatique des préfixes (y compris pour l'attention hybride et les modèles récurrents) conserve les préfixes actifs dans la mémoire HBM et décharge les préfixes plus anciens dans la mémoire hôte pour éviter de recalculer les requêtes multitours. L'appel d'outils et la sortie structurée sont intégrés.
- Transferts de cache KV superposés avec TPU Sync : permet de dissocier le préremplissage et le décodage (en séparant le traitement des requêtes et la génération de jetons sur des pools de nœuds de calcul distincts) entre les hôtes et le déchargement KV de l'hôte à l'aide de TPU Sync. TPU Sync est une bibliothèque C++ Open Source qui lit les tampons d'appareil PyTorch directement sur les threads d'arrière-plan sans copier les données via la mémoire du processeur hôte.
Pour en savoir plus sur vLLM-TorchTPU, consultez le dépôt vLLM-TorchTPU, posez des questions sur le canal Slack vLLM ou signalez des problèmes liés à vLLM-TorchTPU sur GitHub.
Pour en savoir plus sur SGLang-TorchTPU, consultez le dépôt SGLang-TorchTPU ou signalez les problèmes liés à SGLang-TorchTPU sur GitHub.
llm-d : inférence distribuée native Kubernetes
llm-d est un framework de bac à sable Open Source de la Cloud Native Computing Foundation (CNCF) pour l'inférence LLM distribuée sur Kubernetes, développé avec Red Hat, IBM, Google Cloudet une communauté de plus de 500 contributeurs et 35 organisations.
Motivation
Alors que les moteurs d'inférence à instance unique gèrent l'exécution par instance répliquée, les parcs de production doivent gérer les pics de trafic, les priorités mutualisées, le partage de contexte à l'échelle du parc et les déploiements sans temps d'arrêt. llm-d fournit la couche de routage et d'opérations au niveau du cluster pour coordonner un parc de serveurs d'inférence.
Conception
llm-d s'exécute devant les serveurs de modèles tels que vLLM et SGLang sur Kubernetes. llm-d fournit les éléments suivants :
- Achemine les requêtes en fonction de l'état du cache de préfixe et de la charge de l'instance répliquée.
- Coordonne les pools de nœuds de calcul de préremplissage et de décodage désagrégés.
- Compatible avec le partitionnement MoE et l'inférence par lot asynchrone.
- Gère le déchargement du cache KV par niveaux entre la mémoire de l'appareil, la mémoire de l'hôte et le stockage.
Principaux points forts
- Routage de session multitour : achemine les conversations multitours vers les instances répliquées qui contiennent leur contexte mis en cache. La planification par priorité de tour et la compatibilité avec l'API Stateful Responses permettent aux agents de réutiliser le contexte d'un tour à l'autre pour réduire les recalculs.
- Qualité de service mutualisée : le contrôle de flux de priorité et d'équité permet aux requêtes sensibles à la latence et aux charges de travail d'agent en rafale de partager un parc sans manque de ressources.
- Opérations de parc et mises à jour progressives : fournit une API de configuration v1, une haute disponibilité du routeur et des mises à jour progressives coordonnées qui gèrent les instances répliquées de préremplissage et de décodage en tant qu'unité logique unique.
- Mise en service TorchTPU native sur GKE : vous pouvez mettre en service des Cloud TPU avec d'autres accélérateurs derrière un point de terminaison llm-d et gérer les instances répliquées vLLM-TorchTPU et SGLang-TorchTPU avec les outils Kubernetes standards.
Pour en savoir plus, posez vos questions sur le canal Slack llm-d ou signalez des problèmes sur GitHub.
Bibliothèques d'entraînement, d'affinage et de domaine
Pour pré-entraîner, affiner et adapter des modèles volumineux, TorchTPU fournit des recettes d'entraînement de référence et des bibliothèques spécifiques au domaine, réglées pour le matériel TPU.
TorchTitan sur TPU : référence d'entraînement à grande échelle
TorchTitan sur TPU étend TorchTitan, la plate-forme de référence modulaire PyTorch pour l'entraînement de l'IA générative, avec des passes de segmentation TPU, des kernels personnalisés et des recettes d'entraînement. Pour en savoir plus, lisez l'article de blog Integrating TorchTPU into TorchTitan and Optimizing Models for TPU.
Motivation
Pour effectuer un scaling de l'entraînement sur des tranches de TPU multi-hôtes, vous devez segmenter les paramètres sur l'interconnexion des puces et chevaucher la communication avec le calcul. Google et Meta ont co-développé des passes de compilation et de segmentation TPU dans TorchTitan. Vous n'avez donc pas besoin de concevoir des stratégies de segmentation TPU personnalisées ni de planifier manuellement la communication.
Conception
Les modèles sont écrits en PyTorch pour un seul appareil, sans code spécifique à l'accélérateur. TorchTitan configure les couches de modèle à partir de fichiers de configuration, ce qui vous permet de remplacer des couches individuelles par des kernels Pallas personnalisés (comme Splash Attention) sans modifier la définition du modèle ni la boucle d'entraînement.
L'implémentation SimpleFSDP de TorchTitan place les opérations de segmentation des paramètres directement dans le graphe compilé afin que le compilateur XLA puisse chevaucher la communication de l'appareil avec le calcul, tandis que la compilation du graphe en une seule étape capture l'intégralité de l'étape d'entraînement en tant que programme XLA unique. Pour les exécutions Multitranche, la segmentation hybride (HSDP) segmente chaque tranche sur l'interconnexion entre puces (ICI) et réplique les tranches sur le réseau du centre de données (DCN). Cette disposition limite le trafic entre les tranches à une seule réduction de gradient par étape.
Principaux points forts
- Recettes de pré-entraînement et de post-entraînement par RL : inclut des recettes de référence pour les LLM denses (Llama 3, Qwen 3 et MuseGlimmer 30B), les modèles Mixture of Experts (MoE) (Qwen 3 235B, validé sur jusqu'à 8 192 puces TPU7x) et les transformateurs de diffusion (FLUX.1). Pour le post-entraînement par RL (comme l'optimisation de stratégie relative de groupe, ou GRPO), VeRL (preview) délègue les mises à jour des paramètres à TorchTitan et transmet les pondérations mises à jour aux moteurs de diffusion pour générer des trajectoires d'entraînement (déploiements).
- Paramètres de compilateur et de parallélisme préconfigurés : les configurations de recette incluent des paramètres de compilateur et de parallélisme préconfigurés afin que vous puissiez régler l'utilisation des FLOP du modèle (MFU) via des fichiers de configuration plutôt que des modifications de code.
- Intégration de nouvelles architectures : le backend de modélisation Hugging Face Transformers exécute les points de contrôle du modèle Hugging Face Hub (y compris les modèles MoE sans parallélisme d'experts) via l'outil d'entraînement TorchTitan. Pour les ports de modèle complets, TorchTitan inclut une compétence d'intégration par étapes pour les ingénieurs et les agents de codage.
- Réutilisation de composants autonomes : vous pouvez adopter TorchTitan de bout en bout ou importer des modules individuels, des opérateurs personnalisés et des options de compilateur dans un codebase d'entraînement existant.
Pour en savoir plus, consultez le guide de démarrage de TorchTitan sur TPU, posez des questions sur le forum de discussion PyTorch ou signalez des problèmes sur GitHub.
TorchRec : systèmes de recommandation
TorchRec est une bibliothèque de domaine PyTorch qui fournit des tables d'embeddings distribuées et des primitives de segmentation pour les modèles de recommandation. Sur Cloud TPU, TorchRec décharge les recherches de tables d'embeddings creux vers des processeurs TPU SparseCore dédiés tout en exécutant des opérations de matrice dense sur les TPU TensorCore.
Pour en savoir plus sur TorchRec, consultez la documentation TorchRec, posez des questions sur le forum de discussion PyTorch sur TPU ou signalez des problèmes sur GitHub.
Orchestration de clusters et outils pour les développeurs
Pour faire évoluer les pipelines multinœuds et automatiser l'intégration des modèles, l'écosystème TorchTPU s'intègre à Ray et fournit des extensions d'agent de codage avec accès à la documentation sur les TPU.
Ray : entraînement distribué, mise en service et RL
Ray effectue le scaling des charges de travail Python et IA sur des clusters à l'aide de Ray Train, Ray Serve, Ray Data, Ray Core et de frameworks RL tels que verl.
Motivation
L'entraînement Multislice et les pipelines multi-étapes (comme les workflows RL qui combinent le prétraitement des données, l'entraînement et la génération de déploiements) nécessitent le provisionnement automatisé des tranches, la découverte de la topologie et la coordination des nœuds de calcul tolérante aux pannes. Les utilitaires de lancement autonomes tels que torchrun ne provisionnent pas de tranches de TPU ni ne coordonnent les pipelines d'acteurs multi-étapes. Ray gère donc la planification et l'emplacement à l'échelle du cluster pour les charges de travail TorchTPU.
Conception
Lorsque vous envoyez un job en spécifiant la génération de TPU, la topologie et le nombre de nœuds de calcul, Ray réserve des tranches de TPU complètes afin que tous les nœuds de calcul d'une tranche soient planifiés ensemble, découvre les adresses d'interconnexion des puces et démarre un nœud de calcul PyTorch par appareil TPU. Le backend PyTorch de Ray Train initialise automatiquement l'appareil tpu et le groupe de processus tpu_dist avant de démarrer le job.
Principaux points forts
- Emplacement correspondant à la topologie : fait correspondre l'emplacement des nœuds de calcul sur les hôtes à la génération de TPU physique et à la disposition des tranches.
- Récupération automatique après défaillance : exécute des jobs d'entraînement distribués sur plusieurs tranches de TPU sur GKE avec une récupération automatique en cas de défaillance d'un nœud de calcul ou d'une tranche.
- Prérécupération des données directement vers le TPU : la méthode
iter_torch_batchesde Ray Data prérécupère les lots en tant que tenseurs PyTorch directement dans la mémoire de l'appareil TPU. - Orchestration de l'inférence multihôte : gère les déploiements de diffusion multihôte pour vLLM-TorchTPU et SGLang-TorchTPU.
TPU agent suite : (preview) agents de codage pour TPU
La suite d'agents TPU est une extension Open Source pour les assistants de codage, y compris Claude Code et Google Antigravity, avec d'autres agents de codage à venir, axée sur l'inférence de transformateurs (LLM denses et modèles MoE) sur TPU v6e et TPU7x.
Motivation
Les assistants de codage généralistes manquent souvent de contexte à jour sur les topologies matérielles des TPU, les options du compilateur XLA, la télémétrie XProf et les contraintes du kernel Pallas. La suite d'agents TPU permet à votre assistant d'accéder à la documentation officielle sur les TPU et à des workflows structurés. Cela permet d'éviter les suggestions d'indicateurs non valides et d'automatiser le profilage et l'analyse comparative itératifs.
Conception
La suite ajoute une base de connaissances TPU et six sous-agents spécifiques à des tâches à votre assistant de codage existant. Un agent de routage délègue chaque requête au sous-agent approprié sans exécuter de commandes lui-même. Toute exécution de commande sur votre VM TPU ou votre cluster GKE nécessite votre approbation, et les boucles de réglage exécutent un nombre limité de tentatives enregistrées avant de renvoyer des résultats.
Principaux points forts
- Intégration du modèle et vérification de la justesse : l'agent d'intégration de modèle TPU résout les opérateurs non compatibles, sélectionne un chemin de diffusion (vLLM-TorchTPU ou PyTorch standard) et compare les sorties couche par couche au modèle de référence du processeur pour vérifier la justesse numérique.
- Diagnostic des plantages et des goulots d'étranglement : l'agent de diagnostic TPU analyse les journaux de plantage, inspecte les profils XProf et les traces du compilateur XLA, et isole les goulots d'étranglement de l'environnement d'exécution.
- Optimisation du noyau, du compilateur et de la segmentation : l'agent de développement de noyau TPU aide à créer des noyaux Pallas personnalisés, l'agent d'optimisation des performances TPU évalue les combinaisons d'options du compilateur XLA, et l'agent de segmentation TPU planifie les configurations de parallélisme multitranche.
- Recherche de documentation avec citations : l'agent de la base de connaissances TPU répond aux questions techniques en citant explicitement la documentation et les tutoriels TPU officiels, et indique quand un sujet n'est pas couvert.
Pour en savoir plus, consultez la documentation de la suite d'agents TPU, partagez vos commentaires et posez des questions dans les discussions GitHub, ou signalez des problèmes sur GitHub.
Étapes suivantes
- Consultez la documentation TorchTPU.
- Essayez les recettes TorchTitan sur TPU.
- Déployez des charges de travail d'inférence avec vLLM-TorchTPU et SGLang-TorchTPU.
- Posez vos questions sur le forum de discussion PyTorch sur TPU.
- Pour discuter d'un cas d'utilisation spécifique avec l'équipe produit et ingénierie de Google, envoyez un e-mail à l'adresse torchtpu-feedback@google.com.