


לקוח
Spanner תומך בשאילתות SQL. הנה דוגמה לשאילתה:
SELECT s.SingerId, s.FirstName, s.LastName, s.SingerInfo
FROM Singers AS s
WHERE s.FirstName = @firstName;
המחרוזת @firstName היא הפניה לפרמטר של שאילתה. אפשר להשתמש בפרמטר של שאילתה בכל מקום שאפשר להשתמש בו בערך ליטרלי. מומלץ מאוד להשתמש בפרמטרים בממשקי API פרוגרמטיים. השימוש בפרמטרים של שאילתות עוזר להימנע ממתקפות של הזרקת SQL, ויש סיכוי גבוה יותר שהשאילתות שמתקבלות ייהנו ממטמונים שונים בצד השרת. מידע נוסף זמין במאמר בנושא שמירה במטמון.
כשמריצים את השאילתה, צריך לקשר את הפרמטרים של השאילתה לערך. לדוגמה:
Statement statement =
    Statement.newBuilder("SELECT s.SingerId...").bind("firstName").to("Jimi").build();
try (ResultSet resultSet = dbClient.singleUse().executeQuery(statement)) {
 while (resultSet.next()) {
 ...
 }
}
כש-Spanner מקבל קריאה ל-API, הוא מנתח את השאילתה ואת הפרמטרים הקשורים כדי לקבוע איזה צומת שרת של Spanner צריך לעבד את השאילתה. השרת שולח חזרה זרם של שורות תוצאות שנקראות על ידי הקריאות ל-ResultSet.next().
ביצוע שאילתה
ביצוע השאילתה מתחיל עם קבלת בקשה לביצוע שאילתה בשרת Spanner. השרת מבצע את הפעולות הבאות:
- אימות הבקשה
- ניתוח הטקסט של השאילתה
- יצירת אלגברה ראשונית של שאילתות
- יצירת אלגברה אופטימלית של שאילתות
- יצירת תוכנית שאילתה שניתן להפעיל
- ביצוע התוכנית (בדיקת הרשאות, קריאת נתונים, קידוד תוצאות וכו')
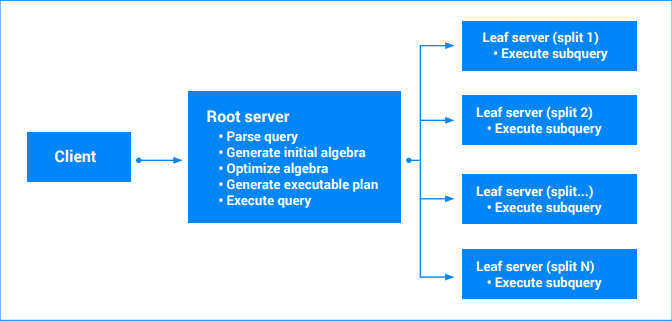
ניתוח
כלי הניתוח של SQL מנתח את טקסט השאילתה וממיר אותו לעץ תחביר מופשט. היא מחלצת את מבנה השאילתה הבסיסי (SELECT …
FROM … WHERE …) ומבצעת בדיקות תחביריות.
אלגברה
מערכת הטיפוסים של Spanner יכולה לייצג סקלרים, מערכים, מבנים וכו'. אלגברת השאילתות מגדירה אופרטורים לסריקות טבלאות, סינון, מיון/קיבוץ, כל מיני הצטרפויות, צבירה ועוד. אלגברת השאילתות הראשונית נבנית מהפלט של מנתח התחביר. הפניות לשמות של שדות בעץ הניתוח נפתרות באמצעות סכימת מסד הנתונים. הקוד הזה בודק גם שגיאות סמנטיות (למשל, מספר שגוי של פרמטרים, אי התאמות של סוגים וכו').
בשלב הבא ('אופטימיזציה של שאילתות') נלקחת האלגברה הראשונית ונוצרת אלגברה אופטימלית יותר. יכול להיות שהשיטה הזו פשוטה יותר, יעילה יותר או פשוט מתאימה יותר ליכולות של מנוע ההפעלה. לדוגמה, אלגברה ראשונית עשויה לציין רק 'join', בעוד שאלגברה שעברה אופטימיזציה מציינת 'hash join'.
ביצוע
תוכנית השאילתה הסופית שניתנת להרצה נבנית מהאלגברה שנכתבה מחדש. בעצם, תוכנית ההפעלה היא גרף אציקלי מכוון של 'איטרטורים'. כל איטרטור חושף רצף של ערכים. איטרטורים יכולים לצרוך קלט כדי להפיק פלט (לדוגמה, איטרטור מיון). שאילתות שכוללות פיצול יחיד יכולות להתבצע על ידי שרת יחיד (השרת שמכיל את הנתונים). השרת יסרוק טווחים מטבלאות שונות, יבצע צירופים, יבצע צבירה וכל פעולה אחרת שמוגדרת על ידי אלגברת השאילתות.
שאילתות שכוללות כמה פיצולים יחולקו לכמה חלקים. חלק מהשאילתה ימשיך לפעול בשרת הראשי (root). שאילתות משנה חלקיות אחרות מועברות לצמתי עלים (אלה שבבעלותם הפיצולים שנקראים). העברת הטיפול הזו יכולה לחזור על עצמה באופן רקורסיבי בשאילתות מורכבות, וכתוצאה מכך נוצר עץ של ביצועים בשרת. כל השרתים מסכימים על חותמת זמן כדי שתוצאות השאילתה יהיו תמונת מצב עקבית של הנתונים. כל שרת עלים שולח בחזרה זרם של תוצאות חלקיות. בשאילתות שכוללות צבירה, התוצאות יכולות להיות תוצאות צבירה חלקיות. שרת הבסיס של השאילתה מעבד את התוצאות משרתי העלים ומריץ את שאר תוכנית השאילתה. מידע נוסף זמין במאמר בנושא תוכניות להרצת שאילתות.
כששאילתה כוללת כמה פיצולים, Spanner יכול להריץ את השאילתה במקביל על פני הפיצולים. רמת ההרצה המקבילית תלויה בטווח הנתונים שהשאילתה סורקת, בתוכנית הביצוע של השאילתה ובפיזור הנתונים בין הפיצולים. Spanner מגדיר באופן אוטומטי את רמת המקביליות המקסימלית לשאילתה על סמך גודל המופע והגדרת המופע (אזורי או רב-אזורי) כדי להשיג ביצועים אופטימליים של השאילתה ולמנוע עומס יתר על המעבד.
שמירה במטמון
רבים מהארטיפקטים של עיבוד השאילתות נשמרים במטמון באופן אוטומטי ונעשה בהם שימוש חוזר בשאילתות הבאות. הנתונים האלה כוללים אלגבראות של שאילתות, תוכניות שאילתות שניתנות להרצה וכו'. השמירה במטמון מבוססת על טקסט השאילתה, השמות והסוגים של פרמטרים מאוגדים. לכן, עדיף להשתמש בפרמטרים מאוגדים (כמו @firstName בדוגמה שלמעלה) מאשר בערכים ליטרליים בטקסט של השאילתה. אפשר לשמור את הערך הראשון במטמון פעם אחת ולעשות בו שימוש חוזר בלי קשר לערך בפועל. לפרטים נוספים, אפשר לעיין במאמר בנושא אופטימיזציה של ביצועי שאילתות ב-Spanner.
טיפול בשגיאות
השיטות executeQuery (או executeStreamingSql) ו-streamingRead מחזירות זרם של הודעות PartialResultSet. כדי לשפר את היעילות, יכול להיות שערך של שורה או עמודה יפוצל לכמה הודעות PartialResultSet, במיוחד אם מדובר בנתונים גדולים.
יכול להיות שיהיו שיבושים בשידור הזה בגלל שגיאות זמניות ברשת, העברות שיחה מפוצלות או הפעלה מחדש של השרת. יכול להיות שיהיו העברות שיחה חלקיות במהלך איזון העומסים, ויכול להיות שיהיו הפעלות מחדש של השרתים במהלך השדרוגים.
כדי לטפל בהפרעות האלה, Spanner כולל מחרוזות אטומות resume_token בהודעות PartialResultSet מסוימות.
נקודות חשובות לגבי resume_token:
- לא כל רכיב
PartialResultSetמכיל רכיבresume_token. - בדרך כלל, התו
resume_tokenנכלל רק בסוף שורה מלאה, ומציין נקודת חזרה בטוחה. -
PartialResultSetעםchunked_value(לערכים גדולים שמפוצלים בין הודעות) לא יכלולresume_tokenעד שכל הערך והשורה יישלחו. - כדי להמשיך סטרימינג שהופסק, שולחים בקשה חדשה עם הערך האחרון שהתקבל של
resume_tokenשאינו ריק.
ספריות הלקוח של Spanner מנהלות באופן אוטומטי את האגירה הזו בזיכרון ואת השחזור. הם מרכיבים שורות מלאות מ-PartialResultSet הודעות ועוקבים אחרי האחרונה מביניהן.resume_token אם החיבור נכשל, הספרייה משתמשת באסימון התקין האחרון כדי להפעיל מחדש את הזרם, ומתעלמת מכל נתון חלקי שהתקבל אחרי האסימון הזה. התהליך הזה מבטיח שתראו זרם רציף של שורות מלאות ללא כפילויות, גם אם מתרחשים כשלים זמניים.