


Come descritto in Piani di esecuzione delle query, il compilatore SQL trasforma un'istruzione SQL in un piano di esecuzione delle query, che viene utilizzato per ottenere i risultati della query. Questa pagina descrive le best practice per la creazione di istruzioni SQL per aiutare Spanner a trovare piani di esecuzione efficienti. Consulta la guida all'[ottimizzazione delle query][query_tuning] per assistenza nel miglioramento delle prestazioni delle query.
Le istruzioni SQL di esempio mostrate in questa pagina utilizzano il seguente schema di esempio:
GoogleSQL
CREATE TABLE Singers (
 SingerId   INT64 NOT NULL,
 FirstName  STRING(1024),
 LastName   STRING(1024),
 SingerInfo BYTES(MAX),
 BirthDate  DATE
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
 SingerId     INT64 NOT NULL,
 AlbumId      INT64 NOT NULL,
 AlbumTitle   STRING(MAX),
 ReleaseDate  DATE
) PRIMARY KEY (SingerId, AlbumId),
INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Per il riferimento SQL completo, consulta Sintassi delle istruzioni, Funzioni e operatori e Struttura e sintassi lessicali.
PostgreSQL
CREATE TABLE Singers (
 SingerId   BIGINT PRIMARY KEY,
 FirstName  VARCHAR(1024),
 LastName   VARCHAR(1024),
 SingerInfo BYTEA,
 BirthDate  TIMESTAMPTZ
);

CREATE TABLE Albums (
 SingerId        BIGINT NOT NULL,
 AlbumId         BIGINT NOT NULL,
 AlbumTitle      VARCHAR(1024),
 ReleaseDate     DATE,
 PRIMARY KEY(SingerId, AlbumId),
 FOREIGN KEY (SingerId) REFERENCES Singers(SingerId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Per saperne di più, consulta Il linguaggio PostgreSQL in Spanner.
Utilizza parametri di ricerca
Spanner supporta parametri di ricerca per aumentare le prestazioni e contribuire a prevenire l'SQL injection quando le query vengono create utilizzando l'input utente'utente. Puoi utilizzare parametri di ricerca come sostituti di espressioni arbitrarie, ma non come sostituti di identificatori, nomi di colonne, nomi di tabelle o altre parti della query.
I parametri possono essere visualizzati ovunque sia previsto un valore letterale. Lo stesso nome di parametro può essere utilizzato più di una volta in una singola istruzione SQL.
In sintesi, parametri di ricerca supportano l'esecuzione delle query nei seguenti modi:
- Piani pre-ottimizzati: le query che utilizzano parametri possono essere eseguite più velocemente a ogni chiamata perché la parametrizzazione semplifica la memorizzazione nella cache del piano di esecuzione da parte di Spanner.
- Composizione semplificata delle query: non è necessario utilizzare caratteri di escape per i valori stringa quando li fornisci nei parametri di ricerca. I parametri di query riducono anche il rischio di errori di sintassi.
- Sicurezza: i parametri di query rendono le query più sicure proteggendoti da vari attacchi di SQL injection. Questa protezione è particolarmente importante per le query create dallinput utente.
Per migliorare le prestazioni, Spanner converte i valori letterali impostati come hardcoded in SQL in parametri se il piano di esecuzione ottimale delle query non dipende dai valori letterali specifici. In questo modo Spanner può ridurre la latenza e i costi della CPU memorizzando nella cache e riutilizzando il piano di query. Tuttavia, questo non offre le stesse protezioni da SQL injection e i vantaggi di una composizione più semplice delle query. L'utilizzo parametri di ricerca nel codice dell'applicazione è la best practice.
Scopri in che modo Spanner esegue le query
Spanner ti consente di eseguire query sui database utilizzando istruzioni SQL dichiarative che specificano i dati che vuoi recuperare. Se vuoi capire in che modo Spanner ottiene i risultati, esamina il piano di esecuzione della query. Un piano di esecuzione delle query mostra il costo di calcolo associato a ogni passaggio della query. Utilizzando questi costi, puoi eseguire il debug dei problemi di prestazioni delle query e ottimizzarle. Per scoprire di più, consulta Piani di esecuzione delle query.
Puoi recuperare i piani di esecuzione delle query tramite la console Google Cloud o le librerie client.
Per ottenere un piano di esecuzione delle query per una query specifica utilizzando la consoleGoogle Cloud , segui questi passaggi:
Apri la pagina Istanze Spanner.
Seleziona i nomi dell'istanza Spanner e del database su cui vuoi eseguire query.
Fai clic su Spanner Studio nel pannello di navigazione a sinistra.
Digita la query nel campo di testo, quindi fai clic su Esegui query.
Fai clic su Spiegazione
. La console Google Cloud mostra un piano di esecuzione visivo per la query.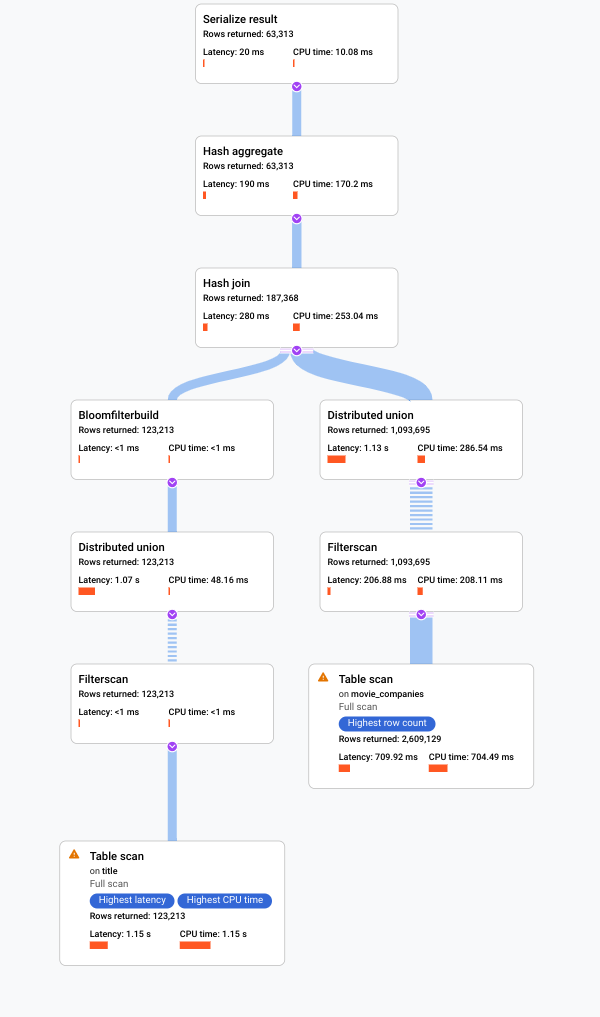
Per saperne di più su come comprendere i piani visivi e utilizzarli per eseguire il debug delle query, consulta Ottimizza una query utilizzando il visualizzatore del piano di query.
Puoi anche visualizzare esempi di piani di query storici e confrontare le prestazioni di una query nel tempo per determinate query. Per scoprire di più, consulta Piani di query campionati.
Utilizza indici secondari
Come altri database relazionali, Spanner offre indici secondari che puoi utilizzare per recuperare i dati utilizzando un'istruzione SQL o l'interfaccia di lettura di Spanner. L'utilizzo di un indice secondario in una query SQL ti consente di specificare come vuoi che Spanner ottenga i risultati. La specifica di un indice secondario può velocizzare l'esecuzione delle query.
Ad esempio, supponiamo di voler recuperare gli ID di tutti i cantanti con un cognome specifico. Un modo per scrivere una query SQL di questo tipo è:
SELECT s.SingerId
FROM Singers AS s
WHERE s.LastName = 'Smith';
Questa query restituirebbe i risultati previsti, ma potrebbe richiedere molto tempo. La tempistica dipende dal numero di righe nella tabella Singers e da quante soddisfano il predicato WHERE s.LastName = 'Smith'.
Se non esiste un indice secondario che contiene la colonna LastName da cui leggere,
il piano di query leggerà l'intera tabella Singers per trovare le righe che corrispondono al
predicato. La lettura dell'intera tabella è chiamata scansione completa della tabella. Una scansione completa della tabella è un modo costoso per ottenere i risultati quando la tabella contiene solo una piccola percentuale di Singers con quel cognome.
Puoi migliorare le prestazioni di questa query definendo un indice secondario nella colonna del cognome:
CREATE INDEX SingersByLastName ON Singers (LastName);
Poiché l'indice secondario SingersByLastName contiene la colonna della tabella indicizzata LastName e la colonna della chiave primaria SingerId, Spanner può recuperare tutti i dati dalla tabella dell'indice, che è molto più piccola, anziché eseguire la scansione dell'intera tabella Singers.
In questo scenario, Spanner utilizza automaticamente l'indice secondario
SingersByLastName durante l'esecuzione della query (a condizione che siano trascorsi tre giorni
dalla creazione del database; consulta Nota sui nuovi database).
Tuttavia, è meglio indicare esplicitamente a Spanner di utilizzare l'indice specificando una istruzione index nella clausola FROM:
GoogleSQL
SELECT s.SingerId
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Se utilizzi schemi denominati, utilizza la seguente sintassi per la clausola FROM:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Ora supponiamo che tu voglia recuperare anche il nome del cantante oltre all'ID. Anche se la colonna FirstName non è contenuta nell'indice, devi comunque specificare la direttiva dell'indice come prima:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId, s.FirstName
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
L'utilizzo dell'indice offre comunque un vantaggio in termini di prestazioni perché Spanner non deve eseguire una scansione completa della tabella durante l'esecuzione del piano di query. Seleziona invece il sottoinsieme di righe che soddisfano il predicato dall'indice SingersByLastName, quindi esegue una ricerca dalla tabella di base Singers per recuperare il nome solo per quel sottoinsieme di righe.
Se vuoi che Spanner non debba recuperare alcuna riga dalla tabella di base, puoi archiviare una copia della colonna FirstName nell'indice stesso:
GoogleSQL
CREATE INDEX SingersByLastName ON Singers (LastName) STORING (FirstName);
PostgreSQL
CREATE INDEX SingersByLastName ON Singers (LastName) INCLUDE (FirstName);
L'utilizzo di una clausola STORING (per il dialetto GoogleSQL) o di una clausola INCLUDE (per il dialetto PostgreSQL) come questa comporta costi di archiviazione aggiuntivi, ma offre i seguenti vantaggi:
- Le query SQL che utilizzano l'indice e selezionano le colonne archiviate nella clausola
STORINGoINCLUDEnon richiedono un join aggiuntivo alla tabella di base. - Le chiamate di lettura che utilizzano l'indice possono leggere le colonne archiviate nella clausola
STORINGoINCLUDE.
Gli esempi precedenti illustrano come gli indici secondari possono velocizzare le query quando le righe scelte dalla clausola WHERE di una query possono essere identificate rapidamente utilizzando l'indice secondario.
Un altro scenario in cui gli indici secondari possono offrire vantaggi in termini di prestazioni è quello di alcune query che restituiscono risultati ordinati. Ad esempio, supponiamo che tu voglia recuperare tutti i titoli degli album e le relative date di uscita in ordine crescente di data di uscita e in ordine decrescente di titolo dell'album. Puoi scrivere una query SQL come segue:
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Senza un indice secondario, questa query richiede un passaggio di ordinamento potenzialmente costoso nel piano di esecuzione. Puoi velocizzare l'esecuzione delle query definendo questo indice secondario:
CREATE INDEX AlbumsByReleaseDateTitleDesc on Albums (ReleaseDate, AlbumTitle DESC);
Quindi, riscrivi la query per utilizzare l'indice secondario:
GoogleSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums@{FORCE_INDEX=AlbumsByReleaseDateTitleDesc} AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
PostgreSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums /*@ FORCE_INDEX=AlbumsByReleaseDateTitleDesc */ AS s
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Questa query e questa definizione di indice soddisfano entrambi i seguenti criteri:
- Per rimuovere il passaggio di ordinamento, assicurati che l'elenco di colonne nella clausola
ORDER BYsia un prefisso dell'elenco di chiavi di indice. - Per evitare di dover tornare alla tabella di base per recuperare le colonne mancanti, assicurati che l'indice copra tutte le colonne della tabella utilizzate dalla query.
Sebbene gli indici secondari possano velocizzare le query comuni, l'aggiunta di indici secondari può aumentare la latenza delle operazioni di commit, perché ogni indice secondario in genere richiede il coinvolgimento di un nodo aggiuntivo in ogni commit. Per la maggior parte dei workload, avere alcuni indici secondari va bene. Tuttavia, dovresti considerare se ti interessa di più la latenza di lettura o di scrittura e valutare quali operazioni sono più critiche per il tuo workload. Esegui il benchmark del tuo workload per assicurarti che funzioni come previsto.
Per il riferimento completo sugli indici secondari, consulta Indici secondari.
Ottimizza le ricerche delle chiavi di intervallo
Un utilizzo comune di una query SQL è la lettura di più righe da Spanner in base a un elenco di chiavi note.
Le seguenti best practice ti aiutano a scrivere query efficienti durante il recupero dei dati in base a un intervallo di chiavi:
Se l'elenco di chiavi è sparso e non adiacente, utilizza parametri di ricerca e
UNNESTper creare la query.Ad esempio, se l'elenco di chiavi è
{1, 5, 1000}, scrivi la query in questo modo:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST (@KeyList)
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST ($1)
Note:
L'operatore UNNEST dell'array appiattisce un array di input in righe di elementi.
Il parametro di query, che è
@KeyListper GoogleSQL e$1per PostgreSQL, può velocizzare la query, come descritto nella best practice precedente.È meglio utilizzare un UNNEST con un singolo parametro, anziché OR con più parametri.
Se l'elenco di chiavi è adiacente e rientra in un intervallo, specifica i limiti inferiore e superiore dell'intervallo di chiavi nella clausola
WHERE.Ad esempio, se l'elenco di chiavi è
{1,2,3,4,5}, crea la query come segue:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN @min AND @max
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN $1 AND $2
Questa query è più efficiente solo se le chiavi nell'intervallo di chiavi sono adiacenti. In altre parole, se l'elenco di chiavi è
{1, 5, 1000}, non specificare i limiti inferiore e superiore come nella query precedente, perché la query risultante eseguirebbe la scansione di ogni valore compreso tra 1 e 1000.
Ottimizza i join
Le operazioni di join possono essere costose perché possono aumentare in modo significativo il numero di righe che la query deve analizzare, il che comporta query più lente. Oltre alle tecniche che utilizzi abitualmente in altri database relazionali per ottimizzare le query di join, di seguito sono riportate alcune best practice per un JOIN più efficiente quando utilizzi Spanner SQL:
- Se possibile, unisci i dati nelle tabelle con interleaving in base alla chiave primaria. Ad esempio:
SELECT s.FirstName, a.ReleaseDate
FROM Singers AS s JOIN Albums AS a ON s.SingerId = a.SingerId;
The rows in the interleaved table `Albums` are physically
stored in the same splits as the parent row in `Singers`, as discussed in
[Schema and Data Model](/spanner/docs/schema-and-data-model). Therefore, joins can be
completed locally without sending lots of data across the network.
Utilizza l'istruzione JOIN se vuoi forzare l'ordine del join. Ad esempio:
GoogleSQL
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
PostgreSQL
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
La direttiva di join
FORCE_JOIN_ORDERindica a Spanner di utilizzare l'ordine di join specificato nella query (ovveroSingers JOIN Albums, nonAlbums JOIN Singers). I risultati restituiti sono gli stessi, indipendentemente dall'ordine scelto da Spanner. Tuttavia, potresti voler utilizzare questa istruzione di join se noti nel piano di query che Spanner ha modificato l'ordine di join e ha causato conseguenze indesiderate, come risultati intermedi più grandi, o ha perso opportunità di ricerca di righe.Utilizza una direttiva di join per scegliere un'implementazione di join. Quando utilizzi SQL per eseguire query su più tabelle, Spanner utilizza automaticamente un metodo di join che probabilmente renderà la query più efficiente. Tuttavia, Google consiglia di eseguire test con diversi algoritmi di join. La scelta dell'algoritmo di join giusto può migliorare la latenza, il consumo di memoria o entrambi. Questa query mostra la sintassi per l'utilizzo di un'istruzione JOIN con il suggerimento
JOIN_METHODper scegliere unHASH JOIN:GoogleSQL
SELECT *
FROM Singers s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON a.SingerId = a.SingerId
PostgreSQL
SELECT *
FROM Singers s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON a.SingerId = a.SingerId
Se utilizzi un
HASH JOINoAPPLY JOINe hai una clausolaWHEREaltamente selettiva su un lato diJOIN, inserisci la tabella che produce il numero più basso di righe come prima tabella nella clausolaFROMdel join. Questa struttura è utile perché inHASH JOIN, Spanner sceglie sempre la tabella di sinistra come build e la tabella di destra come probe. Analogamente, perAPPLY JOIN, Spanner sceglie la tabella a sinistra come esterna e la tabella a destra come interna. Scopri di più su questi tipi di join: [Hash join][hash_join] e [Apply join][apply_join].Per le query fondamentali per il tuo workload, specifica il metodo e l'ordine di join più efficienti nelle istruzioni SQL per ottenere prestazioni più coerenti.
Ottimizza le query con il pushdown del predicato del timestamp
Il pushdown del predicato del timestamp è una tecnica di ottimizzazione delle query utilizzata in Spanner per migliorare l'efficienza delle query che utilizzano timestamp e dati con una policy di archiviazione a livelli basata sull'età. Quando attivi questa ottimizzazione, le operazioni di filtro sulle colonne dei timestamp vengono eseguite il prima possibile nel piano di esecuzione delle query. In questo modo, puoi ridurre notevolmente la quantità di dati elaborati e migliorare le prestazioni complessive delle query.
Con il pushdown del predicato del timestamp, il motore del database analizza la query e identifica il filtro del timestamp. Quindi, "esegue il push down" di questo filtro al livello di archiviazione, in modo che dall'SSD vengano letti solo i dati pertinenti in base ai criteri del timestamp. In questo modo, la quantità di dati elaborati e trasferiti viene ridotta al minimo, con una conseguente esecuzione più rapida delle query.
Per ottimizzare le query in modo che accedano solo ai dati archiviati su SSD, deve essere soddisfatta la seguente condizione:
- La query deve avere il pushdown del predicato del timestamp abilitato. Per saperne di più, consulta Suggerimenti per le istruzioni GoogleSQL e Suggerimenti per le istruzioni PostgreSQL
La query deve utilizzare una limitazione basata sull'età uguale o inferiore all'età specificata nella policy di spill dei dati (impostata con l'opzione
ssd_to_hdd_spill_timespannell'istruzione DDLCREATE LOCALITY GROUPoALTER LOCALITY GROUP). Per saperne di più, consulta Istruzioni GoogleSQLLOCALITY GROUPe Istruzioni PostgreSQLLOCALITY GROUP.La colonna filtrata nella query deve essere una colonna timestamp che contiene il timestamp di commit. Per informazioni dettagliate su come creare una colonna di timestamp di commit, consulta Timestamp di commit in GoogleSQL e Timestamp di commit in PostgreSQL. Queste colonne devono essere aggiornate insieme alla colonna del timestamp e risiedere nello stesso gruppo di località, che ha una policy di archiviazione a livelli basata sull'età.
Se, per una determinata riga, alcune delle colonne su cui viene eseguita la query si trovano su SSD e altre su HDD (perché le colonne vengono aggiornate in momenti diversi e invecchiano su HDD in momenti diversi), le prestazioni della query potrebbero essere peggiori quando utilizzi l'hint. Questo perché la query deve inserire i dati dai diversi livelli di archiviazione. In seguito all'utilizzo del suggerimento, Spanner invecchia i dati a livello di singola cella (livello di granularità di riga e colonna) in base al timestamp di commit di ogni cella, rallentando la query. Per evitare questo problema, assicurati di aggiornare regolarmente tutte le colonne su cui vengono eseguite query utilizzando questa tecnica di ottimizzazione nella stessa transazione, in modo che tutte le colonne condividano lo stesso timestamp di commit e traggano vantaggio dall'ottimizzazione.
Per attivare il pushdown del predicato del timestamp a livello di istruzione, utilizza un suggerimento per l'istruzione nella query. Ad esempio:
GoogleSQL
@{allow_timestamp_predicate_pushdown=TRUE}
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 12 HOUR);
PostgreSQL
/*@allow_timestamp_predicate_pushdown=TRUE*/
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > CURRENT_TIMESTAMP - INTERVAL '12 hours';
Evita letture di grandi dimensioni all'interno di transazioni di lettura/scrittura
Le transazioni di lettura/scrittura consentono una sequenza di zero o più letture o query SQL e possono includere un insieme di mutazioni prima di una chiamata al commit. Per mantenere la coerenza dei dati, Spanner acquisisce i blocchi durante la lettura e la scrittura di righe nelle tabelle e negli indici. Per saperne di più sul blocco, consulta Ciclo di vita di letture e scritture.
A causa del modo in cui funziona il blocco in Spanner, l'esecuzione di una lettura o di una query SQL che legge un numero elevato di righe (ad esempio SELECT * FROM
Singers) significa che nessun'altra transazione può scrivere nelle righe che hai letto finché la transazione non viene sottoposta a commit o interrotta.
Inoltre, poiché la transazione elabora un numero elevato di righe, è probabile che richieda più tempo rispetto a una transazione che legge un intervallo di righe molto più piccolo (ad esempio SELECT LastName FROM Singers WHERE SingerId = 7), il che aggrava ulteriormente il problema e riduce il throughput del sistema.
Pertanto, cerca di evitare letture di grandi dimensioni (ad esempio scansioni di tabelle complete o operazioni di join di grandi dimensioni) nelle transazioni, a meno che tu non sia disposto ad accettare un throughput di scrittura inferiore.
In alcuni casi, il seguente pattern può produrre risultati migliori:
- Esegui le letture di grandi dimensioni all'interno di una transazione di sola lettura. Le transazioni di sola lettura consentono un throughput aggregato più elevato perché non utilizzano blocchi.
- (Facoltativo) Esegui l'elaborazione richiesta sui dati appena letti.
- Avvia una transazione di lettura/scrittura.
- Verifica che i valori delle righe critiche non siano cambiati rispetto a quando hai eseguito la transazione di sola lettura nel passaggio 1.
- Se le righe sono cambiate, esegui il rollback della transazione e ricomincia dal passaggio 1.
- Se è tutto a posto, esegui il commit delle mutazioni.
Un modo per assicurarti di evitare letture di grandi dimensioni nelle transazioni di lettura/scrittura è esaminare i piani di esecuzione generati dalle query.
Utilizza ORDER BY per garantire l'ordinamento dei risultati SQL
Se ti aspetti un determinato ordine per i risultati di una query SELECT,
includi esplicitamente la clausola ORDER BY. Ad esempio, se vuoi elencare tutti i cantanti in ordine di chiave primaria, utilizza questa query:
SELECT * FROM
Singers
ORDER BY SingerId;
Spanner garantisce l'ordinamento dei risultati solo se la clausola ORDER BY è presente nella query. In altre parole, considera questa query senza ORDER
BY:
SELECT * FROM Singers;
Spanner non garantisce che i risultati di questa query siano in ordine di chiave primaria. Inoltre, l'ordinamento dei risultati può cambiare in qualsiasi momento e non è garantito che sia coerente da una chiamata all'altra. Se una query contiene una clausola ORDER BY e Spanner utilizza un indice che fornisce l'ordine richiesto, Spanner non ordina esplicitamente i dati. Pertanto, non preoccuparti dell'impatto sul rendimento dell'inclusione di questa clausola. Puoi verificare se un'operazione di ordinamento esplicita è inclusa nell'esecuzione esaminando il piano di query.
Utilizza STARTS_WITH anziché LIKE
Poiché Spanner non valuta i pattern LIKE parametrizzati fino al momento dell'esecuzione, deve leggere tutte le righe e valutarle rispetto all'espressione LIKE per filtrare le righe che non corrispondono.
Quando un pattern LIKE ha la forma foo% (ad esempio, inizia con una stringa fissa e termina con un singolo carattere jolly percentuale) e la colonna è indicizzata, utilizza STARTS_WITH anziché LIKE. Questa opzione consente a Spanner di ottimizzare in modo più efficace il piano di esecuzione delle query.
Non consigliato:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE @like_clause;
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE $1;
Recommended:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, @prefix);
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, $2);
Utilizza i timestamp di commit
Se la tua applicazione deve eseguire query sui dati scritti dopo un determinato momento, aggiungi colonne di timestamp di commit alle tabelle pertinenti. I timestamp di commit consentono un'ottimizzazione di Spanner che può ridurre l'I/O delle query le cui clausole WHERE limitano i risultati alle righe scritte più di recente rispetto a un momento specifico.
Scopri di più su questa ottimizzazione con i database con dialetto GoogleSQL o con i database con dialetto PostgreSQL.