


In un database Spanner, Spanner crea automaticamente un indice per la chiave primaria di ogni tabella. Ad esempio, non devi fare nulla per indicizzare la chiave primaria di Singers, perché viene indicizzata automaticamente.
Puoi anche creare indici secondari per altre colonne. Aggiungere un indice secondario a una colonna rende più efficiente la ricerca dei dati nella colonna. Ad esempio, se devi cercare rapidamente un album per titolo, devi creare un indice secondario su AlbumTitle, in modo che Spanner non debba eseguire la scansione dell'intera tabella.
Se la ricerca nell'esempio precedente viene eseguita all'interno di una transazione di lettura/scrittura, la ricerca più efficiente evita anche di bloccare l'intera tabella, il che consente inserimenti e aggiornamenti simultanei alla tabella per le righe esterne all'intervallo di ricerca AlbumTitle.
Oltre ai vantaggi che apportano alle ricerche, gli indici secondari possono anche aiutare Spanner a eseguire le scansioni in modo più efficiente, consentendo scansioni degli indici anziché scansioni complete delle tabelle.
Spanner archivia i seguenti dati in ogni indice secondario:
- Tutte le colonne chiave della tabella di base
- Tutte le colonne incluse nell'indice
- Tutte le colonne specificate nella clausola facoltativa
STORING(database con dialetto GoogleSQL) oINCLUDE(database con dialetto PostgreSQL) della definizione dell'indice.
Nel tempo, Spanner analizza le tabelle per assicurarsi che gli indici secondari vengano utilizzati per le query appropriate.
Aggiungi un indice secondario
Il momento più efficiente per aggiungere un indice secondario è durante la creazione della tabella. Per creare una tabella e i relativi indici contemporaneamente, invia le istruzioni DDL per la nuova tabella e i nuovi indici in un'unica richiesta a Spanner.
In Spanner, puoi anche aggiungere un nuovo indice secondario a una tabella esistente mentre il database continua a gestire il traffico. Come qualsiasi altra modifica dello schema in Spanner, l'aggiunta di un indice a un database esistente non richiede la disconnessione del database e non blocca intere colonne o tabelle.
Ogni volta che viene aggiunto un nuovo indice a una tabella esistente, Spanner esegue automaticamente il backfill o il popolamento dell'indice per riflettere una visualizzazione aggiornata dei dati indicizzati. Spanner gestisce questo processo di backfill per te e il processo viene eseguito in background utilizzando le risorse dei nodi con priorità bassa. La velocità di backfill dell'indice si adatta alle risorse dei nodi in evoluzione durante la creazione dell'indice e il backfill non influisce in modo significativo sulle prestazioni del database.
La creazione dell'indice può richiedere da diversi minuti a molte ore. Poiché la creazione dell'indice è un aggiornamento dello schema, è soggetta agli stessi vincoli di prestazioni di qualsiasi altro aggiornamento dello schema. Il tempo necessario per creare un indice secondario dipende da diversi fattori:
- Le dimensioni del set di dati
- La capacità di calcolo dell'istanza
- Il carico sull'istanza
Per visualizzare i progressi di un processo di backfill dell'indice, consulta la sezione relativa ai progressi.
Tieni presente che l'utilizzo della colonna del timestamp di commit come prima parte dell'indice secondario può creare hotspot e ridurre le prestazioni di scrittura.
Utilizza l'istruzione CREATE INDEX per definire un indice secondario nello schema. Ecco alcuni esempi:
Per indicizzare tutti i Singers nel database in base al nome e al cognome:
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Per creare un indice di tutti i Songs nel database in base al valore di SongName:
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
Per indicizzare solo i brani di un determinato cantante, utilizza la clausola INTERLEAVE IN per intercalare l'indice nella tabella Singers:
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
Per indicizzare solo i brani di un determinato album:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
Per indicizzare in ordine decrescente di SongName:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
Tieni presente che l'annotazione DESC precedente si applica solo a SongName. Per indicizzare in ordine decrescente altre chiavi di indice, annotale anche con DESC: SingerId DESC, AlbumId DESC.
Tieni presente inoltre che PRIMARY_KEY è una parola riservata e non può essere utilizzata come nome di un indice. È il nome assegnato allo pseudo-indice che viene creato quando viene creata una tabella con la specifica PRIMARY KEY
Per ulteriori dettagli e best practice per la scelta di indici non con interleaving e con interleaving, consulta Scegli tra indici con interleaving e globali, Opzioni di indice e Utilizza un indice con interleaving su una colonna il cui valore aumenta o diminuisce monotonicamente.
Indici e interleaving
Gli indici Spanner possono essere intercalati con altre tabelle per collocare le righe dell'indice con quelle di un'altra tabella. Analogamente all'interleaving delle tabelle Spanner, le colonne di chiave primaria dell'elemento padre dell'indice devono essere un prefisso delle colonne indicizzate, corrispondenti per tipo e ordinamento. A differenza delle tabelle intercalate, non è richiesta la corrispondenza dei nomi delle colonne. Ogni riga di un indice con interleaving viene archiviata fisicamente insieme alla riga principale associata.
Ad esempio, considera il seguente schema:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
Per indicizzare tutti i Singers nel database in base al nome e al cognome, devi creare un indice. Ecco come definire l'indice SingersByFirstLastName:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Se vuoi creare un indice di Songs su (SingerId, AlbumId, SongName),
puoi procedere nel seguente modo:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
In alternativa, puoi creare un indice con interleaving con un predecessore di Songs, ad esempio:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
Inoltre, puoi anche creare un indice di Songs su (PublisherId, SingerId, AlbumId, SongName) con interleaving con una tabella che non è un predecessore di Songs, ad esempio Publishers. Tieni presente che la chiave primaria della tabella Publishers (id) non è un prefisso delle colonne indicizzate nell'esempio seguente. Questo è comunque consentito perché Publishers.Id e Songs.PublisherId condividono lo stesso tipo, ordinamento e nullabilità.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
Scegli tra indici interleaved e globali
Quando crei un indice secondario in Spanner, lo definisci come indice globale (l'indice predefinito non con interleaving) o come indice con interleaving. La scelta del tipo di indice ottimale è fondamentale per le prestazioni di lettura e scrittura.
Confronto degli indici
| Funzionalità | Indice con interleaving | Indice globale |
|---|---|---|
| Località di archiviazione | Collocata nella stessa suddivisione della riga principale (albero delle righe). | Archiviati in una tabella root separata, che può essere suddivisa indipendentemente dalla tabella di base. |
| Requisiti principali | La chiave primaria della tabella padre deve essere un prefisso delle chiavi di indice. | Nessuna limitazione sulle chiavi di indice. |
| Overhead di scrittura | Basso. Se l'interfoliazione viene eseguita in un predecessore della tabella di base, gli aggiornamenti sono solitamente locali rispetto alla suddivisione, evitando commit in due fasi tra le suddivisioni. Se l'interfoliazione è in una tabella che non è un predecessore, l'overhead di scrittura è maggiore perché gli aggiornamenti potrebbero richiedere transazioni distribuite. | Più alto. Gli aggiornamenti spesso interessano diverse suddivisioni, richiedendo transazioni distribuite. |
| Ideale per | Query con ambito limitato a una singola entità padre, ad esempio "trova le foto dell'utente USER_NAME". | Query che eseguono ricerche nell'intero database, ad esempio "trova utente per email". |
Perché di solito sono preferiti gli indici con interfoliazione
In un database distribuito come Spanner, la località dei dati è fondamentale per le prestazioni. Gli indici con interleaving sono generalmente preferiti perché preservano la località dei dati:
- Letture efficienti: se le query filtrano sempre in entità padre'ID di un'entità principale, un indice con interleaving consente a Spanner di soddisfare la query eseguendo la scansione solo della suddivisione che contiene l'entità padre, anziché consultare più suddivisioni.
- Scritture efficienti: quando aggiorni una riga in una tabella, Spanner deve aggiornare anche i relativi indici secondari. Se utilizzi un indice globale, è probabile che la voce dell'indice si trovi in una suddivisione diversa rispetto alla riga di base. In questo modo, Spanner è costretto a eseguire una transazione distribuita (commit in due fasi) tra gli split, il che aumenta la latenza e l'utilizzo della CPU. Se un indice intercalato è intercalato in un predecessore della tabella di base, la voce dell'indice viene archiviata nella stessa suddivisione della riga di base, rendendo la scrittura un'operazione locale.
Guida alle decisioni
Utilizza le seguenti linee guida per scegliere il tipo di indice ottimale per il tuo caso d'uso:
Quando utilizzare un indice con interfoliazione
Utilizza un indice con interleaving quando una o più delle seguenti condizioni sono vere:
- Le query includono sempre un filtro sulla chiave primaria della tabella principale, ad esempio
WHERE UserId = @userId AND .... - Le colonne della chiave primaria della tabella padre possono essere utilizzate naturalmente come prefisso per le chiavi di indice.
- Vuoi ridurre al minimo la latenza di scrittura e l'overhead della CPU per la manutenzione dell'indice.
Esempio:
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
Quando utilizzare un indice globale
Utilizza un indice globale quando si verificano una o più delle seguenti condizioni:
- Devi eseguire query sui dati nell'intero database senza filtrare in base a un'entità padre, ad esempio una ricerca globale.
- Le colonne che vuoi indicizzare non condividono un prefisso con nessuna tabella principale.
Esempio:
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
Controlla l'avanzamento del backfill dell'indice
Console
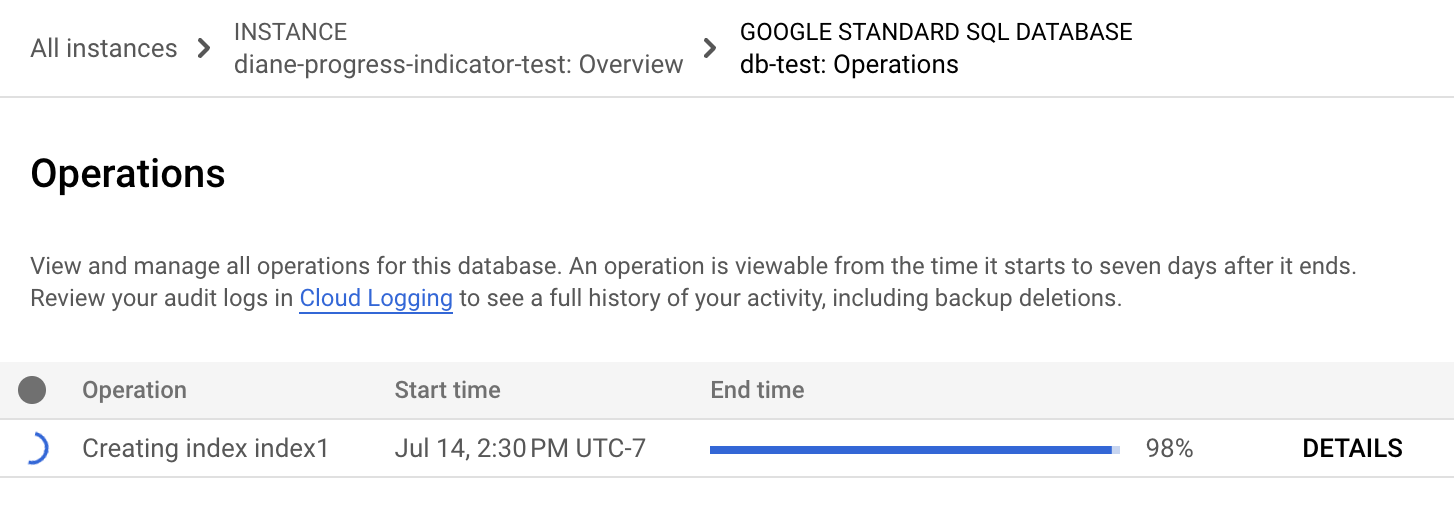
Nel menu di navigazione di Spanner, fai clic sulla scheda Operazioni. La pagina Operazioni mostra un elenco delle operazioni in esecuzione.
Trova l'operazione di backfill nell'elenco. Se è ancora in esecuzione, l'indicatore di avanzamento nella colonna Ora di fine mostra la percentuale dell'operazione completata, come mostrato nell'immagine seguente:
gcloud
Utilizza gcloud spanner operations describe per controllare l'avanzamento di un'operazione.
Recupera l'ID operazione:
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Sostituisci quanto segue:
- INSTANCE-NAME con il nome dell'istanza Spanner.
- DATABASE-NAME con il nome del database.
Note sull'utilizzo:
Per limitare l'elenco, specifica il flag
--filter. Ad esempio:--filter="metadata.name:example-db"elenca solo le operazioni su un database specifico.--filter="error:*"elenca solo le operazioni di backup non riuscite.
Per informazioni sulla sintassi dei filtri, consulta gcloud topic filters. Per informazioni sul filtro delle operazioni di backup, consulta il campo
filterin ListBackupOperationsRequest.Il flag
--typenon è sensibile alle maiuscole.
L'output è simile al seguente:
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
Esegui
gcloud spanner operations describe:gcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
Sostituisci quanto segue:
- INSTANCE-NAME: il nome dell'istanza Spanner.
- DATABASE-NAME: il nome del database Spanner.
- PROJECT-NAME: il nome del progetto.
- OPERATION-ID: l'ID operazione dell'operazione che vuoi controllare.
La sezione
progressnell'output mostra la percentuale di completamento dell'operazione. L'output sarà simile al seguente:done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST v1
Recupera l'ID operazione:
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Sostituisci quanto segue:
- INSTANCE-NAME con il nome dell'istanza Spanner.
- DATABASE-NAME con il nome del database.
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT-ID: l'ID progetto
- INSTANCE-ID: l'ID istanza.
- DATABASE-ID: l'ID del database.
- OPERATION-ID: l'ID operazione.
Metodo HTTP e URL:
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
Per inviare la richiesta, espandi una di queste opzioni:
Dovresti ricevere una risposta JSON simile alla seguente:
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
Per gcloud e REST, puoi trovare l'avanzamento di ogni istruzione di backfill dell'indice nella sezione progress. Per ogni istruzione nell'array di istruzioni, esiste un campo corrispondente nell'array di avanzamento. L'ordine di questo array di avanzamento corrisponde all'ordine dell'array di istruzioni. Una volta disponibili, i campi startTime, progressPercent e endTime vengono compilati di conseguenza.
Tieni presente che l'output non mostra un tempo stimato per il completamento dell'avanzamento del backfill.
Se l'operazione richiede troppo tempo, puoi annullarla. Per saperne di più, consulta Annulla la creazione dell'indice.
Scenari durante la visualizzazione dell'avanzamento del backfill dell'indice
Esistono diversi scenari che puoi incontrare quando provi a controllare l'avanzamento di un backfill dell'indice. Le istruzioni di creazione degli indici che richiedono un backfill dell'indice fanno parte delle operazioni di aggiornamento dello schema e possono essere presenti diverse istruzioni che fanno parte di un'operazione di aggiornamento dello schema.
Il primo scenario è il più semplice, ovvero quando l'istruzione di creazione dell'indice è la prima istruzione nell'operazione di aggiornamento dello schema. Poiché l'istruzione di creazione dell'indice è la prima istruzione, è la prima a essere elaborata ed eseguita a causa dell'ordine di esecuzione.
Immediatamente, il campo startTime dell'istruzione di creazione dell'indice verrà compilato con l'ora di inizio dell'operazione di aggiornamento dello schema. Successivamente, il campo progressPercent dell'istruzione di creazione dell'indice viene compilato quando l'avanzamento del backfill dell'indice è superiore allo 0%. Infine, il campo endTime viene compilato una volta eseguito il commit dell'istruzione.
Il secondo scenario si verifica quando l'istruzione di creazione dell'indice non è la prima istruzione nell'operazione di aggiornamento dello schema. Nessun campo relativo all'istruzione di creazione dell'indice verrà compilato finché non verrà eseguito il commit delle istruzioni precedenti a causa dell'ordine di esecuzione.
Come nello scenario precedente, una volta eseguito il commit delle istruzioni precedenti, viene compilato prima il campo startTime dell'istruzione di creazione dell'indice, seguito dal campo progressPercent. Infine, il campo endTime viene compilato al termine del commit dell'istruzione.
Annulla la creazione dell'indice
Puoi utilizzare Google Cloud CLI per annullare la creazione dell'indice. Per recuperare un elenco di operazioni di aggiornamento dello schema per un database Spanner, utilizza il comando gcloud spanner operations list e includi l'opzione --filter:
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
Trova il OPERATION_ID dell'operazione che vuoi annullare, quindi utilizza il comando gcloud spanner operations cancel per annullarla:
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
Visualizza gli indici esistenti
Per visualizzare le informazioni sugli indici esistenti in un database, puoi utilizzare la consoleGoogle Cloud o Google Cloud CLI:
Console
Vai alla pagina Istanze di Spanner nella console Google Cloud .
Fai clic sul nome dell'istanza che vuoi visualizzare.
Nel riquadro a sinistra, fai clic sul database che vuoi visualizzare, quindi sulla tabella che vuoi visualizzare.
Fai clic sulla scheda Indici. La console Google Cloud mostra un elenco di indici.
(Facoltativo) Per visualizzare i dettagli di un indice, ad esempio le colonne che include, fai clic sul nome dell'indice.
gcloud
Utilizza il comando gcloud spanner databases ddl describe:
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
gcloud CLI stampa le istruzioni DDL (Data Definition Language) per creare le tabelle e gli indici del database. Le istruzioni CREATE
INDEX descrivono gli indici esistenti. Ad esempio:
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
Esegui query con un indice specifico
Le sezioni seguenti spiegano come specificare un indice in un'istruzione SQL e con l'interfaccia di lettura per Spanner. Gli esempi in queste sezioni presuppongono che tu abbia aggiunto una colonna MarketingBudget alla tabella Albums e creato un indice denominato AlbumsByAlbumTitle:
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Specifica un indice in un'istruzione SQL
Quando utilizzi SQL per eseguire query su una tabella Spanner, Spanner utilizza automaticamente tutti gli indici che potrebbero rendere la query più efficiente. Di conseguenza, non è necessario specificare un indice per le query SQL. Tuttavia, per le query fondamentali per il tuo workload, Google consiglia di utilizzare le istruzioni FORCE_INDEX nelle istruzioni SQL per ottenere prestazioni più coerenti.
In alcuni casi, Spanner potrebbe scegliere un indice che causa un aumento della latenza delle query. Se segui i [passaggi per la risoluzione dei problemi relativi alle regressioni delle prestazioni][troubleshooting-query-performance-regressions] e decidi di provare un indice diverso per la query, puoi specificare l'indice come parte della query.
Per specificare un indice in un'istruzione SQL, utilizza l'hint FORCE_INDEX per fornire un'istruzione di indice. Le istruzioni di indicizzazione utilizzano la seguente sintassi:
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
Puoi anche utilizzare un'istruzione di indice per indicare a Spanner di analizzare la tabella di base anziché utilizzare un indice:
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
Puoi utilizzare un'istruzione di indice per indicare a Spanner di eseguire la scansione di un indice in una tabella con schemi denominati:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
L'esempio seguente mostra una query SQL che specifica un indice:
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
Un'istruzione di indice potrebbe forzare il processore di query di Spanner a leggere colonne aggiuntive richieste dalla query, ma non archiviate nell'indice.
Il processore di query recupera queste colonne unendo l'indice e la tabella di base. Per evitare questo join aggiuntivo, utilizza una clausola STORING (database con dialetto GoogleSQL) o una clausola INCLUDE (database con dialetto PostgreSQL) per archiviare le colonne aggiuntive nell'indice.
Nell'esempio precedente, la colonna MarketingBudget non è archiviata nell'indice, ma la query SQL seleziona questa colonna. Di conseguenza, Spanner deve cercare la colonna MarketingBudget nella tabella di base e poi unirla ai dati dell'indice per restituire i risultati della query.
Spanner genera un errore se la direttiva dell'indice presenta uno dei seguenti problemi:
- L'indice non esiste.
- L'indice si trova su una tabella di base diversa.
- Nella query manca un'espressione di filtro
NULLobbligatoria per un indiceNULL_FILTERED.
I seguenti esempi mostrano come scrivere ed eseguire query che recuperano i valori di AlbumId, AlbumTitle e MarketingBudget utilizzando l'indice AlbumsByAlbumTitle:
C++
C#
Vai
Java
Node.js
PHP
Python
Ruby
Specifica un indice nell'interfaccia di lettura
Quando utilizzi l'interfaccia di lettura di Spanner e vuoi che Spanner utilizzi un indice, devi specificare l'indice. L'interfaccia di lettura non seleziona automaticamente l'indice.
Inoltre, l'indice deve contenere tutti i dati visualizzati nei risultati della query, escluse le colonne che fanno parte della chiave primaria. Questa limitazione esiste perché l'interfaccia di lettura non supporta i join tra l'indice e la tabella di base. Se devi includere altre colonne nei risultati della query, hai a disposizione alcune opzioni:
- Utilizza una clausola
STORINGoINCLUDEper archiviare le colonne aggiuntive nell'indice. - Esegui una query senza includere le colonne aggiuntive, quindi utilizza le chiavi primarie per inviare un'altra query che legga le colonne aggiuntive.
Spanner restituisce i valori dall'indice in ordinamento crescente in base alla chiave dell'indice. Per recuperare i valori in ordine decrescente, completa questi passaggi:
Annota la chiave di indice con
DESC. Ad esempio:CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);L'annotazione
DESCsi applica a una singola chiave di indice. Se l'indice include più di una chiave e vuoi che i risultati della query vengano visualizzati in ordine decrescente in base a tutte le chiavi, includi un'annotazioneDESCper ogni chiave.Se la lettura specifica un intervallo di chiavi, assicurati che anche l'intervallo di chiavi sia in ordine decrescente. In altre parole, il valore della chiave di inizio deve essere maggiore del valore della chiave di fine.
L'esempio seguente mostra come recuperare i valori di AlbumId e
AlbumTitle utilizzando l'indice AlbumsByAlbumTitle:
C++
C#
Vai
Java
Node.js
PHP
Python
Ruby
Crea un indice per le scansioni solo indice
Facoltativamente, puoi utilizzare la clausola STORING (per i database con dialetto GoogleSQL) o la clausola INCLUDE (per i database con dialetto PostgreSQL) per archiviare una copia di una colonna nell'indice. Questo tipo di indice offre vantaggi per le query e le chiamate di lettura che utilizzano l'indice, al costo di utilizzare spazio di archiviazione aggiuntivo:
- Le query SQL che utilizzano l'indice e selezionano le colonne archiviate nella clausola
STORINGoINCLUDEnon richiedono un join aggiuntivo alla tabella di base. - Le chiamate
read()che utilizzano l'indice possono leggere le colonne archiviate dalla clausolaSTORING/INCLUDE.
Ad esempio, supponiamo che tu abbia creato una versione alternativa di AlbumsByAlbumTitle che memorizza una copia della colonna MarketingBudget nell'indice (nota la clausola STORING o INCLUDE in grassetto):
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
Con il vecchio indice AlbumsByAlbumTitle, Spanner deve unire l'indice alla tabella di base, quindi recuperare la colonna dalla tabella di base. Con il nuovo indice AlbumsByAlbumTitle2, Spanner legge la colonna direttamente dall'indice, il che è più efficiente.
Se utilizzi l'interfaccia di lettura anziché SQL, il nuovo indice AlbumsByAlbumTitle2 ti consente anche di leggere direttamente la colonna MarketingBudget:
C++
C#
Vai
Java
Node.js
PHP
Python
Ruby
Modifica un indice
Puoi utilizzare l'istruzione ALTER INDEX per aggiungere altre colonne a un indice esistente o per eliminare colonne. In questo modo, puoi aggiornare l'elenco di colonne definito dalla clausola STORING (database con dialetto GoogleSQL) o dalla clausola INCLUDE (database con dialetto PostgreSQL) quando crei l'indice. Non puoi utilizzare questa istruzione per aggiungere o eliminare colonne dalla chiave di indice. Ad esempio, anziché creare un nuovo indice AlbumsByAlbumTitle2, puoi utilizzare ALTER INDEX per aggiungere una colonna a AlbumsByAlbumTitle, come mostrato nell'esempio seguente:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
Quando aggiungi una nuova colonna a un indice esistente, Spanner utilizza un processo di backfill in background. Durante il backfill, la colonna nell'indice non è leggibile, quindi potresti non ottenere il miglioramento delle prestazioni previsto. Puoi utilizzare il comando gcloud spanner operations per elencare l'operazione a lunga esecuzione e visualizzarne lo stato.
Per saperne di più, consulta l'operazione di descrizione.
Puoi anche utilizzare l'operazione di annullamento per annullare un'operazione in esecuzione.
Al termine del backfill, Spanner aggiunge la colonna all'indice. Man mano che l'indice cresce, le query che lo utilizzano potrebbero rallentare.
L'esempio seguente mostra come eliminare una colonna da un indice:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
Indice dei valori NULL
Per impostazione predefinita, Spanner indicizza i valori NULL. Ad esempio, ricorda la definizione dell'indice SingersByFirstLastName nella tabella Singers:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Tutte le righe di Singers vengono indicizzate anche se FirstName o LastName, o entrambi, sono NULL.
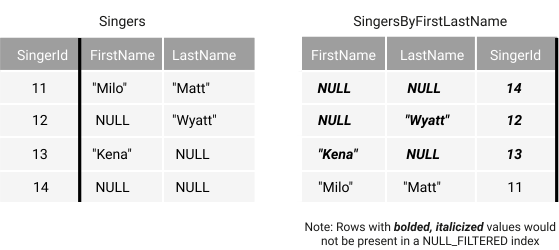
Quando i valori NULL vengono indicizzati, puoi eseguire query SQL e letture efficienti sui dati che includono valori NULL. Ad esempio, utilizza questa istruzione di query SQL per trovare tutti i Singers con un FirstName NULL:
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
Ordinamento per i valori NULL
Spanner ordina NULL come il valore più piccolo per un determinato tipo. Per una colonna in ordine crescente (ASC), i valori NULL vengono ordinati per primi. Per una colonna in ordine decrescente (DESC), i valori NULL vengono ordinati per ultimi.
Disattiva l'indicizzazione dei valori NULL
GoogleSQL
Per disattivare l'indicizzazione dei valori null, aggiungi la parola chiave NULL_FILTERED alla definizione dell'indice. Gli indici NULL_FILTERED sono particolarmente utili per l'indicizzazione di colonne sparse, in cui la maggior parte delle righe contiene un valore NULL. In questi casi, l'indice NULL_FILTERED può essere notevolmente più piccolo e più efficiente da gestire rispetto a un indice normale che include valori NULL.
Ecco una definizione alternativa di SingersByFirstLastName che non indicizza i valori NULL:
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
La parola chiave NULL_FILTERED si applica a tutte le colonne delle chiavi di indice. Non puoi specificare
il filtro NULL per colonna.
PostgreSQL
Per filtrare le righe con valori null in una o più colonne indicizzate, utilizza il predicato WHERE COLUMN IS NOT NULL.
Gli indici con filtro null sono particolarmente utili per l'indicizzazione di colonne sparse, in cui la maggior parte delle righe contiene un valore NULL. In questi casi, l'indice con filtro null può essere notevolmente più piccolo e più efficiente da gestire rispetto a un indice normale che include valori NULL.
Ecco una definizione alternativa di SingersByFirstLastName che non indicizza i valori NULL:
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
Il filtro dei valori NULL impedisce a Spanner di utilizzarlo per alcune query. Ad esempio, Spanner non utilizza l'indice per questa query, perché l'indice omette le righe Singers per le quali LastName è NULL. Di conseguenza, l'utilizzo dell'indice impedirebbe alla query di restituire le righe corrette:
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
Per consentire a Spanner di utilizzare l'indice, devi riscrivere la query in modo che escluda le righe escluse anche dall'indice:
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
Campi proto dell'indice
Utilizza le colonne generate per indicizzare i campi nei buffer di protocollo archiviati nelle colonne PROTO, a condizione che i campi indicizzati utilizzino i tipi di dati primitivi o ENUM.
Se definisci un indice su un campo di un messaggio di protocollo, non puoi modificare o rimuovere quel campo dallo schema proto. Per saperne di più, consulta Aggiornamenti agli schemi che contengono un indice sui campi proto.
Di seguito è riportato un esempio della tabella Singers con una colonna di messaggi proto SingerInfo. Per definire un indice nel campo nationality di PROTO, devi creare una colonna generata archiviata:
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
La definizione del tipo di proto googlesql.example.SingerInfo è la seguente:
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
Poi definisci un indice sul campo nationality del proto:
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
La seguente query SQL legge i dati utilizzando l'indice precedente:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
Note:
- Utilizza una istruzione index per accedere agli indici sui campi delle colonne del buffer di protocollo.
- Non puoi creare un indice su campi di buffer di protocollo ripetuti.
Aggiornamenti agli schemi che contengono un indice sui campi proto
Se definisci un indice su un campo di un messaggio di protocollo, non puoi modificare o rimuovere quel campo dallo schema proto. Questo perché, dopo aver definito l'indice, il controllo del tipo viene eseguito ogni volta che lo schema viene aggiornato. Spanner acquisisce le informazioni sul tipo per tutti i campi nel percorso utilizzati nella definizione dell'indice.
Indici unici
Gli indici possono essere dichiarati UNIQUE. Gli indici UNIQUE aggiungono un vincolo ai dati indicizzati che impedisce voci duplicate per una determinata chiave di indice.
Questo vincolo viene applicato da Spanner al momento del commit della transazione.
In particolare, qualsiasi transazione che causerebbe l'esistenza di più voci di indice per la stessa chiave non verrà eseguita.
Se una tabella contiene dati non UNIQUE, il tentativo di creare un indice UNIQUE non andrà a buon fine.
Una nota sugli indici UNIQUE NULL_FILTERED
Un indice UNIQUE NULL_FILTERED non applica l'unicità della chiave di indice quando almeno una delle parti della chiave dell'indice è NULL.
Ad esempio, supponiamo di aver creato la tabella e l'indice seguenti:
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
Le seguenti due righe in ExampleTable hanno gli stessi valori per le chiavi di indice secondarie Key1, Key2 e Col1:
1, NULL, 1, 1
1, NULL, 2, 1
Poiché Key2 è NULL e l'indice è filtrato per i valori null, le righe non saranno presenti nell'indice ExampleIndex. Poiché non vengono inserite nell'indice, quest'ultimo non le rifiuterà per violazione dell'unicità su (Key1, Key2,
Col1).
Se vuoi che l'indice applichi l'unicità dei valori della tupla (Key1,
Key2, Col1), devi annotare Key2 con NOT NULL nella definizione della tabella
o creare l'indice senza filtrare i valori null.
Crea un indice basato su un'espressione scalare
Un indice di espressione consente di creare un indice basato su un'espressione scalare che si applica a una o più colonne della tabella. Questo è utile perché elimina la necessità di creare e gestire una colonna generata dedicata nella tabella solo per l'indicizzazione.
Gli indici sulle colonne generate e gli indici delle espressioni possono essere utili per indicizzare campi specifici all'interno di una colonna JSON. Puoi creare un indice su un valore estratto da un oggetto JSON, in modo che l'ottimizzatore delle query possa eseguire ricerche in modo efficiente in base a quel valore.
In questo esempio, una colonna generata denominata VenueCity, basata sul campo city all'interno del JSON, viene creata al solo scopo di inserirla in un indice:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
Per farlo in modo più efficiente, puoi definire l'indice direttamente e Spanner gestisce il meccanismo sottostante in modo implicito:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
In entrambi i casi, la query può utilizzare l'indice VenuesByCity per un'esecuzione più rapida:
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
Gli indici di espressione possono avere colonne che sono una combinazione di espressioni e riferimenti diretti alle colonne. In questo modo, più query possono utilizzare l'indice per un'esecuzione più rapida.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
Elimina un indice
Utilizza l'istruzione DROP INDEX per eliminare un indice secondario dallo schema.
Per eliminare l'indice denominato SingersByFirstLastName:
DROP INDEX SingersByFirstLastName;
Indicizza per una scansione più rapida
Quando Spanner deve eseguire una scansione della tabella (anziché una ricerca indicizzata) per recuperare i valori da una o più colonne, puoi ricevere risultati più rapidi se esiste un indice per queste colonne e nell'ordine specificato dalla query. Se esegui spesso query che richiedono scansioni, valuta la possibilità di creare indici secondari per contribuire a rendere queste scansioni più efficienti.
In particolare, se hai bisogno che Spanner esegua spesso la scansione della chiave primaria o di un altro indice di una tabella in ordine inverso, puoi aumentarne l'efficienza tramite un indice secondario che rende esplicito l'ordine scelto.
Ad esempio, la seguente query restituisce sempre un risultato rapido, anche se Spanner deve eseguire la scansione di Songs per trovare il valore più basso di SongId:
SELECT SongId FROM Songs LIMIT 1;
SongId è la chiave primaria della tabella, memorizzata (come per tutte le chiavi primarie) in ordine crescente. Spanner può scansionare l'indice della chiave e trovare rapidamente il primo risultato.
Tuttavia, senza l'aiuto di un indice secondario, la seguente query non restituirebbe i risultati così rapidamente, soprattutto se Songs contiene molti dati:
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
Anche se SongId è la chiave primaria della tabella, Spanner non ha modo di recuperare il valore più alto della colonna senza ricorrere a una scansione completa della tabella.
L'aggiunta del seguente indice consentirebbe a questa query di restituire i risultati più rapidamente:
CREATE INDEX SongIdDesc On Songs(SongId DESC);
Con questo indice, Spanner lo utilizzerà per restituire un risultato per la seconda query molto più rapidamente.
Passaggi successivi
- Scopri le best practice SQL per Spanner.
- Comprendi i piani di esecuzione delle query per Spanner.
- Scopri come risolvere i problemi relativi alle regressioni delle prestazioni nelle query SQL.