


Panoramica
Questa pagina spiega i concetti alla base dei piani di esecuzione delle query e il modo in cui Spanner li utilizza per eseguire query in un ambiente distribuito. Per scoprire come recuperare un piano di esecuzione per una query specifica utilizzando la consoleGoogle Cloud , consulta Scopri come Spanner esegue le query. Puoi anche visualizzare i piani di query storici campionati per confrontare le prestazioni delle query nel tempo. Per scoprire di più, consulta Piani di query campionati.
Spanner utilizza istruzioni SQL dichiarative per eseguire query sui suoi database. Le istruzioni SQL definiscono cosa vuole l'utente senza specificare come ottenere i risultati. Un piano di esecuzione delle query è l'insieme di passaggi per ottenere i risultati. Per una determinata istruzione SQL, potrebbero esserci più modi per ottenere i risultati. Query Optimizer di Spanner valuta diversi piani di esecuzione e sceglie quello più efficiente. Spanner utilizza quindi il piano di esecuzione per recuperare i risultati. I piani di esecuzione supportano i database con dialetto GoogleSQL e PostgreSQL.
Per ulteriori informazioni su Query Optimizer, consulta la panoramica di Query Optimizer.
Concettualmente, un piano di esecuzione è un albero di operatori relazionali. Ogni operatore legge le righe dai suoi input e produce righe di output. Il risultato dell'operatore alla radice dell'esecuzione viene restituito come risultato della query SQL.
Ad esempio, considera la seguente query:
SELECT s.SongName FROM Songs AS s;
Questa query genera un piano di esecuzione della query che può essere visualizzato come:
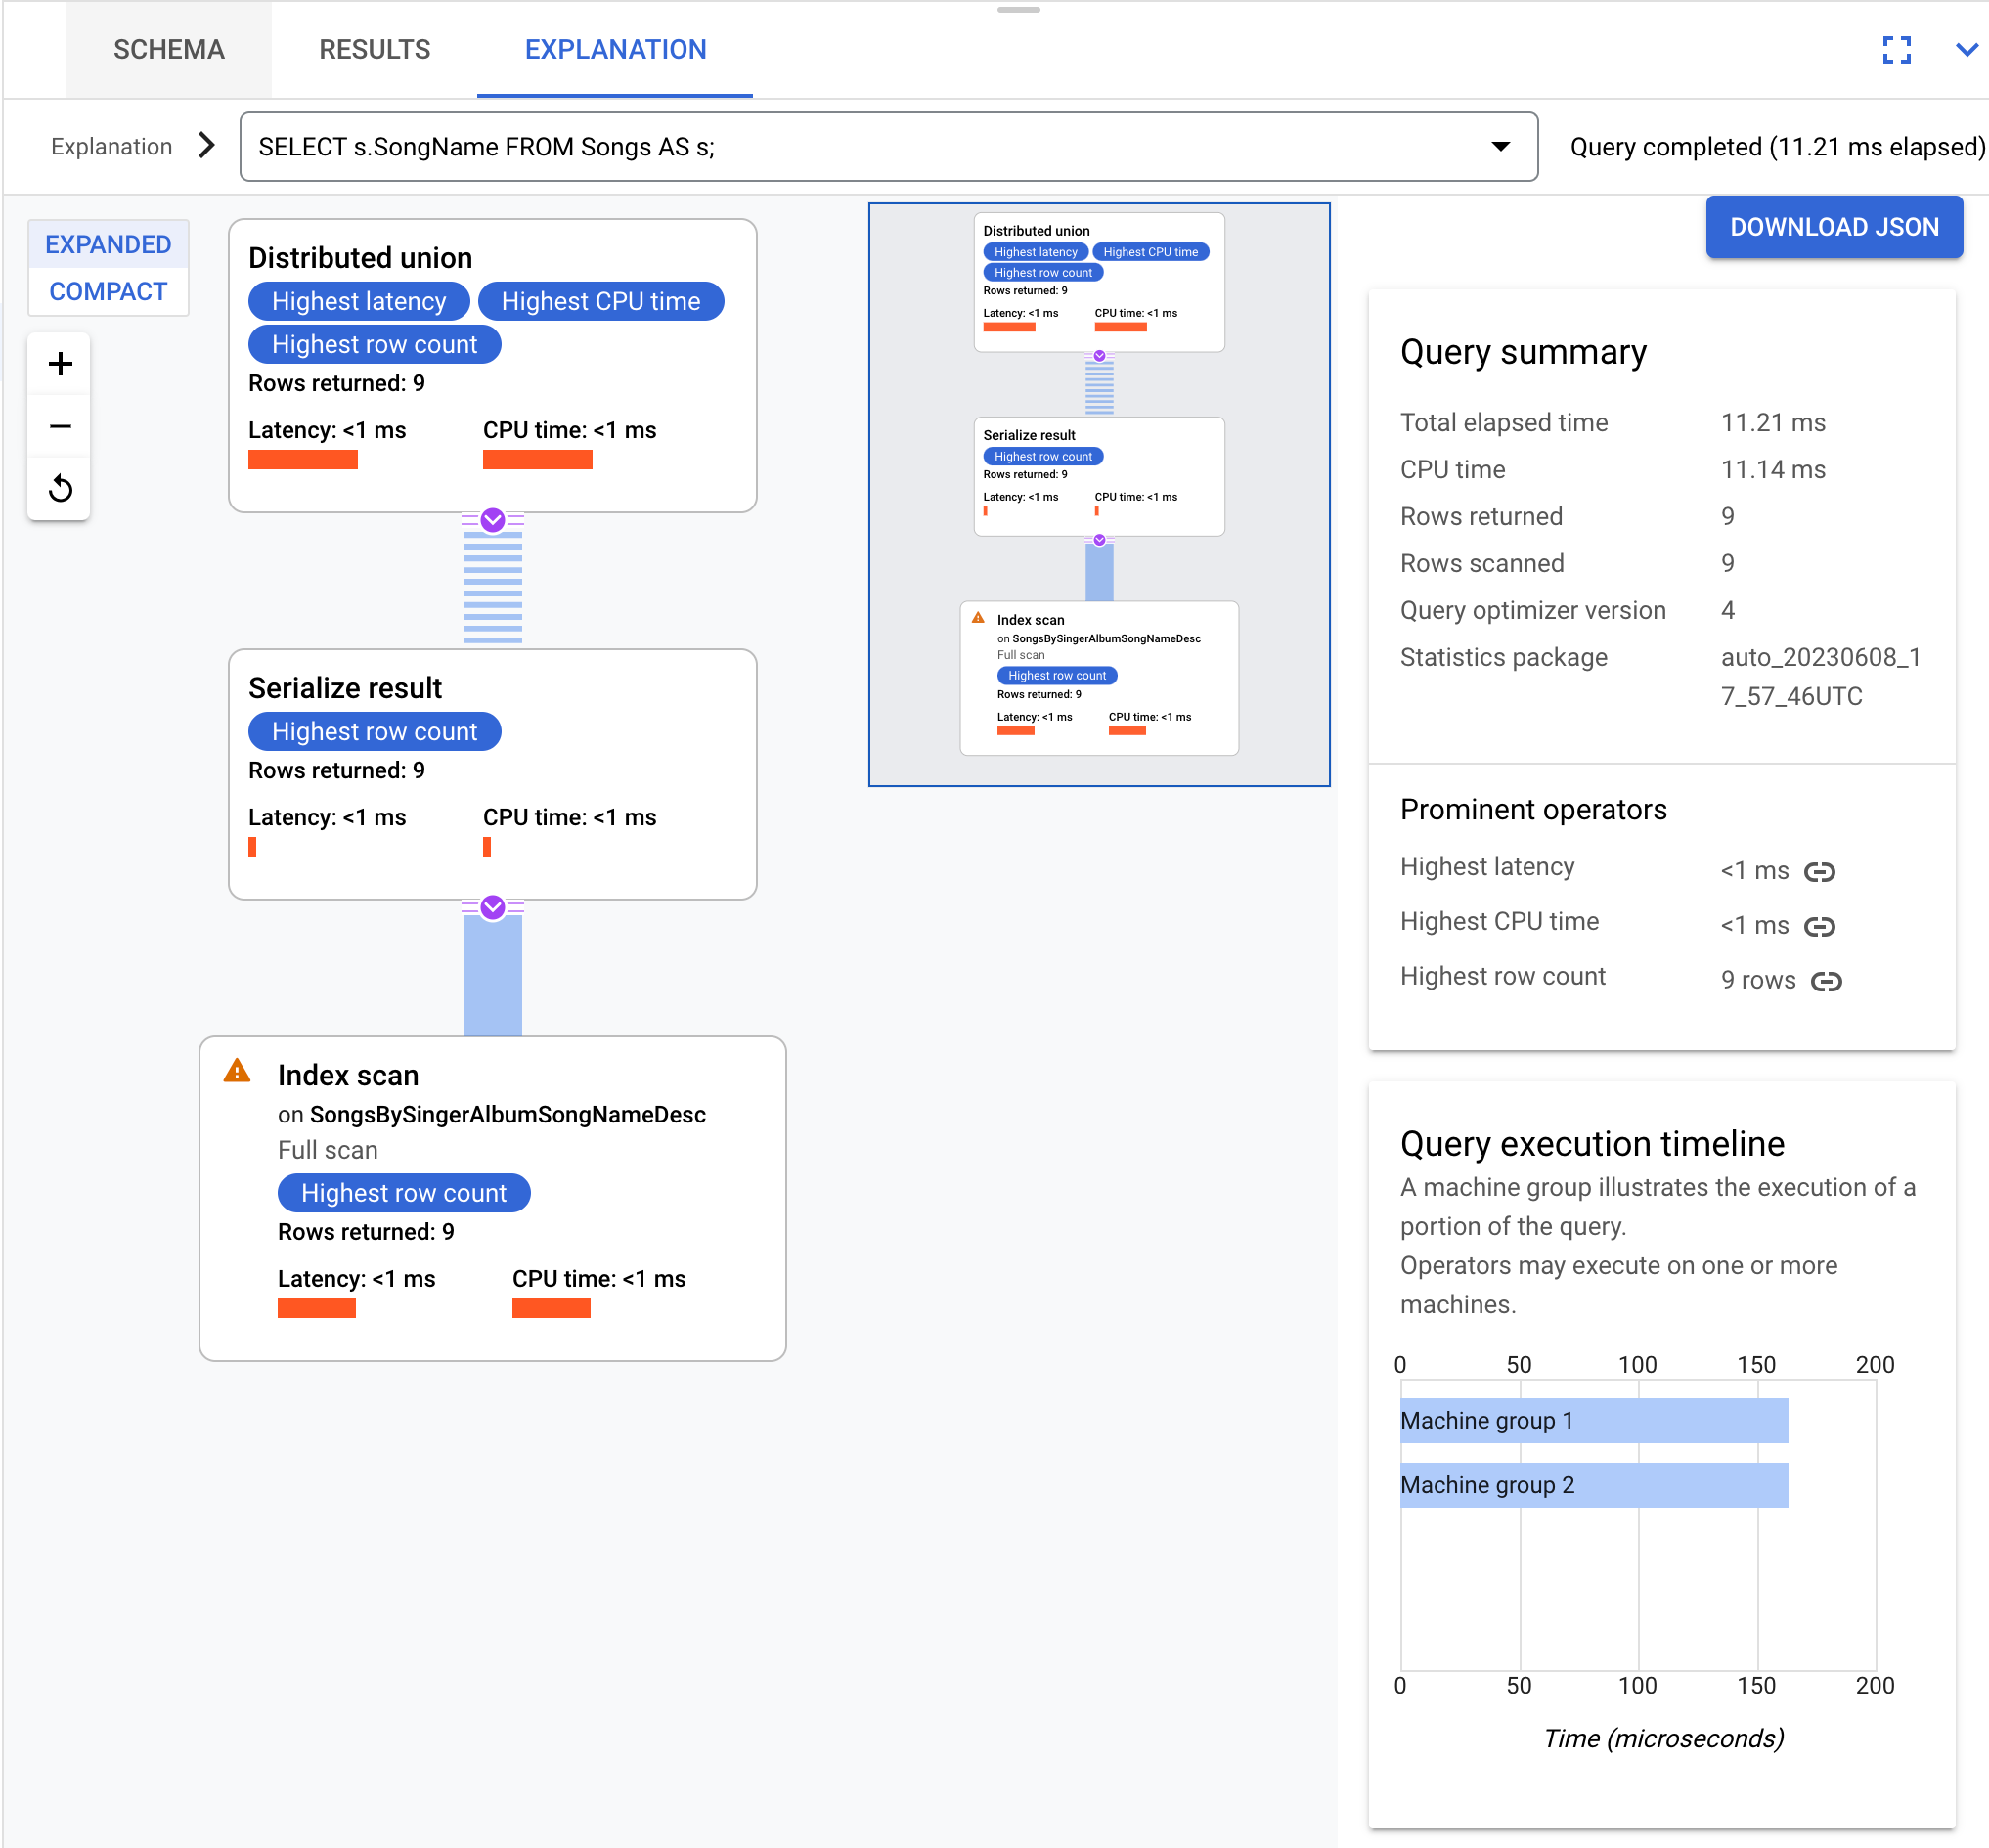
In questo esempio, Spanner esegue il piano di query dall'alto verso il basso e i dati fluiscono dal basso verso l'alto. L'operatore distributed union viene eseguito per primo. Le linee tratteggiate blu indicano che questo operatore può effettuare una chiamata remota. In locale o da remoto, richiama l'operatore serialize result e continua lungo l'albero. Quando l'operatore table scan produce una riga, restituisce immediatamente il controllo all'operatore serialize result. Questo processo continua finché la query non analizza tutte le righe.
Le query e i piani di esecuzione in questa pagina si basano sul seguente schema di database:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Puoi utilizzare le seguenti istruzioni DML (Data Manipulation Language) per aggiungere dati a queste tabelle:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Ottenere piani di esecuzione efficienti è difficile perché Spanner divide i dati in suddivisioni. Le suddivisioni possono spostarsi indipendentemente l'una dall'altra e Spanner può assegnarle a server diversi, che potrebbero trovarsi in posizioni fisiche diverse. Per valutare i piani di esecuzione su dati distribuiti, Spanner esegue le seguenti attività:
- Esegue i subplan localmente sui server che archiviano i dati.
- Orchestra e aggrega più esecuzioni remote con una potatura aggressiva della distribuzione.
Per abilitare questo modello, Spanner utilizza l'operatore distributed union, insieme alle sue varianti distributed cross apply e distributed outer apply.
In che modo Spanner esegue le query
Concettualmente, l'esecuzione delle query avviene dall'alto verso il basso, mentre i risultati delle query vengono visualizzati dal basso verso l'alto. Il seguente diagramma mostra questo pattern:
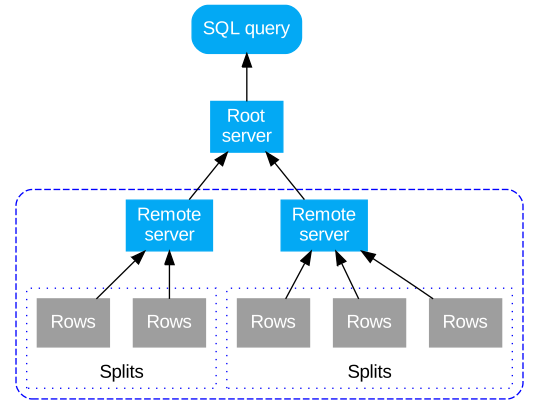
Spanner compila una query SQL in un piano di esecuzione. Per ridurre al minimo il numero di hop ai dati oggetto della query, Spanner sceglie un server principale iniziale e gli invia il piano. Il server root esegue le seguenti azioni:
- Avvia l'esecuzione remota dei sottopiani, se necessario.
- Attende i risultati delle esecuzioni remote.
- Gestisce eventuali passaggi di esecuzione locale rimanenti, ad esempio l'aggregazione dei risultati.
- Restituisce i risultati della query.
Un server remoto che riceve un sottopiano funge da server root per il suo sottopiano, seguendo lo stesso modello del server root di livello più alto. Questo modello di esecuzione genera un albero di esecuzioni remote.
Principali metriche sul rendimento
Il visualizzatore del piano di query di Spanner Studio mostra le metriche di riepilogo per l'esecuzione delle query. Le metriche di riepilogo rappresentano l'aggregazione delle metriche di tutti i singoli operatori eseguiti durante la query. La tabella seguente descrive le metriche sul rendimento principali:
| Metrica | Descrizione |
|---|---|
| Tempo totale trascorso | Il tempo totale impiegato per eseguire la query. |
| Tempo di CPU | La quantità totale di tempo di CPU dedicato su tutti i server coinvolti nell'esecuzione della query. Poiché alcune parti dell'esecuzione della query possono procedere in parallelo, il tempo di CPU potrebbe essere maggiore rispetto al tempo totale trascorso. |
Piani di query campionati
I piani di query campionati di Spanner ti consentono di visualizzare esempi di piani di query storici e di confrontare le prestazioni di una query nel tempo. I piani di query campionati non sono disponibili per tutte le query. Spanner potrebbe campionare solo le query che consumano una quantità significativa di CPU. Spanner conserva i campioni dei piani di query per 30 giorni. Per trovare esempi di piani di query nella pagina Query Insights della consoleGoogle Cloud , consulta Visualizza i piani di query campionati.
L'anatomia di un piano di query campionato è la stessa di un normale piano di esecuzione delle query. Per saperne di più su come comprendere i piani visivi e utilizzarli per eseguire il debug delle query, consulta Panoramica del visualizzatore del piano di query.
Casi d'uso comuni per i piani di query campionati
I casi d'uso comuni per i piani di query campionati includono:
- Osservazione delle modifiche al piano di query dovute a modifiche allo schema (ad esempio, l'aggiunta o la rimozione di un indice).
- Osservazione di modifiche al piano di query a causa di un aggiornamento della versione dell'ottimizzatore.
- Osservazione delle modifiche al piano di query dovute alle nuove statistiche dell'ottimizzatore.
Spanner raccoglie queste statistiche automaticamente ogni tre giorni, oppure puoi aggiornarle manualmente utilizzando il comando
ANALYZE.
Se le prestazioni delle query variano in modo significativo nel tempo o se vuoi migliorarle, consulta le best practice SQL per creare istruzioni di query ottimizzate che aiutino Spanner a trovare piani di esecuzione efficienti.
Pattern comuni
I seguenti esempi illustrano i pattern comuni nei piani di esecuzione di Spanner.
Query di aggregazione
Una query aggregata implementa la logica GROUP BY.
Ad esempio, la seguente query calcola il numero di canzoni per cantante:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
Ecco i risultati:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
Concettualmente, questo è il piano di esecuzione:
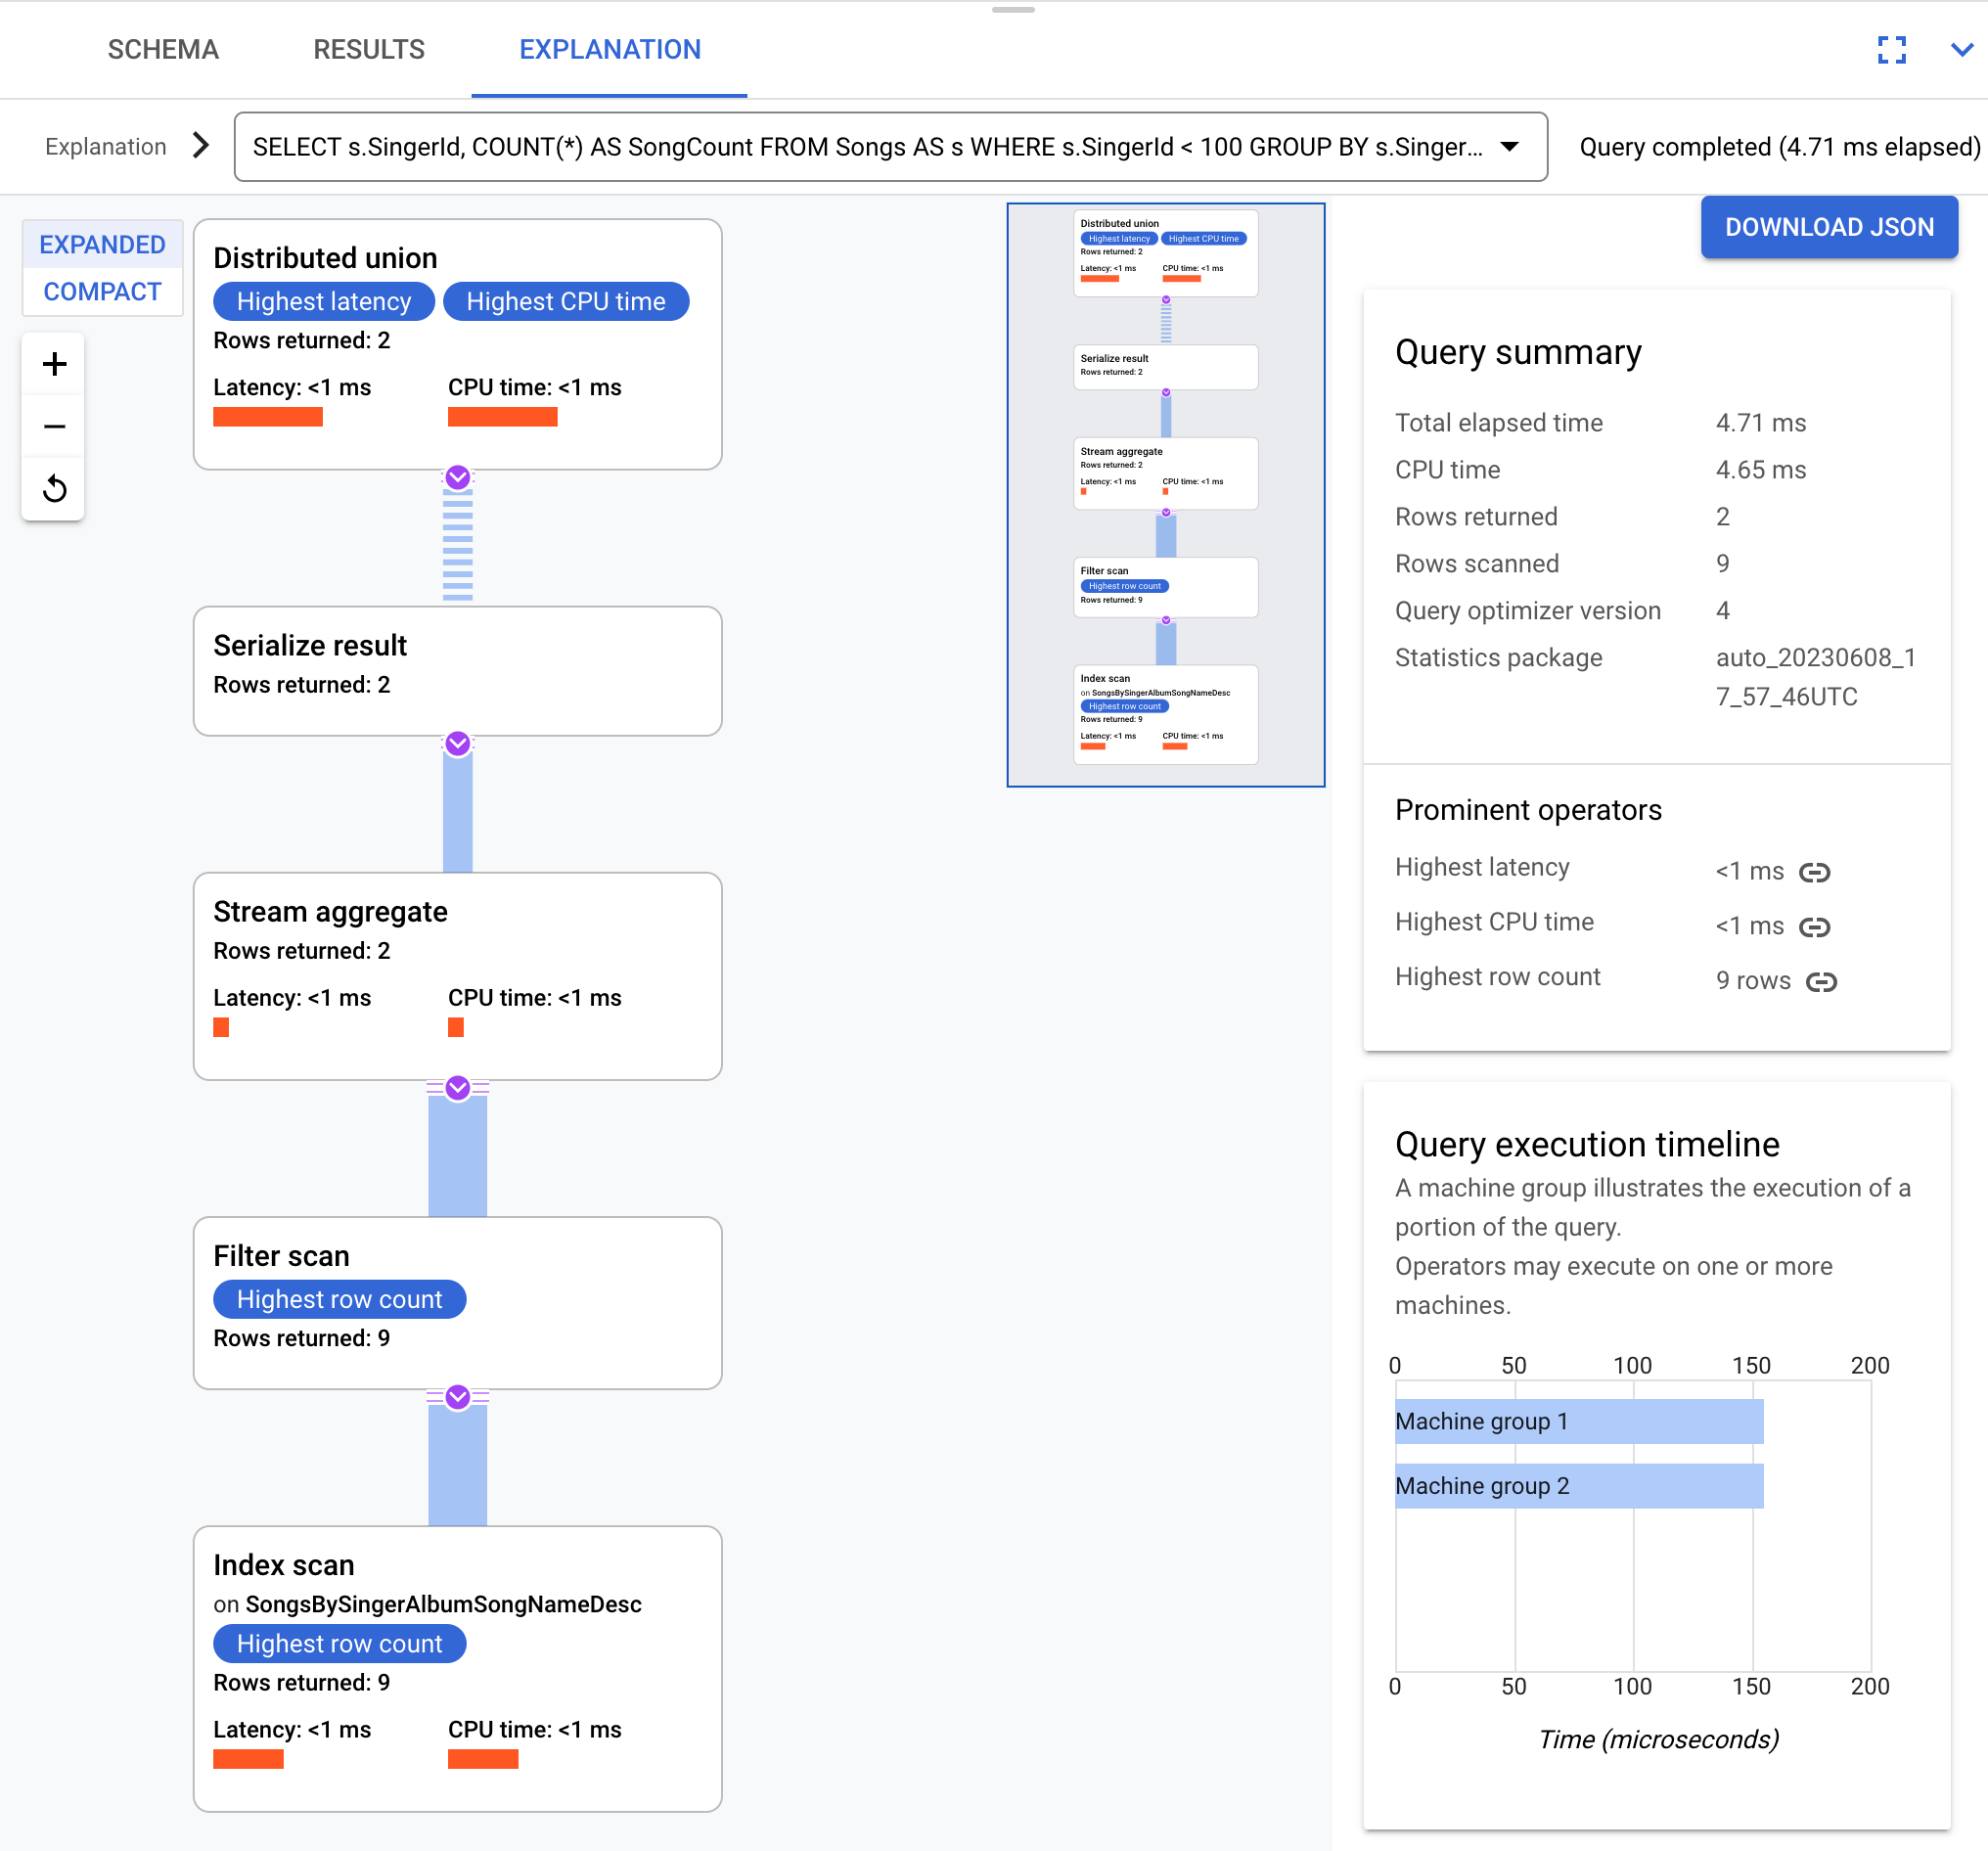
Spanner invia il piano di esecuzione a un server root che coordina l'esecuzione della query e distribuisce i sottopiani da remoto.
Questo piano di esecuzione inizia con un operatore distributed union che distribuisce i sottopiani ai server remoti le cui suddivisioni soddisfano SingerId < 100. Al termine della scansione delle singole suddivisioni, l'operatore stream aggregate aggrega le righe per ottenere i conteggi per ogni SingerId. L'operatore serialize result quindi serializza il risultato. Infine, distributed union combina tutti i risultati e restituisce i risultati della query.
Per saperne di più sulle aggregazioni, consulta Operatori di aggregazione.
Query di join collocate
Nelle tabelle interleaved, Spanner archivia fisicamente le righe correlate insieme. Un join in co-location è un join tra tabelle con interleaving. Le join collocate possono migliorare le prestazioni rispetto alle join che richiedono indici o alle join di ritorno.
Ad esempio, considera la seguente query:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
Questa query presuppone che Songs sia con interleaving in Albums.
Ecco i risultati:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
Questo è il piano di esecuzione:
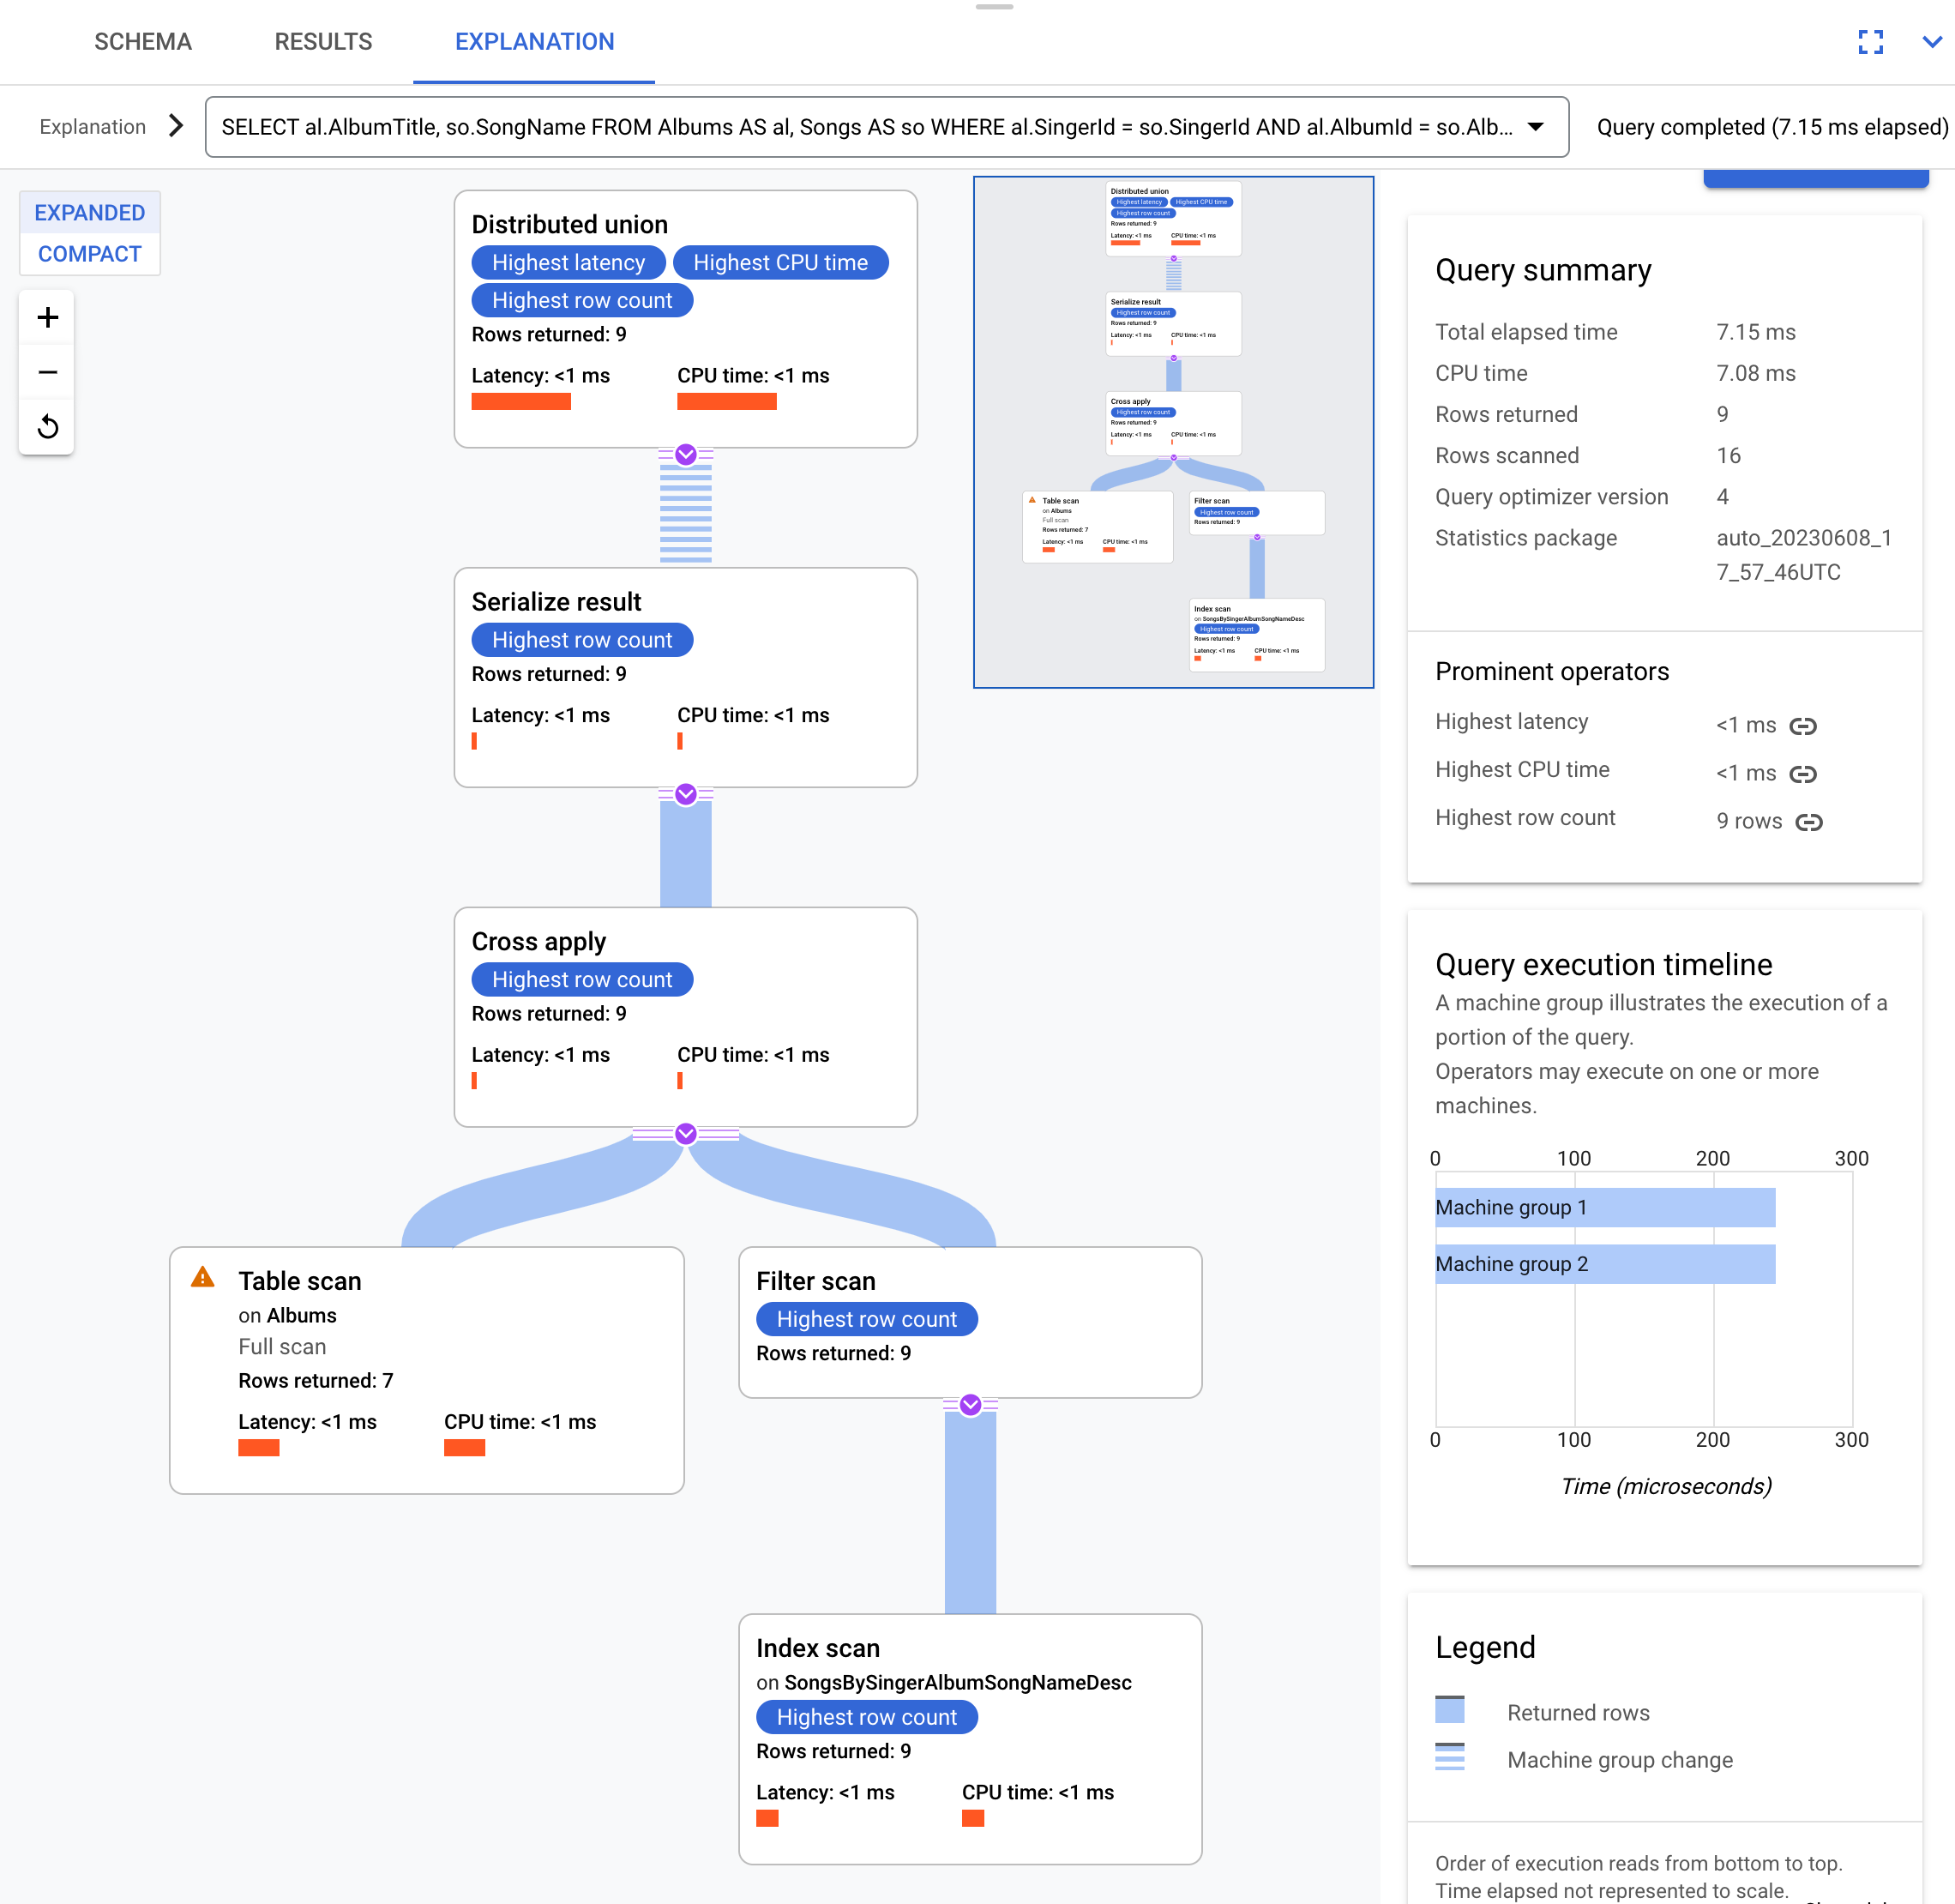
Questo piano di esecuzione inizia con un operatore distributed union che distribuisce i sottopiani ai server remoti, che contengono le suddivisioni della tabella Albums. Poiché Songs è intercalato in Albums, ogni server remoto esegue l'intero sottopiano localmente senza eseguire un join tra server diversi.
I sottopiani contengono un operatore cross apply. Ogni operatore cross apply esegue un'operazione table scan sulla tabella Albums per recuperare SingerId, AlbumId e AlbumTitle. L'operatore cross apply mappa quindi l'output della scansione della tabella
all'output di una scansione dell'indice SongsBySingerAlbumSongNameDesc.
Questo indice è soggetto a un filtro, che richiede che il SingerId nell'indice corrisponda al SingerId dell'output della scansione della tabella. Ogni operatore cross apply invia i propri risultati a un operatore serialize result, che serializza i dati AlbumTitle e SongName e restituisce i risultati alle unioni distribuite locali. L'unione distribuita aggrega i risultati delle unioni distribuite locali e li restituisce come risultato della query.
Query di indice e back join
L'esempio precedente utilizza un join su due tabelle, in cui una tabella è intercalata nell'altra. Se due tabelle o una tabella e un indice non sono intercalati, i piani di esecuzione sono più complessi e meno efficienti.
Considera un indice creato con il seguente comando:
CREATE INDEX SongsBySongName ON Songs(SongName);
Per utilizzare questo indice in una query, seleziona una delle seguenti opzioni di dialetto del database:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Ecco i risultati:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
Questo è il piano di esecuzione:
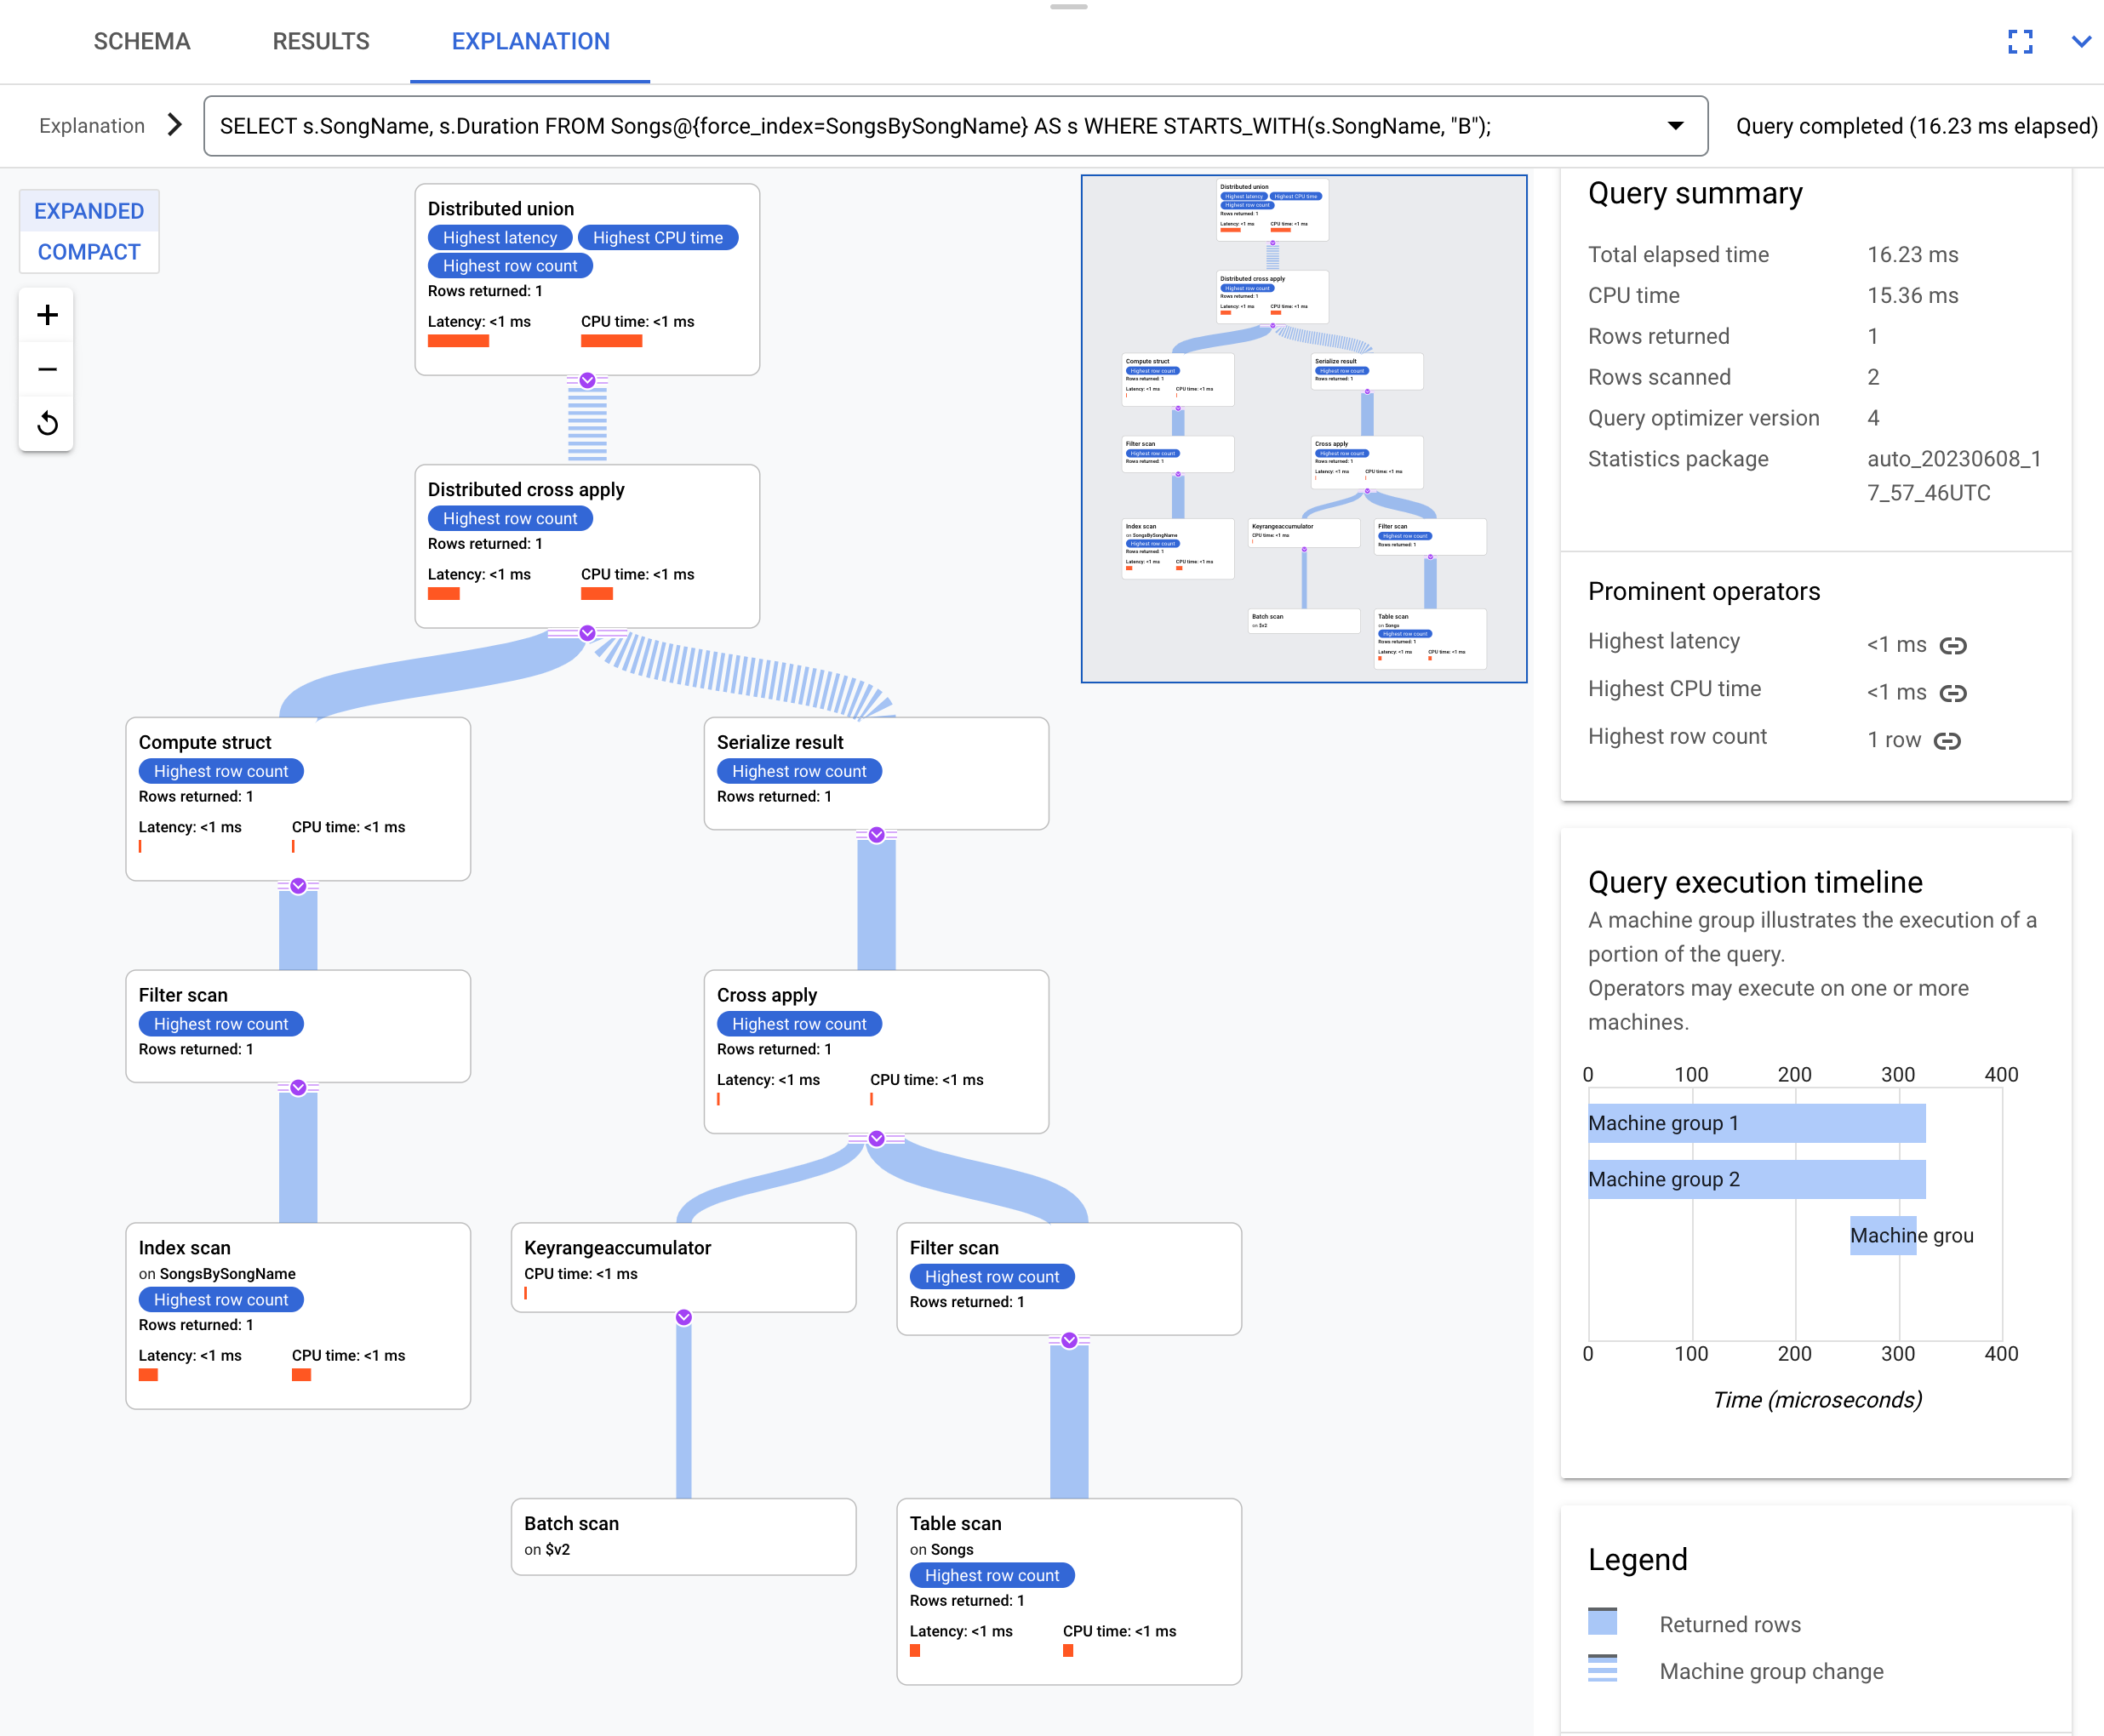
Il piano di esecuzione risultante è complesso perché l'indice SongsBySongName non contiene la colonna Duration. Per ottenere il valore Duration,
Spanner esegue il back join dei risultati indicizzati alla tabella Songs. Si tratta di un join, ma non è in co-location perché la tabella Songs e l'indice globale SongsBySongName non sono con interleaving. Se i dati non sono collocati, Spanner esegue ottimizzazioni per velocizzare l'esecuzione. Queste ottimizzazioni rendono il piano di esecuzione più complesso rispetto
all'esempio precedente di join in co-location.
L'operatore principale è distributed cross apply. Il lato di input di questo operatore riceve batch di righe dall'indice SongsBySongName che soddisfano il predicato STARTS_WITH(s.SongName, "B"). L'operatore distributed cross apply mappa quindi questi batch ai server remoti che contengono suddivisioni con i dati Duration. Per recuperare la colonna Duration, i server remoti eseguono una scansione della tabella. Questa scansione utilizza la condizione di filtro Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId), che unisce TrackId della tabella Songs alle colonne TrackId delle righe raggruppate dall'indice SongsBySongName.
Spanner aggrega i risultati nella risposta finale alla query.
A sua volta, il lato di input dell'operatore distributed cross apply contiene una coppia distributed union o local distributed union per valutare le righe dell'indice che soddisfano il predicato STARTS_WITH.
Considera una query leggermente diversa che non seleziona la colonna s.Duration:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Il seguente piano di esecuzione mostra che questa query utilizza completamente l'indice:
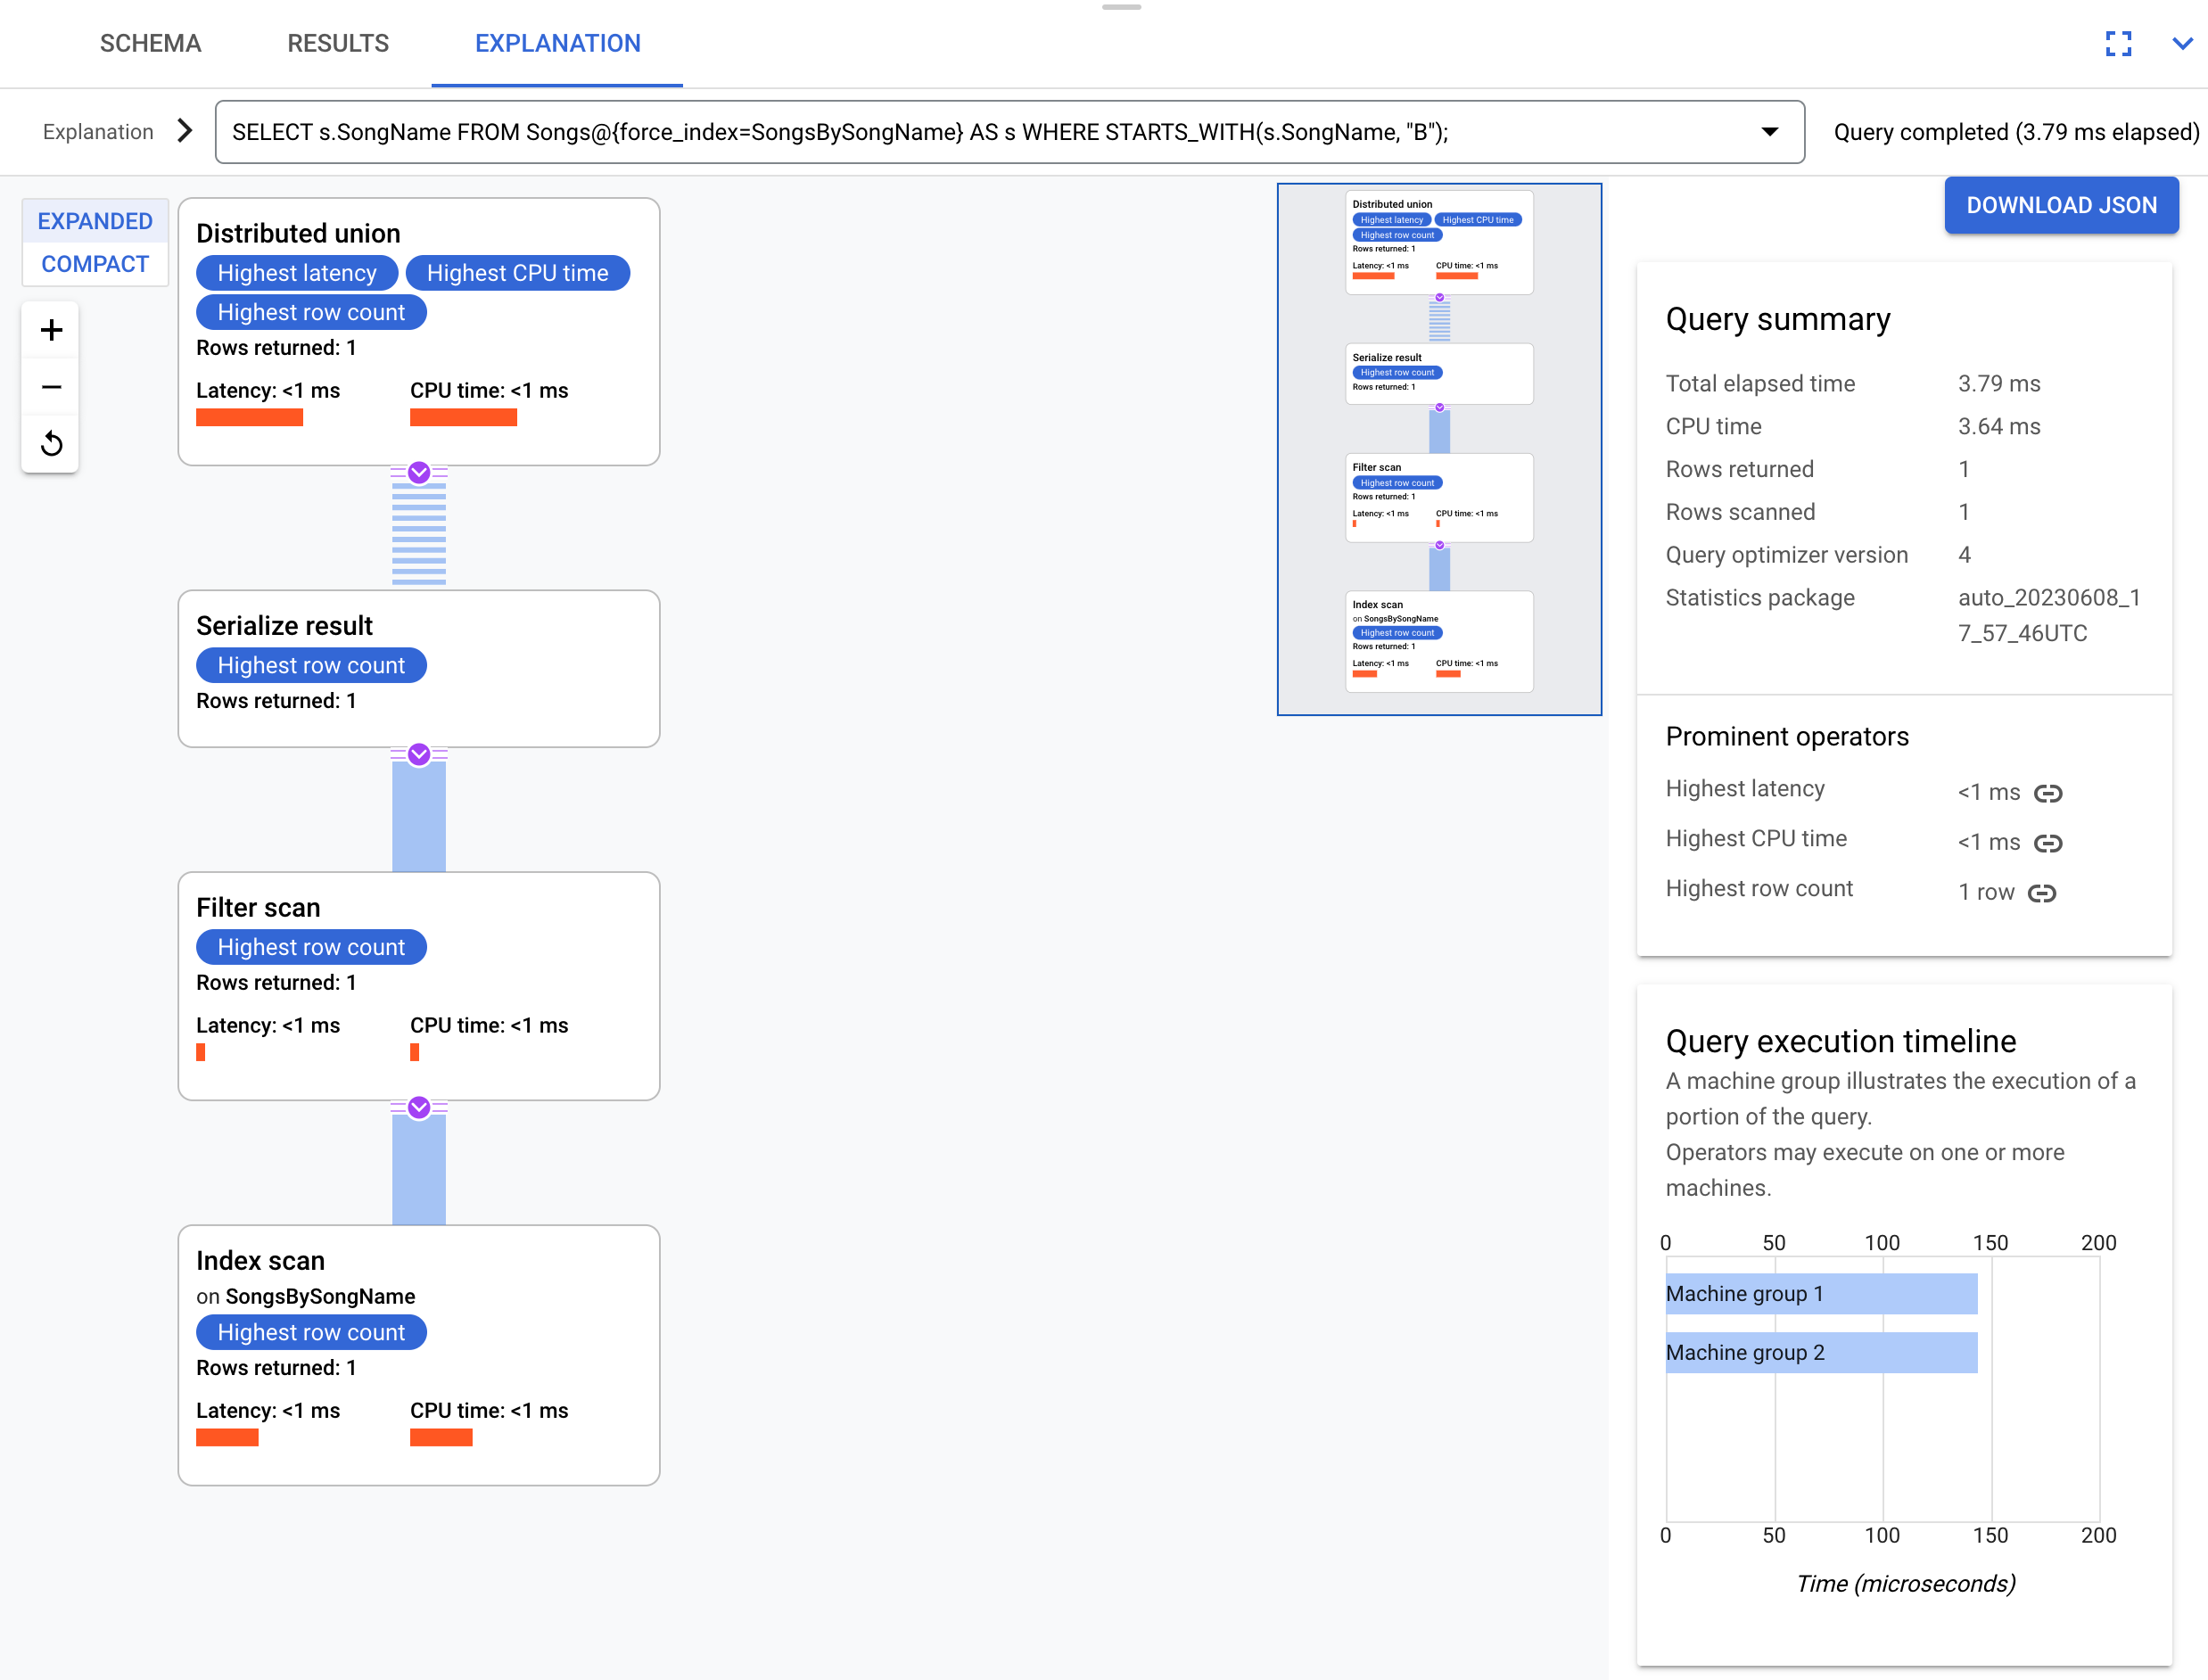
Il piano di esecuzione non richiede un back join perché l'indice contiene tutte le colonne richieste dalla query.
Scansione sequenziale e ricerche sparse
La lettura di un intervallo contiguo di righe è molto più veloce della lettura dello stesso numero di righe sparse.
Ad esempio, la seguente query somma la durata dei brani di un insieme specificato di cantanti. Questa query esegue ricerche per ogni ID cantante specificato. Per vedere quante ricerche ha eseguito la query, consulta la statistica Conteggio Seek.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
Tuttavia, se strutturi la query in modo da leggere una sequenza contigua di ID cantante, puoi migliorare le prestazioni eseguendo una lettura sequenziale della tabella Songs. La tabella Songs contiene SingerId come parte della chiave primaria.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
Questa differenza è importante quando scegli un metodo di join e quando prendi decisioni di progettazione dello schema, ad esempio la scelta di una chiave primaria. Per saperne di più sulla scelta di un metodo di join, consulta Come i join interagiscono con le scansioni.
Condivisione di unioni distribuite
Ogni tabella o indice in una query deve avere un operatore distribuito corrispondente.
Questo operatore è distributed union o distributed apply. Se due tabelle o indici sono intercalati nello stesso elemento principale, l'ottimizzatore delle query potrebbe utilizzare un singolo operatore distributed union per entrambe le tabelle o gli indici.
Passaggi successivi
- Scopri di più sugli operatori di esecuzione delle query.
- Scopri di più su Query Optimizer di Spanner.
- Scopri come gestire l'ottimizzatore delle query.