


Présentation
Cette page explique les concepts des plans d'exécution de requêtes et comment Spanner les utilise pour exécuter des requêtes dans un environnement distribué. Pour savoir comment récupérer un plan d'exécution pour une requête spécifique à l'aide de la consoleGoogle Cloud , consultez Comprendre comment Spanner exécute les requêtes. Vous pouvez également afficher des échantillons de plans de requête historiques pour comparer les performances des requêtes au fil du temps. Pour en savoir plus, consultez Plans de requête échantillonnés.
Spanner utilise des instructions SQL déclaratives pour interroger ses bases de données. Les instructions SQL définissent ce que l'utilisateur souhaite sans spécifier comment obtenir les résultats. Un plan d'exécution de requêtes réunit l'ensemble des étapes permettant de définir ce "comment". Pour une instruction SQL donnée, les résultats peuvent être obtenus de plusieurs façons. L'optimiseur de requêtes Spanner évalue différents plans d'exécution et choisit le plus efficace. Spanner utilise ensuite le plan d'exécution pour récupérer les résultats. Les plans d'exécution sont compatibles avec les bases de données utilisant les dialectes GoogleSQL et PostgreSQL.
Pour en savoir plus sur l'optimiseur de requêtes, consultez Présentation de l'optimiseur de requêtes.
Conceptuellement, un plan d'exécution correspond à une arborescence d'opérateurs relationnels. Chaque opérateur lit les lignes de ses entrées et produit des lignes de sortie. Le résultat de l'opérateur situé à la racine de l'exécution est renvoyé en tant que résultat de la requête SQL.
Prenons l'exemple de la requête suivante :
SELECT s.SongName FROM Songs AS s;
Cette requête génère un plan d'exécution de requête qui peut être visualisé comme suit :
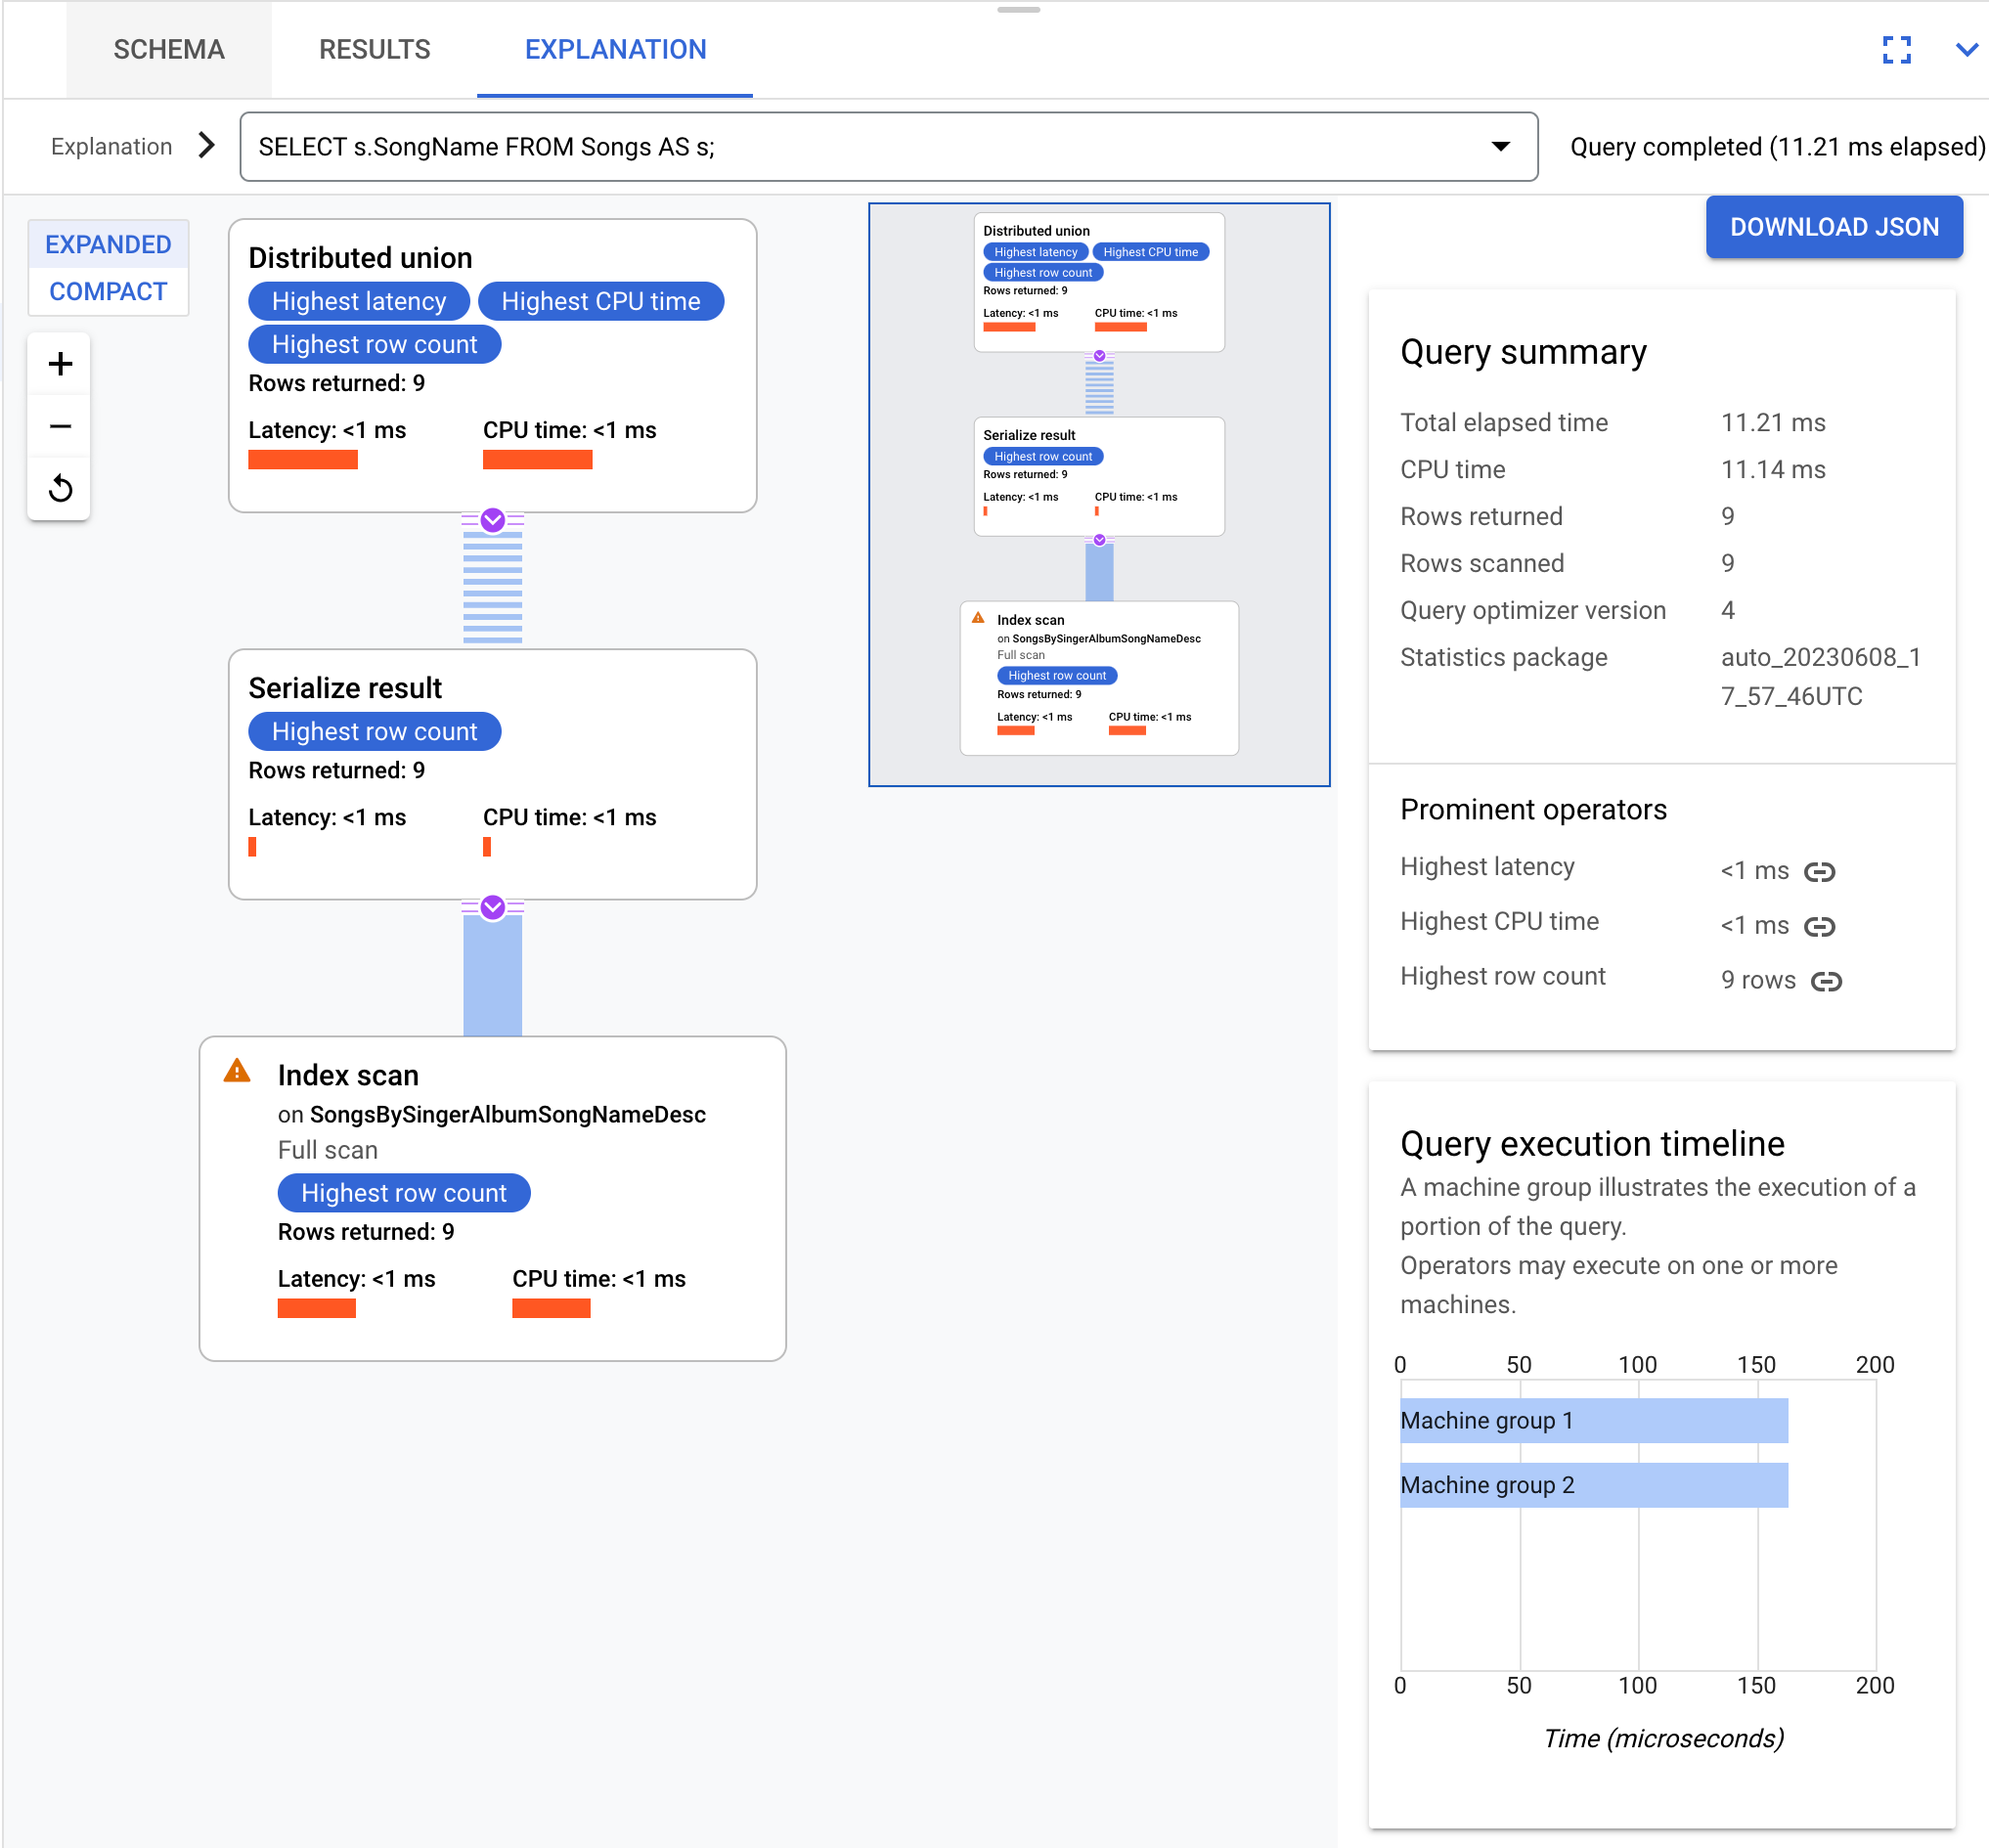
Dans cet exemple, Spanner exécute le plan de requête de haut en bas, et les données circulent de bas en haut. L'opérateur distributed union s'exécute en premier. Les lignes bleues en pointillés indiquent que cet opérateur peut effectuer un appel à distance. Que ce soit localement ou à distance, il appelle l'opérateur serialize result et continue de descendre dans l'arborescence. Lorsque l'opérateur table scan produit une ligne, il renvoie immédiatement le contrôle à l'opérateur serialize result. Ce processus se poursuit jusqu'à ce que la requête analyse toutes les lignes.
Les requêtes et les plans d'exécution de cette page sont basés sur le schéma de base de données suivant :
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Vous pouvez utiliser les instructions LMD (langage de manipulation de données) suivantes pour ajouter des données à ces tables :
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Il est difficile d'obtenir des plans d'exécution efficaces, car Spanner divise les données en divisions. Les divisions peuvent se déplacer indépendamment les unes des autres, et Spanner peut les attribuer à différents serveurs, qui peuvent se trouver dans des emplacements physiques différents. Pour évaluer les plans d'exécution sur des données distribuées, Spanner effectue les tâches suivantes :
- Exécute des sous-plans localement sur les serveurs qui stockent les données.
- Orchestre et agrège plusieurs exécutions à distance avec un élagage agressif de la distribution.
Pour activer ce modèle, Spanner utilise l'opérateur distributed union, ainsi que ses variantes distributed cross apply et distributed outer apply.
Comment Spanner exécute les requêtes
Sur le plan conceptuel, l'exécution de la requête se fait de haut en bas, et les résultats de la requête sont renvoyés de bas en haut. Le diagramme suivant illustre ce schéma :
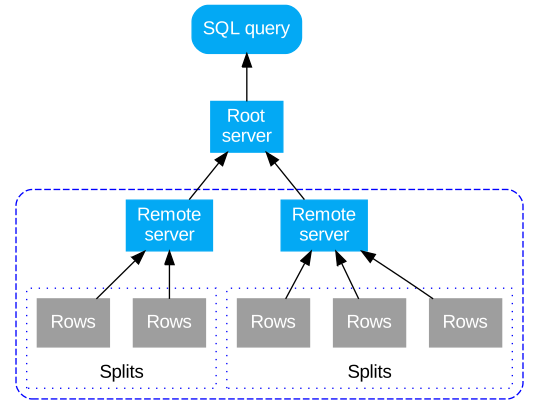
Spanner compile une requête SQL dans un plan d'exécution. Pour réduire le nombre de sauts nécessaires pour atteindre les données interrogées, Spanner choisit un serveur racine initial et lui envoie le plan. Le serveur racine effectue les actions suivantes :
- lance l'exécution à distance des sous-plans, si nécessaire ;
- attend les résultats des exécutions à distance ;
- gère toutes les étapes d'exécution locales restantes, telles que l'agrégation des résultats ;
- Renvoie les résultats de la requête.
Un serveur distant qui reçoit un sous-plan agit comme serveur racine de ce sous-plan, et suit le même modèle que le serveur racine initial. Ce modèle d'exécution génère une arborescence d'exécutions à distance.
Métriques de performances clés
Le visualiseur de plan de requête de Spanner Studio affiche des métriques récapitulatives pour l'exécution de la requête. Les métriques récapitulatives représentent l'agrégation des métriques de tous les opérateurs individuels exécutés pendant la requête. Le tableau suivant décrit les principales métriques de performances :
| Métrique | Description |
|---|---|
| Temps total écoulé | Temps réel total nécessaire pour exécuter la requête. |
| Temps CPU | Temps CPU total utilisé sur tous les serveurs impliqués dans l'exécution de la requête. Certaines parties de l'exécution d'une requête peuvent avoir lieu en parallèle. Il est donc possible que le temps CPU soit supérieur à la durée totale écoulée. |
Plans de requête échantillonnés
Les exemples de plans de requête Spanner vous permettent d'afficher des exemples de plans de requête historiques et de comparer les performances d'une requête au fil du temps. Les plans de requête échantillonnés ne sont pas disponibles pour toutes les requêtes. Spanner peut n'échantillonner que les requêtes qui consomment beaucoup de ressources processeur. Spanner conserve les échantillons de plans de requête pendant 30 jours. Pour trouver des exemples de plans de requête sur la page Insights sur les requêtes de la consoleGoogle Cloud , consultez Afficher des exemples de plans de requête.
L'anatomie d'un plan de requête échantillonné est identique à celle d'un plan d'exécution de requête standard. Pour en savoir plus sur la compréhension des plans visuels et leur utilisation pour déboguer vos requêtes, consultez Présentation du visualiseur de plan de requête.
Cas d'utilisation courants des plans de requête échantillonnés
Voici quelques cas d'utilisation courants des plans de requête échantillonnés :
- Observer les modifications du plan de requête en raison de modifications de schéma (par exemple, l'ajout ou la suppression d'un index).
- Observer les modifications du plan de requête en raison d'une mise à jour de la version de l'optimiseur.
- Observer les modifications du plan de requête en raison de nouvelles statistiques de l'optimiseur.
Spanner collecte ces statistiques automatiquement tous les trois jours, ou vous pouvez les mettre à jour manuellement à l'aide de la commande
ANALYZE.
Si les performances des requêtes varient considérablement au fil du temps ou si vous souhaitez les améliorer, consultez les bonnes pratiques SQL pour créer des instructions de requête optimisées qui aident Spanner à trouver des plans d'exécution efficaces.
Schémas courants
Les exemples suivants illustrent des modèles courants dans les plans d'exécution Spanner.
Requêtes d'agrégation
Une requête d'agrégation implémente la logique GROUP BY.
Par exemple, la requête suivante calcule le nombre de chansons par chanteur :
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
Vous obtenez les résultats suivants :
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
Sur le plan conceptuel, voici le plan d'exécution :
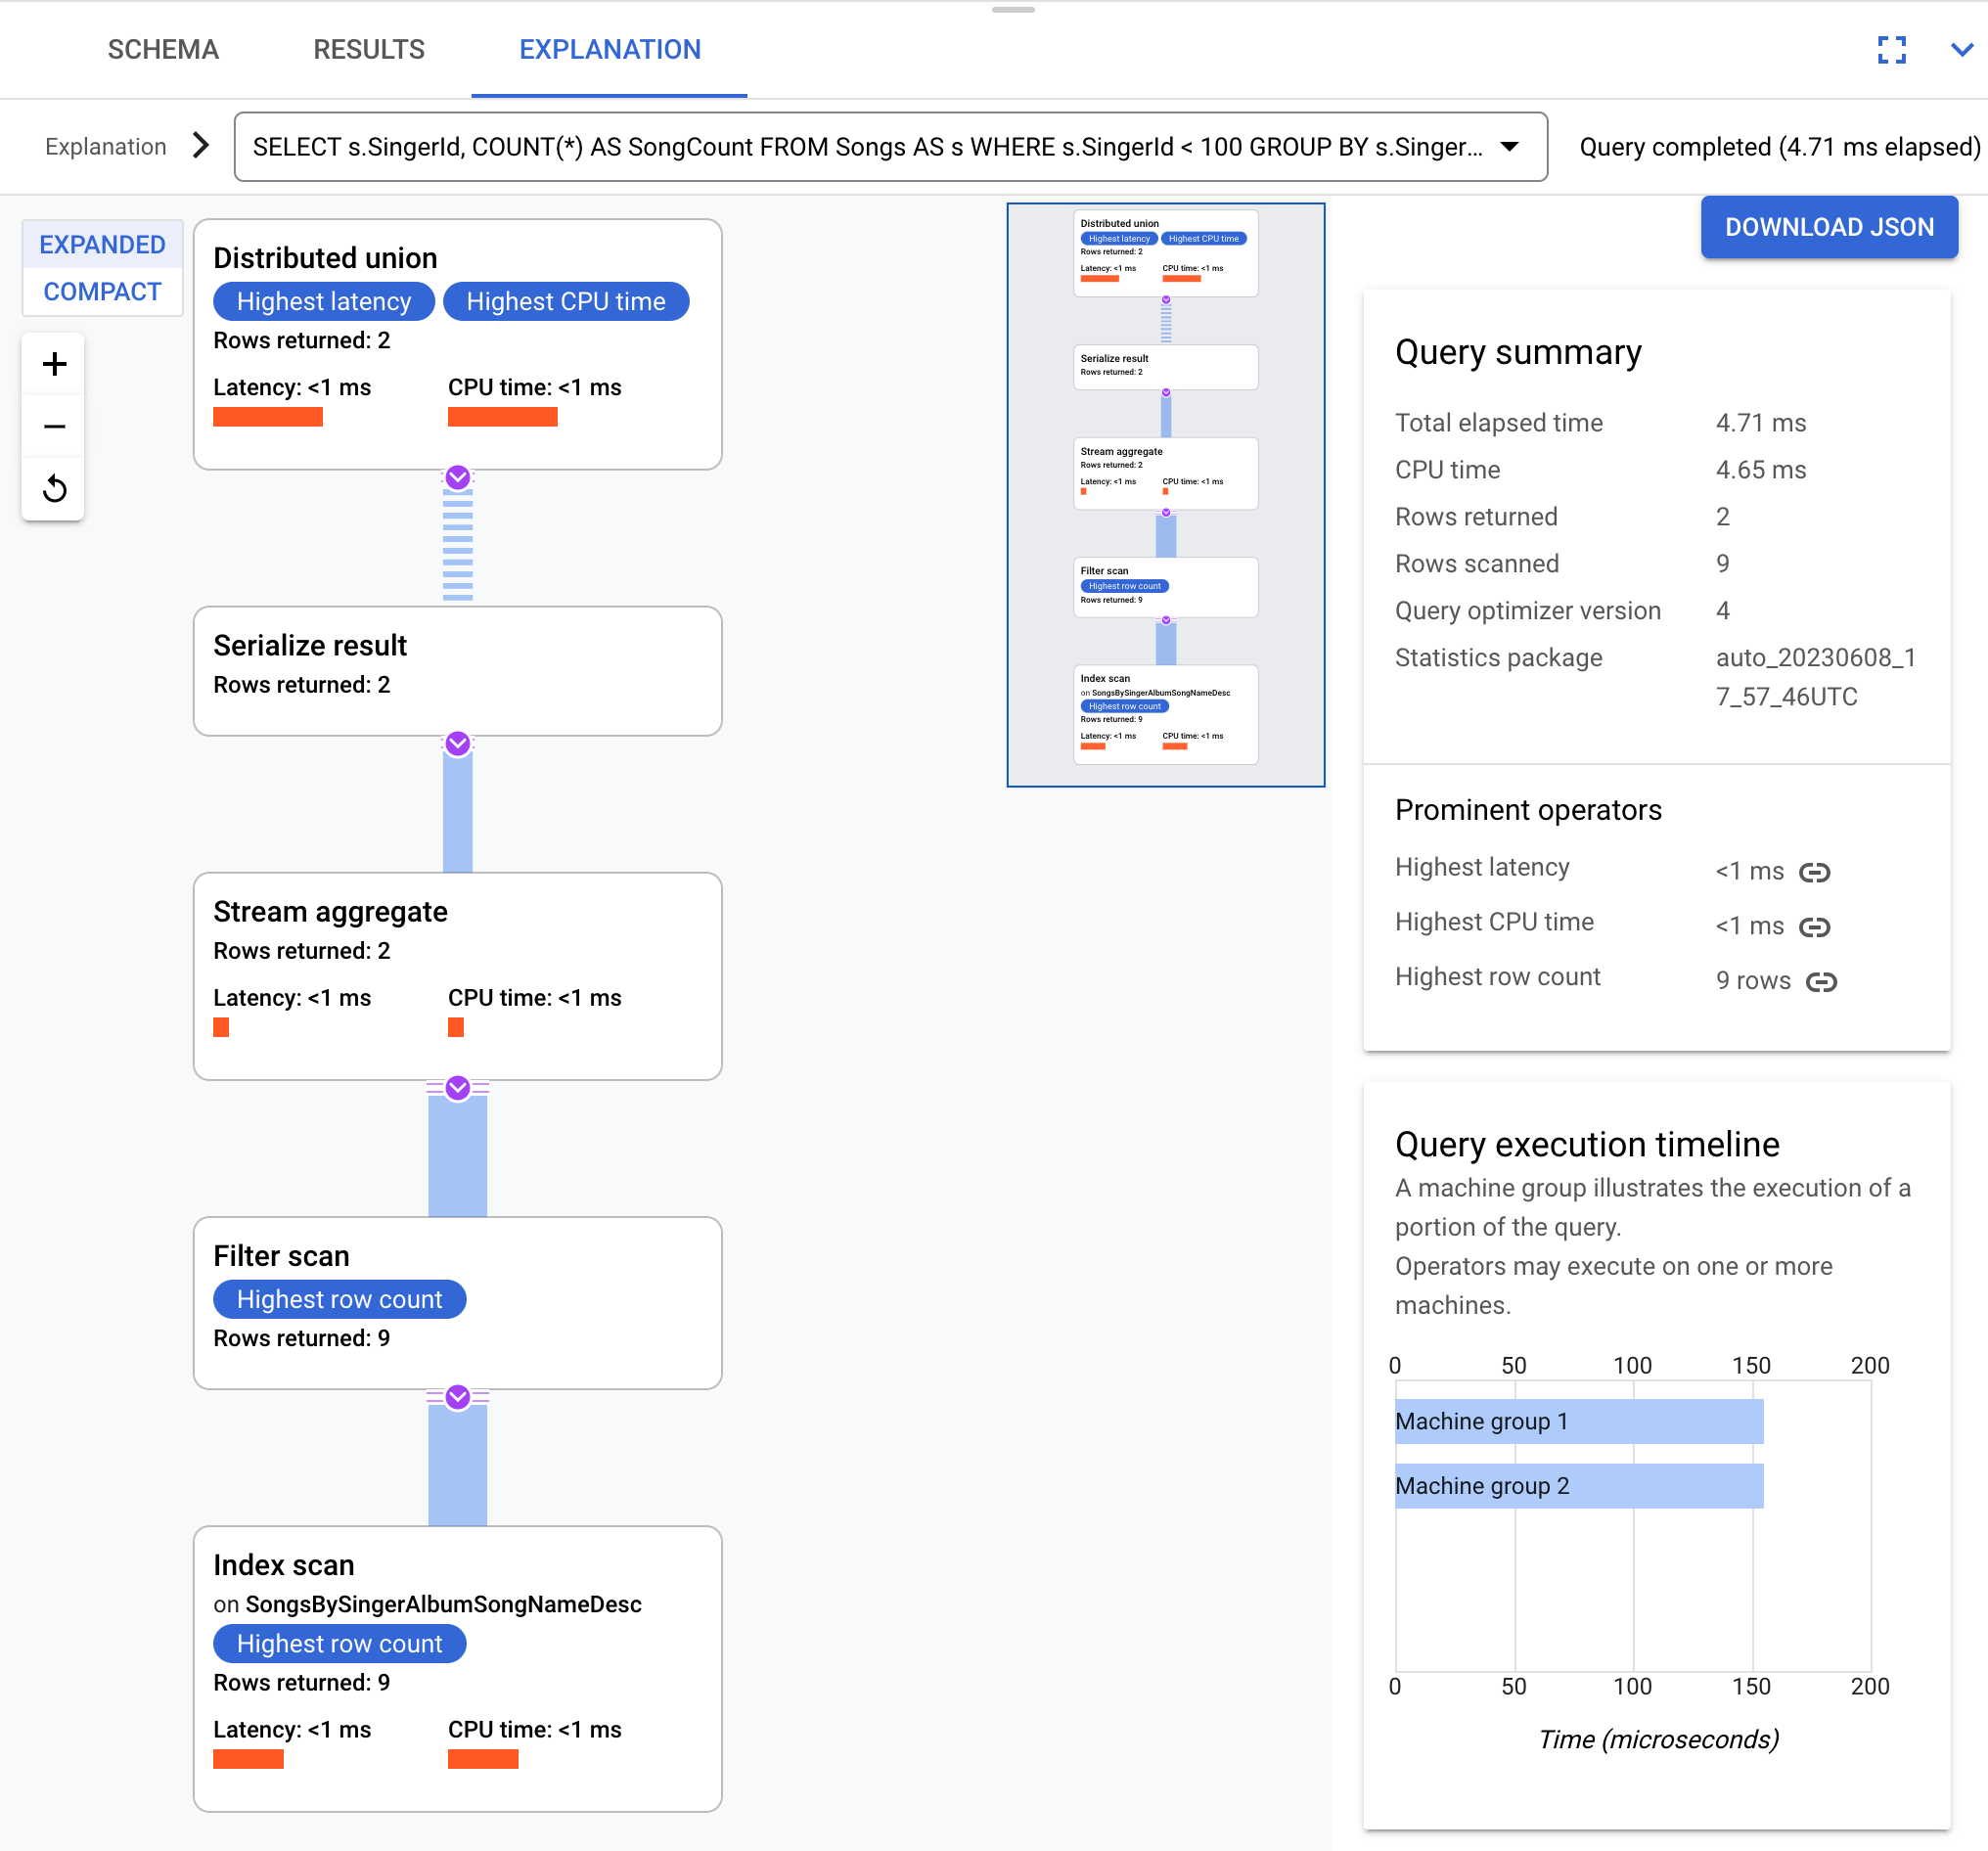
Spanner envoie le plan d'exécution à un serveur racine qui coordonne l'exécution de la requête et distribue les sous-plans à distance.
Ce plan d'exécution commence par un opérateur distributed union qui distribue des sous-plans aux serveurs distants dont les divisions répondent à la condition SingerId < 100. Une fois l'analyse des divisions individuelles terminée, l'opérateur stream aggregate agrège les lignes pour obtenir le nombre de chaque SingerId. L'opérateur serialize result sérialise ensuite le résultat. Enfin, le distributed union combine tous les résultats et renvoie les résultats de la requête.
Pour en savoir plus sur les agrégats, consultez Opérateurs d'agrégation.
Requêtes de jointure colocalisée
Dans les tables entrelacées, Spanner stocke physiquement les lignes associées ensemble. Les jointures colocalisées permettent de joindre des tables entrelacées. Ce type de jointure peut améliorer les performances par rapport aux jointures nécessitant des index ou des jointures ultérieures.
Par exemple, examinez la requête suivante :
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
Cette requête suppose que Songs est entrelacé dans Albums.
Vous obtenez les résultats suivants :
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
Voici le plan d'exécution :
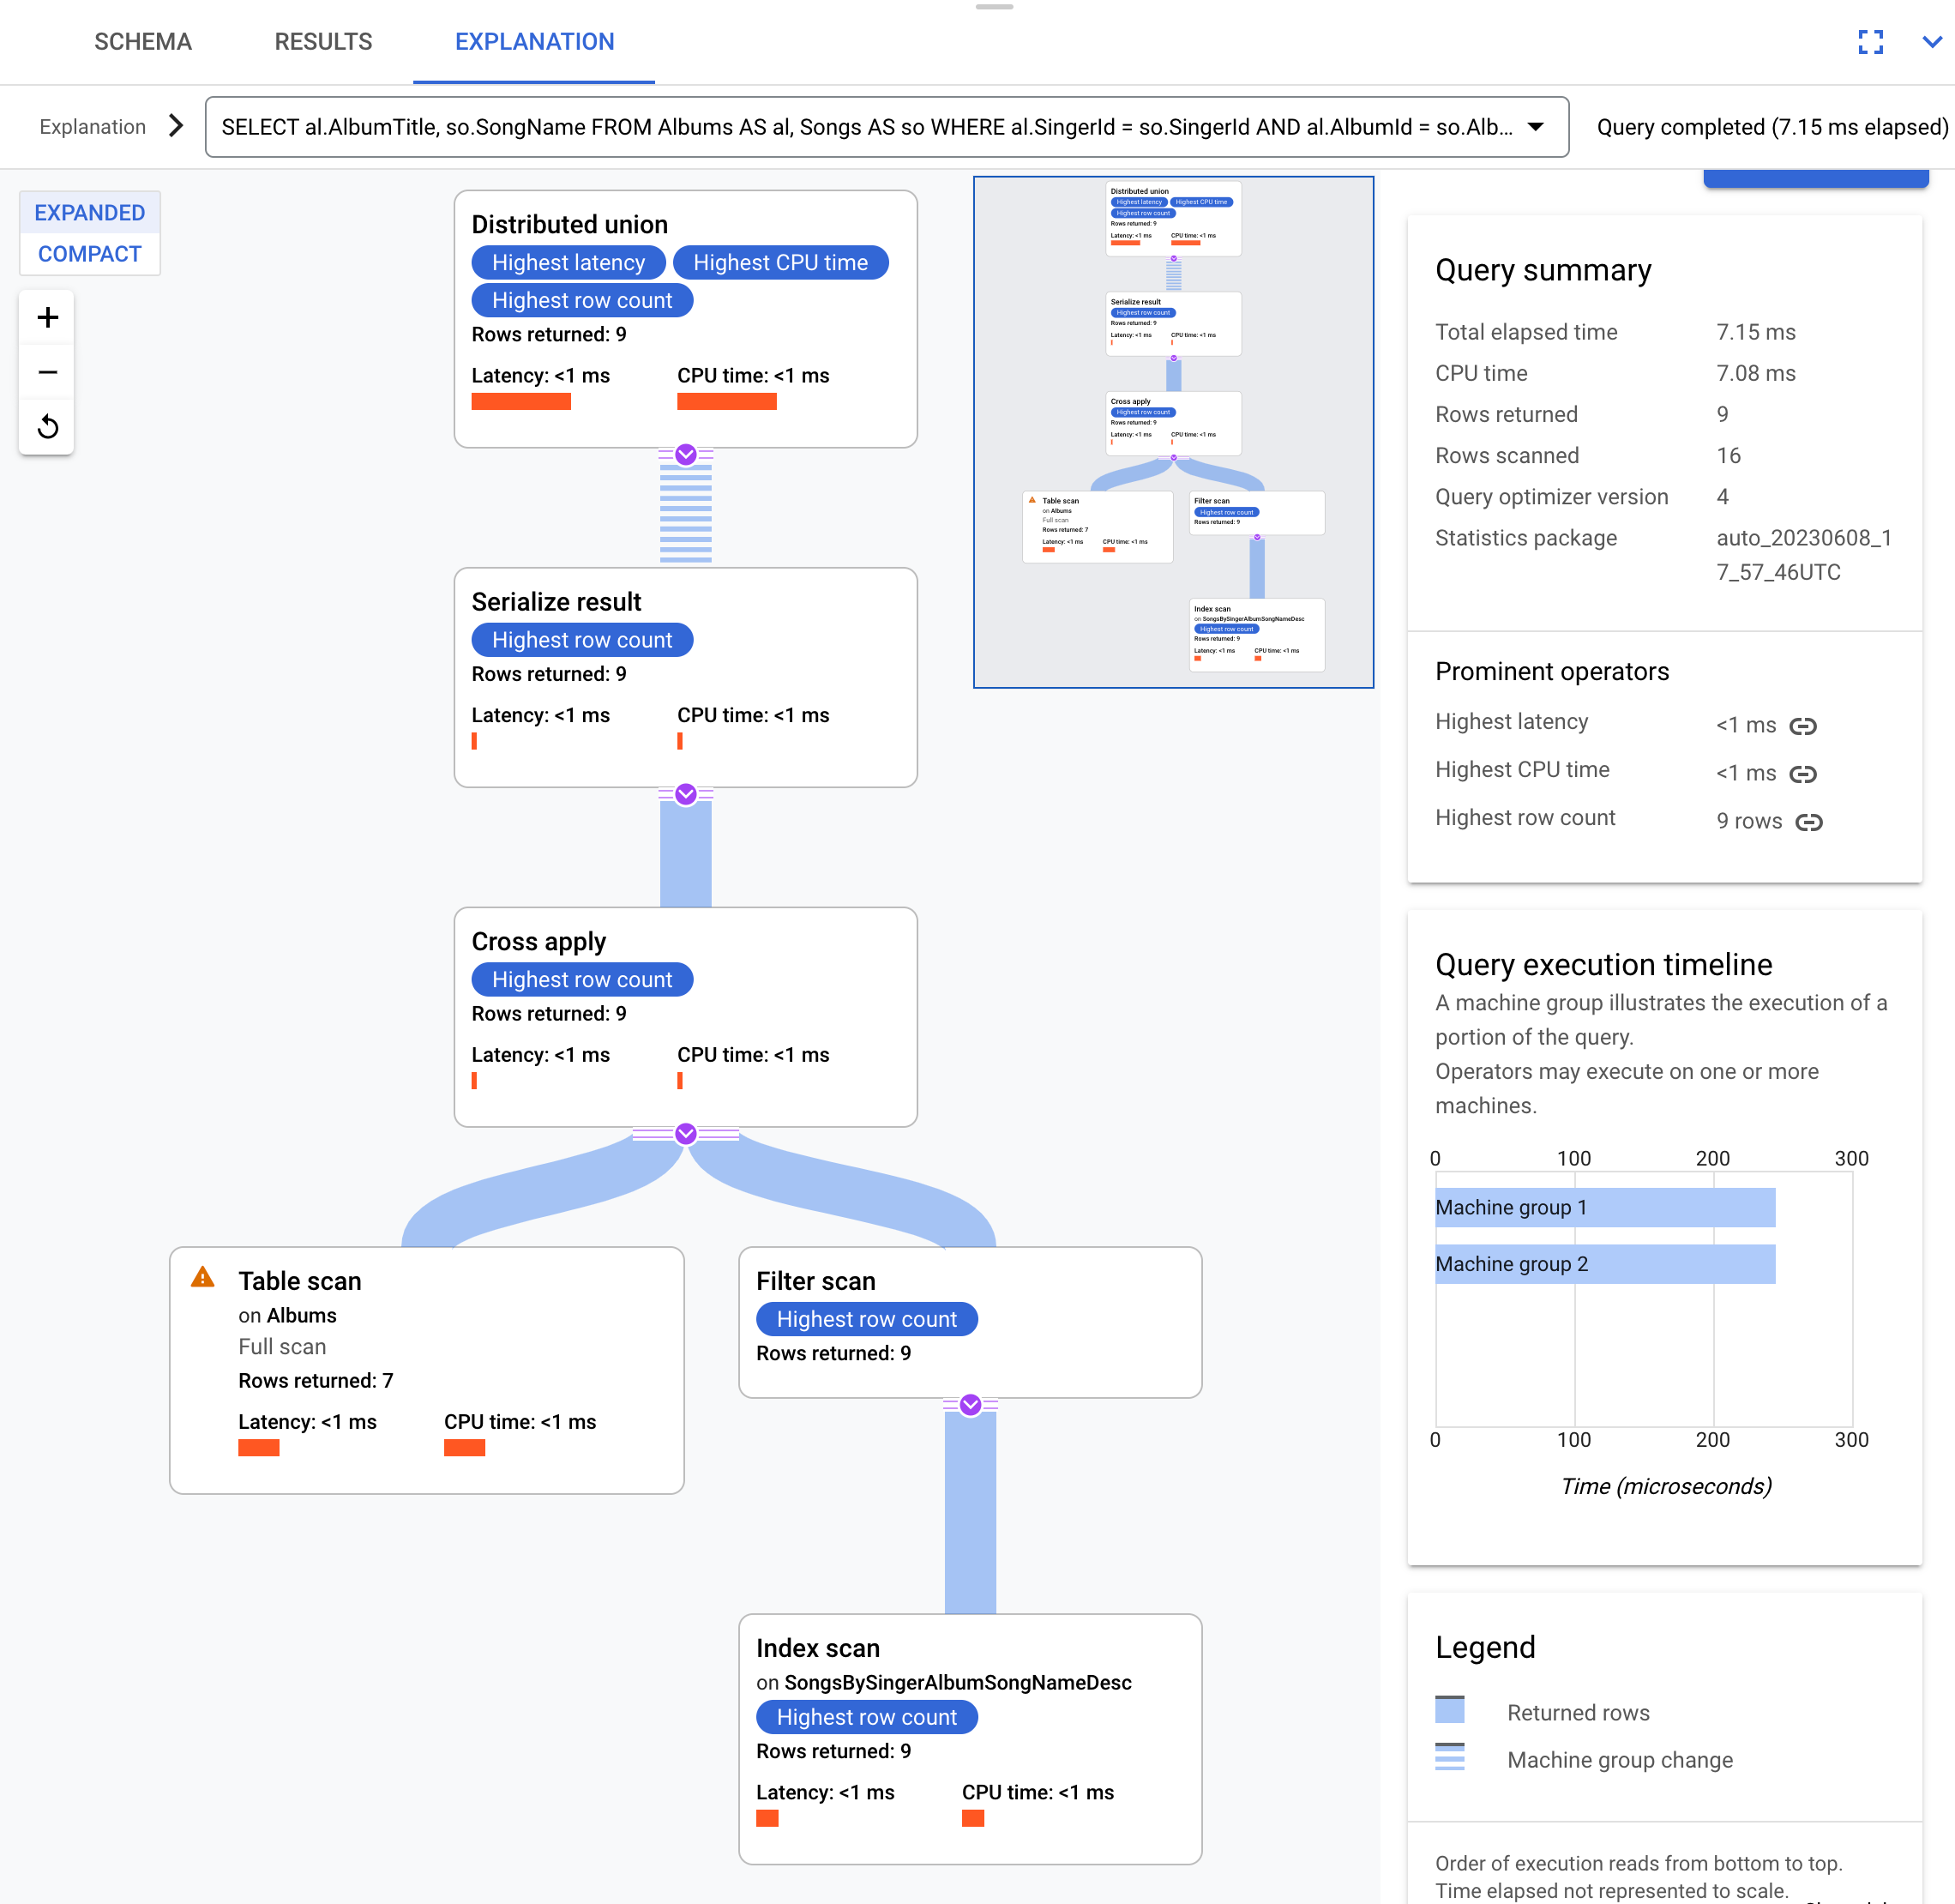
Ce plan d'exécution commence par un opérateur distributed union qui distribue des sous-plans aux serveurs distants contenant des divisions de la table Albums. Comme Songs est entrelacé dans Albums, chaque serveur distant exécute l'intégralité du sous-plan localement sans effectuer de jointure entre différents serveurs.
Les sous-plans contiennent un opérateur cross apply. Chaque opérateur cross apply effectue une table scan sur la table Albums pour récupérer SingerId, AlbumId et AlbumTitle. L'opérateur cross apply mappe ensuite les résultats de l'analyse de la table avec ceux d'une analyse de l'index SongsBySingerAlbumSongNameDesc.
Cet index est soumis à un filtre, qui exige que le SingerId de l'index corresponde au SingerId du résultat de l'analyse de la table. Chaque opérateur cross apply envoie ses résultats à un opérateur serialize result, qui sérialise les données AlbumTitle et SongName, et renvoie les résultats aux unions distribuées locales. L'union distribuée agrège les résultats provenant des unions distribuées locales, puis les renvoie en tant que résultats de la requête.
Index et requêtes de jointure ultérieure
L'exemple précédent utilise une jointure sur deux tables, où une table est entrelacée dans l'autre. Si deux tables, ou une table et un index, ne sont pas entrelacés, les plans d'exécution sont plus complexes et moins efficaces.
Prenons l'exemple d'un index créé avec la commande suivante :
CREATE INDEX SongsBySongName ON Songs(SongName);
Pour utiliser cet index dans une requête, sélectionnez l'une des options de dialecte de base de données suivantes :
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Vous obtenez les résultats suivants :
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
Voici le plan d'exécution :
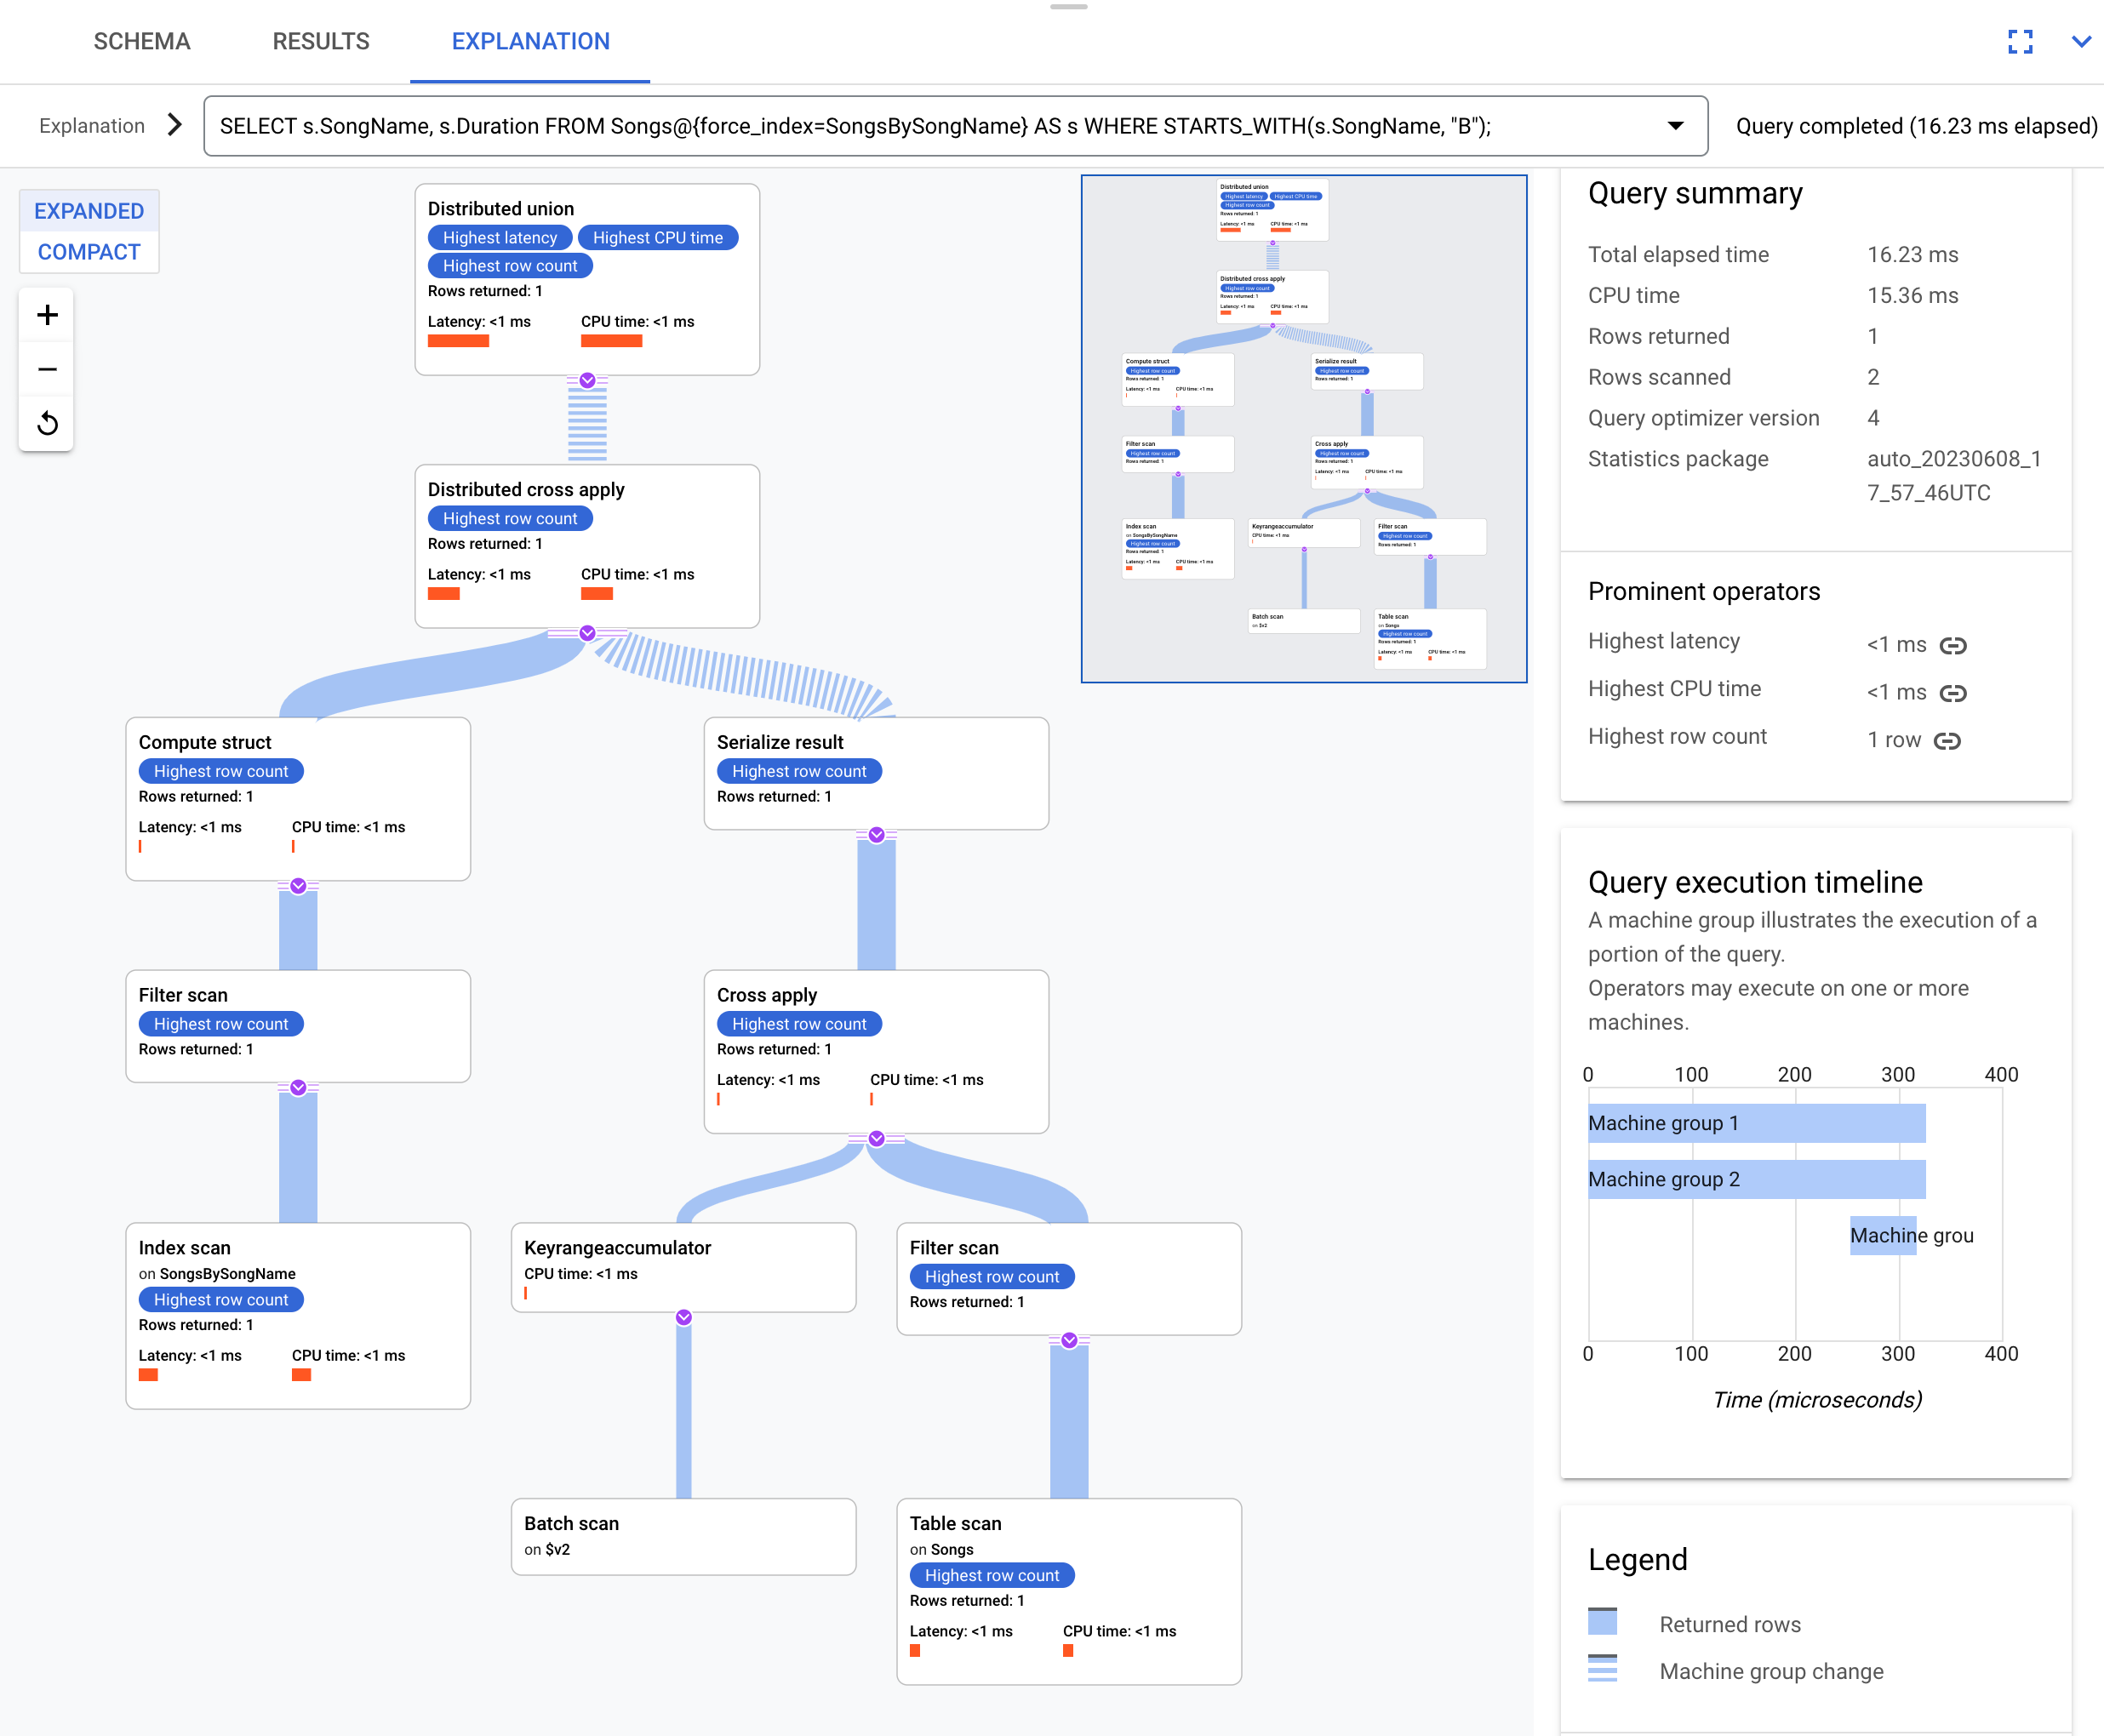
Le plan d'exécution obtenu est complexe, car l'index SongsBySongName ne contient pas la colonne Duration. Pour obtenir la valeur Duration, Spanner joint les résultats indexés à la table Songs. Il s'agit d'une jointure, mais elle n'est pas colocalisée, car la table Songs et l'index global SongsBySongName ne sont pas entrelacés. Si les données ne sont pas colocalisées, Spanner effectue des optimisations pour accélérer l'exécution. Ces optimisations rendent le plan d'exécution plus complexe que l'exemple de jointure colocalisée précédent.
L'opérateur supérieur est un distributed cross apply. Le côté d'entrée de cet opérateur reçoit des lots de lignes de l'index SongsBySongName qui satisfont au prédicat STARTS_WITH(s.SongName, "B"). L'opérateur distributed cross apply mappe ensuite ces lots sur des serveurs distants contenant des divisions avec les données Duration. Pour récupérer la colonne Duration, les serveurs distants effectuent une analyse de table. Cette analyse utilise la condition de filtre Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId), qui joint TrackId de la table Songs aux colonnes TrackId des lignes regroupées à partir de l'index SongsBySongName.
Spanner regroupe les résultats dans la réponse finale à la requête.
À son tour, le côté entrée de l'opérateur distributed cross apply contient une paire distributed union ou local distributed union pour évaluer les lignes de l'index qui satisfont au prédicat STARTS_WITH.
Prenons l'exemple d'une requête légèrement différente ne sélectionnant pas la colonne s.Duration :
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Le plan d'exécution suivant montre que cette requête utilise entièrement l'index :
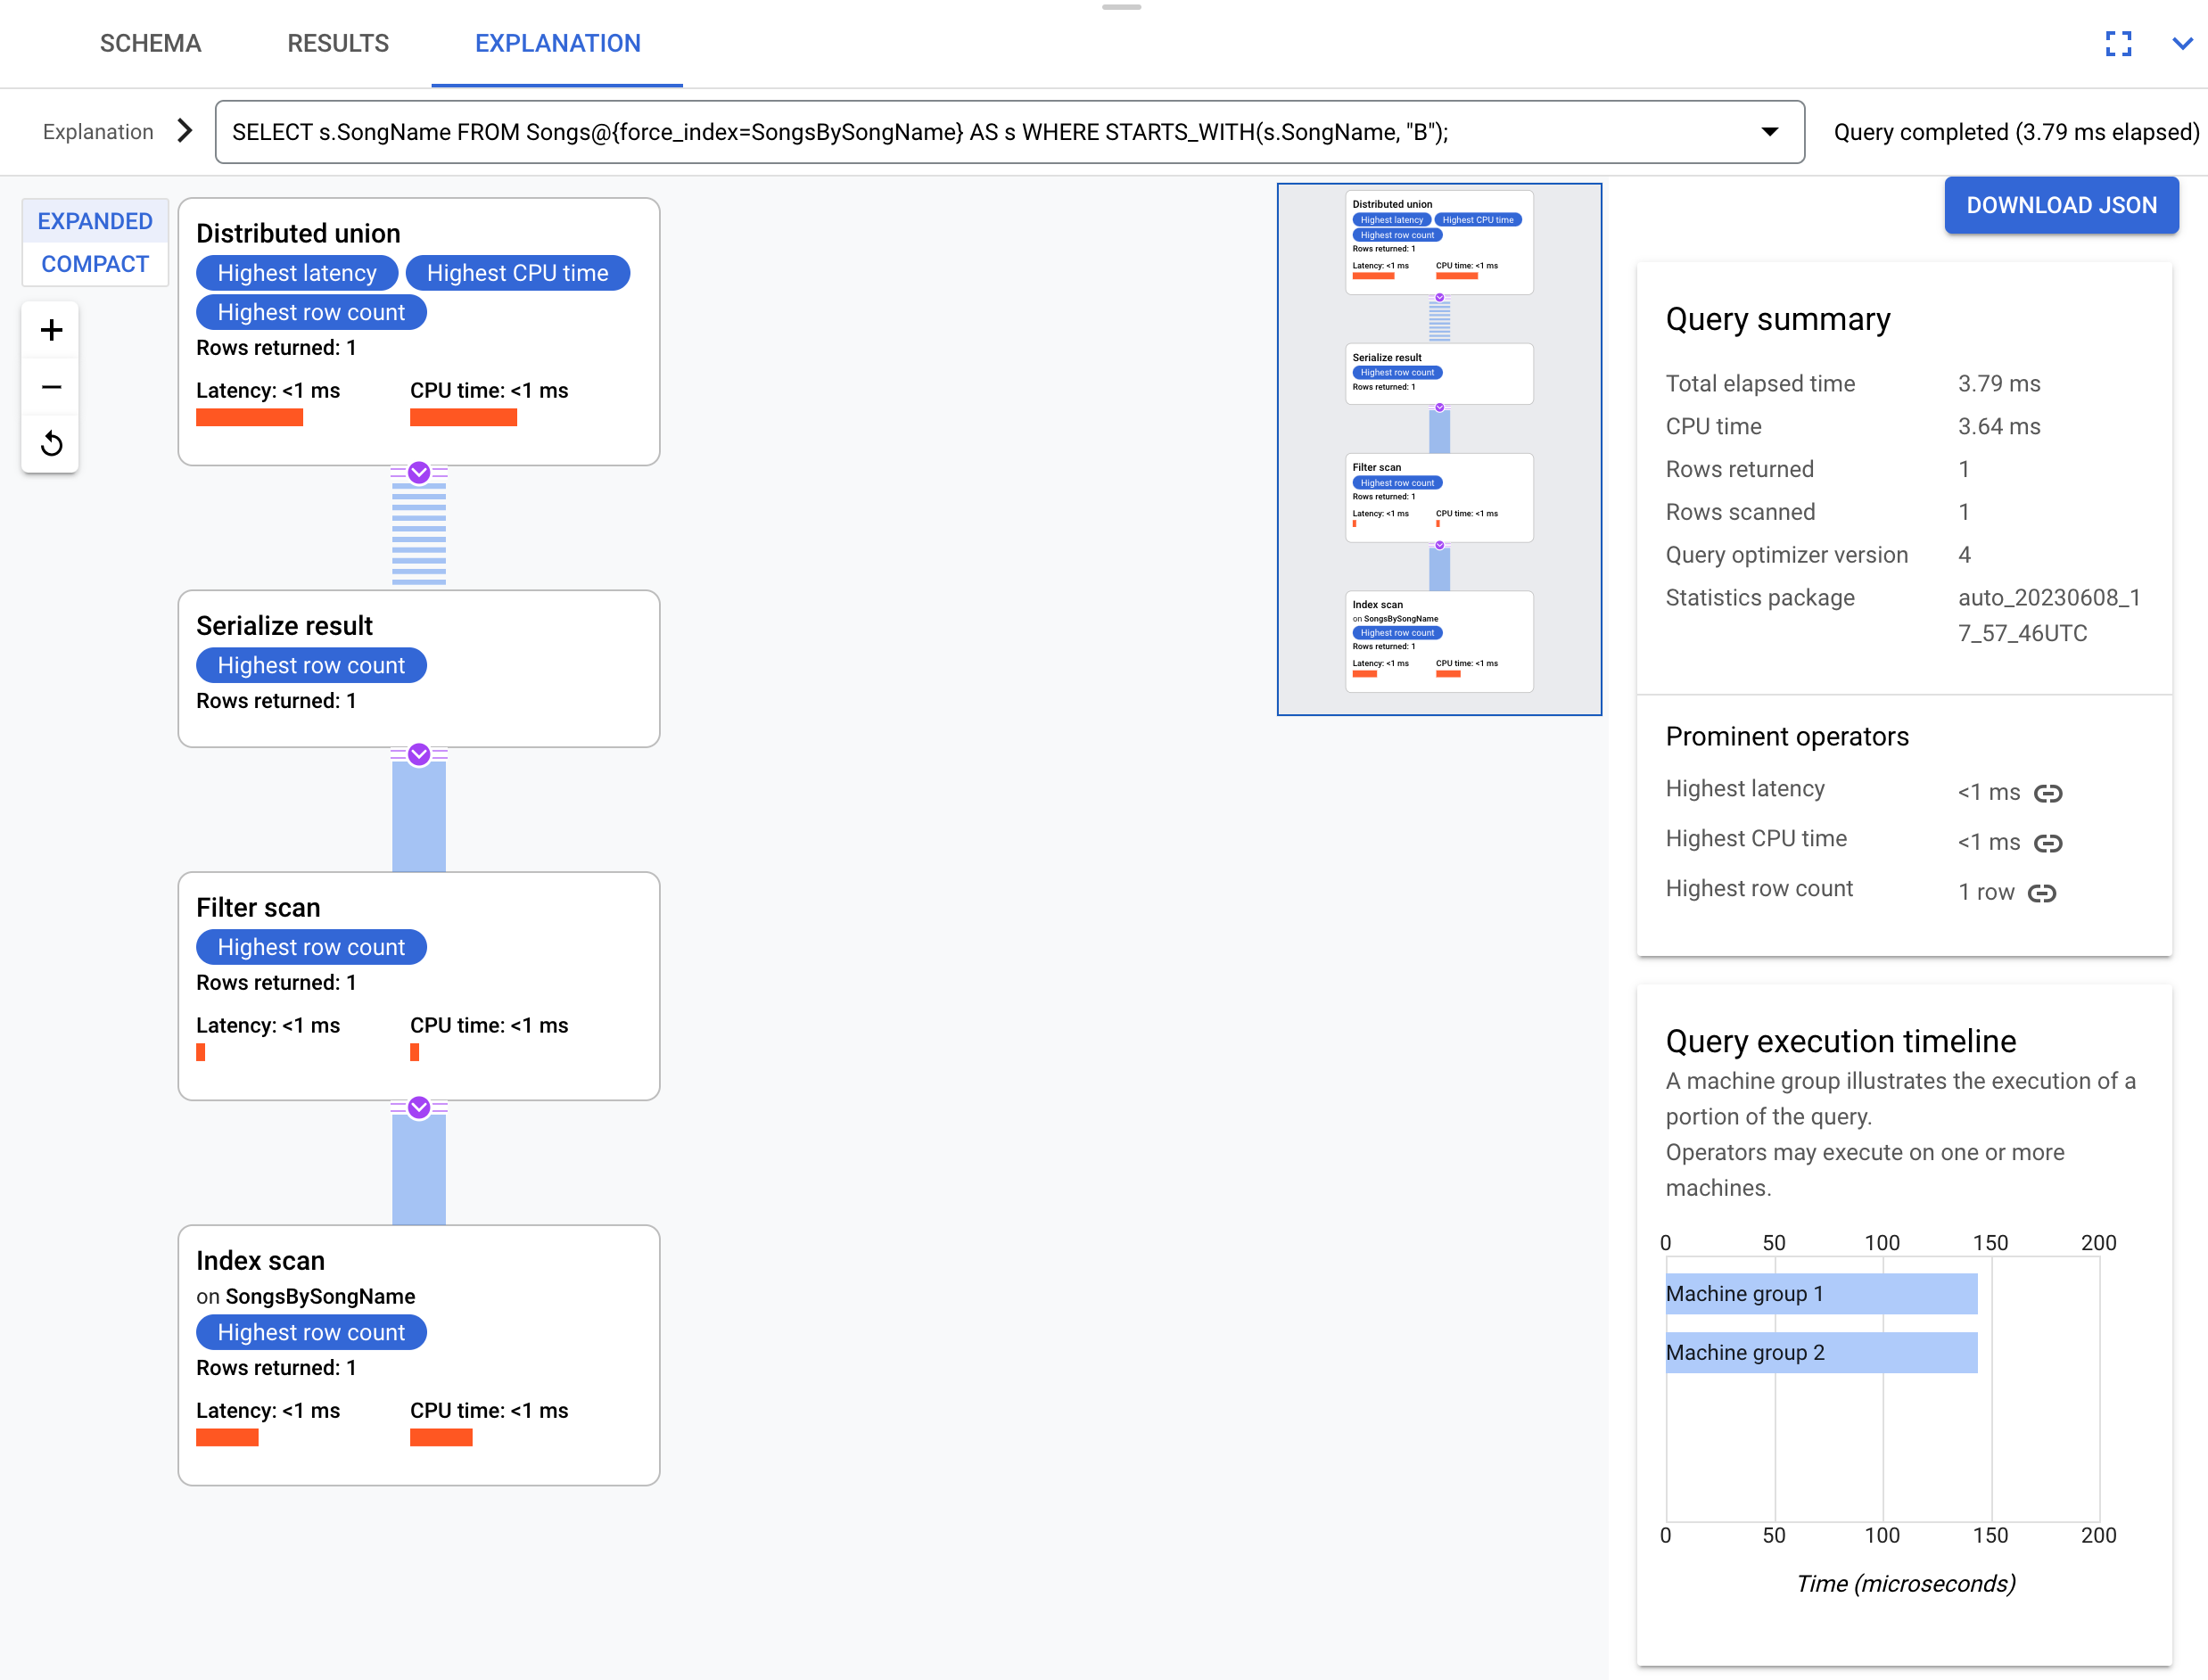
Le plan d'exécution ne nécessite pas de jointure arrière, car l'index contient toutes les colonnes demandées par la requête.
Analyse séquentielle ou recherches dispersées
La lecture d'une plage de lignes contiguës est beaucoup plus rapide que la lecture du même nombre de lignes dispersées.
Par exemple, la requête suivante additionne la durée des chansons d'un ensemble de chanteurs spécifié. Cette requête effectue des recherches pour chaque ID de chanteur spécifié. Pour connaître le nombre de recherches effectuées par la requête, consultez la statistique Nombre de recherches.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
Toutefois, si vous structurez la requête pour lire une séquence contiguë d'ID de chanteurs, vous pouvez améliorer les performances en effectuant une lecture séquentielle de la table Songs. La table Songs contient SingerId dans sa clé primaire.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
Cette différence est pertinente lorsque vous choisissez une méthode de jointure et lorsque vous prenez des décisions de conception de schéma, comme le choix d'une clé primaire. Pour en savoir plus sur le choix d'une méthode de jointure, consultez Interaction des jointures avec les analyses.
Partager des unions distribuées
Chaque table ou index d'une requête doit avoir un opérateur distribué correspondant.
Cet opérateur est soit distributed union, soit distributed apply. Si deux tables ou index sont entrelacés dans le même parent, l'optimiseur de requête peut utiliser un seul opérateur distributed union pour les deux tables ou index.
Étapes suivantes
- Découvrez les opérateurs d'exécution de requêtes.
- Découvrez l'optimiseur de requêtes Spanner.
- Découvrez comment gérer l'optimiseur de requêtes.