


Auf dieser Seite wird gezeigt, wie Sie Dataflow-Pipelines erstellen, die Spanner-Änderungsdaten mithilfe von Änderungsstreams verarbeiten und weiterleiten. Sie können den Beispielcode auf dieser Seite verwenden, um benutzerdefinierte Pipelines zu erstellen.
Wichtige Konzepte
Im Folgenden finden Sie einige wichtige Konzepte für Dataflow-Pipelines für Änderungsstreams.
Dataflow
Dataflow ist ein serverloser, schneller und kostengünstiger Dienst, der sowohl die Stream- als auch die Batchverarbeitung unterstützt. Es bietet Portabilität mit Verarbeitungsjobs, die mit den Open-Source-Bibliotheken Apache Beam geschrieben wurden, und automatisiert die Infrastrukturbereitstellung und das Cluster-Management. Dataflow bietet Streaming nahezu in Echtzeit, wenn Daten aus Änderungsstreams gelesen werden.
Sie können Dataflow verwenden, um Spanner-Änderungsstreams mit dem SpannerIO-Connector zu nutzen. Dieser bietet eine Abstraktion der Spanner API zum Abfragen von Änderungsstreams. Mit diesem Connector müssen Sie den Lebenszyklus der Änderungsstream-Partitionen nicht verwalten, was erforderlich ist, wenn Sie die Spanner API direkt verwenden. Der Connector stellt Ihnen einen Stream mit Datensatzänderungen zur Verfügung, sodass Sie sich mehr auf die Anwendungslogik und weniger auf bestimmte API-Details und die dynamische Partitionierung von Änderungsstreams konzentrieren können. Wir empfehlen, in den meisten Fällen, in denen Sie Änderungsstreamdaten lesen müssen, den SpannerIO-Connector anstelle der Spanner API zu verwenden.
Dataflow-Vorlagen sind vordefinierte Dataflow-Pipelines, die gängige Anwendungsfälle implementieren. Eine Übersicht finden Sie unter Dataflow-Vorlagen.
Dataflow-Pipeline
Eine Dataflow-Pipeline für Spanner-Änderungsstreams besteht aus vier Hauptteilen:
- Eine Spanner-Datenbank mit einem Änderungsstream
- Der SpannerIO-Connector
- Benutzerdefinierte Transformationen und Senken
- Ein Apache Beam-Senken-E/A-Writer
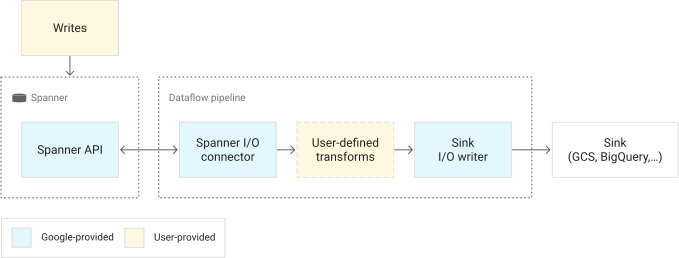
Spanner-Änderungsstream
Weitere Informationen zum Erstellen eines Änderungsstreams finden Sie unter Änderungsstream erstellen.
Apache Beam SpannerIO-Connector
Dies ist der SpannerIO-Connector, der im vorherigen Dataflow-Abschnitt beschrieben wird.
Es handelt sich um einen Quell-E/A-Connector, der einen PCollection von Datensatzänderungen für spätere Phasen der Pipeline ausgibt. Die Ereigniszeit für jeden ausgegebenen Datensatz zur Datenänderung ist der Commit-Zeitstempel. Die ausgegebenen Datensätze sind nicht sortiert. Der SpannerIO-Connector garantiert, dass es keine verspäteten Datensätze gibt.
Bei der Arbeit mit Änderungsstreams verwendet Dataflow Checkpointing. Daher wartet jeder Worker möglicherweise bis zum konfigurierten Prüfpunktintervall, während die Änderungen zwischengespeichert werden und bevor die Änderungen zur weiteren Verarbeitung gesendet werden.
Benutzerdefinierte Transformationen
Mit einer benutzerdefinierten Transformation können Nutzer Verarbeitungsdaten in einer Dataflow-Pipeline aggregieren, transformieren oder ändern. Häufige Anwendungsfälle sind das Entfernen personenidentifizierbarer Informationen, das Erfüllen von Downstream-Datenformatanforderungen und das Sortieren. Weitere Informationen finden Sie in der offiziellen Apache Beam-Dokumentation im Programmierhandbuch zu Transformationen.
Apache Beam-Senken-E/A-Writer
Apache Beam enthält integrierte E/A-Connectors, mit denen Daten aus einer Dataflow-Pipeline in eine Datensenke wie BigQuery geschrieben werden können. Die gängigsten Datensenken werden nativ unterstützt.
Dataflow-Vorlagen
Dataflow-Vorlagen bieten eine Methode zum Erstellen von Dataflow-Jobs auf der Grundlage von vorgefertigten Docker-Images für gängige Anwendungsfälle über die Google Cloud -Konsole, die Google Cloud -CLI oder REST API-Aufrufe.
Für Spanner-Änderungsstreams stellen wir drei flexible Dataflow-Vorlagen zur Verfügung:
Bei Verwendung der Vorlage Spanner-Änderungsstreams zu Pub/Sub gelten die folgenden Einschränkungen:
Pub/Sub hat eine Beschränkung der Nachrichtengröße von 10 MB. Weitere Informationen finden Sie unter Pub/Sub-Kontingente und -Limits.
Die Vorlage Spanner-Änderungsstreams zu Pub/Sub unterstützt aufgrund von Pub/Sub-Einschränkungen keine Verarbeitung großer Nachrichten.
IAM-Berechtigungen für Dataflow-Vorlagen festlegen
Bevor Sie einen Dataflow-Job mit den drei aufgeführten flexiblen Vorlagen erstellen, müssen Sie dafür sorgen, dass Sie die erforderlichen Identity and Access Management (IAM)-Berechtigungen für die folgenden Dienstkonten haben:
Wenn Sie nicht die erforderlichen IAM-Berechtigungen haben, müssen Sie ein nutzerverwaltetes Worker-Dienstkonto angeben, um den Dataflow-Job zu erstellen. Weitere Informationen finden Sie unter Sicherheit und Berechtigungen in Dataflow.
Wenn Sie versuchen, einen Job aus einer Dataflow-Flexible Vorlage auszuführen, ohne alle erforderlichen Berechtigungen zu haben, schlägt der Job möglicherweise mit dem Fehler Fehler beim Lesen der Ergebnisdatei oder Berechtigung für Ressource verweigert fehl. Weitere Informationen finden Sie unter Fehlerbehebung bei flexiblen Vorlagen.
Dataflow-Pipeline erstellen
In diesem Abschnitt wird die Erstkonfiguration des Connectors beschrieben. Außerdem finden Sie Beispiele für gängige Integrationen mit der Funktion für Spanner-Änderungsstreams.
Für diese Schritte benötigen Sie eine Java-Entwicklungsumgebung für Dataflow. Weitere Informationen finden Sie unter Dataflow-Pipeline mit Java erstellen.
Änderungsstream erstellen
Weitere Informationen zum Erstellen eines Änderungsstreams finden Sie unter Änderungsstream erstellen. Damit Sie mit den nächsten Schritten fortfahren können, benötigen Sie eine Spanner-Datenbank mit einem konfigurierten Änderungsstream.
Berechtigungen für die detaillierte Zugriffssteuerung gewähren
Wenn Sie erwarten, dass Nutzer mit detaillierter Zugriffssteuerung den Dataflow-Job ausführen, müssen Sie dafür sorgen, dass die Nutzer Zugriff auf eine Datenbankrolle haben, die die Berechtigung SELECT für den Änderungsstream und die Berechtigung EXECUTE für die Tabellenwertfunktion des Änderungsstreams hat. Achten Sie außerdem darauf, dass das Prinzipal die Datenbankrolle in der SpannerIO-Konfiguration oder in der flexiblen Dataflow-Vorlage angibt.
Weitere Informationen finden Sie unter Detaillierte Zugriffssteuerung.
SpannerIO-Connector als Abhängigkeit hinzufügen
Der Apache Beam SpannerIO-Connector kapselt die Komplexität des direkten Verarbeitens der Änderungsstreams mit der Cloud Spanner API und gibt eine PCollection von Änderungsstream-Datensätzen für spätere Phasen der Pipeline aus.
Diese Objekte können in anderen Phasen der Dataflow-Pipeline des Nutzers verwendet werden. Die Änderungsstream-Integration ist Teil des SpannerIO-Connectors. Damit Sie den SpannerIO-Connector verwenden können, muss die Abhängigkeit der Datei pom.xml hinzugefügt werden:
<dependency>
  <groupId>org.apache.beam</groupId>
  <artifactId>beam-sdks-java-io-google-cloud-platform</artifactId>
  <version>${beam-version}</version> <!-- available from version 2.38.0 -->
</dependency>
Metadatendatenbank erstellen
Der Connector muss jede Partition im Blick behalten, wenn die Apache Beam-Pipeline ausgeführt wird. Die Metadaten werden in einer Spanner-Tabelle gespeichert, die vom Connector während der Initialisierung erstellt wird. Sie geben die Datenbank an, in der diese Tabelle erstellt wird, wenn Sie den Connector konfigurieren.
Wie unter Best Practices für Änderungsstreams beschrieben, empfehlen wir, für diesen Zweck eine neue Datenbank zu erstellen, anstatt dem Connector zu erlauben, die Datenbank Ihrer Anwendung zum Speichern der Metadatentabelle zu verwenden.
Der Inhaber eines Dataflow-Jobs, der den SpannerIO-Connector verwendet, muss die folgenden IAM-Berechtigungen für diese Metadatenbank haben:
spanner.databases.updateDdlspanner.databases.beginReadOnlyTransactionspanner.databases.beginOrRollbackReadWriteTransactionspanner.databases.readspanner.databases.selectspanner.databases.writespanner.sessions.createspanner.sessions.get
Connector konfigurieren
Der Cloud Spanner-Änderungsstreams-Connector kann so konfiguriert werden:
SpannerConfig spannerConfig = SpannerConfig
  .create()
  .withProjectId("my-project-id")
  .withInstanceId("my-instance-id")
  .withDatabaseId("my-database-id")
  .withDatabaseRole("my-database-role");    // Needed for fine-grained access control only

Timestamp startTime = Timestamp.now();
Timestamp endTime = Timestamp.ofTimeSecondsAndNanos(
   startTime.getSeconds() + (10 * 60),
   startTime.getNanos()
);

SpannerIO
  .readChangeStream()
  .withSpannerConfig(spannerConfig)
  .withChangeStreamName("my-change-stream")
  .withMetadataInstance("my-meta-instance-id")
  .withMetadataDatabase("my-meta-database-id")
  .withMetadataTable("my-meta-table-name")
  .withRpcPriority(RpcPriority.MEDIUM)
  .withInclusiveStartAt(startTime)
  .withInclusiveEndAt(endTime);
Im Folgenden werden die readChangeStream()-Optionen beschrieben:
Cloud Spanner-Konfiguration (erforderlich)
Wird zum Konfigurieren des Projekts, der Instanz und der Datenbank verwendet, in denen der Änderungsstream erstellt wurde und aus denen er abgefragt werden soll. Gibt optional auch die Datenbankrolle an, die verwendet werden soll, wenn das IAM-Hauptkonto, das den Dataflow-Job ausführt, ein Nutzer für die detaillierte Zugriffssteuerung ist. Der Job übernimmt diese Datenbankrolle für den Zugriff auf den Änderungsstream. Weitere Informationen finden Sie unter Detaillierte Zugriffssteuerung.
Name des Änderungsstreams (erforderlich)
Dieser Name identifiziert den Änderungsstream eindeutig. Der Name muss mit dem Namen übereinstimmen, der beim Erstellen verwendet wurde.
Metadaten-Instanz-ID (optional)
In dieser Instanz werden die Metadaten gespeichert, die vom Connector verwendet werden, um die Nutzung der Änderungsstream-API-Daten zu steuern.
Metadaten-Datenbank-ID (erforderlich)
In dieser Datenbank werden die Metadaten gespeichert, die vom Connector verwendet werden, um die Nutzung der Änderungsstream-API-Daten zu steuern.
Name der Metadatentabelle (optional)
Dieser Parameter sollte nur beim Aktualisieren einer vorhandenen Pipeline verwendet werden.
Dies ist der Name der vorhandenen Metadatentabelle, die vom Connector verwendet werden soll. Der Connector verwendet diese Tabelle, um die Metadaten zum Steuern der Nutzung der Änderungsstream-API-Daten zu speichern. Wenn diese Option nicht angegeben wird, erstellt Spanner bei der Initialisierung des Connectors eine neue Tabelle mit einem generierten Namen.
RPC-Priorität (optional)
Die Anfragepriorität, die für die Änderungsstream-Abfragen verwendet werden soll. Wenn dieser Parameter weggelassen wird, wird high
priority verwendet.
InclusiveStartAt (erforderlich)
Änderungen ab dem angegebenen Zeitstempel werden an den Aufrufer zurückgegeben.
InclusiveEndAt (optional)
Änderungen bis zum angegebenen Zeitstempel werden an den Aufrufer zurückgegeben. Wenn dieser Parameter weggelassen wird, werden Änderungen unbegrenzt ausgegeben.
Transforms und Senken zum Verarbeiten von Änderungsdaten hinzufügen
Nachdem Sie die vorherigen Schritte ausgeführt haben, ist der konfigurierte SpannerIO-Connector bereit, eine PCollection von DataChangeRecord-Objekten auszugeben.
Unter Beispieltransformationen und ‑senken finden Sie mehrere Beispielkonfigurationen für Pipelines, mit denen diese Streamingdaten auf verschiedene Arten verarbeitet werden.
Die vom SpannerIO-Connector ausgegebenen Änderungsstreamdatensätze sind nicht sortiert. Das liegt daran, dass PCollections keine Reihenfolge garantieren. Wenn Sie einen sortierten Stream benötigen, müssen Sie die Datensätze als Transformationen in Ihren Pipelines gruppieren und sortieren. Weitere Informationen finden Sie unter Beispiel: Nach Schlüssel sortieren. Sie können dieses Beispiel erweitern, um die Datensätze nach beliebigen Feldern zu sortieren, z. B. nach Transaktions-IDs.
Beispiel für Transformations- und Senkenknoten
Sie können eigene Transformationen definieren und Senken angeben, in die die Daten geschrieben werden sollen. Die Apache Beam-Dokumentation enthält eine Vielzahl von Transformationen, die angewendet werden können, sowie gebrauchsfertige E/A-Connectors, mit denen die Daten in externe Systeme geschrieben werden können.
Beispiel: Nach Schlüssel sortieren
In diesem Codebeispiel werden Datenänderungsdatensätze ausgegeben, die nach Commit-Zeitstempel sortiert und nach Primärschlüsseln gruppiert sind. Dazu wird der Dataflow-Connector verwendet.
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(ParDo.of(new BreakRecordByModFn()))
  .apply(ParDo.of(new KeyByIdFn()))
  .apply(ParDo.of(new BufferKeyUntilOutputTimestamp(2)))
  // Subsequent processing goes here
In diesem Codebeispiel werden Status und Zeitgeber verwendet, um Datensätze für jeden Schlüssel zu puffern. Die Ablaufzeit des Zeitgebers wird auf eine vom Nutzer konfigurierte Zeit T in der Zukunft festgelegt (definiert in der Funktion BufferKeyUntilOutputTimestamp). Wenn das Dataflow-Watermark die Zeit T überschreitet, werden mit diesem Code alle Datensätze im Puffer mit einem Zeitstempel, der kleiner als T ist, geleert, nach Commit-Zeitstempel sortiert und ein Schlüssel/Wert-Paar ausgegeben, wobei gilt:
- Der Schlüssel ist der Eingabeschlüssel, d. h. der Primärschlüssel, der in ein Bucket-Array der Größe 1.000 gehasht wird.
- Der Wert sind die geordneten Datensatzänderungen, die für den Schlüssel gepuffert wurden.
Für jeden Schlüssel gelten die folgenden Garantien:
- Timer werden garantiert in der Reihenfolge des Ablaufzeitstempels ausgelöst.
- Nachgelagerte Phasen erhalten die Elemente garantiert in derselben Reihenfolge, in der sie erstellt wurden.
Bei einem Schlüssel mit dem Wert 100 wird der Timer beispielsweise um T1 und T10 ausgelöst und es wird jeweils ein Bündel von Datensatzänderungen erstellt. Da die in T1 ausgegebenen Datensatzänderungen vor den in T10 ausgegebenen Datensatzänderungen erstellt wurden, werden die in T1 ausgegebenen Datensatzänderungen garantiert vor den in T10 ausgegebenen Datensatzänderungen in der nächsten Phase empfangen. Dieser Mechanismus hilft uns, eine strenge Reihenfolge der Commit-Zeitstempel pro Primärschlüssel für die Downstream-Verarbeitung zu garantieren.
Dieser Vorgang wird wiederholt, bis die Pipeline endet und alle Datensatzänderungen verarbeitet wurden. Wenn keine Endzeit angegeben ist, wird er unbegrenzt wiederholt.
In diesem Codebeispiel werden Status und Zeitgeber anstelle von Fenstern verwendet, um die Sortierung nach Schlüssel durchzuführen. Der Grund dafür ist, dass Fenster nicht garantiert in der richtigen Reihenfolge verarbeitet werden. Das bedeutet, dass ältere Zeiträume später als neuere Zeiträume verarbeitet werden können, was zu einer Verarbeitung in falscher Reihenfolge führen kann.
BreakRecordByModFn
Jeder Datensatz für Änderungen kann mehrere Änderungen enthalten. Jede Änderung stellt einen Einfüge-, Aktualisierungs- oder Löschvorgang für einen einzelnen Primärschlüsselwert dar. Mit dieser Funktion wird jeder Datensatz für Datenänderungen in separate Datensätze für Datenänderungen aufgeteilt, einer pro Änderung.
private static class BreakRecordByModFn extends DoFn<DataChangeRecord,
                                                     DataChangeRecord>  {
  @ProcessElement
  public void processElement(
      @Element DataChangeRecord record, OutputReceiver<DataChangeRecord>
    outputReceiver) {
    record.getMods().stream()
      .map(
          mod ->
              new DataChangeRecord(
                  record.getPartitionToken(),
                  record.getCommitTimestamp(),
                  record.getServerTransactionId(),
                  record.isLastRecordInTransactionInPartition(),
                  record.getRecordSequence(),
                  record.getTableName(),
                  record.getRowType(),
                  Collections.singletonList(mod),
                  record.getModType(),
                  record.getValueCaptureType(),
                  record.getNumberOfRecordsInTransaction(),
                  record.getNumberOfPartitionsInTransaction(),
                  record.getTransactionTag(),
                  record.isSystemTransaction(),
                  record.getMetadata()))
      .forEach(outputReceiver::output);
  }
}
KeyByIdFn
Diese Funktion nimmt einen DataChangeRecord entgegen und gibt einen DataChangeRecord aus, der nach dem Spanner-Primärschlüssel gehasht und in einen Ganzzahlwert umgewandelt wird.
private static class KeyByIdFn extends DoFn<DataChangeRecord, KV<String, DataChangeRecord>>  {
  // NUMBER_OF_BUCKETS should be configured by the user to match their key cardinality
  // Here, we are choosing to hash the Spanner primary keys to a bucket index, in order to have a deterministic number
  // of states and timers for performance purposes.
  // Note that having too many buckets might have undesirable effects if it results in a low number of records per bucket
  // On the other hand, having too few buckets might also be problematic, since many keys will be contained within them.
  private static final int NUMBER_OF_BUCKETS = 1000;

  @ProcessElement
  public void processElement(
      @Element DataChangeRecord record,
      OutputReceiver<KV<String, DataChangeRecord>> outputReceiver) {
    int hashCode = (int) record.getMods().get(0).getKeysJson().hashCode();
    // Hash the received keys into a bucket in order to have a
    // deterministic number of buffers and timers.
    String bucketIndex = String.valueOf(hashCode % NUMBER_OF_BUCKETS);

    outputReceiver.output(KV.of(bucketIndex, record));
  }
}
BufferKeyUntilOutputTimestamp
Timer und Puffer sind schlüsselbezogen. Diese Funktion puffert jeden Datensatz mit einer Datenänderung, bis das Wasserzeichen den Zeitstempel erreicht, zu dem wir die gepufferten Datensätze mit Datenänderungen ausgeben möchten.
In diesem Code wird ein Timer verwendet, um zu bestimmen, wann der Puffer geleert werden soll:
- Wenn zum ersten Mal ein Datensatz zur Datenänderung für einen Schlüssel erkannt wird, wird der Timer so eingestellt, dass er zum Commit-Zeitstempel des Datensatzes zur Datenänderung +
incrementIntervalInSeconds(eine vom Nutzer konfigurierbare Option) ausgelöst wird. - Wenn der Timer ausgelöst wird, werden alle Datensatzänderungen im Puffer mit einem Zeitstempel, der kleiner als die Ablaufzeit des Timers ist, zu
recordsToOutputhinzugefügt. Wenn der Puffer Datensatzänderungen enthält, deren Zeitstempel größer oder gleich der Ablaufzeit des Timers ist, werden diese Datensatzänderungen wieder in den Puffer eingefügt, anstatt ausgegeben zu werden. Der nächste Timer wird dann auf die Ablaufzeit des aktuellen Timers plusincrementIntervalInSecondseingestellt. - Wenn
recordsToOutputnicht leer ist, werden die Datensatzänderungen inrecordsToOutputnach Commit-Zeitstempel und Transaktions-ID sortiert und dann ausgegeben.
private static class BufferKeyUntilOutputTimestamp extends
    DoFn<KV<String, DataChangeRecord>, KV<String, Iterable<DataChangeRecord>>>  {
  private static final Logger LOG =
      LoggerFactory.getLogger(BufferKeyUntilOutputTimestamp.class);

  private final long incrementIntervalInSeconds;

  private BufferKeyUntilOutputTimestamp(long incrementIntervalInSeconds) {
    this.incrementIntervalInSeconds = incrementIntervalInSeconds;
  }

  @SuppressWarnings("unused")
  @TimerId("timer")
  private final TimerSpec timerSpec = TimerSpecs.timer(TimeDomain.EVENT_TIME);

  @StateId("buffer")
  private final StateSpec<BagState<DataChangeRecord>> buffer = StateSpecs.bag();

  @StateId("keyString")
  private final StateSpec<ValueState<String>> keyString =
      StateSpecs.value(StringUtf8Coder.of());

  @ProcessElement
  public void process(
      @Element KV<String, DataChangeRecord> element,
      @StateId("buffer") BagState<DataChangeRecord> buffer,
      @TimerId("timer") Timer timer,
      @StateId("keyString") ValueState<String> keyString) {
    buffer.add(element.getValue());

    // Only set the timer if this is the first time we are receiving a data change
    // record with this key.
    String elementKey = keyString.read();
    if (elementKey == null) {
      Instant commitTimestamp =
          new Instant(element.getValue().getCommitTimestamp().toSqlTimestamp());
      Instant outputTimestamp =
          commitTimestamp.plus(Duration.standardSeconds(incrementIntervalInSeconds));
      timer.set(outputTimestamp);
      keyString.write(element.getKey());
    }
  }

  @OnTimer("timer")
  public void onExpiry(
      OnTimerContext context,
      @StateId("buffer") BagState<DataChangeRecord> buffer,
      @TimerId("timer") Timer timer,
      @StateId("keyString") ValueState<String> keyString) {
    if (!buffer.isEmpty().read()) {
      String elementKey = keyString.read();

      final List<DataChangeRecord> records =
          StreamSupport.stream(buffer.read().spliterator(), false)
              .collect(Collectors.toList());
      buffer.clear();

      List<DataChangeRecord> recordsToOutput = new ArrayList<>();
      for (DataChangeRecord record : records) {
        Instant recordCommitTimestamp =
            new Instant(record.getCommitTimestamp().toSqlTimestamp());
        final String recordString =
            record.getMods().get(0).getNewValuesJson().isEmpty()
                ? "Deleted record"
                : record.getMods().get(0).getNewValuesJson();
        // When the watermark passes time T, this means that all records with
        // event time < T have been processed and successfully committed. Since the
        // timer fires when the watermark passes the expiration time, we should
        // only output records with event time < expiration time.
        if (recordCommitTimestamp.isBefore(context.timestamp())) {
          LOG.info(
             "Outputting record with key {} and value {} at expiration " +
             "timestamp {}",
              elementKey,
              recordString,
              context.timestamp().toString());
          recordsToOutput.add(record);
        } else {
          LOG.info(
              "Expired at {} but adding record with key {} and value {} back to " +
              "buffer due to commit timestamp {}",
              context.timestamp().toString(),
              elementKey,
              recordString,
              recordCommitTimestamp.toString());
          buffer.add(record);
        }
      }

      // Output records, if there are any to output.
      if (!recordsToOutput.isEmpty()) {
        // Order the records in place, and output them. The user would need
        // to implement DataChangeRecordComparator class that sorts the
        // data change records by commit timestamp and transaction ID.
        Collections.sort(recordsToOutput, new DataChangeRecordComparator());
        context.outputWithTimestamp(
            KV.of(elementKey, recordsToOutput), context.timestamp());
        LOG.info(
            "Expired at {}, outputting records for key {}",
            context.timestamp().toString(),
            elementKey);
      } else {
        LOG.info("Expired at {} with no records", context.timestamp().toString());
      }
    }

    Instant nextTimer = context.timestamp().plus(Duration.standardSeconds(incrementIntervalInSeconds));
    if (buffer.isEmpty() != null && !buffer.isEmpty().read()) {
      LOG.info("Setting next timer to {}", nextTimer.toString());
      timer.set(nextTimer);
    } else {
      LOG.info(
          "Timer not being set since the buffer is empty: ");
      keyString.clear();
    }
  }
}
Transaktionen sortieren
Diese Pipeline kann so geändert werden, dass die Ergebnisse nach Transaktions-ID und Commit-Zeitstempel sortiert werden. Puffern Sie dazu Datensätze für jedes Transaktions-ID-/Commit-Zeitstempel-Paar anstelle jedes Spanner-Schlüssels. Dazu muss der Code in KeyByIdFn geändert werden.
Beispiel: Transaktionen zusammenführen
In diesem Codebeispiel werden Datensatzänderungen gelesen, alle Datensatzänderungen, die zur selben Transaktion gehören, in einem einzelnen Element zusammengefasst und dieses Element ausgegeben. Die von diesem Beispielcode ausgegebenen Transaktionen sind nicht nach dem Commit-Zeitstempel sortiert.
In diesem Codebeispiel werden Puffer verwendet, um Transaktionen aus Datensatzänderungen zusammenzustellen. Wenn ein Datensatz für eine Datenänderung, der zu einer Transaktion gehört, zum ersten Mal empfangen wird, wird das Feld numberOfRecordsInTransaction im Datensatz für die Datenänderung gelesen. Es beschreibt die erwartete Anzahl von Datensätzen für die Datenänderung, die zu dieser Transaktion gehören. Die Datensatzänderungen, die zu dieser Transaktion gehören, werden so lange gepuffert, bis die Anzahl der gepufferten Datensätze mit numberOfRecordsInTransaction übereinstimmt. Dann werden die gebündelten Datensatzänderungen ausgegeben.
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(ParDo.of(new KeyByTransactionIdFn()))
  .apply(ParDo.of(new TransactionBoundaryFn()))
  // Subsequent processing goes here
KeyByTransactionIdFn
Diese Funktion verwendet ein DataChangeRecord und gibt ein DataChangeRecord zurück, das nach der Transaktions-ID indexiert ist.
private static class KeyByTransactionIdFn extends DoFn<DataChangeRecord, KV<String, DataChangeRecord>>  {
  @ProcessElement
  public void processElement(
      @Element DataChangeRecord record,
      OutputReceiver<KV<String, DataChangeRecord>> outputReceiver) {
    outputReceiver.output(KV.of(record.getServerTransactionId(), record));
  }
}
TransactionBoundaryFn
TransactionBoundaryFn puffert empfangene Schlüssel/Wert-Paare von {TransactionId, DataChangeRecord} aus KeyByTransactionIdFn und puffert sie in Gruppen basierend auf TransactionId. Wenn die Anzahl der gepufferten Datensätze der Anzahl der Datensätze in der gesamten Transaktion entspricht, sortiert diese Funktion die DataChangeRecord-Objekte in der Gruppe nach der Datensatzsequenz und gibt ein Schlüssel/Wert-Paar aus {CommitTimestamp, TransactionId} und Iterable<DataChangeRecord> aus.
Hier gehen wir davon aus, dass SortKey eine benutzerdefinierte Klasse ist, die ein {CommitTimestamp, TransactionId}-Paar darstellt. Weitere Informationen zum SortKey finden Sie in der Beispielimplementierung.
private static class TransactionBoundaryFn extends DoFn<KV<String, DataChangeRecord>, KV<SortKey, Iterable<DataChangeRecord>>>  {
  @StateId("buffer")
  private final StateSpec<BagState<DataChangeRecord>> buffer = StateSpecs.bag();

  @StateId("count")
  private final StateSpec<ValueState<Integer>> countState = StateSpecs.value();

  @ProcessElement
  public void process(
      ProcessContext context,
      @StateId("buffer") BagState<DataChangeRecord> buffer,
      @StateId("count") ValueState<Integer> countState) {
    final KV<String, DataChangeRecord> element = context.element();
    final DataChangeRecord record = element.getValue();

    buffer.add(record);
    int count = (countState.read() != null ? countState.read() : 0);
    count = count + 1;
    countState.write(count);

    if (count == record.getNumberOfRecordsInTransaction()) {
      final List<DataChangeRecord> sortedRecords =
          StreamSupport.stream(buffer.read().spliterator(), false)
              .sorted(Comparator.comparing(DataChangeRecord::getRecordSequence))
              .collect(Collectors.toList());

      final Instant commitInstant =
          new Instant(sortedRecords.get(0).getCommitTimestamp().toSqlTimestamp()
              .getTime());
      context.outputWithTimestamp(
          KV.of(
              new SortKey(sortedRecords.get(0).getCommitTimestamp(),
                          sortedRecords.get(0).getServerTransactionId()),
              sortedRecords),
          commitInstant);
      buffer.clear();
      countState.clear();
    }
  }
}
Beispiel: Nach Transaktions-Tag filtern
Wenn eine Transaktion, bei der Nutzerdaten geändert werden, mit einem Tag versehen wird, werden das entsprechende Tag und sein Typ als Teil von DataChangeRecord gespeichert. In diesen Beispielen wird gezeigt, wie Sie Änderungsstream-Datensätze anhand von benutzerdefinierten Transaktions-Tags sowie System-Tags filtern:
Benutzerdefinierte Tag-Filterung für my-tx-tag:
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(Filter.by(record ->
           !record.isSystemTransaction()
           && record.getTransactionTag().equalsIgnoreCase("my-tx-tag")))
  // Subsequent processing goes here
System-Tag-Filterung/TTL-Prüfung:
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(Filter.by(record ->
           record.isSystemTransaction()
           && record.getTransactionTag().equals("RowDeletionPolicy")))
  // Subsequent processing goes here
Beispiel: Vollständige Zeile abrufen
In diesem Beispiel wird mit einer Spanner-Tabelle namens Singer gearbeitet, die die folgende Definition hat:
CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  FirstName STRING(1024),
  LastName STRING(1024)
) PRIMARY KEY (SingerId);
Im Standardmodus OLD_AND_NEW_VALUES für die Werterfassung von Änderungsstreams enthält der empfangene Datensatz für Datenänderungen bei einer Aktualisierung einer Spanner-Zeile nur die Spalten, die geändert wurden. Spalten, die erfasst, aber nicht geändert wurden, sind nicht im Datensatz enthalten. Der Primärschlüssel des Mod kann verwendet werden, um einen Spanner-Snapshot-Lesevorgang zum Commit-Zeitstempel des Datensatzes durchzuführen, um die unveränderten Spalten oder sogar die gesamte Zeile abzurufen.
Die Aufbewahrungsrichtlinie für die Datenbank muss möglicherweise auf einen Wert geändert werden, der größer oder gleich der Aufbewahrungsrichtlinie für den Änderungsstream ist, damit der Snapshot-Lesevorgang erfolgreich ist.
Außerdem ist die Verwendung des Werterfassungstyps NEW_ROW die empfohlene und effizientere Methode, da standardmäßig alle erfassten Spalten der Zeile zurückgegeben werden und kein zusätzlicher Snapshot-Lesevorgang in Spanner erforderlich ist.
SpannerConfig spannerConfig = SpannerConfig
   .create()
   .withProjectId("my-project-id")
   .withInstanceId("my-instance-id")
   .withDatabaseId("my-database-id")
   .withDatabaseRole("my-database-role");   // Needed for fine-grained access control only

pipeline
   .apply(SpannerIO
       .readChangeStream()
       .withSpannerConfig(spannerConfig)
       // Assume we have a change stream "my-change-stream" that watches Singers table.
       .withChangeStreamName("my-change-stream")
       .withMetadataInstance("my-metadata-instance-id")
       .withMetadataDatabase("my-metadata-database-id")
       .withInclusiveStartAt(Timestamp.now()))
   .apply(ParDo.of(new ToFullRowJsonFn(spannerConfig)))
   // Subsequent processing goes here
ToFullRowJsonFn
Bei dieser Transformation wird für jeden empfangenen Datensatz ein Lesevorgang veralteter Daten mit dem Commit-Zeitstempel ausgeführt und die gesamte Zeile wird JSON zugeordnet.
public class ToFullRowJsonFn extends DoFn<DataChangeRecord, String> {
 // Since each instance of this DoFn will create its own session pool and will
 // perform calls to Spanner sequentially, we keep the number of sessions in
 // the pool small. This way, we avoid wasting resources.
 private static final int MIN_SESSIONS = 1;
 private static final int MAX_SESSIONS = 5;
 private final String projectId;
 private final String instanceId;
 private final String databaseId;

 private transient DatabaseClient client;
 private transient Spanner spanner;

 public ToFullRowJsonFn(SpannerConfig spannerConfig) {
   this.projectId = spannerConfig.getProjectId().get();
   this.instanceId = spannerConfig.getInstanceId().get();
   this.databaseId = spannerConfig.getDatabaseId().get();
 }

 @Setup
 public void setup() {
   SessionPoolOptions sessionPoolOptions = SessionPoolOptions
      .newBuilder()
      .setMinSessions(MIN_SESSIONS)
      .setMaxSessions(MAX_SESSIONS)
      .build();
   SpannerOptions options = SpannerOptions
       .newBuilder()
       .setProjectId(projectId)
       .setSessionPoolOption(sessionPoolOptions)
       .build();
   DatabaseId id = DatabaseId.of(projectId, instanceId, databaseId);
   spanner = options.getService();
   client = spanner.getDatabaseClient(id);
 }

 @Teardown
 public void teardown() {
   spanner.close();
 }

 @ProcessElement
 public void process(
   @Element DataChangeRecord element,
   OutputReceiver<String> output) {
   com.google.cloud.Timestamp commitTimestamp = element.getCommitTimestamp();
   element.getMods().forEach(mod -> {
     JSONObject keysJson = new JSONObject(mod.getKeysJson());
     JSONObject newValuesJson = new JSONObject(mod.getNewValuesJson());
     ModType modType = element.getModType();
     JSONObject jsonRow = new JSONObject();
     long singerId = keysJson.getLong("SingerId");
     jsonRow.put("SingerId", singerId);
     if (modType == ModType.INSERT) {
       // For INSERT mod, get non-primary key columns from mod.
       jsonRow.put("FirstName", newValuesJson.get("FirstName"));
       jsonRow.put("LastName", newValuesJson.get("LastName"));
     } else if (modType == ModType.UPDATE) {
       // For UPDATE mod, get non-primary key columns by doing a snapshot read using the primary key column from mod.
       try (ResultSet resultSet = client
         .singleUse(TimestampBound.ofReadTimestamp(commitTimestamp))
         .read(
           "Singers",
           KeySet.singleKey(com.google.cloud.spanner.Key.of(singerId)),
             Arrays.asList("FirstName", "LastName"))) {
         if (resultSet.next()) {
           jsonRow.put("FirstName", resultSet.isNull("FirstName") ?
             JSONObject.NULL : resultSet.getString("FirstName"));
           jsonRow.put("LastName", resultSet.isNull("LastName") ?
             JSONObject.NULL : resultSet.getString("LastName"));
         }
       }
     } else {
       // For DELETE mod, there is nothing to do, as we already set SingerId.
     }

     output.output(jsonRow.toString());
   });
 }
}
Mit diesem Code wird ein Spanner-Datenbankclient erstellt, um den vollständigen Zeilenabruf durchzuführen. Außerdem wird der Sitzungspool so konfiguriert, dass er nur wenige Sitzungen enthält und Lesevorgänge sequenziell in einer Instanz von ToFullRowJsonFn ausgeführt werden.
Dataflow sorgt dafür, dass viele Instanzen dieser Funktion mit jeweils einem eigenen Clientpool erstellt werden.
Beispiel: Spanner zu Pub/Sub
In diesem Szenario streamt der Aufrufer Datensätze so schnell wie möglich an Pub/Sub, ohne Gruppierung oder Aggregation. Das ist eine gute Möglichkeit, die nachgelagerte Verarbeitung auszulösen, z. B. alle neuen Zeilen, die in eine Spanner-Tabelle eingefügt werden, zur weiteren Verarbeitung in Pub/Sub zu streamen.
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(MapElements.into(TypeDescriptors.strings()).via(Object::toString))
  .apply(PubsubIO.writeStrings().to("my-topic"));
Die Pub/Sub-Senke kann so konfiguriert werden, dass die Exactly-Once-Semantik gewährleistet ist.
Beispiel: Spanner zu Cloud Storage
In diesem Szenario gruppiert der Aufrufer alle Datensätze innerhalb eines bestimmten Zeitraums und speichert die Gruppe in separaten Cloud Storage-Dateien. Das eignet sich gut für Analysen und die Archivierung zu einem bestimmten Zeitpunkt, die unabhängig vom Aufbewahrungszeitraum von Spanner ist.
pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(SpannerConfig
      .create()
      .withProjectId("my-project-id")
      .withInstanceId("my-instance-id")
      .withDatabaseId("my-database-id")
      .withDatabaseRole("my-database-role"))    // Needed for fine-grained access control only
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(MapElements.into(TypeDescriptors.strings()).via(Object::toString))
  .apply(Window.into(FixedWindows.of(Duration.standardMinutes(1))))
  .apply(TextIO
    .write()
    .to("gs://my-bucket/change-stream-results-")
    .withSuffix(".txt")
    .withWindowedWrites()
    .withNumShards(1));
Beachten Sie, dass die Cloud Storage-Senke standardmäßig die „Mindestens einmal“-Semantik bietet. Mit zusätzlicher Verarbeitung kann sie so geändert werden, dass sie eine „Exactly-Once“-Semantik hat.
Für diesen Anwendungsfall stellen wir auch eine Dataflow-Vorlage zur Verfügung. Weitere Informationen finden Sie unter Änderungsstreams mit Cloud Storage verbinden.
Beispiel: Spanner to BigQuery (Ledger-Tabelle)
Hier streamt der Aufrufer Änderungsdatensätze in BigQuery. Jeder Datenänderungseintrag wird als eine Zeile in BigQuery dargestellt. Das ist gut für Analysen geeignet. In diesem Code werden die zuvor im Abschnitt Vollständige Zeile abrufen definierten Funktionen verwendet, um die vollständige Zeile des Datensatzes abzurufen und in BigQuery zu schreiben.
SpannerConfig spannerConfig = SpannerConfig
  .create()
  .withProjectId("my-project-id")
  .withInstanceId("my-instance-id")
  .withDatabaseId("my-database-id")
  .withDatabaseRole("my-database-role");   // Needed for fine-grained access control only

pipeline
  .apply(SpannerIO
    .readChangeStream()
    .withSpannerConfig(spannerConfig)
    .withChangeStreamName("my-change-stream")
    .withMetadataInstance("my-metadata-instance-id")
    .withMetadataDatabase("my-metadata-database-id")
    .withInclusiveStartAt(Timestamp.now()))
  .apply(ParDo.of(new ToFullRowJsonFn(spannerConfig)))
  .apply(BigQueryIO
    .<String>write()
    .to("my-bigquery-table")
    .withCreateDisposition(CreateDisposition.CREATE_IF_NEEDED)
    .withWriteDisposition(Write.WriteDisposition.WRITE_APPEND)
    .withSchema(new TableSchema().setFields(Arrays.asList(
      new TableFieldSchema()
        .setName("SingerId")
        .setType("INT64")
        .setMode("REQUIRED"),
      new TableFieldSchema()
        .setName("FirstName")
        .setType("STRING")
        .setMode("REQUIRED"),
      new TableFieldSchema()
        .setName("LastName")
        .setType("STRING")
        .setMode("REQUIRED")
    )))
    .withAutoSharding()
    .optimizedWrites()
    .withFormatFunction((String element) -> {
      ObjectMapper objectMapper = new ObjectMapper();
      JsonNode jsonNode = null;
      try {
        jsonNode = objectMapper.readTree(element);
      } catch (IOException e) {
        e.printStackTrace();
      }
      return new TableRow()
        .set("SingerId", jsonNode.get("SingerId").asInt())
        .set("FirstName", jsonNode.get("FirstName").asText())
        .set("LastName", jsonNode.get("LastName").asText());
    }
  )
);
Die BigQuery-Senke bietet standardmäßig die „Mindestens einmal“-Semantik. Mit zusätzlicher Verarbeitung kann sie so geändert werden, dass sie eine „Exactly-Once“-Semantik hat.
Für diesen Anwendungsfall stellen wir auch eine Dataflow-Vorlage bereit. Weitere Informationen finden Sie unter Änderungsstreams mit BigQuery verbinden.
Pipeline überwachen
Es gibt zwei Klassen von Messwerten, mit denen Sie eine Dataflow-Pipeline für Änderungsstreams überwachen können.
Standardmäßige Dataflow-Messwerte
Dataflow bietet mehrere Messwerte, um den Zustand Ihres Jobs zu überwachen, z. B. Datenaktualität, Systemverzögerung, Jobdurchsatz und CPU-Auslastung des Workers. Weitere Informationen finden Sie unter Monitoring für Dataflow-Pipelines verwenden.
Bei Change Streams-Pipelines sind zwei Hauptmesswerte zu berücksichtigen: die Systemlatenz und die Datenaktualität.
Die Systemlatenz gibt die aktuelle maximale Dauer in Sekunden an, für die ein Datenelement verarbeitet wird oder auf die Verarbeitung wartet.
Die Datenaktualität gibt die Zeit zwischen der Echtzeit und dem Ausgabewasserzeichen an. Das Ausgabewasserzeichen für die Zeit T gibt an, dass alle Elemente mit einer Ereigniszeit (strikt) vor T für die Berechnung verarbeitet wurden. Die Datenaktualität gibt also an, wie auf dem neuesten Stand die Pipeline in Bezug auf die Verarbeitung der empfangenen Ereignisse ist.
Wenn die Pipeline nicht genügend Ressourcen hat, können Sie das an diesen beiden Messwerten erkennen. Die Systemlatenz nimmt zu, da Elemente länger warten müssen, bevor sie verarbeitet werden. Auch die Datenaktualität nimmt zu, da die Pipeline mit der Menge der empfangenen Daten nicht mithalten kann.
Benutzerdefinierte Messwerte für Änderungsstreams
Diese Messwerte sind in Cloud Monitoring verfügbar und umfassen:
- Die in Buckets (Histogramm) unterteilte Latenz zwischen dem Commit eines Datensatzes in Spanner und der Ausgabe in eine PCollection durch den Connector. Mit diesem Messwert können Sie Leistungsprobleme (Latenz) bei der Pipeline erkennen.
- Gesamtzahl der gelesenen Datensätze. Dies ist ein allgemeiner Hinweis auf die Anzahl der Datensätze, die vom Connector ausgegeben werden. Diese Zahl sollte immer weiter steigen und den Trend der Schreibvorgänge in der zugrunde liegenden Spanner-Datenbank widerspiegeln.
- Anzahl der Partitionen, die gelesen werden. Es sollten immer Partitionen gelesen werden. Wenn diese Zahl null ist, ist in der Pipeline ein Fehler aufgetreten.
- Gesamtzahl der Abfragen, die während der Ausführung des Connectors ausgegeben wurden. Dies ist ein allgemeiner Hinweis auf Änderungsstream-Abfragen, die während der Ausführung der Pipeline an die Spanner-Instanz gesendet wurden. Damit lässt sich die Last des Connectors für die Spanner-Datenbank schätzen.
Vorhandene Pipeline aktualisieren
Eine laufende Pipeline, die den SpannerIO-Connector zum Verarbeiten von Änderungsstreams verwendet, kann aktualisiert werden, wenn die Job-Kompatibilitätsprüfungen erfolgreich sind. Dazu müssen Sie beim Aktualisieren des neuen Jobs den Parameter für den Namen der Metadatentabelle explizit festlegen. Verwenden Sie den Wert der Pipelineoption metadataTable aus dem Job, den Sie aktualisieren.
Wenn Sie eine von Google bereitgestellte Dataflow-Vorlage verwenden, legen Sie den Tabellennamen mit dem Parameter spannerMetadataTableName fest. Sie können auch Ihren vorhandenen Job so ändern, dass die Metadatentabelle explizit mit der Methode withMetadataTable(your-metadata-table-name) in der Connector-Konfiguration verwendet wird. Danach können Sie der Anleitung unter Ersatzjob starten in der Dataflow-Dokumentation folgen, um einen laufenden Job zu aktualisieren.
Best Practices für Änderungsstreams und Dataflow
Im Folgenden finden Sie einige Best Practices für das Erstellen von Verbindungen für Änderungsstreams mit Dataflow.
Separate Metadatendatenbank verwenden
Wir empfehlen, eine separate Datenbank für den SpannerIO-Connector zum Speichern von Metadaten zu erstellen, anstatt ihn für die Verwendung Ihrer Anwendungsdatenbank zu konfigurieren.
Weitere Informationen finden Sie unter Separate Metadatenbank in Betracht ziehen.
Clustergröße festlegen
Als Faustregel für die anfängliche Anzahl von Workern in einem Spanner-Änderungsstream-Job gilt ein Worker pro 1.000 Schreibvorgänge pro Sekunde. Diese Schätzung kann je nach mehreren Faktoren variieren, z. B. der Größe der einzelnen Transaktionen, der Anzahl der Änderungsstream-Datensätze, die aus einer einzelnen Transaktion generiert werden, und anderen Transformationen, Aggregationen oder Senken, die in der Pipeline verwendet werden.
Nach der ersten Bereitstellung ist es wichtig, die in Pipeline überwachen erwähnten Messwerte im Blick zu behalten, um sicherzustellen, dass die Pipeline fehlerfrei funktioniert. Wir empfehlen, mit einer anfänglichen Worker-Pool-Größe zu experimentieren und zu beobachten, wie Ihre Pipeline mit der Last umgeht. Erhöhen Sie die Anzahl der Knoten bei Bedarf. Die CPU-Auslastung ist ein wichtiger Messwert, um zu prüfen, ob die Last angemessen ist und ob weitere Knoten erforderlich sind.
Bekannte Einschränkungen
Bei der Verwendung von Spanner-Änderungsstreams mit Dataflow sind einige Einschränkungen bekannt:
Autoscaling
Für das Autoscaling von Pipelines, die SpannerIO.readChangeStream enthalten, ist Apache Beam 2.39.0 oder höher erforderlich.
Wenn Sie eine Apache Beam-Version vor 2.39.0 verwenden, muss für Pipelines, die SpannerIO.readChangeStream enthalten, der Autoscaling-Algorithmus explizit als NONE angegeben werden, wie unter Horizontales Autoscaling beschrieben.
Informationen zum manuellen Skalieren einer Dataflow-Pipeline anstelle von Autoscaling finden Sie unter Streamingpipeline manuell skalieren.
Portable Runner
Für den Spanner-Änderungsstreams-Connector ist der Dataflow Portable Runner erforderlich. Dies muss während der Ausführung manuell angegeben werden, da sonst ein Fehler ausgegeben wird.
Sie können Portable Runner angeben, indem Sie Ihren Job mit dem folgenden Flag konfigurieren:
- Beam SDK 2.74 oder höher:
--experiments=enable_portable_runner. - Beam SDK 2.73 oder früher:
--experiments=use_runner_v2.
Snapshot
Der Spanner-Connector für Änderungsstreams unterstützt keine Dataflow-Snapshots.
Ausgleichen
Der Cloud Spanner-Änderungsstreams-Connector unterstützt das Beenden eines Jobs per Drain nicht. Es ist nur möglich, einen vorhandenen Job abzubrechen.
Sie können auch eine vorhandene Pipeline aktualisieren, ohne sie beenden zu müssen.
OpenCensus
Wenn Sie OpenCensus verwenden möchten, um Ihre Pipeline zu überwachen, geben Sie die Version 0.28.3 oder höher an.
NullPointerException bei Pipelinestart
Ein Fehler in Apache Beam-Version 2.38.0 kann unter bestimmten Umständen beim Starten der Pipeline zu einem NullPointerException führen. Dadurch würde verhindert, dass Ihr Job gestartet wird, und stattdessen würde diese Fehlermeldung angezeigt:
java.lang.NullPointerException: null value in entry: Cloud Storage_PROJECT_ID=null
Um dieses Problem zu beheben, verwenden Sie entweder Apache Beam-Version 2.39.0 oder höher oder geben Sie die Version von beam-sdks-java-core manuell als 2.37.0 an:
<dependency>
  <groupId>org.apache.beam</groupId>
  <artifactId>beam-sdks-java-core</artifactId>
  <version>2.37.0</version>
</dependency>