


Auf dieser Seite werden Änderungsstreams in Cloud Spanner für Datenbanken im GoogleSQL-Dialekt und Datenbanken im PostgreSQL-Dialekt beschrieben. Dazu gehören:
- Das auf Splits basierende Partitionierungsmodell
- Format und Inhalt von Änderungsstream-Datensätzen
- Die Low-Level-Syntax, die zum Abfragen dieser Datensätze verwendet wird
- Beispiel für den Abfrageworkflow
Sie verwenden die Spanner API, um Änderungsstreams direkt abzufragen. Anwendungen, die stattdessen Dataflow zum Lesen von Änderungsstreamdaten verwenden, müssen nicht direkt mit dem hier beschriebenen Datenmodell arbeiten.
Einen umfassenderen Einführungsleitfaden zu Änderungsstreams finden Sie unter Übersicht über Änderungsstreams.
Partitionen von Änderungsstreams
Wenn sich eine Tabelle ändert, die von einem Änderungsstream überwacht wird, schreibt Spanner synchron in derselben Transaktion wie die Datenänderung einen entsprechenden Änderungsstream-Datensatz in die Datenbank. Wenn die Transaktion erfolgreich ist, hat Spanner die Änderung also auch erfolgreich erfasst und gespeichert. Intern werden der Änderungsstream-Datensatz und die Datenänderung in Spanner auf demselben Server platziert, um den Schreibaufwand zu minimieren.
Im Rahmen der DML für einen bestimmten Split hängt Spanner den Schreibvorgang in derselben Transaktion an den entsprechenden Änderungsstream-Datensplit an. Durch diese Colocation ist keine zusätzliche Koordination zwischen den Serving-Ressourcen erforderlich, was den Overhead für den Transaktions-Commit minimiert.
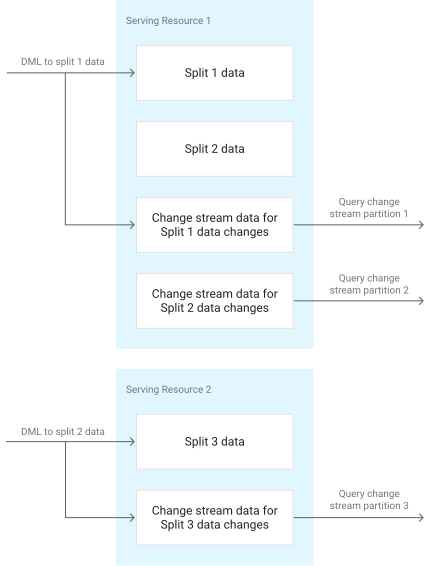
Spanner skaliert, indem Daten basierend auf Datenbanklast und -größe dynamisch aufgeteilt und zusammengeführt werden und Splits auf Serving-Ressourcen verteilt werden.
Damit Schreib- und Lesevorgänge in Änderungsstreams skaliert werden können, teilt und führt Spanner den internen Speicher für Änderungsstreams zusammen mit den Datenbankdaten auf und vermeidet so automatisch Hotspots. Damit Änderungsstreamdatensätze nahezu in Echtzeit gelesen werden können, wenn die Anzahl der Schreibvorgänge in der Datenbank skaliert wird, ist die Spanner API so konzipiert, dass ein Änderungsstream gleichzeitig mit Änderungsstreampartitionen abgefragt werden kann. Änderungsstreampartitionen werden Änderungsstream-Datenaufteilungen zugeordnet, die die Änderungsstream-Datensätze enthalten. Die Partitionen eines Änderungsstreams ändern sich im Laufe der Zeit dynamisch und hängen davon ab, wie Spanner die Datenbankdaten dynamisch aufteilt und zusammenführt.
Eine Änderungsstreampartition enthält Datensätze für einen unveränderlichen Schlüsselbereich für einen bestimmten Zeitraum. Jede Änderungsstreampartition kann in eine oder mehrere Änderungsstreampartitionen aufgeteilt oder mit anderen Änderungsstreampartitionen zusammengeführt werden. Wenn diese Ereignisse zum Aufteilen oder Zusammenführen eintreten, werden untergeordnete Partitionen erstellt, um die Änderungen für die entsprechenden unveränderlichen Schlüsselbereiche für den nächsten Zeitraum zu erfassen. Zusätzlich zu Datenänderungsdatensätzen gibt eine Änderungsstream-Abfrage untergeordnete Partitionsdatensätze zurück, um Leser über neue Änderungsstream-Partitionen zu informieren, die abgefragt werden müssen. Außerdem werden Heartbeat-Datensätze zurückgegeben, um den Fortschritt anzuzeigen, wenn in letzter Zeit keine Schreibvorgänge erfolgt sind.
Wenn Sie eine bestimmte Change Stream-Partition abfragen, werden die Änderungsdatensätze in der Reihenfolge der Commit-Zeitstempel zurückgegeben. Jeder Änderungsdatensatz wird genau einmal zurückgegeben. Die Reihenfolge der Änderungsdatensätze ist nicht garantiert. Änderungsdatensätze für einen bestimmten Primärschlüssel werden nur in einer Partition für einen bestimmten Zeitraum zurückgegeben.
Aufgrund der Abstammung der Parent-Child-Partitionen sollten Datensätze, die von untergeordneten Partitionen zurückgegeben werden, erst verarbeitet werden, nachdem Datensätze aus allen übergeordneten Partitionen verarbeitet wurden, um Änderungen für einen bestimmten Schlüssel in der Reihenfolge der Commit-Zeitstempel zu verarbeiten.
Funktionen zum Lesen des Änderungsstreams und Abfragesyntax ändern
GoogleSQL
Verwenden Sie die ExecuteStreamingSql API, um Änderungsstreams abzufragen. Spanner erstellt automatisch eine spezielle Lesefunktion zusammen mit dem Änderungsstream. Die Lesefunktion bietet Zugriff auf die Datensätze des Änderungsstreams. Die Namenskonvention für die Lesefunktion lautet READ_change_stream_name.
Angenommen, in der Datenbank ist ein Änderungsstream SingersNameStream vorhanden. Die Abfragesyntax für GoogleSQL lautet so:
SELECT ChangeRecord
FROM READ_SingersNameStream (
    start_timestamp,
    end_timestamp,
    partition_token,
    heartbeat_milliseconds,
    read_options
)
Die Funktion „read“ akzeptiert die folgenden Argumente:
| Name des Arguments | Typ | Erforderlich/Optional? | Beschreibung |
|---|---|---|---|
start_timestamp |
TIMESTAMP |
Erforderlich | Gibt an, dass Datensätze mit commit_timestamp größer oder gleich start_timestamp zurückgegeben werden sollen. Der Wert muss innerhalb des Aufbewahrungszeitraums des Änderungsstreams liegen und kleiner oder gleich der aktuellen Zeit und größer oder gleich dem Zeitstempel der Erstellung des Änderungsstreams sein. |
end_timestamp |
TIMESTAMP |
Optional (Standard: NULL) |
Gibt an, dass Datensätze mit einem commit_timestamp-Wert kleiner oder gleich end_timestamp zurückgegeben werden sollen. Der Wert muss innerhalb des Aufbewahrungszeitraums für den Änderungsstream liegen und größer oder gleich start_timestamp sein. Die Abfrage wird entweder beendet, nachdem alle ChangeRecords bis zum end_timestamp zurückgegeben wurden, oder wenn Sie die Verbindung beenden. Wenn end_timestamp auf NULL gesetzt oder nicht angegeben ist, wird die Abfrage so lange ausgeführt, bis alle ChangeRecords zurückgegeben werden oder Sie die Verbindung beenden. |
partition_token |
STRING |
Optional (Standard: NULL) |
Gibt an, welche Änderungsstream-Partition abgefragt werden soll, basierend auf dem Inhalt von Datensätzen für untergeordnete Partitionen. Wenn NULL oder nicht angegeben ist, fragt der Leser den Änderungsstream zum ersten Mal ab und hat keine bestimmten Partitionstokens zum Abfragen erhalten. |
heartbeat_milliseconds |
INT64 |
Erforderlich | Bestimmt, wie oft ein Heartbeat ChangeRecord zurückgegeben wird, wenn in dieser Partition keine Transaktionen ausgeführt werden.
Der Wert muss zwischen 100 (100 Millisekunden) und 300,000 (5 Minuten) liegen. |
read_options |
ARRAY |
Optional (Standard: NULL) |
Fügt Leseoptionen hinzu, die für die zukünftige Verwendung reserviert sind. Der einzige zulässige Wert ist NULL. |
Wir empfehlen, eine Hilfsmethode zum Erstellen des Texts der Lesefunktionsabfrage und zum Binden von Parametern daran zu erstellen, wie im folgenden Beispiel gezeigt.
Java
    private static final String SINGERS_NAME_STREAM_QUERY_TEMPLATE =
    "SELECT ChangeRecord FROM READ_SingersNameStream"
        + "("
        + "   start_timestamp => @startTimestamp,"
        + "   end_timestamp => @endTimestamp,"
        + "   partition_token => @partitionToken,"
        + "   heartbeat_milliseconds => @heartbeatMillis"
        + ")";

    // Helper method to conveniently create change stream query texts and
    // bind parameters.
    public static Statement getChangeStreamQuery(
          String partitionToken,
          Timestamp startTimestamp,
          Timestamp endTimestamp,
          long heartbeatMillis) {
      return Statement.newBuilder(SINGERS_NAME_STREAM_QUERY_TEMPLATE)
                        .bind("startTimestamp")
                        .to(startTimestamp)
                        .bind("endTimestamp")
                        .to(endTimestamp)
                        .bind("partitionToken")
                        .to(partitionToken)
                        .bind("heartbeatMillis")
                        .to(heartbeatMillis)
                        .build();
    }
PostgreSQL
Verwenden Sie die ExecuteStreamingSql API, um Änderungsstreams abzufragen. Spanner erstellt automatisch eine spezielle Lesefunktion zusammen mit dem Änderungsstream. Die Lesefunktion bietet Zugriff auf die Datensätze des Änderungsstreams. Die Namenskonvention für die Lesefunktion lautet spanner.read_json_change_stream_name.
Angenommen, in der Datenbank ist ein Änderungsstream SingersNameStream vorhanden. Die Abfragesyntax für PostgreSQL lautet:
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
    start_timestamp,
    end_timestamp,
    partition_token,
    heartbeat_milliseconds,
    read_options
)
Die Funktion „read“ akzeptiert die folgenden Argumente:
| Name des Arguments | Typ | Erforderlich/Optional? | Beschreibung |
|---|---|---|---|
start_timestamp |
timestamp with time zone |
Erforderlich | Gibt an, dass Änderungsdatensätze mit commit_timestamp größer oder gleich start_timestamp zurückgegeben werden sollen. Der Wert muss innerhalb des Aufbewahrungszeitraums des Änderungsstreams liegen und kleiner oder gleich der aktuellen Zeit sowie größer oder gleich dem Zeitstempel der Erstellung des Änderungsstreams sein. |
end_timestamp |
timestamp with time zone |
Optional (Standard: NULL) |
Gibt an, dass Änderungsdatensätze mit commit_timestamp kleiner oder gleich end_timestamp zurückgegeben werden sollen. Der Wert muss innerhalb des Aufbewahrungszeitraums des Änderungsstreams liegen und größer oder gleich start_timestamp sein.
Die Abfrage wird entweder beendet, nachdem alle Änderungsdatensätze bis zum end_timestamp zurückgegeben wurden, oder wenn Sie die Verbindung beenden.
Wenn NULL, wird die Ausführung der Abfrage fortgesetzt, bis alle Änderungsdatensätze zurückgegeben werden oder Sie die Verbindung beenden. |
partition_token |
text |
Optional (Standard: NULL) |
Gibt an, welche Änderungsstream-Partition abgefragt werden soll, basierend auf dem Inhalt von Datensätzen für untergeordnete Partitionen. Wenn NULL oder nicht angegeben ist, fragt der Leser den Änderungsstream zum ersten Mal ab und hat keine bestimmten Partitionstokens zum Abfragen erhalten. |
heartbeat_milliseconds |
bigint |
Erforderlich | Bestimmt, wie oft ein Heartbeat ChangeRecord zurückgegeben wird, wenn in dieser Partition keine Transaktionen ausgeführt werden.
Der Wert muss zwischen 100 (100 Millisekunden) und 300,000 (fünf Minuten) liegen. |
read_options |
text[] |
Optional (Standard: NULL) |
Fügt Leseoptionen hinzu, die für die zukünftige Verwendung reserviert sind. Der einzige zulässige Wert ist NULL. |
Wir empfehlen, eine Hilfsmethode zum Erstellen des Texts der Lesefunktion und zum Binden von Parametern daran zu erstellen, wie im folgenden Beispiel gezeigt.
Java
private static final String SINGERS_NAME_STREAM_QUERY_TEMPLATE =
        "SELECT * FROM \"spanner\".\"read_json_SingersNameStream\""
            + "($1, $2, $3, $4, null)";

// Helper method to conveniently create change stream query texts and
// bind parameters.
public static Statement getChangeStreamQuery(
      String partitionToken,
      Timestamp startTimestamp,
      Timestamp endTimestamp,
      long heartbeatMillis) {

  return Statement.newBuilder(SINGERS_NAME_STREAM_QUERY_TEMPLATE)
                    .bind("p1")
                    .to(startTimestamp)
                    .bind("p2")
                    .to(endTimestamp)
                    .bind("p3")
                    .to(partitionToken)
                    .bind("p4")
                    .to(heartbeatMillis)
                    .build();
}
Aufnahmeformat von Änderungsstreams ändern
GoogleSQL
Die Lesefunktion für Änderungsstreams gibt eine einzelne ChangeRecord-Spalte vom Typ ARRAY<STRUCT<...>> zurück. In jeder Zeile enthält dieses Array immer ein einzelnes Element.
Die Array-Elemente haben den folgenden Typ:
STRUCT <
  data_change_record ARRAY<STRUCT<...>>,
  heartbeat_record ARRAY<STRUCT<...>>,
  child_partitions_record ARRAY<STRUCT<...>>
>
Dieses STRUCT enthält drei Felder: data_change_record, heartbeat_record und child_partitions_record. Jedes Feld hat den Typ ARRAY<STRUCT<...>>. In jeder Zeile, die von der Funktion zum Lesen des Änderungsstreams zurückgegeben wird, enthält nur eines dieser drei Felder einen Wert. Die anderen beiden sind leer oder NULL. Diese Arrayfelder enthalten höchstens ein Element.
In den folgenden Abschnitten werden die einzelnen Datensatztypen genauer betrachtet.
PostgreSQL
Die Funktion zum Lesen von Änderungsstreams gibt eine einzelne ChangeRecord-Spalte vom Typ JSON mit der folgenden Struktur zurück:
{
  "data_change_record" : {},
  "heartbeat_record" : {},
  "child_partitions_record" : {}
}
Dieses Objekt kann drei mögliche Schlüssel enthalten: data_change_record, heartbeat_record und child_partitions_record. Der entsprechende Werttyp ist JSON. In jeder Zeile, die von der Lesefunktion für den Änderungsstream zurückgegeben wird, ist nur einer dieser drei Schlüssel vorhanden.
In den folgenden Abschnitten werden die einzelnen Datensatztypen genauer betrachtet.
Datensatz für Datenänderungen
Ein Datensatz für Datenänderungen enthält eine Reihe von Änderungen an einer Tabelle mit demselben Änderungstyp (Einfügen, Aktualisieren oder Löschen), die mit demselben Commit-Zeitstempel in einer Änderungsstreampartition für dieselbe Transaktion committet wurden. Für dieselbe Transaktion können mehrere Datensatzänderungen über mehrere Änderungsstreampartitionen zurückgegeben werden.
Alle Datenänderungsdatensätze haben die Felder commit_timestamp, server_transaction_id und record_sequence, die zusammen die Reihenfolge im Änderungsstream für einen Streamdatensatz bestimmen. Diese drei Felder reichen aus, um die Reihenfolge der Änderungen abzuleiten und für externe Konsistenz zu sorgen.
Mehrere Transaktionen können denselben Commit-Zeitstempel haben, wenn sie sich auf nicht überlappende Daten beziehen. Mit dem Feld server_transaction_id lässt sich unterscheiden, welche Änderungen (möglicherweise über Änderungsstreampartitionen hinweg) innerhalb derselben Transaktion ausgegeben wurden. Wenn Sie es mit den Feldern record_sequence und number_of_records_in_transaction kombinieren, können Sie auch alle Datensätze einer bestimmten Transaktion puffern und sortieren.
Die Felder eines Datensatzes für Datenänderungen umfassen Folgendes:
GoogleSQL
| Feld | Typ | Beschreibung |
|---|---|---|
commit_timestamp |
TIMESTAMP |
Gibt den Zeitstempel an, zu dem die Änderung übernommen wurde. |
record_sequence |
STRING |
Gibt die Sequenznummer für den Datensatz innerhalb der Transaktion an.
Sequenznummern sind innerhalb einer Transaktion eindeutig und kontinuierlich ansteigend (aber nicht unbedingt fortlaufend). Sortieren Sie die Datensätze für dieselbe server_transaction_id nach record_sequence, um die Reihenfolge der Änderungen innerhalb der Transaktion zu rekonstruieren.
Spanner optimiert diese Reihenfolge möglicherweise für eine bessere Leistung. Sie entspricht dann nicht immer der ursprünglichen Reihenfolge, die Sie angegeben haben. |
server_transaction_id |
STRING |
Stellt einen global eindeutigen String bereit, der die Transaktion darstellt, in der die Änderung per Commit übergeben wurde. Der Wert sollte nur im Zusammenhang mit der Verarbeitung von Änderungsstream-Datensätzen verwendet werden und steht nicht in Zusammenhang mit der Transaktions-ID in der Spanner API. |
is_last_record_in_transaction_in_partition |
BOOL |
Gibt an, ob dies der letzte Datensatz für eine Transaktion in der aktuellen Partition ist. |
table_name |
STRING |
Name der Tabelle, die von der Änderung betroffen ist. |
value_capture_type |
STRING |
Beschreibt den Werterfassungstyp, der in der Änderungsstreamkonfiguration angegeben wurde, als diese Änderung erfasst wurde. Der Typ der Wertzuordnung kann einer der folgenden sein:
Der Standardwert ist |
column_types |
[
  {
      "name": "STRING",
      "type": {
        "code": "STRING"
      },
      "is_primary_key": BOOLEAN
      "ordinal_position": NUMBER
    },
    ...
] |
Gibt den Namen der Spalte, den Spaltentyp, an, ob es sich um einen Primärschlüssel handelt, und die Position der Spalte, wie im Schema (ordinal_position) definiert. Die erste Spalte einer Tabelle im Schema hat die Ordnungszahl 1. Der Spaltentyp kann für Arrayspalten verschachtelt werden. Das Format entspricht der in der Spanner API-Referenz beschriebenen Typstruktur.
|
mods |
[
  {
    "keys": {"STRING" : "STRING"},
    "new_values": {
      "STRING" : "VALUE-TYPE",
      [...]
    },
    "old_values": {
      "STRING" : "VALUE-TYPE",
      [...]
    },
  },
  [...]
]
|
Beschreibt die vorgenommenen Änderungen, einschließlich der Primärschlüsselwerte, der alten Werte und der neuen Werte der geänderten oder verfolgten Spalten.
Die Verfügbarkeit und der Inhalt der alten und neuen Werte hängen von der konfigurierten value_capture_type ab. Die Felder new_values und old_values enthalten nur die Spalten, die nicht als Schlüssel verwendet werden. |
mod_type |
STRING |
Beschreibt die Art der Änderung. Entweder INSERT, UPDATE oder DELETE. |
number_of_records_in_transaction |
INT64 |
Gibt die Anzahl der Datenänderungsdatensätze an, die Teil dieser Transaktion in allen Änderungsstream-Partitionen sind. |
number_of_partitions_in_transaction |
INT64 |
Gibt die Anzahl der Partitionen an, die Datenänderungsdatensätze für diese Transaktion zurückgeben. |
transaction_tag |
STRING |
Gibt das Transaktionstag an, das mit dieser Transaktion verknüpft ist. |
is_system_transaction |
BOOL |
Gibt an, ob es sich bei der Transaktion um eine Systemtransaktion handelt. |
PostgreSQL
| Feld | Typ | Beschreibung |
|---|---|---|
commit_timestamp |
STRING |
Gibt den Zeitstempel an, zu dem die Änderung übernommen wurde. |
record_sequence |
STRING |
Gibt die Sequenznummer für den Datensatz innerhalb der Transaktion an.
Sequenznummern sind innerhalb einer Transaktion eindeutig und kontinuierlich ansteigend (aber nicht unbedingt fortlaufend). Sortieren Sie die Datensätze für dieselbe server_transaction_id nach record_sequence, um die Reihenfolge der Änderungen innerhalb der Transaktion zu rekonstruieren. |
server_transaction_id |
STRING |
Stellt einen global eindeutigen String bereit, der die Transaktion darstellt, in der die Änderung per Commit übergeben wurde. Der Wert sollte nur im Zusammenhang mit der Verarbeitung von Änderungsstream-Datensätzen verwendet werden und steht nicht in Zusammenhang mit der Transaktions-ID in der Spanner API. |
is_last_record_in_transaction_in_partition |
BOOLEAN |
Gibt an, ob dies der letzte Datensatz für eine Transaktion in der aktuellen Partition ist. |
table_name |
STRING |
Gibt den Namen der Tabelle an, die von der Änderung betroffen ist. |
value_capture_type |
STRING |
Beschreibt den Werterfassungstyp, der in der Änderungsstreamkonfiguration angegeben wurde, als diese Änderung erfasst wurde. Der Typ der Wertzuordnung kann einer der folgenden sein:
Der Standardwert ist |
column_types |
[
  {
      "name": "STRING",
      "type": {
        "code": "STRING"
      },
      "is_primary_key": BOOLEAN
      "ordinal_position": NUMBER
    },
    ...
] |
Gibt den Namen der Spalte, den Spaltentyp, an, ob es sich um einen Primärschlüssel handelt, und die Position der Spalte, wie im Schema (ordinal_position) definiert. Die erste Spalte einer Tabelle im Schema hat die Ordnungszahl 1. Der Spaltentyp kann für Arrayspalten verschachtelt werden. Das Format entspricht der in der Spanner API-Referenz beschriebenen Typstruktur.
|
mods |
[
  {
    "keys": {"STRING" : "STRING"},
    "new_values": {
      "STRING" : "VALUE-TYPE",
      [...]
    },
    "old_values": {
      "STRING" : "VALUE-TYPE",
      [...]
    },
  },
  [...]
]
|
Beschreibt die vorgenommenen Änderungen, einschließlich der Primärschlüsselwerte, der alten Werte und der neuen Werte der geänderten oder verfolgten Spalten. Die Verfügbarkeit und der Inhalt der alten und neuen Werte hängen von der konfigurierten value_capture_type ab. Die Felder new_values und old_values enthalten nur die Spalten, die nicht als Schlüsselspalten verwendet werden.
|
mod_type |
STRING |
Beschreibt die Art der Änderung. Entweder INSERT, UPDATE oder DELETE. |
number_of_records_in_transaction |
INT64 |
Gibt die Anzahl der Datenänderungsdatensätze an, die Teil dieser Transaktion in allen Änderungsstream-Partitionen sind. |
number_of_partitions_in_transaction |
NUMBER |
Gibt die Anzahl der Partitionen an, die Datenänderungsdatensätze für diese Transaktion zurückgeben. |
transaction_tag |
STRING |
Gibt das Transaktionstag an, das mit dieser Transaktion verknüpft ist. |
is_system_transaction |
BOOLEAN |
Gibt an, ob es sich bei der Transaktion um eine Systemtransaktion handelt. |
Beispiel für einen Datenänderungsdatensatz
Im Folgenden finden Sie zwei Beispiele für Datensatzänderungen. Sie beschreiben eine einzelne Transaktion, bei der eine Übertragung zwischen zwei Konten erfolgt. Die beiden Konten befinden sich in separaten Änderungsstream-Partitionen.
"data_change_record": {
  "commit_timestamp": "2022-09-27T12:30:00.123456Z",
  // record_sequence is unique and monotonically increasing within a
  // transaction, across all partitions.
  "record_sequence": "00000000",
  "server_transaction_id": "6329047911",
  "is_last_record_in_transaction_in_partition": true,

  "table_name": "AccountBalance",
  "column_types": [
    {
      "name": "AccountId",
      "type": {"code": "STRING"},
      "is_primary_key": true,
      "ordinal_position": 1
    },
    {
      "name": "LastUpdate",
      "type": {"code": "TIMESTAMP"},
      "is_primary_key": false,
      "ordinal_position": 2
    },
    {
       "name": "Balance",
       "type": {"code": "INT"},
       "is_primary_key": false,
       "ordinal_position": 3
    }
  ],
  "mods": [
    {
      "keys": {"AccountId": "Id1"},
      "new_values": {
        "LastUpdate": "2022-09-27T12:30:00.123456Z",
        "Balance": 1000
      },
      "old_values": {
        "LastUpdate": "2022-09-26T11:28:00.189413Z",
        "Balance": 1500
      },
    }
  ],
  "mod_type": "UPDATE", // options are INSERT, UPDATE, DELETE
  "value_capture_type": "OLD_AND_NEW_VALUES",
  "number_of_records_in_transaction": 2,
  "number_of_partitions_in_transaction": 2,
  "transaction_tag": "app=banking,env=prod,action=update",
  "is_system_transaction": false,
}
"data_change_record": {
  "commit_timestamp": "2022-09-27T12:30:00.123456Z",
  "record_sequence": "00000001",
  "server_transaction_id": "6329047911",
  "is_last_record_in_transaction_in_partition": true,

  "table_name": "AccountBalance",
  "column_types": [
    {
      "name": "AccountId",
      "type": {"code": "STRING"},
      "is_primary_key": true,
      "ordinal_position": 1
    },
    {
      "name": "LastUpdate",
      "type": {"code": "TIMESTAMP"},
      "is_primary_key": false,
      "ordinal_position": 2
    },
    {
      "name": "Balance",
      "type": {"code": "INT"},
      "is_primary_key": false,
      "ordinal_position": 3
    }
  ],
  "mods": [
    {
      "keys": {"AccountId": "Id2"},
      "new_values": {
        "LastUpdate": "2022-09-27T12:30:00.123456Z",
        "Balance": 2000
      },
      "old_values": {
        "LastUpdate": "2022-01-20T11:25:00.199915Z",
        "Balance": 1500
      },
    },
    ...
  ],
  "mod_type": "UPDATE", // options are INSERT, UPDATE, DELETE
  "value_capture_type": "OLD_AND_NEW_VALUES",
  "number_of_records_in_transaction": 2,
  "number_of_partitions_in_transaction": 2,
  "transaction_tag": "app=banking,env=prod,action=update",
  "is_system_transaction": false,
}
Der folgende Datensatz für Datenänderungen ist ein Beispiel für einen Datensatz mit dem Erfassungstyp NEW_VALUES. Es werden nur neue Werte eingefügt.
Nur die Spalte LastUpdate wurde geändert, daher wurde nur diese Spalte zurückgegeben.
"data_change_record": {
  "commit_timestamp": "2022-09-27T12:30:00.123456Z",
  // record_sequence is unique and monotonically increasing within a
  // transaction, across all partitions.
  "record_sequence": "00000000",
  "server_transaction_id": "6329047911",
  "is_last_record_in_transaction_in_partition": true,
  "table_name": "AccountBalance",
  "column_types": [
    {
      "name": "AccountId",
      "type": {"code": "STRING"},
      "is_primary_key": true,
      "ordinal_position": 1
    },
    {
      "name": "LastUpdate",
      "type": {"code": "TIMESTAMP"},
      "is_primary_key": false,
      "ordinal_position": 2
    }
  ],
  "mods": [
    {
      "keys": {"AccountId": "Id1"},
      "new_values": {
        "LastUpdate": "2022-09-27T12:30:00.123456Z"
      },
      "old_values": {}
    }
  ],
  "mod_type": "UPDATE", // options are INSERT, UPDATE, DELETE
  "value_capture_type": "NEW_VALUES",
  "number_of_records_in_transaction": 1,
  "number_of_partitions_in_transaction": 1,
  "transaction_tag": "app=banking,env=prod,action=update",
  "is_system_transaction": false
}
Der folgende Datensatz für Datenänderungen ist ein Beispiel für einen Datensatz mit dem Erfassungstyp NEW_ROW. Nur die Spalte LastUpdate wurde geändert, aber alle erfassten Spalten werden zurückgegeben.
"data_change_record": {
  "commit_timestamp": "2022-09-27T12:30:00.123456Z",
  // record_sequence is unique and monotonically increasing within a
  // transaction, across all partitions.
  "record_sequence": "00000000",
  "server_transaction_id": "6329047911",
  "is_last_record_in_transaction_in_partition": true,

  "table_name": "AccountBalance",
  "column_types": [
    {
      "name": "AccountId",
      "type": {"code": "STRING"},
      "is_primary_key": true,
      "ordinal_position": 1
    },
    {
      "name": "LastUpdate",
      "type": {"code": "TIMESTAMP"},
      "is_primary_key": false,
      "ordinal_position": 2
    },
    {
       "name": "Balance",
       "type": {"code": "INT"},
       "is_primary_key": false,
       "ordinal_position": 3
    }
  ],
  "mods": [
    {
      "keys": {"AccountId": "Id1"},
      "new_values": {
        "LastUpdate": "2022-09-27T12:30:00.123456Z",
        "Balance": 1000
      },
      "old_values": {}
    }
  ],
  "mod_type": "UPDATE", // options are INSERT, UPDATE, DELETE
  "value_capture_type": "NEW_ROW",
  "number_of_records_in_transaction": 1,
  "number_of_partitions_in_transaction": 1,
  "transaction_tag": "app=banking,env=prod,action=update",
  "is_system_transaction": false
}
Der folgende Datensatz für Datenänderungen ist ein Beispiel für einen Datensatz mit dem Erfassungstyp NEW_ROW_AND_OLD_VALUES. Nur die Spalte LastUpdate wurde geändert, aber alle erfassten Spalten werden zurückgegeben. Mit diesem Erfassungstyp werden der neue und der alte Wert von LastUpdate erfasst.
"data_change_record": {
  "commit_timestamp": "2022-09-27T12:30:00.123456Z",
  // record_sequence is unique and monotonically increasing within a
  // transaction, across all partitions.
  "record_sequence": "00000000",
  "server_transaction_id": "6329047911",
  "is_last_record_in_transaction_in_partition": true,

  "table_name": "AccountBalance",
  "column_types": [
    {
      "name": "AccountId",
      "type": {"code": "STRING"},
      "is_primary_key": true,
      "ordinal_position": 1
    },
    {
      "name": "LastUpdate",
      "type": {"code": "TIMESTAMP"},
      "is_primary_key": false,
      "ordinal_position": 2
    },
    {
       "name": "Balance",
       "type": {"code": "INT"},
       "is_primary_key": false,
       "ordinal_position": 3
    }
  ],
  "mods": [
    {
      "keys": {"AccountId": "Id1"},
      "new_values": {
        "LastUpdate": "2022-09-27T12:30:00.123456Z",
        "Balance": 1000
      },
      "old_values": {
        "LastUpdate": "2022-09-26T11:28:00.189413Z"
      }
    }
  ],
  "mod_type": "UPDATE", // options are INSERT, UPDATE, DELETE
  "value_capture_type": "NEW_ROW_AND_OLD_VALUES",
  "number_of_records_in_transaction": 1,
  "number_of_partitions_in_transaction": 1,
  "transaction_tag": "app=banking,env=prod,action=update",
  "is_system_transaction": false
}
Heartbeat-Einträge
Wenn ein Heartbeat-Datensatz zurückgegeben wird, bedeutet das, dass alle Änderungen mit commit_timestamp, die kleiner oder gleich dem timestamp des Heartbeat-Datensatzes sind, zurückgegeben wurden. Zukünftige Datensätze in dieser Partition müssen höhere Commit-Zeitstempel haben als der, der vom Heartbeat-Datensatz zurückgegeben wurde. Heartbeat-Datensätze werden zurückgegeben, wenn keine Datenänderungen in eine Partition geschrieben werden. Wenn Datenänderungen in die Partition geschrieben werden, kann data_change_record.commit_timestamp anstelle von heartbeat_record.timestamp verwendet werden, um anzugeben, dass der Leser beim Lesen der Partition vorankommt.
Sie können Heartbeat-Datensätze verwenden, die für Partitionen zurückgegeben werden, um Leser über alle Partitionen hinweg zu synchronisieren. Sobald alle Leser entweder einen Heartbeat mit einem Zeitstempel größer oder gleich A oder Daten oder untergeordnete Partitionsdatensätze mit einem Zeitstempel größer oder gleich A empfangen haben, wissen sie, dass sie alle Datensätze empfangen haben, die vor oder zu diesem Zeitstempel A committet wurden. Sie können dann mit der Verarbeitung der gepufferten Datensätze beginnen, z. B. die partitionsübergreifenden Datensätze nach Zeitstempel sortieren und nach server_transaction_id gruppieren.
Ein Heartbeat-Datensatz enthält nur ein Feld:
GoogleSQL
| Feld | Typ | Beschreibung |
|---|---|---|
timestamp |
TIMESTAMP |
Gibt den Zeitstempel des Heartbeat-Datensatzes an. |
PostgreSQL
| Feld | Typ | Beschreibung |
|---|---|---|
timestamp |
STRING |
Gibt den Zeitstempel des Heartbeat-Datensatzes an. |
Beispiel für einen Heartbeat-Eintrag
Beispiel für einen Heartbeat-Datensatz, der angibt, dass alle Datensätze mit Zeitstempeln, die kleiner oder gleich dem Zeitstempel dieses Datensatzes sind, zurückgegeben wurden:
heartbeat_record: {
  "timestamp": "2022-09-27T12:35:00.312486Z"
}
Untergeordnete Partitionsdatensätze
„Child partition records“ gibt Informationen zu untergeordneten Partitionen zurück: ihre Partitionstokens, die Tokens ihrer übergeordneten Partitionen und die start_timestamp, die den frühesten Zeitstempel darstellt, für den die untergeordneten Partitionen Änderungsdatensätze enthalten. Einträge, deren Commit-Zeitstempel unmittelbar vor child_partitions_record.start_timestamp liegen, werden in der aktuellen Partition zurückgegeben. Nachdem alle untergeordneten Partitionsdatensätze für diese Partition zurückgegeben wurden, wird diese Abfrage mit dem Status „Erfolgreich“ zurückgegeben. Das bedeutet, dass alle Datensätze für diese Partition zurückgegeben wurden.
Die Felder eines untergeordneten Partitionsdatensatzes umfassen Folgendes:
GoogleSQL
| Feld | Typ | Beschreibung |
|---|---|---|
start_timestamp |
TIMESTAMP |
Gibt an, dass die Datenänderungsdatensätze, die von untergeordneten Partitionen in diesem untergeordneten Partitionsdatensatz zurückgegeben werden, einen Commit-Zeitstempel haben, der größer oder gleich start_timestamp ist. Wenn Sie eine untergeordnete Partition abfragen, muss in der Abfrage das Token der untergeordneten Partition und ein start_timestamp angegeben werden, das größer oder gleich child_partitions_token.start_timestamp ist. Alle untergeordneten Partitionen, die von einer Partition zurückgegeben werden, haben denselben start_timestamp. Der Zeitstempel liegt immer zwischen dem in der Abfrage angegebenen start_timestamp und end_timestamp. |
record_sequence |
STRING |
Gibt eine monoton steigende Sequenznummer an, mit der die Reihenfolge der untergeordneten Partitionsdatensätze definiert werden kann, wenn mehrere untergeordnete Partitionsdatensätze mit derselben start_timestamp in einer bestimmten Partition zurückgegeben werden. Mit dem Partitionstoken start_timestamp und record_sequence wird ein untergeordneter Partitionsdatensatz eindeutig identifiziert.
|
child_partitions |
[
  {
    "token" : "STRING",
    "parent_partition_tokens" : ["STRING"]
  }
] |
Gibt eine Reihe von untergeordneten Partitionen und die zugehörigen Informationen zurück. Dazu gehören der Partitionstoken-String, mit dem die untergeordnete Partition in Abfragen identifiziert wird, sowie die Tokens der übergeordneten Partitionen. |
PostgreSQL
| Feld | Typ | Beschreibung |
|---|---|---|
start_timestamp |
STRING |
Gibt an, dass die Datenänderungsdatensätze, die von untergeordneten Partitionen in diesem untergeordneten Partitionsdatensatz zurückgegeben werden, einen Commit-Zeitstempel haben, der größer oder gleich start_timestamp ist. Wenn Sie eine untergeordnete Partition abfragen, muss in der Abfrage das Token der untergeordneten Partition und ein start_timestamp größer als oder gleich child_partitions_token.start_timestamp angegeben werden. Alle untergeordneten Partitionen, die von einer Partition zurückgegeben werden, haben denselben start_timestamp und der Zeitstempel liegt immer zwischen dem in der Abfrage angegebenen start_timestamp und end_timestamp.
|
record_sequence |
STRING |
Gibt eine monoton steigende Sequenznummer an, mit der die Reihenfolge der untergeordneten Partitionsdatensätze definiert werden kann, wenn mehrere untergeordnete Partitionsdatensätze mit derselben start_timestamp in einer bestimmten Partition zurückgegeben werden. Mit dem Partitionstoken start_timestamp und record_sequence wird ein untergeordneter Partitionsdatensatz eindeutig identifiziert.
|
child_partitions |
[
  {
    "token": "STRING",
    "parent_partition_tokens": ["STRING"],
  }, [...]
] |
Gibt ein Array von untergeordneten Partitionen und den zugehörigen Informationen zurück. Dazu gehören der Partitionstoken-String, mit dem die untergeordnete Partition in Abfragen identifiziert wird, sowie die Tokens der übergeordneten Partitionen. |
Beispiel für einen untergeordneten Partitionseintrag
Hier ein Beispiel für einen untergeordneten Partitionsdatensatz:
child_partitions_record: {
  "start_timestamp": "2022-09-27T12:40:00.562986Z",
  "record_sequence": "00000001",
  "child_partitions": [
    {
      "token": "child_token_1",
      // To make sure changes for a key is processed in timestamp
      // order, wait until the records returned from all parents
      // have been processed.
      "parent_partition_tokens": ["parent_token_1", "parent_token_2"]
    }
  ],
}
Workflow für Änderungsstream-Abfragen
Führen Sie Änderungsstream-Abfragen mit der ExecuteStreamingSql API mit einer einmaligen Lesezugriff-Transaktion und einer starken Zeitstempelgrenze aus. Mit der Funktion zum Lesen des Änderungsstreams können Sie start_timestamp und end_timestamp für den interessierenden Zeitraum angeben. Alle Änderungsdatensätze innerhalb des Aufbewahrungszeitraums sind über die starke Zeitstempelgrenze mit Lesezugriff zugänglich.
Alle anderen
TransactionOptions
sind für Änderungsstream-Abfragen ungültig. Wenn TransactionOptions.read_only.return_read_timestamp auf true festgelegt ist, wird in der Transaction-Nachricht, die die Transaktion beschreibt, anstelle eines gültigen Lesezeitstempels der spezielle Wert kint64max - 1 zurückgegeben. Dieser spezielle Wert sollte verworfen und nicht für nachfolgende Anfragen verwendet werden.
Jede Änderungsstream-Abfrage kann beliebig viele Zeilen zurückgeben, die jeweils einen Datensatz zu Datenänderungen, einen Heartbeat-Datensatz oder einen Datensatz zu untergeordneten Partitionen enthalten. Sie müssen keine Frist für die Anfrage festlegen.
Beispiel für einen Workflow für Änderungsstream-Abfragen
Der Workflow für Änderungsstreams beginnt mit der Ausführung der ersten Änderungsstream-Abfrage, indem partition_token auf NULL festgelegt wird. In der Abfrage müssen die Lesefunktion für den Änderungsstream, der Start- und Endzeitstempel des interessierenden Zeitraums sowie das Heartbeat-Intervall angegeben werden. Wenn end_timestamp gleich NULL ist, werden in der Abfrage weiterhin Datenänderungen zurückgegeben, bis die Partition endet.
GoogleSQL
SELECT ChangeRecord FROM READ_SingersNameStream (
  start_timestamp => "2022-05-01T09:00:00Z",
  end_timestamp => NULL,
  partition_token => NULL,
  heartbeat_milliseconds => 10000
);
PostgreSQL
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
  '2022-05-01T09:00:00Z',
  NULL,
  NULL,
  10000,
  NULL
) ;
Verarbeiten Sie Datensätze aus dieser Abfrage, bis alle untergeordneten Partitionsdatensätze zurückgegeben werden. Im folgenden Beispiel werden zwei untergeordnete Partitionsdatensätze und drei Partitionstokens zurückgegeben. Danach wird die Abfrage beendet. Untergeordnete Partitionseinträge aus einer bestimmten Abfrage haben immer dieselbe start_timestamp.
child_partitions_record: {
  "record_type": "child_partitions",
  "start_timestamp": "2022-05-01T09:00:01Z",
  "record_sequence": "1000012389",
  "child_partitions": [
    {
      "token": "child_token_1",
      // Note parent tokens are null for child partitions returned
        // from the initial change stream queries.
      "parent_partition_tokens": [NULL]
    }
    {
      "token": "child_token_2",
      "parent_partition_tokens": [NULL]
    }
  ],
}
child_partitions_record: {
  "record_type": "child_partitions",
  "start_timestamp": "2022-05-01T09:00:01Z",
  "record_sequence": "1000012390",
  "child_partitions": [
    {
      "token": "child_token_3",
      "parent_partition_tokens": [NULL]
    }
  ],
}
Wenn Sie Änderungen nach dem 2022-05-01T09:00:01Z verarbeiten möchten, erstellen Sie drei neue Abfragen und führen Sie sie parallel aus. Zusammen liefern die drei Abfragen Datenänderungen für denselben Schlüsselbereich wie die übergeordnete Abfrage. Legen Sie start_timestamp immer auf start_timestamp im selben untergeordneten Partitionseintrag fest und verwenden Sie dasselbe end_timestamp und dasselbe Heartbeat-Intervall, um die Datensätze in allen Abfragen einheitlich zu verarbeiten.
GoogleSQL
SELECT ChangeRecord FROM READ_SingersNameStream (
  start_timestamp => "2022-05-01T09:00:01Z",
  end_timestamp => NULL,
  partition_token => "child_token_1",
  heartbeat_milliseconds => 10000
);
SELECT ChangeRecord FROM READ_SingersNameStream (
  start_timestamp => "2022-05-01T09:00:01Z",
  end_timestamp => NULL,
  partition_token => "child_token_2",
  heartbeat_milliseconds => 10000
);
SELECT ChangeRecord FROM READ_SingersNameStream (
  start_timestamp => "2022-05-01T09:00:01Z",
  end_timestamp => NULL,
  partition_token => "child_token_3",
  heartbeat_milliseconds => 10000
);
PostgreSQL
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
  '2022-05-01T09:00:01Z',
  NULL,
  'child_token_1',
  10000,
  NULL
);
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
  '2022-05-01T09:00:01Z',
  NULL,
  'child_token_2',
  10000,
  NULL
);
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
  '2022-05-01T09:00:01Z',
  NULL,
  'child_token_3',
  10000,
  NULL
);
Die Abfrage für child_token_2 wird beendet, nachdem ein weiterer untergeordneter Partitionseintrag zurückgegeben wurde. Dieser Datensatz gibt an, dass eine neue Partition Änderungen für child_token_2 und child_token_3 ab dem 2022-05-01T09:30:15Z abdeckt. Der genau gleiche Datensatz wird von der Abfrage für child_token_3 zurückgegeben, da beide die übergeordneten Partitionen der neuen child_token_4 sind. Damit die Datensätze für einen bestimmten Schlüssel in einer strengen Reihenfolge verarbeitet werden, muss die Abfrage für child_token_4 erst gestartet werden, wenn alle übergeordneten Elemente abgeschlossen sind. In diesem Fall sind die übergeordneten Elemente child_token_2 und child_token_3. Erstellen Sie nur eine Abfrage für jedes untergeordnete Partitionstoken. Im Design des Abfrageworkflows sollte ein übergeordneter Knoten festgelegt werden, der wartet und die Abfrage für child_token_4 plant.
child_partitions_record: {
  "record_type": "child_partitions",
  "start_timestamp": "2022-05-01T09:30:15Z",
  "record_sequence": "1000012389",
  "child_partitions": [
    {
      "token": "child_token_4",
      "parent_partition_tokens": ["child_token_2", "child_token_3"],
    }
  ],
}
GoogleSQL
SELECT ChangeRecord FROM READ_SingersNameStream(
  start_timestamp => "2022-05-01T09:30:15Z",
  end_timestamp => NULL,
  partition_token => "child_token_4",
  heartbeat_milliseconds => 10000
);
PostgreSQL
SELECT *
FROM "spanner"."read_json_SingersNameStream" (
  '2022-05-01T09:30:15Z',
  NULL,
  'child_token_4',
  10000,
  NULL
);
Beispiele für die Verarbeitung und das Parsen von Änderungsstream-Datensätzen im Dataflow-Connector „Apache Beam SpannerIO“ finden Sie auf GitHub.