


本页介绍了两种 Sensitive Data Protection 服务(发现服务和检查服务),并对这两种服务进行了比较,以帮助您了解自己的数据并实现数据治理工作流。
敏感数据发现
发现服务会监控组织中的数据。此服务会持续运行,并自动发现、分类和分析数据。探索功能可帮助您了解所存储数据的位置和性质,包括您可能不知道的数据资源。未知数据(有时称为影子数据)通常不会像已知数据那样接受相同级别的数据治理和风险管理。
您可以在各种范围内配置发现。您可以为不同的数据子集设置不同的分析时间表。您还可以排除不需要进行分析的数据子集。
发现扫描输出:数据剖析文件
发现扫描的输出是一组数据分析,其中包含范围内每个数据资源的分析结果。例如,对 BigQuery 或 Cloud SQL 数据进行发现扫描会在项目、表和列级别生成数据剖析文件。
数据分析包含有关所分析资源的指标和分析洞见。它包括数据分类(或 infoType)、敏感度级别、数据风险级别、数据大小、数据形状以及描述数据性质及其数据安全状况(数据安全程度)的其他元素。您可以利用数据分析结果,就如何保护数据做出明智的决策,例如,通过在表上设置访问权限政策。
假设有一个名为 ccn 的 BigQuery 列,其中每行都包含一个唯一的信用卡号,并且没有 null 值。生成的列级数据分析文件将包含以下详细信息:
| 显示名称 | 值 |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
此外,此列级剖析文件是表级剖析文件的一部分,可提供数据位置、加密状态以及表是否公开共享等数据洞见。在 Google Cloud 控制台中,您还可以查看表的 Cloud Logging 条目以及具有表角色的 IAM 主账号。
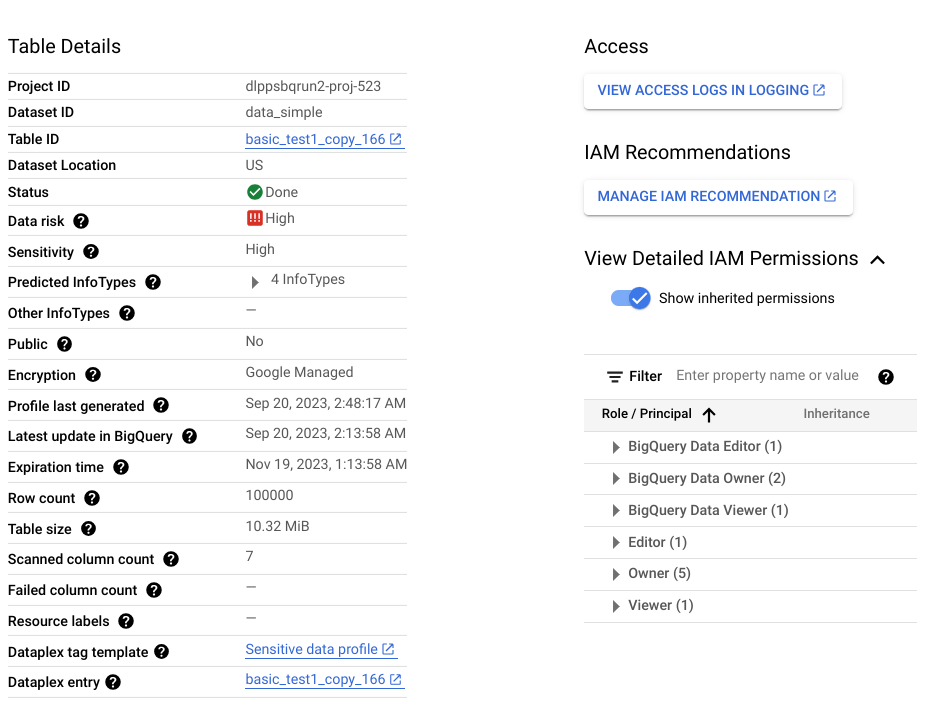
如需查看数据剖析文件中包含的指标和数据洞见的完整列表,请参阅指标参考文档。
何时使用发现功能
在规划数据风险管理方法时,我们建议您先进行发现。发现服务可帮助您全面了解数据,并实现问题提醒、报告和补救。
以下是一些常见使用场景:
- 全面了解云环境:持续扫描和分析组织、文件夹或项目中的所有数据资产,而无需创建单独的扫描作业。
- 发现影子数据和非受管的存储库:检测缺乏适当治理或访问权限控制的新建或未分类的表和存储桶。
- 根据风险评分确定安全计划的优先级:将补救和保护资源集中用于敏感度高且数据风险得分高的数据存储库。
- 确定需要进行深度检查的候选对象:确定具有较高自由文本得分的表和存储桶,这些表和存储桶包含需要进行精细扫描的非结构化评论或评价。
敏感数据检查
检查服务会对单个资源执行详尽的扫描,以找到每个敏感数据实例。每次检查都会为检测到的每个实例生成一个发现结果。
检查作业提供了一组丰富的配置选项,可帮助您精确定位要检查的数据。例如,您可以启用抽样,将要检查的数据限制为特定行数(对于 BigQuery 数据)或特定文件类型(对于 Cloud Storage 数据)。您还可以指定数据创建或修改的具体时间范围。
与持续监控数据的发现不同,检查是一项按需操作。不过,您可以安排周期性检查作业,即作业触发器。
检查扫描输出:发现结果
每个发现结果都包含详细信息,例如检测到的实例的位置、其 潜在的 infoType,以及发现结果与 infoType 匹配的确定性(也称为 可能性)。根据您的设置,您还可以获取与发现结果相关的实际字符串;在 Sensitive Data Protection 中,此字符串称为“引用”。
如需查看检查发现结果中包含的详细信息的完整列表,请参阅 Finding。
何时使用检查
以下是一些常见使用场景:
- 扫描非结构化文本和自由格式字段:在客户评论、反馈表单、支持工单和文档库中查找个人身份信息 (PII) 的每个具体实例。
- 对单个资源执行时间点合规性审核:生成详细的发现结果报告,其中记录了目标表或存储桶中所有敏感项的确切字节和行位置。
- 检查混合云和多云数据流:直接从本地服务器、ETL 流水线或外部云流式传输载荷,以在 Google Cloud中生成集中式发现报告。
- 触发自动隔离和提醒工作流:将检测到的结果发布到 Pub/Sub 或直接保存到 BigQuery 表中,以实现事件驱动型修复。
何时不应使用检查
如果同时满足以下两个条件,检查资源就没什么用处。 通过发现扫描,您可以确定是否需要进行检查扫描。
- 资源中只有结构化数据。也就是说,没有自由格式的数据列,例如用户评论或评价。
- 您已了解相应资源中存储的 infoType。
例如,假设某次发现扫描的数据剖析结果表明,某个 BigQuery 表没有包含非结构化数据的列,但有一个包含唯一信用卡号的列。在这种情况下,检查表格中是否存在信用卡号就没什么用处。检查将为列中的每个项生成一个发现。如果您有 100 万行,并且每行包含 1 个信用卡号,则检查作业将针对 CREDIT_CARD_NUMBER infoType 生成 100 万个发现结果。在此示例中,由于发现扫描已表明该列包含唯一的信用卡号,因此无需进行检查。
数据驻留、处理和存储
发现和检查功能均支持数据驻留要求:
- 发现服务会在数据所在的位置处理数据,并将生成的数据分析文件存储在与分析数据相同的区域或多区域中。如需了解详情,请参阅数据驻留注意事项。
- 在检查 Google Cloud 存储系统中的数据时,检查服务会在数据所在的同一区域中处理数据,并将检查作业存储在该区域中。通过混合作业或
content方法检查数据时,检查服务可让您指定应在何处处理数据。如需了解详情,请参阅数据存储方式。
比较摘要:发现和检查服务
| 发现 | 检查 | |
|---|---|---|
| 优势 |
|
|
| 费用 |
在用量模式下,10 TB 的费用约为每月 300 美元。 |
如果是 10 TB,费用大约为每次扫描 10,000 美元。 |
| 支持的数据源 | BigLake BigQuery Cloud Run 函数环境变量 Cloud Run 服务修订版本环境变量 Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore 混合(任意来源)1 |
| 支持的作用域 |
|
单个 BigQuery 表、Cloud Storage 存储桶或 Datastore 种类。 |
| 内置检查模板 | 是 | 是 |
| 内置和自定义 infoType | 是 | 是 |
| 扫描输出 | 所有受支持数据的简要概览(数据分析文件)。 | 被检查资源中敏感数据的具体发现结果。 |
| 将结果保存到 BigQuery | 是 | 是 |
| 以标记形式发送到 Knowledge Catalog(已弃用) | 是 | 是 |
| 以切面形式发送到 Knowledge Catalog | 是 | 否 |
| 将结果发布到 Security Command Center | 是 | 是 |
| 将发现结果发布到 Google Security Operations | 是 适用于组织级和文件夹级发现 | 否 |
| 发布到 Pub/Sub | 是 | 是 |
| 数据驻留支持 | 是 | 是 |
1 混合检查采用不同的价格模式。如需了解详情,请参阅检查来自任意来源的数据 。
后续步骤
- 了解用于降低数据风险的推荐策略(本系列的下一个文档)