


בדף הזה מוסבר איך לייבא את פרטי הקטלוג ולעדכן אותם.
ההליכים לייבוא שמתוארים בדף הזה רלוונטיים גם להמלצות וגם לחיפוש. אחרי שמייבאים נתונים, שני השירותים יכולים להשתמש בהם, כך שלא צריך לייבא את אותם נתונים פעמיים אם משתמשים בשני השירותים.
אפשר לייבא את נתוני המוצרים מ-BigQuery או לציין את הנתונים בשורת הבקשה. כל אחת מהפעולות האלה היא ייבוא חד-פעמי, למעט קישור חשבון Merchant Center. כדאי לתזמן ייבוא קטלוגים באופן קבוע (רצוי מדי יום) כדי לוודא שהקטלוג עדכני.
אפשר גם לייבא פריטי מוצר ספציפיים. מידע נוסף זמין במאמר בנושא העלאת מוצר.
לפני שמתחילים
לפני שמתחילים לייבא את הקטלוג, צריך:
- מגדירים את הפרויקט.
- יוצרים חשבון שירות.
- מוסיפים את חשבון השירות לסביבה המקומית.
מידע נוסף זמין במאמר בנושא תנאים מוקדמים להגדרה.
שיקולים לגבי ייבוא קטלוג
בקטע הזה מתוארות השיטות שבהן אפשר להשתמש לייבוא באצווה של נתוני הקטלוג, מתי כדאי להשתמש בכל שיטה ומה המגבלות שלהן.
| BigQuery | תיאור | ייבוא נתונים מטבלת BigQuery שנשמרו בה נתונים בעבר, ושנעשה בה שימוש בסכמת החיפוש של AI Commerce. אפשר לבצע את הפעולה באמצעות מסוף Google Cloud או curl. |
|---|---|---|
| מתי כדאי להשתמש |
אם יש לכם קטלוגי מוצרים עם הרבה מאפיינים. הייבוא ל-BigQuery מתבצע באמצעות סכימת החיפוש של AI Commerce, שכוללת יותר מאפייני מוצר מאפשרויות ייבוא אחרות, כולל מאפיינים מותאמים אישית של מפתח/ערך.
אם יש לכם נפחים גדולים של נתונים. אין הגבלה על כמות הנתונים שניתן לייבא מ-BigQuery. אם אתם כבר משתמשים ב-BigQuery. |
|
| מגבלות | נדרש שלב נוסף של יצירת טבלה ב-BigQuery שממפה לסכימה של AI Commerce Search. | |
| Cloud Storage | תיאור |
ייבוא נתונים בפורמט JSON מקבצים שנטענו לקטגוריה של Cloud Storage. כל קובץ צריך להיות בגודל של 2GB או פחות, ואפשר לייבא עד 100 קבצים בכל פעם. אפשר לבצע את הייבוא באמצעות מסוף Google Cloud או curl. הפורמט של הנתונים הוא JSON Product, שמאפשר להשתמש במאפיינים מותאמים אישית.
|
| מתי כדאי להשתמש | אם אתם צריכים לטעון כמות גדולה של נתונים בשלב אחד. | |
| מגבלות | לא מומלץ לקטלוגים עם עדכונים תכופים של מלאי ומחירים, כי השינויים לא משתקפים באופן מיידי. | |
| ייבוא בתוך השורה | תיאור |
מייבאים באמצעות קריאה ל-Product.import. משתמש באובייקט ProductInlineSource, שיש לו פחות מאפיינים של קטלוג מוצרים מאשר לסכימת AI Commerce Search, אבל הוא תומך במאפיינים בהתאמה אישית.
|
| מתי כדאי להשתמש | אם יש לכם נתוני קטלוג שטוחים ולא רלציוניים, או אם אתם מעדכנים את הכמויות או המחירים בתדירות גבוהה. | |
| מגבלות | אפשר לייבא עד 100 פריטים לקטלוג בכל פעם. אבל אפשר לבצע הרבה שלבי טעינה, אין הגבלה על מספר הפריטים. |
מדריכים
בקטע הזה נסביר על שיטות שונות לייבוא קטלוגים, באמצעות הדרכות בווידאו וב-Shell.
סרטון הדרכה
בסרטון הזה מוסבר איך לייבא קטלוג באמצעות AI Commerce Search API.
מדריך לייבוא קטלוג מ-BigQuery
במדריך הזה נסביר איך להשתמש בטבלה ב-BigQuery כדי לייבא כמויות גדולות של נתוני קטלוג ללא הגבלות.
בלחיצה על תראו לי איך תקבלו הסבר מפורט על המשימה ישירות ב-Cloud Shell Editor:
הדרכה בנושא ייבוא קטלוג מ-Cloud Storage
במדריך הזה נסביר איך לייבא מספר גדול של פריטים לקטלוג.
בלחיצה על תראו לי איך תקבלו הסבר מפורט על המשימה ישירות ב-Cloud Shell Editor:
מדריך לייבוא נתוני קטלוג
במדריך הזה מוסבר איך לייבא מוצרים לקטלוג באופן מוטמע.
בלחיצה על תראו לי איך תקבלו הסבר מפורט על המשימה ישירות ב-Cloud Shell Editor:
שיטות מומלצות לייבוא קטלוגים
כדי ליצור תוצאות באיכות גבוהה, צריך נתונים באיכות גבוהה. אם בנתונים שלכם חסרים שדות או שיש ערכי זמני לשמירת מקום (פלייסהולדר) במקום ערכים בפועל, איכות התחזיות ותוצאות החיפוש נפגעת.
כשמייבאים נתוני קטלוג, חשוב להקפיד על שיטות העבודה המומלצות הבאות:
חשוב להבחין היטב בין מוצרים ראשיים לבין משפחות מוצרים. לפני שמעלים נתונים, כדאי לעיין במאמר בנושא רמות מוצרים.
לשנות את ההגדרה ברמת המוצר אחרי שהשקעתם מאמץ משמעותי בייבוא נתונים. פריטים ראשיים – לא וריאציות – מוחזרים כתוצאות חיפוש או כהמלצות.
דוגמה: אם קבוצת המק"טים הראשית היא חולצת וי, מודל ההמלצות יחזיר חולצת וי, ואולי גם חולצות עם צווארון עגול וצווארון סקופ. אבל אם לא משתמשים בווריאציות וכל מק"ט הוא ראשי, כל שילוב של צבע ומידה של חולצת וי מחזיר פריט נפרד בחלונית ההמלצות: חולצת וי חומה, מידה XL, חולצת וי חומה, מידה L עד חולצת וי לבנה, מידה M, חולצת וי לבנה, מידה S.
המערכת יכולה לזהות את כל הווריאציות ביחד אם כוללים את מזהי הווריאציות לצד מזהי המוצרים הראשיים ב-
collectionMemberIds[]. כתוצאה מכך, אוסף מוצרים שממנו המשתמש רכש מוצר אחד או יותר נרשם באירוע המשתמש, והמערכת משייכת את כל המוצרים לרכישה. כך קל יותר להציג לאותו משתמש מוצרים אחרים באוסף נתון בשאילתה קשורה עתידית.דוגמה: משתמש רכש בעבר כיסוי שמיכה, ולכן המערכת מחזירה מוצרים תואמים באוסף של סדינים, כמו ציפיות.
חשוב לשים לב למגבלות על ייבוא פריטי מוצרים.
לייבוא בכמות גדולה מ-Cloud Storage, הגודל של כל קובץ צריך להיות עד 2GB. אפשר לכלול עד 100 קבצים בכל בקשת ייבוא בכמות גדולה.
בייבוא מוטבע, אפשר לייבא עד 5,000 פריטי מוצר בכל פעם.
חשוב לוודא שהפרטים הנדרשים בקטלוג כלולים ונכונים. אל תשתמשו בערכים זמניים לשמירת מקום (placeholder).
כדאי לכלול כמה שיותר פרטים אופציונליים בקטלוג.
חשוב לוודא שבכל האירועים נעשה שימוש במטבע אחד, במיוחד אם אתם מתכננים להשתמש בGoogle Cloud מסוף כדי לקבל מדדי הכנסה. AI Commerce Search API לא תומך בשימוש בכמה מטבעות לכל קטלוג.
מומלץ לעדכן את הקטלוג מדי יום. תזמון של ייבוא קטלוגים תקופתי מונע ירידה באיכות המודל לאורך זמן. כשמייבאים את הקטלוג באמצעות AI Commerce Search במסוף Gemini Enterprise for Customer Experience, אפשר לתזמן ייבוא אוטומטי חוזר. אפשר גם להשתמש ב-Google Cloud Scheduler כדי להגדיר ייבוא אוטומטי.
לא מתעדים אירועים של משתמשים לגבי פריטים במוצר שעדיין לא יובאו.
אחרי שמייבאים את פרטי הקטלוג, כדאי לעיין בError Reporting ורישום ביומן בפרויקט. אם מופיעות יותר מכמה שגיאות, צריך לבדוק אותן ולתקן את הבעיות בתהליך שגרמו לשגיאות.
צינור ההטמעה של נתונים בAI Commerce Search כולל נתונים מקטלוג המוצרים ונתוני אירועים של משתמשים. זרם הנתונים הזה מספק את הבסיס לאימון מודלים חזקים ולהערכה מתמשכת באמצעות מנגנוני משוב. הטמעה מדויקת ומלאה של נתונים היא לא רק דרישה מוקדמת, אלא תהליך מתמשך שחיוני לשמירה על יכולת ההתאמה של המודלים הבסיסיים. הדבר משפיע ישירות על האיכות והרלוונטיות של תוצאות החיפוש, ומניב החזר משמעותי על ההשקעה.
כדאי להביא בחשבון את השיטות המומלצות האלה להטמעת נתונים כשמתכננים את הפתרון לחיפוש מסחרי.
ייבוא בכמות גדולה, סטרימינג בזמן אמת או שניהם?
יש שתי שיטות עיקריות להוספת קטלוג ל-AI Commerce Search:
ייבוא בכמות גדולה
סטרימינג בזמן אמת
הגישה הכפולה הזו מאפשרת להתאים את המערכת לצרכים האדריכליים המגוונים של מערכות קצה עורפיות שונות של לקוחות. אין חובה לבחור רק שיטה אחת. אפשר להשתמש במצב הטמעה היברידי, שכולל גם ייבוא בכמות גדולה וגם עדכונים בזמן אמת, בהתאם לדרישות הספציפיות.
ייבוא בכמות גדולה הוא פתרון אידיאלי כשצריך להוסיף, למחוק או לעדכן אלפי מוצרים בבת אחת. לעומת זאת, סטרימינג בזמן אמת מתאים במיוחד כשצריך עדכונים רציפים למספר קטן יחסית של מוצרים. הבחירה בין השיטות האלה תלויה באופי של קטלוג המוצרים, בתדירות העדכונים ובארכיטקטורה הכוללת של מערכות ה-Backend.
הפונקציונליות של ייבוא בכמות גדולה תומכת בשלושה מקורות נתונים שונים:
- BigQuery: BigQuery מאפשר לשנות במהירות את נתוני הקטלוג, לציין תאריכי חלוקה למחיצות במהלך הייבוא ולבצע טרנספורמציה יעילה של הנתונים באמצעות שאילתות SQL.
- Google Cloud Storage: כדי להשתמש ב-Cloud Storage, צריך להקפיד על פורמטים ספציפיים, כמו JSON, ועל הגבלות על קבצים. המשתמשים אחראים לניהול מבני הבאקטים, לחלוקת הקבצים לחלקים ולשאר ההיבטים של תהליך הייבוא. בנוסף, עריכה ישירה של הקטלוג ב-Cloud Storage יכולה להיות מסורבלת, ולמרות שהיא עשויה להיות חסכונית, היא לא גמישה כמו שיטות אחרות.
- נתונים מוטבעים: בקטלוגים גדולים, ייבוא מוטבע לא תמיד יהיה האפשרות הכי טובה בגלל מגבלות גודל. מומלץ להשתמש בהן לעדכונים קלים או לבדיקות ניסיוניות.
במקרים שבהם יש נפח גדול של עדכונים בקטלוג המוצרים (אלפי שינויים, הוספות או מחיקות של מוצרים) בפרק זמן קצר ובמרווחי זמן קבועים, גישה משולבת של ייבוא בכמות גדולה וסטרימינג בזמן אמת יכולה להיות יעילה מאוד. אפשר להכין את העדכונים ב-BigQuery או ב-Cloud Storage ולבצע ייבוא מצטבר של נתונים בכמויות גדולות במרווחי זמן קבועים, למשל כל שעה או שעתיים. השיטה הזו מאפשרת לנהל ביעילות עדכונים בהיקף גדול, תוך צמצום השיבושים.
לעדכונים קטנים יותר או לעדכונים שמתבצעים לעיתים רחוקות יותר, או לעדכונים שצריכים להשתקף בקטלוג באופן מיידי, אפשר להשתמש ב-API של סטרימינג בזמן אמת. בגישה ההיברידית, אפשר להשתמש בסטרימינג בזמן אמת כדי למלא את הפערים בין ייבוא בכמות גדולה, וכך לוודא שהקטלוג תמיד עדכני. האסטרטגיה הזו מאזנת בין ביצוע קריאות נפרדות ל-REST API (לתיקון מוצרים) לבין ביצוע שינויים בכמות גדולה של מוצרים, וכך משפרת את היעילות ואת מהירות התגובה בניהול קטלוג החיפוש של AI Commerce.
אסטרטגיות הסתעפות לניהול קטלוג
מומלץ לשמור על קטלוג מאוחד בסניף אחד, במקום להשתמש בקטלוגים שונים בכמה סניפים. השיטה הזו מייעלת את העדכונים בקטלוג ומפחיתה את הסיכון לאי-התאמות כשעוברים בין ענפים.
אלה אסטרטגיות נפוצות של הסתעפות שיעילות לניהול קטלוגים.
עדכונים של סניף יחיד
מגדירים הסתעפות פעילה כברירת מחדל ומעדכנים אותה באופן רציף כשמתבצעים שינויים בקטלוג. כדי לבצע עדכון מספר פריטים בו-זמנית, מומלץ להשתמש בפונקציית הייבוא בתקופות של עומס תעבורת נתונים נמוך כדי לצמצם את השיבושים. כדאי להשתמש בממשקי API של סטרימינג לעדכונים קטנים ומצטברים, או לאגד אותם לחלקים גדולים יותר לייבוא רגיל.
החלפת הסתעפויות
יש כמה אפשרויות לניהול ענפים שונים:
שימוש בהסתעפויות להכנה ולאימות:
- חלק מהמהנדסים של אתרי מסחר אלקטרוני בוחרים בגישה של מעבר בין ענפים, שבה הקטלוג מתעדכן בענף שאינו פעיל ואז הופך לענף ברירת המחדל (הפעיל) כשהוא מוכן לייצור. כך אפשר להכין מראש את הקטלוג של היום הבא. אפשר לבצע עדכונים באמצעות ייבוא בכמות גדולה או סטרימינג לענף שאינו פעיל, כדי להבטיח מעבר חלק בזמנים שבהם עומס התנועה נמוך.
- הבחירה בין האסטרטגיות האלה תלויה בדרישות הספציפיות שלכם, בתדירות העדכונים ובהגדרת התשתית. עם זאת, לא משנה איזו אסטרטגיה תבחרו, חשוב לשמור על קטלוג מאוחד בענף יחיד כדי להשיג ביצועים אופטימליים ותוצאות חיפוש עקביות ב-AI Commerce Search.
שימוש בהסתעפויות לגיבויים:
- ענף פעיל יחיד מתמקד בהטמעה ובעיבוד רציפים של עדכוני מוצרים כדי לשמור על עדכניות של אינדקס החיפוש של AI Commerce כמעט בזמן אמת.
- ענף נוסף מתמקד ביצירת תמונת מצב יומית של הנתונים שעברו טרנספורמציה ב-AI Commerce Search, ומשמש כמנגנון חזק למקרה של שיבוש נתונים או בעיות בענף 0.
- הענף השלישי מתמקד ביצירת תמונת מצב שבועית של התאריך שעבר שינוי. כך הלקוח יכול לקבל גיבוי מלפני יום וגיבוי מלפני שבוע בענפים שונים.
מחיקה סופית של ענפים בקטלוג
אם מייבאים נתוני קטלוג חדשים לענף קיים, חשוב שענף הקטלוג יהיה ריק כדי לשמור על שלמות הנתונים שמייבאים לענף. כשהענף ריק, אפשר לייבא נתוני קטלוג חדשים ולקשר את הענף לחשבון של מוֹכר.
אם אתם מציגים תחזיות בזמן אמת או תנועה שמגיעה מרשת החיפוש, ואתם מתכננים למחוק את ענף ברירת המחדל, כדאי קודם לציין ענף אחר כברירת המחדל לפני המחיקה. מחיקה של הסתעפות ברירת מחדל בשידור חי עלולה לגרום להשבתה, כי הסתעפות ברירת המחדל תציג תוצאות ריקות אחרי המחיקה.
כדי למחוק נתונים מענף קטלוג:
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Dataבוחרים ענף קטלוג מהשדה שם הענף.
בתפריט (3 נקודות) שלצד השדה שם הענף, בוחרים באפשרות מחיקת הענף.
תוצג הודעה שמזהירה אתכם שאתם עומדים למחוק את כל הנתונים בענף, וגם את כל המאפיינים שנוצרו עבור הענף.
מזינים את הסניף ולוחצים על אישור כדי למחוק את נתוני הקטלוג מהסניף.
מתחילה פעולה ממושכת למחיקת נתונים מענף הקטלוג. בסיום פעולת ההסרה, הסטטוס של ההסרה מוצג ברשימה קטלוג מוצרים בחלון סטטוס הפעילות.
עדכונים לגבי מלאי שטחי פרסום ב-AI Commerce Search
בקטע הזה מוסבר איך לבצע אופטימיזציה של הביצועים של AI Commerce Search על ידי ביצוע עדכונים שוטפים של המלאי.
סטרימינג בזמן אמת
- לנתונים דינמיים כמו פרטי מלאי (מחיר, זמינות) ופרטים ברמת החנות, כולל סטטוס ביצוע ההזמנה ותמחור ספציפי לחנות, האפשרות היחידה ב-AI Commerce Search היא סטרימינג בזמן אמת.
- ההבדל הזה נובע מהתדירות הגבוהה של שינויים במלאי לעומת נתוני קטלוג המוצרים שהם יציבים יחסית. הזמינות של מוצרים יכולה להשתנות כמה פעמים ביום, בעוד שהתיאורים או המאפיינים נשארים קבועים יחסית.
- ככל שיש יותר מיקומי חנויות, כך תדירות העדכונים ברמת החנות גדלה.
עדכונים אסינכרוניים
- כדי להתמודד עם קצב השינויים המהיר הזה, AI Commerce Search משתמש בעדכוני מלאי אסינכרוניים באמצעות ממשקי API שמחזירים מזהה משימה.
- תהליך העדכון לא נחשב להשלמה עד שהסטטוס של העבודה נבדק ומאושר, מה שעלול לגרום לעיכוב קל של שניות עד דקות.
עדכונים לא תקינים
- תכונה חשובה של המערכת הזו היא היכולת לעדכן את פרטי המלאי לפני שהמוצר הרלוונטי נטען לקטלוג. השינוי הזה נועד לפתור את הבעיה הנפוצה שבה פייפליינים של נתוני מלאי ונתוני מוצרים פועלים באופן עצמאי אצל קמעונאים, ולפעמים נתוני המלאי הופכים לזמינים לפני שקטלוג המוצרים מתעדכן. כשמעדכנים את המלאי, משתמשים באפשרות
allowMissingכדי לטפל בעדכונים של מלאי ומוצרים שלא מתבצעים לפי הסדר. - האפשרות לעדכן את המלאי לפני הטמעת הקטלוג מאפשרת ל-AI Commerce Search להתמודד עם אי-התאמות כאלה בצינורות, וכך לוודא שנתוני המלאי מדויקים גם לגבי מוצרים חדשים.
- עם זאת, פרטי המלאי של מוצר נשמרים למשך 24 שעות, ואם לא מתבצעת הטמעה של מוצר תואם במהלך פרק הזמן הזה, הם נמחקים. המנגנון הזה מבטיח עקביות של הנתונים ומונע את המשך השימוש במידע מלאי לא עדכני במערכת.
בדיקות מקדימות של קטלוג המוצרים כדי לבצע בדיקות A/B מהימנות ב-AI Commerce Search
בקטע הזה מוסבר איך להריץ בדיקות מקדימות על נתוני קטלוג המוצרים.
שמירה על עקביות בעדכוני הקטלוג
- כדי להתכונן לבדיקת A/B ב-AI Commerce Search, חשוב לשמור על שוויון מדויק בין קטלוג המוצרים מדור קודם (קטלוג הבקרה) לבין קטלוג המוצרים ב-AI Commerce Search (קטלוג הבדיקה). חוסר איזון בין שתי הקבוצות עלול להשפיע לרעה על בדיקת ה-A/B, ולגרום להטיה בתצפיות ולקבלת תוצאות לא תקפות. לדוגמה, חוסר עקביות בזמינות המוצרים, בתמחור או אפילו אי-התאמות קלות במאפיינים עלולות להוביל להטיות לא מכוונות בנתוני הבדיקה.
- כדי למזער את הסיכון הזה, חשוב לתכנן תהליך עדכון מקביל גם לקטלוג הבקרה וגם לקטלוג הבדיקה, ולהימנע מעדכונים עוקבים בכל הזדמנות שאפשר. המטרה היא למקסם את הזמן שבו שני הקטלוגים מסונכרנים. לעומת זאת, עדכונים סדרתיים עלולים לגרום לעיכובים באחד הנתיבים. העיכובים האלה עלולים לגרום לחוסר התאמה זמני בין הקטלוגים, כך שמוצר מסוים יהיה במלאי בקטלוג אחד אבל לא בקטלוג השני. או שמוצר חדש שנוסף יופיע בקטלוג אחד לפני שהוא יופיע בקטלוג השני. פערים כאלה יכולים להשפיע באופן משמעותי על התנהגות המשתמשים, על הקליקים ועל הרכישות, ובסופו של דבר להוביל להשוואה לא הוגנת ולתוצאות לא מדויקות של בדיקת A/B.
- הקמעונאים יכולים לתת עדיפות לעדכונים מקבילים ולשאוף לשוויון עקבי בקטלוג, וכך להבטיח תנאים שווים לבדיקות A/B ב-AI Commerce Search. הגישה הזו מאפשרת ניתוח הוגן ונטול הטיה של תוצאות הבדיקה, וכך לקבל תובנות אמינות יותר ולקבל החלטות מושכלות.
השגת שוויון בנתוני הקטלוג
- העומק והדיוק של ההבנה של מודל חיפוש של מוצרים במסחר אלקטרוני תלויים בעושר ובאיכות של המידע בקטלוג המוצרים הבסיסי שלו. ככל שנתוני המוצרים בקטלוג מקיפים יותר, כך המודל מצויד טוב יותר להבנה ולסיווג יעיל של מוצרים.
- לכן, כהכנה לבדיקת A/B, חשוב לוודא שנתוני המוצרים שהועלו לקטלוג מדור קודם (קבוצת הבקרה) ולקטלוג של AI Commerce Search (קבוצת הבדיקה) זהים. כל אי התאמה בפרטי המוצר בין שני הסביבות האלה עלולה להטות באופן משמעותי את תוצאות בדיקת ה-A/B.
- לדוגמה, אם מנוע החיפוש הקודם נהנה מקטלוג עשיר או נרחב יותר בהשוואה ל-AI Commerce Search, נוצר יתרון לא הוגן. מידע חסר בקטלוג של AI Commerce Search עלול לפגוע בהבנה ובסיווג של המוצרים, וכתוצאה מכך להוביל לתוצאות חיפוש לא מדויקות ולהשוואות מטעות של ביצועים. זיהוי פערים כאלה באמצעות כלים חיצוניים יכול להיות מאתגר, ולרוב נדרשת בדיקה ידנית קפדנית של שני הקטלוגים.
- אם קמעונאים יקפידו לוודא ששני הקטלוגים מכילים את אותם נתוני מוצרים עם אותה רמת פירוט, הם יוכלו ליצור תנאים שווים לבדיקות A/B ב-AI Commerce Search. הגישה הזו מאפשרת השוואה הוגנת ונטולת הטיה בין שני מנועי החיפוש, ומקלה על הערכה מדויקת של הביצועים והיכולות של כל אחד מהם.
תכנון התאוששות מאסון (DR)
תוכנית התאוששות מאסון (DR) מוכנה היטב מבטיחה שהיכולות שלכם לחיפוש מסחרי יישארו תפעוליות ורספונסיביות, וכך תצמצמו את ההשפעה על חוויית הלקוח (CX) ועל יצירת ההכנסות. התוכנית הזו אמורה לאפשר שחזור מהיר של הקטלוג כדי לטפל בכשלים פוטנציאליים בצינורות להעברת קטלוגים ואירועי משתמשים, בלי קשר לגורם הבסיסי.
השימוש ב-BigQuery להכנת נתונים מציע יתרון מובהק בתוכנית התאוששות מאסון (DR). אם הקטלוג הנוכחי או נתוני אירועי המשתמשים בחיפוש המסחרי מבוסס ה-AI לא שונים באופן משמעותי מהתמונה העדכנית ביותר שמאוחסנת ב-BigQuery, אפשר להפעיל שחזור מהיר באמצעות קריאה ל-API של הייבוא. הגישה הזו מצמצמת את זמן ההשבתה ומבטיחה שפונקציית החיפוש תמשיך לפעול.
לעומת זאת, אם BigQuery לא משולב בפייפליין, צריך להשתמש במנגנונים חלופיים כדי לטעון מחדש את הקטלוג במהירות ממצב תקין ידוע. המנגנונים האלה עשויים לכלול מערכות גיבוי, שכפול נתונים או אסטרטגיות אחרות למעבר לגיבוי.
אם תשלבו את השיקולים האלה לגבי התאוששות מאסון בארכיטקטורה של AI Commerce Search, תוכלו לחזק את העמידות של המערכת ולשמור על המשכיות עסקית גם במקרה של שיבושים בלתי צפויים.
תכנון להשגת זמינות גבוהה
כשמעלים את קטלוג המוצרים ל-AI Commerce Search, חשוב להבין איך שירותים שונים Google Cloud מטפלים בנתונים אזוריים כדי לתכנן צינור חזק להעברת נתונים.
כדי ליצור צינור להטמעת נתונים שכולל יכולת תוכנית התאוששות מאסון (DR) באמצעות Dataflow, צריך לפרוס את העבודות בכמה אזורים באמצעות אחד מהעיצובים הבאים:
- פעיל/פעיל: מופעים של Dataflow בכמה אזורים מעבדים נתונים באופן פעיל בו-זמנית.
- פעיל/לא פעיל: מופע Dataflow באזור אחד פעיל, בעוד שמופעים באזורים אחרים נשארים במצב המתנה.
כך מטמיעים את העיצובים האלה באמצעות Pub/Sub ו-Dataflow:
- שירותים גלובליים: חלק מהשירותים, כמו Pub/Sub, פועלים באופן גלובלי. Google Cloud מנהלת את הזמינות שלהם בהתאם להסכמי רמת השירות (SLA) הספציפיים שלהם.
- שירותים אזוריים: שירותים אחרים, כמו Dataflow, שבהם אתם עשויים להשתמש כדי לשנות נתונים ולהטמיע אותם ב-AI Commerce Search, הם אזוריים. באחריותכם להגדיר את הרכיבים האלה לזמינות גבוהה ולתוכנית התאוששות מאסון.
לדוגמה, כשמשתמשים ב-BigQuery כדי לשמור נתונים, אפשר להגדיר אותו כך שיהיה מפוזר בכמה אזורים, כדי ש Google Cloudיטפל אוטומטית בשכפול הנתונים ובזמינות שלהם. באופן דומה, כשמשתמשים ב-Cloud Storage, אפשר להגדיר אותו כך שיפעל במספר אזורים.
עיצוב פעיל/פעיל
בארכיטקטורה מסוג Active/Active נעשה שימוש במאפייני הודעות של Pub/Sub ובמסנני מינויים כדי להבטיח שכל הודעה תעובד בדיוק פעם אחת על ידי משימת Dataflow פעילה באזור מסוים.
הוספת מאפייני הודעה: כשמפרסמים הודעות בנושא Pub/Sub, כמו עדכוני מוצרים, צריך לכלול מאפיין שמציין את אזור היעד. לדוגמה:
region:us-central1region:us-east1
הגדרת מסנני מינוי: לכל פייפליין Dataflow אזורי, מגדירים את המינוי ל-Pub/Sub כך שימשוך רק הודעות שתואמות לאזור שלו באמצעות מסנני הודעות. לדוגמה, המינוי למשימת
us-central1Dataflow יכלול מסנן כמוattributes.region = "us-central1".מעבר לגיבוי (Failover): אם אזור מסוים הופך ללא זמין, צריך לעדכן את מערכת הפרסום במעלה הזרם כדי לתייג את כל ההודעות החדשות באמצעות מאפיין של אזור תקין. הפעולה הזו מעבירה את עיבוד ההודעות למופע Dataflow באזור המעבר לגיבוי.
אפשר להגדיר כמה רכיבים שמשמשים בארכיטקטורה כך שיהיו מפוזרים בכמה אזורים כברירת מחדל. לדוגמה, כשמשתמשים ב-BigQuery כדי לשמור נתונים, אפשר להגדיר אותו כך שיהיה במספר אזורים, כדי ש-Cloud Storage יטפל אוטומטית בשכפול הנתונים ובזמינות שלהם. באופן דומה, כשמשתמשים ב-Cloud Storage, אפשר להגדיר אותו כך שיהיה במספר אזורים.
עיצוב פעיל/סביל
העיצוב הזה כולל צינור עיבוד נתונים אזורי אחד של Dataflow ששולף הודעות מ-Pub/Sub בכל זמן נתון.
צירוף מינוי אחד: מוודאים שרק המינוי ל-Pub/Sub של משימת Dataflow באזור הפעיל מצורף ושמתבצעת משיכה של הודעות. צריך ליצור מינויים למשימות Dataflow באזורים פסיביים, אבל הם יישארו מנותקים.
מעבר לגיבוי (Failover): אם מתרחש כשל באזור הפעיל, באופן ידני או באמצעות תוכנה:
- מבטלים את הצירוף של מינוי Pub/Sub שמשויך לעבודת Dataflow באזור שנכשל.
- מצרפים את מינוי Pub/Sub שמשויך למשימת Dataflow באחד מהאזורים הפסיביים (המתנה).
הפעולה הזו מעבירה את עומס העיבוד של ההודעות לאזור שהופעל לאחרונה.
חוסן וניתוח משפטי
שימוש ב-BigQuery בתכנון של הטמעת הנתונים יכול לעזור בטיפול בחוסן וביצירת יכולת לניתוח משפטי ולניפוי באגים. כשמזינים מוצרים ומלאי ישירות באמצעות API patch ו-API addLocalInventory, המשמעות היא שכשהנתונים נשלחים ל-AI Commerce Search, לא נשארים עקבות של עדכון המוצר והמלאי. יכול להיות שהמשתמש רוצה לדעת למה מוצר מסוים לא מוצג כמו שהוא מצפה. אזור זמני שנבנה באמצעות BigQuery עם היסטוריה מלאה של נתונים מאפשר לבצע חקירה וניפוי באגים מהסוג הזה.
תרשים עזר לארכיטקטורה
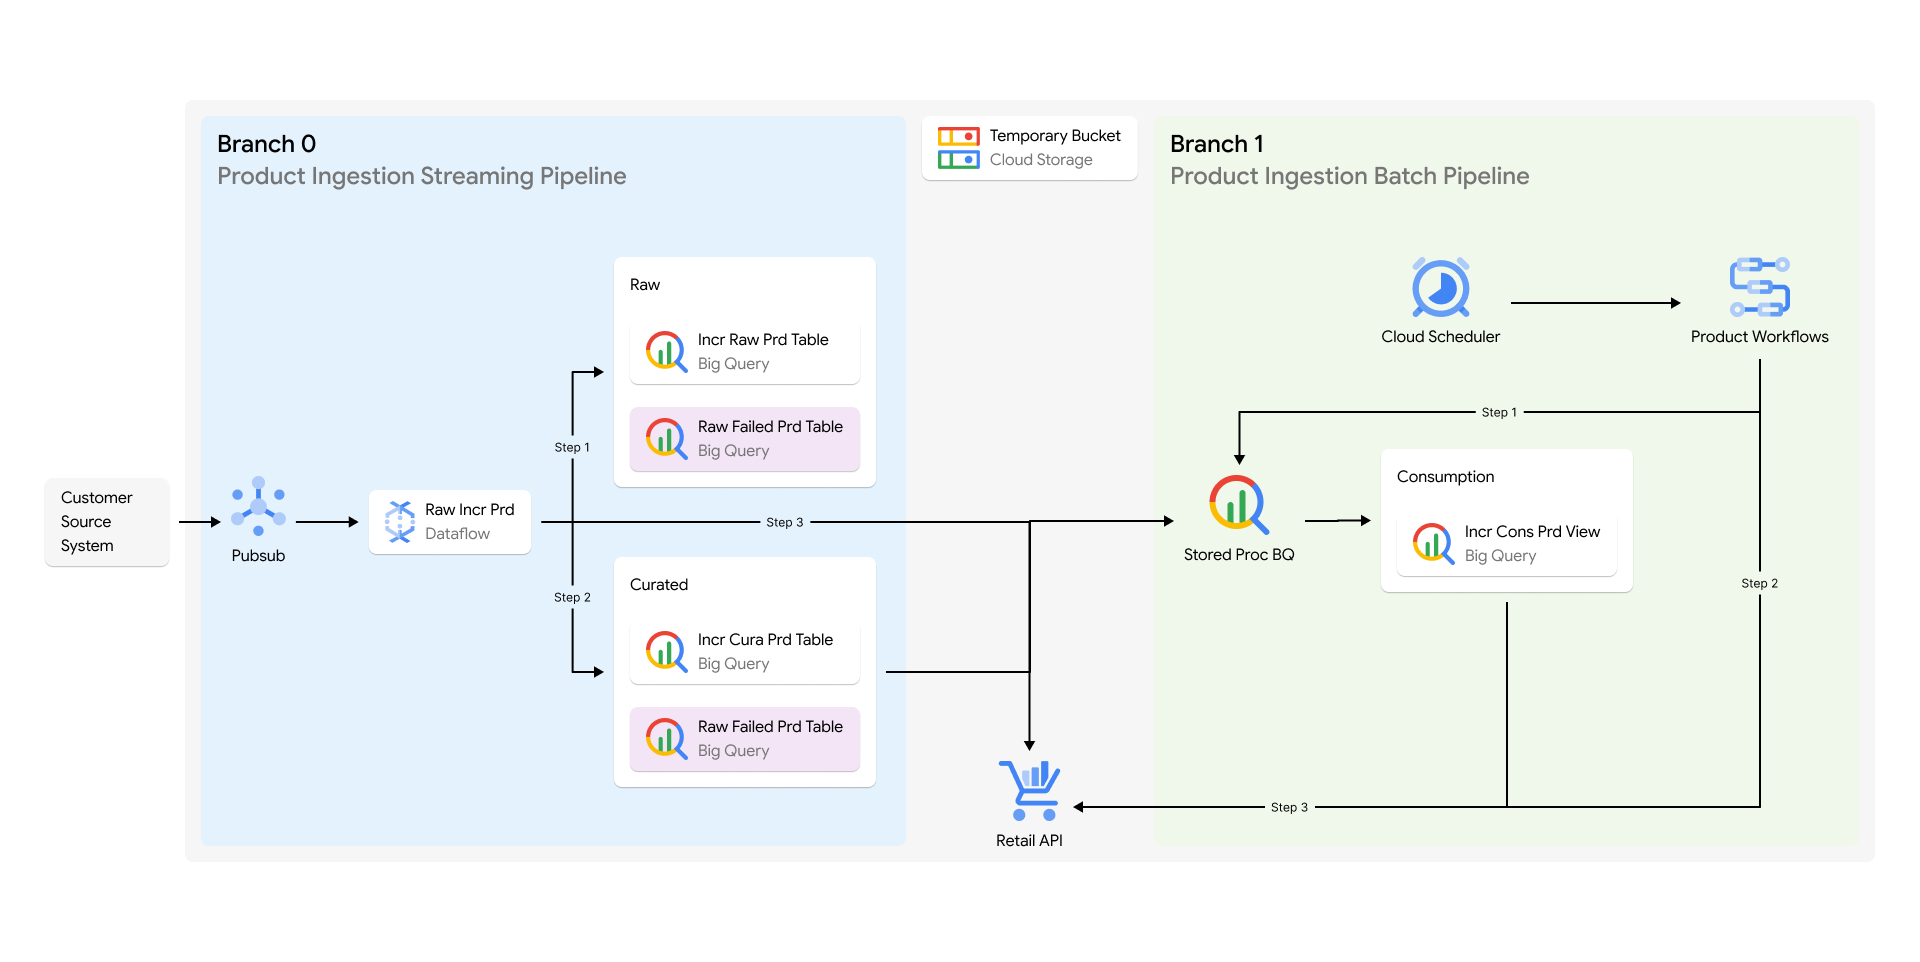
בארכיטקטורה הזו, הטמעת הנתונים בדרך כלל כוללת שלבים של נתונים גולמיים, נתונים שנאספו ונתונים לשימוש, והכול מבוסס על BigQuery. המערכת תעביר נתונים בין השלבים באמצעות Dataflow ותתזמר את כל התהליך הזה באמצעות תהליכי עבודה בענן:
- המערכת תקבל את הנתונים הגולמיים כמו שהם ותתייג אותם בתג זמן כדי לשמור את ההיסטוריה. הנתונים האלה לא משתנים, ולכן הלקוחות יתייחסו אליהם כמקור אמין.
- לאחר מכן המערכת תמיר את הנתונים לשלב מנוהל ותתייג אותם שוב בחותמת זמן. כך הלקוחות יוכלו לדעת מתי התמונה עברה שינוי ואם משהו השתבש.
- לבסוף, המערכת תיצור תצוגות בשלב הצריכה על סמך הנתונים שנאספו, תוך שימוש בשעה שבה המערכת תייגה את הנתונים בשלב מוקדם יותר. כך הלקוח ידע בדיוק אילו נתונים שעברו טרנספורמציה אמורים להיטמע בסופו של דבר ב-AI Commerce Search.
ענף 0, ענף 1 וענף 2 משמשים כגיבוי חי, כגיבוי מלפני יום וכגיבוי מלפני שבוע. נתונים שמוזנים ישירות לענף 0 עוברים צבירה ואינדוקס לענף 1 מדי יום ולענף 2 מדי שבוע. כך אפשר לבטל כל שיבוש בנתונים, ולשפר את המשכיות העסקית ואת חוסן המערכת.
בנוסף, אפשר לבצע ניתוח וניפוי באגים כי ההיסטוריה המלאה של הנתונים והמקור שלהם נשמרים במערכי נתונים גלובליים של BigQuery.
תכנון תרחישי קצה בהעברה של קטלוגים
ברגע שמנגנוני הליבה להטמעת קטלוג ב-AI Commerce Search מוגדרים, גישה פרואקטיבית כוללת הערכה של החוסן שלהם מפני מקרים שונים של קצה. יכול להיות שחלק מהתרחישים האלה לא רלוונטיים באופן מיידי לדרישות העסקיות הספציפיות שלכם, אבל אם תביאו אותם בחשבון בתכנון של הקצה העורפי, תוכלו להבטיח שהמערכת תהיה עמידה בפני שינויים עתידיים.
בשלב ההכנה הזה צריך לבדוק את היכולת של פייפליין הנתונים להתמודד עם תרחישים לא צפויים או עם מקרים קיצוניים, כדי לוודא שהוא חזק ושהוא יכול להסתגל לשינויים בביקוש. כדי לצמצם שיבושים עתידיים ולשמור על זרימה חלקה של נתוני מוצרים למערכת AI Commerce Search, חשוב לצפות מראש אתגרים פוטנציאליים ולטפל בהם באופן יזום.
כדי להשיג את המטרה הזו, צריך לבנות את הלוגיקה של Dataflow כך שהיא:
מאמת כל פריט בנתונים הגולמיים כדי לוודא שהוא תואם לסכימה המתאימה. החוזה של הנתונים הגולמיים צריך להיקבע מראש, וכל רכיב נתונים צריך להיות תמיד תואם לחוזה. אם האימות נכשל, רכיב הנתונים הגולמיים צריך להיות מתויג בזמן ולשמור בטבלאות הגולמיות שנכשלו ב-BigQuery עם השגיאות בפועל שמיועדות לניתוח פורנזי.
דוגמאות לשגיאות כאלה:
- מאפיין מסוים שלא נכלל בחוזה מופיע פתאום ברכיב הנתונים הגולמיים.
- רכיב נתוני הגולמיים לא מכיל מאפיין חובה מסוים.
מאמת כל פריט בנתונים הגולמיים כדי להפוך אותו לפורמט של AI Commerce Search. יש כמה שדות חובה שנדרשים כדי להטמיע מוצרים ב-AI Commerce Search. עכשיו צריך לבדוק שוב כל רכיב בנתונים הגולמיים כדי לוודא שאפשר להמיר אותו בהצלחה לפורמט סכמת החיפוש של AI Commerce. במקרה של כשל בטרנספורמציה, רכיב הנתונים הגולמיים צריך להיות מתויג בחותמת זמן ולהישמר בטבלאות שנכשלו ב-BigQuery עם הודעות שגיאה בפועל שיכולות לעזור בניתוח פורנזי.
דוגמאות לשגיאות כאלה:
- אי אפשר לעצב מאפיין מסוים כמו מחיר כמספר כי רכיב הנתונים הגולמיים הוא אלפאנומרי.
- שם המוצר חסר לגמרי.
בדוגמה הזו מוצגת סכימת טבלה לדוגמה ב-BigQuery לשמירת כל הכשלים לצורך ניפוי באגים:
הצגת סכימת טבלה לדוגמה ב-BigQuery
[
    {
      "mode": "REQUIRED",
      "name": "ingestedTimestamp",
      "type": "TIMESTAMP"
    },
    {
      "mode": "REQUIRED",
      "name": "payloadString",
      "type": "STRING"
    },
    {
      "mode": "REQUIRED",
      "name": "payloadBytes",
      "type": "BYTES"
    },
    {
      "fields": [
        {
          "mode": "NULLABLE",
          "name": "key",
          "type": "STRING"
        },
        {
          "mode": "NULLABLE",
          "name": "value",
          "type": "STRING"
        }
      ],
      "mode": "REPEATED",
      "name": "attributes",
      "type": "RECORD"
    },
    {
      "mode": "NULLABLE",
      "name": "errorMessage",
      "type": "STRING"
    },
    {
      "mode": "NULLABLE",
      "name": "stacktrace",
      "type": "STRING"
    }
  ]
בדיקות מאמץ ומדרגיות
כדי להתכונן לאירועים עם נפח גבוה של משתמשים ולצמיחה, כדאי לבצע בדיקות מאמץ ולשפר את יכולת ההתאמה לגודל.
אירועים עם נפח תנועה גבוה
אירועים עם תנועה גבוהה, כמו חגים, מהווים אתגר משמעותי לצינורות להעברת נתונים. העלייה במספר העדכונים של נתוני המלאי, כולל רמות המלאי והמחירים, ושינויים פוטנציאליים במאפייני המוצרים, מחייבת תשתית חזקה. חשוב לבדוק אם מערכת ההטמעה שלכם יכולה לעמוד בעומס המוגבר הזה. בדיקות עומס בהדמיה, שמשחזרות דפוסי תעבורה בשיא, מזהות צווארי בקבוק ומבטיחות פעולה חלקה בתקופות הקריטיות האלה.
מבצעים לזמן מוגבל
מבצעים לזמן מוגבל מציבים אתגר ייחודי בגלל משך הזמן הקצר שלהם והתנודות המהירות במלאי. חשוב מאוד לוודא שהמלאי מסונכרן בזמן אמת כדי למנוע פערים בין תוצאות החיפוש לבין הזמינות בפועל. אם לא תעשו זאת, עלולים להיווצר מצבים שבהם לקוחות יחוו חוויית הלקוח שלילית, למשל מוצרים פופולריים שיופיעו כזמינים במלאי כשבפועל הם אזלו, או להיפך. בנוסף, שינויים במחיר במהלך מבצעים לזמן מוגבל יכולים להשפיע באופן משמעותי על דירוג המוצרים, ולכן חשוב לעדכן את המחירים באינדקס החיפוש בצורה מדויקת ובזמן.
הרחבת הקטלוג
צמיחה עסקית או הרחבה של קו המוצרים יכולות להוביל לעלייה משמעותית במספר המוצרים בקטלוג, למשל פי 5 או פי 10. ארכיטקטורת ההטמעה צריכה להיות ניתנת להרחבה כדי להתמודד עם הצמיחה הזו בצורה חלקה. במקרים כאלה, יכול להיות שיהיה צורך לבדוק מחדש את כל צינור ה-ETL (חילוץ, טרנספורמציה, טעינה), במיוחד אם נוספו מקורות נתונים חדשים או פורמטים חדשים של מידע על מוצרים.
אם תתייחסו מראש לתרחישים האפשריים האלה, תוכלו לוודא שצינור ההזנה של נתוני AI Commerce Search יישאר חזק, ניתן להרחבה ומגיב, גם במקרים של עליות פתאומיות בתנועה, מבצעים לזמן מוגבל או גידול משמעותי בקטלוג. הגישה הפרואקטיבית הזו מבטיחה את הדיוק והאמינות של תוצאות החיפוש, תורמת לחוויית משתמש חיובית ומקדמת את הצלחת העסק.
צריך להעריך את הביצועים של צינור העברת הנתונים וליצור בסיס להשוואה למדדים הבאים:
- כמה זמן לוקח לפרסם את כל הקטלוג ולייבא את נתוני המלאי? יכול להיות שתצטרכו לעשות את זה באופן אד-הוק במהלך תקופת הקניות של סוף השנה, כשמחירים יכולים להשתנות באופן משמעותי בכל הקטלוג.
- כמה זמן ייקח עד שעדכון של מוצר בודד יופיע?
- מהו קצב העדכונים הגבוה ביותר של נתוני מוצרים ומלאי שהמערכת יכולה לעבד?
צווארי בקבוק
- בודקים אם אפשר להגדיל או להקטין את הצינורות בצורה נכונה.
- בודקים אם המגבלה המקסימלית על מספר המכונות גבוהה או נמוכה מדי.
- כדי לבדוק אם המערכת מוגבלת על ידי AI Commerce Search, מחפשים את קוד ה-HTTP 429.
- צריך לאשר אם יש צורך להגדיל מכסות מסוימות של API כדי לצמצם את הגבלת קצב של יצירת בקשות.
מבנה נתוני מוצרים להעלאת קטלוג
בקטע הזה מוסבר איך להכין את נתוני המוצרים להעלאה לקטלוג.
מוצרים ראשיים
מוצרים ראשיים משמשים כמאגרי מידע לקיבוץ מוצרים שהם וריאציות של אותו מוצר, וכערכים ברשת החיפוש. לציין רק מאפיינים משותפים לווריאציות של מוצרים ראשיים. למשל:
- מזהה המוצר הראשי
- מזהה המוצר (זהה למזהה המוצר הראשי)
- כותרת
- תיאור
מידע נוסף זמין במאמר מידע על מאפייני מוצרים.
משפחת מוצרים
מוצרים שהם וריאציות מקבלים בירושה מאפיינים משותפים מהמוצר הראשי, אבל אפשר גם לציין ערכים ייחודיים.
מאפייני החובה כוללים:
- כל המאפיינים שצוינו למוצרים ראשיים (שם הפריט, התיאור). המחיר, השם והתיאור יכולים להיות שונים מאלה של המוצר הראשי.
- מאפיינים ספציפיים של וריאציות מוצר (צבע, מידה ווריאציות רלוונטיות אחרות של המוצר).
מידע נוסף זמין במאמר מידע על מאפייני מוצרים.
אחזור מאפיינים
תהליך השליפה מתייחס לכל המאפיינים שאפשר לחפש גם במוצרים ראשיים וגם במשפחות מוצרים.
דירוג רלוונטיות
הניקוד של הרלוונטיות מבוסס רק על השדות של השם והתיאור. כדי להבטיח את ההבדלה הנכונה, כדאי לשנות מעט את שם הווריאציה משם המוצר הראשי (למשל, שם המוצר + צבע).
התאמה של וריאציות בתוצאות החיפוש
התאמת וריאציות (לדוגמה, שמלה כחולה) מסננת את התוצאות על סמך מאפייני וריאציה מוגדרים מראש כמו צבע ומידה. בתוצאות החיפוש מוצגים עד חמישה וריאציות תואמות לכל מוצר ראשי.
סנכרון של Merchant Center עם AI Commerce Search
Merchant Center הוא כלי שמאפשר לכם להעלות את נתוני החנות והמוצרים ל-Google, כך שניתן יהיה להציג אותם במודעות שופינג ובשירותים אחרים של Google.
כדי לסנכרן באופן רציף בין Merchant Center לבין AI Commerce Search, אתם יכולים לקשר את חשבון Merchant Center ל-AI Commerce Search.
כשמגדירים סנכרון של Merchant Center עם AI Commerce Search, צריך להקצות ב-Merchant Center את תפקיד אדמין ב-IAM. למרות שרמת גישה רגילה מאפשרת לכם לקרוא את הפידים ב-Merchant Center, כשאתם מנסים לסנכרן את Merchant Center עם AI Commerce Search, מוצגת הודעת שגיאה. לכן, כדי שתוכלו לסנכרן את חשבון Merchant Center עם AI Commerce Search, תצטרכו לשדרג את התפקיד שלכם.
קישור חשבון Merchant Center
כש-AI Commerce Search מקושר לחשבון Merchant Center, שינויים בנתוני המוצרים בחשבון Merchant Center מתעדכנים אוטומטית תוך דקות ב-AI Commerce Search. אם אתם רוצים למנוע סנכרון של שינויים ב-Merchant Center עם AI Commerce Search, אתם יכולים לבטל את הקישור של חשבון Merchant Center.
ביטול הקישור של חשבון Merchant Center לא מוחק מוצרים ב-AI Commerce Search. כדי למחוק מוצרים מיובאים, אפשר לעיין במאמר בנושא מחיקת פרטי מוצרים.
כדי לסנכרן את חשבון Merchant Center, מבצעים את השלבים הבאים.
סנכרון חשבון Merchant Center
מסוף Cloud
-
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Data - לוחצים על ייבוא כדי לפתוח את החלונית ייבוא נתונים.
- בוחרים באפשרות קטלוג מוצרים.
- בוחרים באפשרות סנכרון עם Merchant Center כמקור הנתונים.
- בוחרים את החשבון ב-Merchant Center. אם החשבון לא מופיע, בודקים את גישת משתמש.
- אופציונלי: בוחרים באפשרות מסנן פידים של Merchant Center כדי לייבא רק מוצרים מפידים נבחרים.
אם לא מציינים פידים, המערכת מייבאת מוצרים מכל הפידים (כולל פידים עתידיים). - אופציונלי: כדי לייבא רק מבצעים שמטרגטים מדינות או שפות מסוימות, מרחיבים את הצגת אפשרויות מתקדמות ובוחרים את מדינות המכירה והשפות ב-Merchant Center כדי לסנן את המבצעים.
- בוחרים את הענף שאליו רוצים להעלות את הקטלוג.
- לוחצים על Import.
curl
צריך לוודא שלחשבון השירות בסביבה המקומית יש גישה גם לחשבון Merchant Center וגם ל-AI Commerce Search. כדי לבדוק לאילו חשבונות יש גישה לחשבון Merchant Center שלכם, אפשר לעיין במאמר בנושא הרשאות גישה למשתמשים ב-Merchant Center.
משתמשים בשיטה
MerchantCenterAccountLink.createכדי ליצור את הקישור.curl -X POST \ -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \ -H "Content-Type: application/json; charset=utf-8" \ --data '{ "merchantCenterAccountId": MERCHANT_CENTER_ID, "branchId": "BRANCH_ID", "feedFilters": [ {"dataSourceId": DATA_SOURCE_ID_1} {"dataSourceId": DATA_SOURCE_ID_2} ], "languageCode": "LANGUAGE_CODE", "feedLabel": "FEED_LABEL", }' \ "https://retail.googleapis.com/v2alpha/projects/PROJECT_ID/locations/global/catalogs/default_catalog/merchantCenterAccountLinks"
- MERCHANT_CENTER_ID: המזהה של חשבון Merchant Center.
- BRANCH_ID: המזהה של הענף שאליו רוצים לקשר את החשבון. אפשר להזין בו את הערכים 0, 1 או 2.
- LANGUAGE_CODE: (אופציונלי) קוד השפה בן שתי האותיות של המוצרים שרוצים לייבא. כפי שמופיע ב-Merchant Center בעמודה
Languageשל המוצר. אם לא מגדירים שפות, כל השפות מיובאות. - FEED_LABEL: (אופציונלי) תווית הפיד של המוצרים שרוצים לייבא. תווית הפיד מופיעה ב-Merchant Center בעמודה תווית פיד של המוצר. אם לא מגדירים את התכונה הזו, כל התוויות של הפיד מיובאות.
- FEED_FILTERS: (אופציונלי) רשימה של פידים ראשיים שמתוכם יובאו מוצרים. אם לא בוחרים פידים, כל הפידים בחשבון Merchant Center משותפים. אפשר למצוא את המזהים במקור הנתונים של Content API או להיכנס ל-Merchant Center, לבחור פיד ולקבל את מזהה הפיד מהפרמטר afmDataSourceId בכתובת האתר. לדוגמה,
mc/products/sources/detail?a=MERCHANT_CENTER_ID&afmDataSourceId=DATA_SOURCE_ID.
כדי לראות את חשבון Merchant Center המקושר, עוברים אל הדף נתונים במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience ולוחצים על הלחצן Merchant Center בפינה השמאלית העליונה של הדף. תיפתח החלונית חשבונות Merchant Center מקושרים. אפשר גם להוסיף עוד חשבונות Merchant Center בחלונית הזו.
ראו הצגת נתונים נצברים על הקטלוג שלכם להוראות איך לראות את המוצרים שיובאו.
הצגת הקישורים לחשבון Merchant Center
מסוף Cloud
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Dataלוחצים על הלחצן Merchant Center בפינה השמאלית העליונה של הדף כדי לפתוח רשימה של חשבונות Merchant Center המקושרים.
curl
אפשר להשתמש בשיטה MerchantCenterAccountLink.list כדי להציג את משאב הקישורים.
curl -X GET \
 -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
 -H "Content-Type: application/json; charset=utf-8" \
 "https://retail.googleapis.com/v2alpha/projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/merchantCenterAccountLinks"
ביטול הקישור של חשבון Merchant Center
ביטול הקישור של חשבון Merchant Center יגרום להפסקת הסנכרון של נתוני הקטלוג עם AI Commerce Search. התהליך הזה לא מוחק מוצרים ב-AI Commerce Search שכבר הועלו.
מסוף Cloud
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Dataלוחצים על הלחצן Merchant Center בפינה השמאלית העליונה של הדף כדי לפתוח רשימה של חשבונות Merchant Center המקושרים.
לוחצים על ביטול הקישור לצד חשבון Merchant Center שרוצים לבטל את הקישור שלו, ומאשרים את הבחירה בתיבת הדו-שיח שמופיעה.
curl
כדי להסיר את המשאב MerchantCenterAccountLink, משתמשים בשיטה MerchantCenterAccountLink.delete.
curl -X DELETE \
 -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
 -H "Content-Type: application/json; charset=utf-8" \
 "https://retail.googleapis.com/v2alpha/projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/merchantCenterAccountLinks/BRANCH_ID_MERCHANT_CENTER_ID"
הגבלות על קישור ל-Merchant Center
אפשר לקשר חשבון Merchant Center לכל מספר של ענפים בקטלוג, אבל כל ענף בקטלוג יכול להיות מקושר רק לחשבון Merchant Center אחד.
חשבון Merchant Center לא יכול להיות חשבון מרובה לקוחות (MCA). אבל אפשר לקשר חשבונות משנה בנפרד.
הייבוא הראשון אחרי קישור חשבון Merchant Center יכול להימשך כמה שעות. משך הזמן תלוי במספר המוצרים המשווקים בחשבון Merchant Center.
האפשרות לבצע שינויים במוצרים באמצעות שיטות API מושבתת בסניפים שמקושרים לחשבון Merchant Center. כל שינוי בנתוני קטלוג המוצרים בסניפים האלה צריך להתבצע באמצעות Merchant Center. השינויים האלה מסתנכרנים אוטומטית עם AI Commerce Search.
סוג המוצר 'אוסף' לא נתמך בסניפים שמקושרים ל-Merchant Center.
כדי לשמור על דיוק הנתונים, אפשר לקשר את חשבון Merchant Center רק לענפים ריקים בקטלוג. כדי למחוק מוצרים מענף בקטלוג, אפשר לעיין במאמר בנושא מחיקת פרטי מוצרים.
ייבוא נתוני קטלוג מ-BigQuery
כדי לייבא נתוני קטלוג בפורמט הנכון מ-BigQuery, צריך להשתמש בסכימת AI Commerce Search כדי ליצור טבלה ב-BigQuery בפורמט הנכון ולטעון את הטבלה הריקה עם נתוני הקטלוג. לאחר מכן, מעלים את הנתונים ל-AI Commerce Search.
לקבלת עזרה נוספת בנושא טבלאות BigQuery, אפשר לעיין במאמר מבוא לטבלאות. לקבלת עזרה בשאילתות BigQuery, אפשר לעיין במאמר סקירה כללית של שליחת שאילתות לנתוני BigQuery.
בלחיצה על תראו לי איך תקבלו הסבר מפורט על המשימה ישירות ב-Cloud Shell Editor:
כדי לייבא את הקטלוג:
אם מערך הנתונים שלכם ב-BigQuery נמצא בפרויקט אחר, צריך להגדיר את ההרשאות הנדרשות כדי שהתכונה 'חיפוש מבוסס-AI למסחר' תוכל לגשת למערך הנתונים ב-BigQuery. מידע נוסף
ייבוא נתוני הקטלוג ל-AI Commerce Search.
מסוף Cloud
-
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Data - לוחצים על ייבוא כדי לפתוח את החלונית ייבוא נתונים.
- בוחרים באפשרות קטלוג מוצרים.
- בוחרים באפשרות BigQuery כמקור הנתונים.
- בוחרים את הענף שאליו רוצים להעלות את הקטלוג.
- בוחרים באפשרות סכימת קטלוגי מוצרים בענף הקמעונאות. זו סכימת המוצרים ל-AI Commerce Search.
- מזינים את הטבלה ב-BigQuery שבה נמצאים הנתונים.
- אופציונלי: בקטע Show advanced options (הצגת אפשרויות מתקדמות), מזינים את המיקום של קטגוריה של Cloud Storage בפרויקט בתור מיקום זמני לנתונים.
אם לא מציינים מיקום, המערכת משתמשת במיקום ברירת המחדל. אם מציינים את המיקום, קטגוריה של Cloud Storage ו-BigQuery צריכות להיות באותו אזור. - אם לא הפעלתם את האפשרות 'חיפוש' ואתם משתמשים בסכימה של Merchant Center, בוחרים ברמת המוצר.
חובה לבחור ברמת המוצר אם זו הפעם הראשונה שאתם מייבאים את הקטלוג או אם אתם מייבאים מחדש את הקטלוג אחרי שמחקתם אותו. מידע נוסף על רמות המוצרים שינוי רמות המוצרים אחרי ייבוא נתונים דורש מאמץ משמעותי.
חשוב: אי אפשר להפעיל חיפוש בפרויקטים עם קטלוג מוצרים שנקלט כווריאציות. - לוחצים על Import.
curl
אם זו הפעם הראשונה שאתם מעלים את הקטלוג, או שאתם מייבאים אותו מחדש אחרי שביצעתם ניקוי, אתם צריכים להגדיר את רמות המוצרים באמצעות השיטה
Catalog.patch. כדי לבצע את הפעולה הזו, צריך להיות בעלי תפקיד אדמין בחשבון הקמעונאי.-
ingestionProductType: תומך בערכיםprimary(ברירת מחדל) ו-variant. -
merchantCenterProductIdField: תומך בערכיםofferIdו-itemGroupId. אם אתם לא משתמשים ב-Merchant Center, אתם לא צריכים להגדיר את השדה הזה.
curl -X PATCH \
-H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
-H "Content-Type: application/json; charset=utf-8" \
 --data '{
   "productLevelConfig": {
     "ingestionProductType": "PRODUCT_TYPE",
     "merchantCenterProductIdField": "PRODUCT_ID_FIELD"
   }
 }' \
"https://retail.googleapis.com/v2/projects/PROJECT_ID/locations/global/catalogs/default_catalog"
-
יוצרים קובץ נתונים עם פרמטרי הקלט לייבוא.
משתמשים באובייקט BigQuerySource כדי להפנות למערך הנתונים ב-BigQuery.
- DATASET_ID: המזהה של מערך הנתונים ב-BigQuery.
- TABLE_ID: המזהה של הטבלה ב-BigQuery שמכילה את הנתונים.
- PROJECT_ID: מזהה הפרויקט שבו נמצא מקור הנתונים של BigQuery. אם לא מציינים את מזהה הפרויקט, הוא עובר בירושה מהבקשה הראשית.
- STAGING_DIRECTORY: אופציונלי. ספרייה ב-Cloud Storage שמשמשת כמיקום זמני לנתונים לפני שהם מיובאים ל-BigQuery. מומלץ להשאיר את השדה הזה ריק כדי ליצור באופן אוטומטי ספרייה זמנית.
- ERROR_DIRECTORY: אופציונלי. ספרייה ב-Cloud Storage למידע על שגיאות שקשורות לייבוא. כדי ליצור באופן אוטומטי ספרייה זמנית (מומלץ), משאירים את השדה הזה ריק.
-
dataSchema: במאפייןdataSchema, משתמשים בערךproduct(ברירת מחדל). תשתמשו בסכימת ה-AI Commerce Search.
מומלץ לא לציין ספריות זמניות או ספריות שגיאות, כדי שתוכלו ליצור באופן אוטומטי קטגוריה של Cloud Storage עם ספריות זמניות וספריות שגיאות חדשות. הספריות האלה נוצרות באותו אזור שבו נמצא מערך הנתונים ב-BigQuery, והן ייחודיות לכל ייבוא (מה שמונע ממשימות ייבוא מרובות להכין נתונים להעברה לאותה ספריה, וגם מונע ייבוא חוזר של אותם נתונים). אחרי שלושה ימים, ה-bucket והספריות נמחקים אוטומטית כדי לצמצם את עלויות האחסון.
שם הקטגוריה שנוצר באופן אוטומטי כולל את מזהה הפרויקט, האזור של הקטגוריה ושם סכימת הנתונים, מופרדים באמצעות קווים תחתונים (לדוגמה,
4321_us_catalog_retail). הספריות שנוצרות באופן אוטומטי נקראותstagingאוerrors, עם מספר בסוף (לדוגמה,staging2345אוerrors5678).אם מציינים ספריות, הקטגוריה של Cloud Storage צריכה להיות באותו אזור כמו מערך הנתונים ב-BigQuery, אחרת הייבוא ייכשל. צריך לציין את ספריות ההעברה והשגיאות בפורמט
gs://<bucket>/<folder>/. הן צריכות להיות שונות.{ "inputConfig":{ "bigQuerySource": { "projectId":"PROJECT_ID", "datasetId":"DATASET_ID", "tableId":"TABLE_ID", "dataSchema":"product"} } }
כדי לייבא את פרטי הקטלוג, שולחים בקשת
POSTל-REST methodProducts:importומציינים את שם קובץ הנתונים (כאן, מוצג כ-input.json).curl -X POST \ -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \ -H "Content-Type: application/json; charset=utf-8" -d @./input.json \ "https://retail.googleapis.com/v2/projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/branches/0/products:import"
אפשר לבדוק את הסטטוס באופן פרוגרמטי באמצעות ה-API. אמורים לקבל אובייקט תגובה שנראה כך:
{
"name": "projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/import-products-123456",
"done": false
}
השדה name הוא המזהה של אובייקט הפעולה. כדי לבקש את הסטטוס של האובייקט הזה, מחליפים את השדה name בערך שמוחזר על ידי ה-method
import, עד שהשדהdoneמחזיר את הערךtrue:curl -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \ "https://retail.googleapis.com/v2/projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/import-products-123456"
כשהפעולה מסתיימת, האובייקט שמוחזר כולל את הערך
doneשלtrue, ואובייקט סטטוס שדומה לדוגמה הבאה:{ "name": "projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/import-products-123456", "metadata": { "@type": "type.googleapis.com/google.cloud.retail.v2.ImportMetadata", "createTime": "2020-01-01T03:33:33.000001Z", "updateTime": "2020-01-01T03:34:33.000001Z", "successCount": "2", "failureCount": "1" }, "done": true, "response": { "@type": "type.googleapis.com/google.cloud.retail.v2.ImportProductsResponse", }, "errorsConfig": { "gcsPrefix": "gs://error-bucket/error-directory" } }
כדי לבדוק אם היו שגיאות במהלך הייבוא, אפשר לבדוק את הקבצים בספריית השגיאות ב-Cloud Storage.
-
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
הגדרת גישה למערך הנתונים ב-BigQuery
כדי להגדיר גישה כשמערך הנתונים ב-BigQuery נמצא בפרויקט אחר משירות החיפוש של AI Commerce, צריך לבצע את השלבים הבאים.
פותחים את הדף IAM במסוף Google Cloud .
בוחרים את הפרויקט של AI Commerce Search.
מחפשים את חשבון השירות עם השם Retail Service Agent.
אם לא הפעלתם בעבר פעולת ייבוא, יכול להיות שחשבון השירות הזה לא יופיע ברשימה. אם חשבון השירות הזה לא מופיע, צריך לחזור למשימת הייבוא ולהתחיל את הייבוא. אם הפעולה נכשלת בגלל שגיאות הרשאה, צריך לחזור לכאן ולהשלים את המשימה הזו.
מעתיקים את המזהה של חשבון השירות, שנראה כמו כתובת אימייל (לדוגמה,
service-525@gcp-sa-retail.iam.gserviceaccount.com).עוברים לפרויקט BigQuery (באותו דף IAM & Admin) ולוחצים על person_add Grant Access.
בקטע New principals (ישויות חדשות), מזינים את המזהה של חשבון השירות של AI Commerce Search ובוחרים בתפקיד BigQuery > BigQuery User (משתמש ב-BigQuery).
לוחצים על Add another role (הוספת תפקיד נוסף) ובוחרים באפשרות BigQuery > BigQuery Data Editor (BigQuery > עריכת נתונים ב-BigQuery).
אם אתם לא רוצים להעניק את התפקיד 'עורך נתונים' לכל הפרויקט, אתם יכולים להוסיף את התפקיד הזה ישירות למערך הנתונים. מידע נוסף
לוחצים על Save.
סכמת מוצרים
כשמייבאים קטלוג מ-BigQuery, צריך להשתמש בסכימת המוצרים הבאה של AI Commerce Search כדי ליצור טבלה ב-BigQuery בפורמט הנכון ולטעון אותה עם נתוני הקטלוג. לאחר מכן, מייבאים את הקטלוג.
ייבוא נתוני קטלוג מ-Cloud Storage
כדי לייבא נתוני קטלוג בפורמט JSON, יוצרים קובץ JSON אחד או יותר שמכילים את נתוני הקטלוג שרוצים לייבא, ומעלים אותם ל-Cloud Storage. משם אפשר לייבא אותו ל-AI Commerce Search.
דוגמה לפורמט JSON של פריט מוצר מופיעה במאמר פורמט נתוני JSON של פריט מוצר.
לקבלת עזרה בהעלאת קבצים ל-Cloud Storage, אפשר לעיין במאמר בנושא העלאת אובייקטים.
חשוב לוודא שלחשבון השירות של AI Commerce Search יש הרשאה לקרוא ולכתוב בקטגוריה.
חשבון השירות של AI Commerce Search מופיע בדף IAM במסוף Google Cloud עם השם Retail Service Agent. כשמוסיפים את החשבון להרשאות של קטגוריית היעד, צריך להשתמש במזהה של חשבון השירות, שנראה כמו כתובת אימייל (לדוגמה,
service-525@gcp-sa-retail.iam.gserviceaccount.com).מייבאים את נתוני הקטלוג.
מסוף Cloud
-
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
מעבר לדף Data - לוחצים על ייבוא כדי לפתוח את החלונית ייבוא נתונים.
- בוחרים באפשרות קטלוג מוצרים כמקור הנתונים.
- בוחרים את הענף שאליו רוצים להעלות את הקטלוג.
- בוחרים בסכימה Retail Product Catalogs (קטלוגי מוצרים קמעונאיים).
- מזינים את המיקום של הנתונים ב-Cloud Storage.
- אם החיפוש לא מופעל, בוחרים את רמות המוצרים.
חובה לבחור את רמות המוצרים אם זו הפעם הראשונה שאתם מייבאים את הקטלוג או אם אתם מייבאים מחדש את הקטלוג אחרי שמחקתם אותו. מידע נוסף על רמות המוצרים שינוי רמות המוצרים אחרי ייבוא נתונים דורש מאמץ משמעותי.
חשוב: אי אפשר להפעיל חיפוש בפרויקטים עם קטלוג מוצרים שנקלט כווריאציות. - לוחצים על Import.
curl
אם זו הפעם הראשונה שאתם מעלים את הקטלוג, או שאתם מייבאים מחדש את הקטלוג אחרי שמחקתם אותו, אתם צריכים להגדיר את רמות המוצרים באמצעות השיטה
Catalog.patch. מידע נוסף על רמות המוצרים-
ingestionProductType: תומך בערכיםprimary(ברירת מחדל) ו-variant. -
merchantCenterProductIdField: תומך בערכיםofferIdו-itemGroupId. אם אתם לא משתמשים ב-Merchant Center, אתם לא צריכים להגדיר את השדה הזה.
curl -X PATCH \
-H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
-H "Content-Type: application/json; charset=utf-8" \
 --data '{
   "productLevelConfig": {
     "ingestionProductType": "PRODUCT_TYPE",
     "merchantCenterProductIdField": "PRODUCT_ID_FIELD"
   }
 }' \
"https://retail.googleapis.com/v2/projects/PROJECT_ID/locations/global/catalogs/default_catalog"
-
יוצרים קובץ נתונים עם פרמטרי הקלט לייבוא. משתמשים באובייקט
GcsSourceכדי להפנות לקטגוריה של Cloud Storage.אפשר לספק כמה קבצים או רק אחד. בדוגמה הזו נעשה שימוש בשני קבצים.
- INPUT_FILE: קובץ או קבצים ב-Cloud Storage שמכילים את נתוני הקטלוג.
- ERROR_DIRECTORY: ספרייה ב-Cloud Storage למידע על שגיאות שקשורות לייבוא.
השדות בקובץ הקלט צריכים להיות בפורמט
gs://<bucket>/<path-to-file>/. ספריית השגיאות צריכה להיות בפורמטgs://<bucket>/<folder>/. אם ספריית השגיאות לא קיימת, היא נוצרת. הבאקט חייב להיות קיים.{ "inputConfig":{ "gcsSource": { "inputUris": ["INPUT_FILE_1", "INPUT_FILE_2"] } }, "errorsConfig":{"gcsPrefix":"ERROR_DIRECTORY"} }
כדי לייבא את פרטי הקטלוג, שולחים בקשת
POSTלשיטת RESTProducts:importומציינים את שם קובץ הנתונים (כאן, מוצג כ-input.json).curl -X POST \ -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \ -H "Content-Type: application/json; charset=utf-8" -d @./input.json \ "https://retail.googleapis.com/v2/projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/branches/0/products:import"
הדרך הקלה ביותר לבדוק את הסטטוס של פעולת הייבוא היא באמצעות Google Cloud המסוף. מידע נוסף זמין במאמר בנושא בדיקת הסטטוס של פעולת אינטגרציה ספציפית.
אפשר גם לבדוק את הסטטוס באופן פרוגרמטי באמצעות ה-API. אמורים לקבל אובייקט תגובה שנראה כך:
{
"name": "projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/import-products-123456",
"done": false
}
השדה name הוא המזהה של אובייקט הפעולה. שולחים בקשה לסטטוס של האובייקט הזה, ומחליפים את השדה name בערך שמוחזר על ידי שיטת הייבוא, עד שהשדה
doneמחזיר את הערךtrue:curl -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \ "https://retail.googleapis.com/v2/projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/[OPERATION_NAME]"
כשהפעולה מסתיימת, לאובייקט שמוחזר יש ערך
doneשלtrue, והוא כולל אובייקט סטטוס שדומה לדוגמה הבאה:{ "name": "projects/PROJECT_ID/locations/global/catalogs/default_catalog/operations/import-products-123456", "metadata": { "@type": "type.googleapis.com/google.cloud.retail.v2.ImportMetadata", "createTime": "2020-01-01T03:33:33.000001Z", "updateTime": "2020-01-01T03:34:33.000001Z", "successCount": "2", "failureCount": "1" }, "done": true, "response": { "@type": "type.googleapis.com/google.cloud.retail.v2.ImportProductsResponse" }, "errorsConfig": { "gcsPrefix": "gs://error-bucket/error-directory" } }
אפשר לבדוק את הקבצים בספריית השגיאות ב-Cloud Storage כדי לראות אילו סוגי שגיאות התרחשו במהלך הייבוא.
-
עוברים לדף Data במסוף AI Commerce Search ב-Gemini Enterprise for Customer Experience.
ייבוא נתוני קטלוג בתוך השורה
curl
כדי לייבא את פרטי הקטלוג בשורה, שולחים בקשת POST לשיטת REST Products:import, ומשתמשים באובייקט productInlineSource כדי לציין את נתוני הקטלוג.
צריך לציין את כל המוצר בשורה אחת. כל מוצר צריך להיות בשורה נפרדת.
דוגמה לפורמט JSON של פריט מוצר מופיעה במאמר פורמט נתוני JSON של פריט מוצר.
יוצרים את קובץ ה-JSON של המוצר וקוראים לו
./data.json:{ "inputConfig": { "productInlineSource": { "products": [ { PRODUCT_1 } { PRODUCT_2 } ] } } }מבצעים קריאה לשיטת POST:
curl -X POST \
 -H "Authorization: Bearer $(gcloud auth application-default print-access-token)" \
 -H "Content-Type: application/json; charset=utf-8" \
 --data @./data.json \
"https://retail.googleapis.com/v2/projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/branches/0/products:import"
Java
פורמט נתוני JSON של פריט מוצר
הערכים של Product בקובץ ה-JSON צריכים להיראות כמו בדוגמאות הבאות.
צריך לציין את כל המוצר בשורה אחת. כל מוצר צריך להיות בשורה נפרדת.
שדות החובה המינימליים:
      {
        "id": "1234",
        "categories": "Apparel & Accessories > Shoes",
        "title": "ABC sneakers"
      }
      {
        "id": "5839",
        "categories": "casual attire > t-shirts",
        "title": "Crew t-shirt"
      }
הצגת אובייקט מלא
      {
        "name": "projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/branches/0/products/1234",
        "id": "1234",
        "categories": "Apparel & Accessories > Shoes",
        "title": "ABC sneakers",
        "description": "Sneakers for the rest of us",
        "attributes": { "vendor": {"text": ["vendor123", "vendor456"]} },
        "language_code": "en",
        "tags": [ "black-friday" ],
        "priceInfo": {
          "currencyCode": "USD", "price":100, "originalPrice":200, "cost": 50
        },
        "availableTime": "2020-01-01T03:33:33.000001Z",
        "availableQuantity": "1",
        "uri":"http://example.com",
        "images": [
          {"uri": "http://example.com/img1", "height": 320, "width": 320 }
        ]
      }
      {
        "name": "projects/PROJECT_NUMBER/locations/global/catalogs/default_catalog/branches/0/products/4567",
        "id": "4567",
        "categories": "casual attire > t-shirts",
        "title": "Crew t-shirt",
        "description": "A casual shirt for a casual day",
        "attributes": { "vendor": {"text": ["vendor789", "vendor321"]} },
        "language_code": "en",
        "tags": [ "black-friday" ],
        "priceInfo": {
          "currencyCode": "USD", "price":50, "originalPrice":60, "cost": 40
        },
        "availableTime": "2020-02-01T04:44:44.000001Z",
        "availableQuantity": "2",
        "uri":"http://example.com",
        "images": [
          {"uri": "http://example.com/img2", "height": 320, "width": 320 }
        ]
      }
נתונים היסטוריים של קטלוג
ב-AI Commerce Search אפשר לייבא ולנהל נתונים היסטוריים של קטלוגים. נתוני קטלוג היסטוריים יכולים לעזור כשמשתמשים באירועים היסטוריים של משתמשים לאימון המודל. אפשר להשתמש בפרטי מוצרים קודמים כדי להעשיר את נתוני האירועים ההיסטוריים של המשתמשים ולשפר את דיוק המודל.
מוצרים היסטוריים נשמרים כמוצרים שתוקפם פג. הם לא מוחזרים בתשובות לחיפוש, אבל הם גלויים לקריאות ל-API של Update, List ו-Delete.
ייבוא נתונים היסטוריים של קטלוג
אם השדה expireTime של מוצר מוגדר לערך של חותמת זמן מהעבר, המוצר הזה נחשב למוצר היסטורי. כדי לא להשפיע על ההמלצות, צריך להגדיר את הזמינות של המוצר כ-OUT_OF_STOCK.
מומלץ להשתמש בשיטות הבאות לייבוא נתונים היסטוריים של קטלוג:
מבצעים קריאה ל-Product.Create.
משתמשים ב-method Product.Create כדי ליצור רשומה של Product עם השדה expireTime שמוגדר לחותמת זמן מהעבר.
ייבוא מוצרים שפג תוקפם בשורה
השלבים זהים לייבוא מוצרים בשורה, רק שבמוצרים צריך להגדיר את השדות expireTime לחותמת זמן מהעבר.
צריך לציין את כל המוצר בשורה אחת. כל מוצר צריך להיות בשורה נפרדת.
דוגמה לשימוש ב-./data.json בבקשת ייבוא מוטבעת:
דוגמה לשימוש בבקשת ייבוא מוטמעת
{
"inputConfig": {
  "productInlineSource": {
      "products": [
          {
            "id": "historical_product_001",
            "categories": "Apparel & Accessories > Shoes",
            "title": "ABC sneakers",
            "expire_time": {
              "second": "2021-10-02T15:01:23Z"  // a past timestamp
            }
          },
          {
            "id": "historical product 002",
            "categories": "casual attire > t-shirts",
            "title": "Crew t-shirt",
            "expire_time": {
              "second": "2021-10-02T15:01:24Z"  // a past timestamp
            }
          }
      ]
    }
  }
}
ייבוא מוצרים שתוקפם פג מ-BigQuery או מ-Cloud Storage
אפשר להשתמש באותן פעולות שמתוארות במאמרים בנושא ייבוא נתוני קטלוג מ-BigQuery או ייבוא נתוני קטלוג מ-Cloud Storage. עם זאת, חשוב להגדיר את השדה expireTime לחותמת זמן מהעבר.
שומרים על קטלוג עדכני
כדי לקבל את התוצאות הטובות ביותר, הקטלוג צריך להכיל מידע עדכני. מומלץ לייבא את הקטלוג מדי יום כדי לוודא שהקטלוג מעודכן. אתם יכולים להשתמש ב-Google Cloud Scheduler כדי לתזמן ייבוא, או לבחור באפשרות של תזמון אוטומטי כשאתם מייבאים נתונים באמצעות מסוףGoogle Cloud .
אתם יכולים לעדכן רק פריטי מוצרים חדשים או פריטי מוצרים שהשתנו, או לייבא את כל הקטלוג. אם מייבאים מוצרים שכבר קיימים בקטלוג, הם לא מתווספים שוב. כל פריט שהשתנה מתעדכן.
כדי לעדכן פריט אחד, אפשר לעיין במאמר בנושא עדכון פרטי מוצרים.
חבילת עדכונים
אתם יכולים להשתמש בשיטת הייבוא כדי לעדכן את הקטלוג שלכם בחבילת עדכונים. התהליך זהה לתהליך הייבוא הראשוני. פועלים לפי השלבים שמפורטים במאמר ייבוא נתוני קטלוג.
מעקב אחר תקינות הייבוא
כדי לעקוב אחרי הטמעת הקטלוג והתקינות שלו:
בדף נתונים של AI Commerce Search ב-Gemini Enterprise for Customer Experience, אפשר לראות נתונים נצברים על הקטלוג ולצפות בתצוגה מקדימה של מוצרים שהועלו.
כדאי לבדוק אם צריך לעדכן את נתוני הקטלוג כדי לשפר את איכות תוצאות החיפוש ולשדרג את רמת הביצועים בחיפוש בדף איכות הנתונים.
מידע נוסף על בדיקת איכות נתוני החיפוש ועל צפייה ברמות הביצועים של החיפוש זמין במאמר הצגת רמות הביצועים של החיפוש. בקטע מדדי איכות הקטלוג שבדף הזה מופיע סיכום של מדדי הקטלוג הזמינים.
כדי ליצור התראות שיעדכנו אתכם אם משהו לא בסדר בהעלאות הנתונים, פועלים לפי ההוראות במאמר הגדרה של התראות ב-Cloud Monitoring.
חשוב לשמור על קטלוג עדכני כדי לקבל תוצאות באיכות גבוהה. אפשר להשתמש בהתראות כדי לעקוב אחרי שיעורי השגיאות בייבוא ולפעול אם צריך.
המאמרים הבאים
- מתחילים להקליט אירועים של משתמשים.
- הצגת נתונים נצברים על הקטלוג.
- הגדרת התראות על העלאת נתונים