


Dengan anotasi peristiwa pada diagram di Cloud Monitoring, Anda dapat menghubungkan tren metrik dengan aktivitas sistem, seperti deployment, failover, atau error. Peristiwa adalah aktivitas yang memengaruhi operasi sistem dan diidentifikasi dari pemberitahuan terbuka, Personalized Service Health, atau entri log. Dasbor dapat menampilkan beberapa anotasi, dan setiap anotasi dapat mencantumkan beberapa peristiwa. Tab Observability untuk layanan seperti Compute Engine dan Google Kubernetes Engine juga dapat menampilkan anotasi, tetapi tidak semua jenis peristiwa didukung.
Untuk setiap jenis peristiwa yang tercantum, dokumen ini menyertakan link ke konten pemecahan masalah dan kueri log yang dapat Anda gunakan di Logs Explorer atau dalam kebijakan pemberitahuan berbasis log. Untuk petunjuk penyiapan, lihat Menampilkan peristiwa di dasbor.
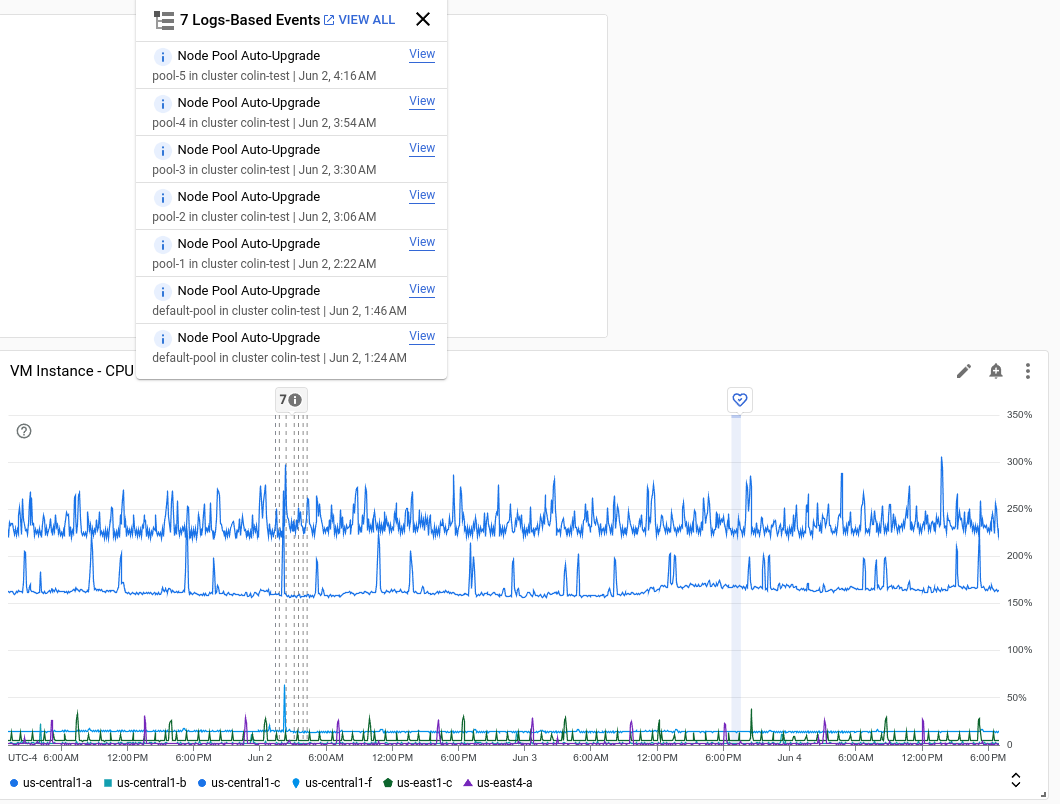
Contoh dasbor dengan anotasi
Screenshot berikut mengilustrasikan diagram yang menampilkan beberapa peristiwa berbasis log dan satu peristiwa Service Health:
Jenis peristiwa notifikasi
Bagian ini menjelaskan jenis peristiwa pemberitahuan yang dapat ditampilkan di dasbor.
Notifikasi dibuka
Peristiwa pemberitahuan dibuka membantu Anda menghubungkan data yang dipetakan dengan waktu pemberitahuan dibuka. Peristiwa pemberitahuan dibuka ditampilkan jika hal berikut terpenuhi:
- Notifikasi yang sesuai dibuka selama rentang waktu yang ditentukan oleh dasbor.
- Notifikasi yang sesuai tidak ditutup.
Notifikasi yang dibuka di luar rentang waktu yang ditentukan oleh dasbor tidak akan ditampilkan. Demikian pula, peristiwa pemberitahuan dibuka tidak ditampilkan saat pemberitahuan yang sesuai dibuka, lalu ditutup dalam rentang waktu yang ditentukan oleh dasbor.
Tooltip untuk peristiwa pemberitahuan dibuka mencakup hal berikut:
- Nama kebijakan pemberitahuan.
- Informasi ringkasan, jika informasi ini tersedia. Misalnya, informasi ini mungkin mencakup nilai minimum dan nilai yang diukur.
- Durasi pemberitahuan, serta tanggal dan waktu pemberitahuan dibuka.
- Label metrik dan resource. Tooltip mungkin tidak menampilkan semua label.
- Tombol Lihat, yang membuka halaman Detail untuk notifikasi.
Jenis peristiwa Google Kubernetes Engine
Bagian ini menjelaskan jenis peristiwa Google Kubernetes Engine yang dapat ditampilkan di dasbor.
Workload GKE yang di-patch atau diupdate
Jenis peristiwa ini membantu Anda memecahkan masalah deployment workload GKE atau perubahan statefulset, karena peristiwa ini dapat berkorelasi dengan regresi performa atau masalah performa lainnya. Jenis peristiwa ini ditampilkan saat workload dibuat, diperbarui, atau dihapus.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(cloudaudit.googleapis.com%2Factivity)
resource.type=k8s_cluster protoPayload.methodName=(
    io.k8s.apps.v1.deployments.create OR io.k8s.apps.v1.deployments.patch OR
    io.k8s.apps.v1.deployments.update OR io.k8s.apps.v1.deployments.delete OR
    io.k8s.apps.v1.statefulsets.create OR io.k8s.apps.v1.statefulsets.patch OR
    io.k8s.apps.v1.statefulsets.update OR io.k8s.apps.v1.statefulsets.delete OR
    io.k8s.apps.v1.daemonsets.create OR io.k8s.apps.v1.daemonsets.patch OR
    io.k8s.apps.v1.daemonsets.update OR io.k8s.apps.v1.daemonsets.delete
)
-protoPayload.authenticationInfo.principalEmail=("system:addon-manager" OR "system:serviceaccount:kube-system:namespace-controller")
-protoPayload.request.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.response.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.resourceName=~"namespaces/(kube-system|gmp-system|gmp-public|gke-gmp-system|istio-system)"
Untuk informasi tambahan, lihat Ringkasan deployment workload dan Melihat metrik kemampuan observasi.
Error pada pod GKE
Jenis peristiwa ini membantu Anda mengidentifikasi dan memecahkan masalah error pod GKE. Error Pod dapat disebabkan oleh kehabisan memori atau error aplikasi. Jenis peristiwa ini ditampilkan saat salah satu hal berikut terjadi:
- Status pod adalah
CrashLoopBackOff. - Pod dihentikan dengan kode keluar bukan nol.
- Pod dihentikan dengan kondisi kehabisan memori.
- Pod dihapus.
- Pemeriksaan kesiapan atau keaktifan gagal.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
(
    log_id(events)
    (
        (resource.type=k8s_pod jsonPayload.reason=(BackOff OR Unhealthy OR Killing OR Evicted)) OR
        (resource.type=k8s_node jsonPayload.reason=OOMKilling)
    )
    severity=WARNING
) OR (
    log_id(cloudaudit.googleapis.com%2Factivity) resource.type=k8s_cluster
    (protoPayload.methodName=io.k8s.core.v1.pods.eviction.create OR
        (protoPayload.methodName=io.k8s.core.v1.pods.delete
        protoPayload.response.status.containerStatuses.state.terminated.exitCode:*
        -protoPayload.response.status.containerStatuses.state.terminated.exitCode=0
        )
    )
)
Untuk mengetahui informasi pemecahan masalah, lihat Memecahkan masalah: CrashLoopBackOff.
Kegagalan menjadwalkan pod GKE
Jenis peristiwa ini membantu Anda mengidentifikasi dan memecahkan masalah pod yang tidak dapat dijadwalkan pada node. Jenis peristiwa ini ditampilkan saat penjadwalan pod gagal karena salah satu alasan berikut:
- CPU node tidak memadai.
- Memori node tidak cukup.
- Tidak ada node untuk taint atau toleransi.
- Node pada batas pod maksimum.
- Node pool dalam ukuran maksimum.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
(
    log_id(events) resource.type=k8s_pod jsonPayload.reason=(NotTriggerScaleUp OR FailedScheduling)
) OR (
    log_id(container.googleapis.com/cluster-autoscaler-visibility)
    resource.type=k8s_cluster jsonPayload.noDecisionStatus.noScaleUp:*
)
Untuk mengetahui informasi pemecahan masalah, lihat Memecahkan masalah: Pod tidak dapat diberi jadwal.
Gagal membuat container GKE
Jenis peristiwa ini membantu Anda mengidentifikasi dan memecahkan masalah kegagalan dalam membuat container GKE. Pembuatan container mungkin gagal karena alasan seperti pemasangan volume yang gagal atau pengambilan image yang gagal.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(events) resource.type=k8s_pod jsonPayload.reason=(Failed OR FailedMount) severity=WARNING
Untuk mengetahui informasi pemecahan masalah tentang penarikan image, lihat Memecahkan masalah penarikan image.
Peningkatan dan penurunan skala autoscaler pod
Peristiwa ini memberi Anda visibilitas ke penskalaan ulang Horizontal Pod Autoscaler, yang meningkatkan atau mengurangi jumlah pod yang berjalan untuk workload. Untuk mengetahui informasi selengkapnya, lihat Penskalaan otomatis Pod horizontal.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=k8s_cluster log_id(events)
jsonPayload.involvedObject.kind=HorizontalPodAutoscaler jsonPayload.reason=SuccessfulRescale
Peningkatan dan penurunan skala autoscaler cluster
Peristiwa ini memberi Anda visibilitas saat autoscaler cluster meningkatkan atau menurunkan skala jumlah node dalam node pool cluster Anda. Untuk mengetahui informasi selengkapnya, lihat Tentang penskalaan otomatis cluster dan Melihat peristiwa autoscaler cluster.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
(resource.type=k8s_cluster log_id(container.googleapis.com%2Fcluster-autoscaler-visibility)
jsonPayload.decision:*)
Pembuatan dan penghapusan cluster
Peristiwa ini melacak tindakan pembuatan dan penghapusan cluster GKE. Untuk mengetahui informasi selengkapnya, lihat Membuat cluster Autopilot, Membuat cluster zona, dan Menghapus cluster.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
protoPayload.methodName=(
    google.container.v1alpha1.ClusterManager.CreateCluster OR
    google.container.v1beta1.ClusterManager.CreateCluster OR
    google.container.v1.ClusterManager.CreateCluster OR
    google.container.v1alpha1.ClusterManager.DeleteCluster OR
    google.container.v1beta1.ClusterManager.DeleteCluster OR
    google.container.v1.ClusterManager.DeleteCluster
)
operation.first=true
Update cluster
Peristiwa ini melacak update cluster GKE. Update mencakup upgrade versi bidang kontrol otomatis serta upgrade manual dan perubahan konfigurasi cluster. Untuk mengetahui informasi selengkapnya, lihat Mengupgrade cluster atau node pool secara manual dan Upgrade cluster Standard.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.PatchCluster OR
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.UpdateCluster
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateCluster OR
        google.container.v1.ClusterManager.UpdateCluster
    )
    operation.first=true
)
protoPayload.metadata.operationType=(UPGRADE_MASTER OR REPAIR_CLUSTER OR UPDATE_CLUSTER)
Update node pool
Peristiwa ini melacak update node pool GKE. Update mencakup upgrade versi node pool otomatis serta upgrade manual, perubahan konfigurasi, dan pengubahan ukuran. Untuk mengetahui informasi selengkapnya, lihat Mengupgrade cluster atau node pool secara manual dan Upgrade cluster Standard.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gke_nodepool log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.RepairNodePool
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateNodePool OR
        google.container.v1.ClusterManager.UpdateNodePool OR
        google.container.v1beta1.ClusterManager.SetNodePoolSize OR
        google.container.v1.ClusterManager.SetNodePoolSize OR
        google.container.v1beta1.ClusterManager.SetNodePoolManagement OR
        google.container.v1.ClusterManager.SetNodePoolManagement OR
        google.container.v1beta1.ClusterManager.SetNodePoolAutoscaling OR
        google.container.v1.ClusterManager.SetNodePoolAutoscaling
    )
    operation.first=true
)
Jenis peristiwa Cloud Run
Bagian ini menjelaskan jenis peristiwa Cloud Run yang dapat ditampilkan di dasbor.
Deployment Cloud Run
Jenis peristiwa ini membantu Anda mengidentifikasi dan memecahkan masalah kegagalan deployment Cloud Run. Deployment mungkin gagal karena alasan seperti akun layanan yang dihapus, izin yang salah, impor container yang gagal, atau container yang gagal dimulai.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloud_run_revision
protoPayload.methodName=google.cloud.run.v1.Services.ReplaceService
Untuk mengetahui informasi pemecahan masalah, lihat Memecahkan masalah: Masalah Cloud Run.
Jenis peristiwa Cloud SQL
Bagian ini menjelaskan jenis peristiwa Cloud SQL yang dapat ditampilkan di dasbor.
Failover Cloud SQL
Jenis peristiwa ini membantu Anda mengidentifikasi kapan failover manual atau otomatis terjadi. Failover terjadi saat ada kegagalan instance atau zona dan instance standby menjadi instance utama baru. Selama failover, Cloud SQL akan otomatis beralih ke penyajian data dari instance standby.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=cloudsql_database
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=cloudsql.instances.failover
        operation.last=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.autoFailover
    )
)
Untuk informasi tambahan, lihat Tentang ketersediaan tinggi.
Memulai atau menghentikan Cloud SQL
Jenis peristiwa ini membantu Anda mengidentifikasi kapan instance Cloud SQL telah dimulai, dihentikan, atau dimulai ulang secara manual. Saat instance dihentikan, semua koneksi, file yang terbuka, dan operasi yang berjalan juga akan dihentikan.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloudsql_database
protoPayload.methodName=cloudsql.instances.update operation.last=true
protoPayload.metadata.intents.intent=(START_INSTANCE OR STOP_INSTANCE)
Untuk informasi tambahan, lihat Tentang ketersediaan tinggi dan Memulai, menghentikan, dan memulai ulang instance.
Penyimpanan Cloud SQL
Jenis peristiwa ini membantu Anda mengidentifikasi peristiwa yang terkait dengan penyimpanan Cloud SQL, termasuk saat penyimpanan database penuh, dan saat database dinonaktifkan karena mencapai kapasitas penyimpanan. Database dengan kapasitas penyimpanan penuh dan tanpa penyimpanan otomatis yang diaktifkan mungkin akan dinonaktifkan untuk mencegah kerusakan data.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=cloudsql_database
(
    (
        (log_id(cloudsql.googleapis.com%2Fpostgres.log) OR log_id(cloudsql.googleapis.com%2Fmysql.err))
        textPayload=~"No space left on device"
        severity=(ERROR OR EMERGENCY)
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.databaseShutdownOutOfStorage
    )
)
Jenis peristiwa Cloud Interconnect
Bagian ini menjelaskan jenis peristiwa Cloud Interconnect yang dapat ditampilkan di dasbor.
Pemeliharaan Interconnect dimulai
Jenis peristiwa ini melacak awal pemeliharaan infrastruktur untuk interkoneksi. Selama durasi peristiwa pemeliharaan, sesi Border Gateway Protocol (BGP) pada lampiran jaringan area lokal virtual (VLAN) akan nonaktif.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="RUNNING"
labels."maintenance.googleapis.com/updated_fields" : "state"
Untuk mengetahui informasi selengkapnya, lihat Peristiwa pemeliharaan infrastruktur.
Pemeliharaan Interconnect selesai
Jenis peristiwa ini melacak akhir pemeliharaan infrastruktur untuk interconnect. Alamat MAC Ethernet perangkat edge dapat berubah setelah peristiwa pemeliharaan tertentu.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="SUCCEEDED"
labels."maintenance.googleapis.com/updated_fields" : "state"
Untuk mengetahui informasi selengkapnya, lihat Peristiwa pemeliharaan infrastruktur.
Jenis peristiwa Cloud VPN
Bagian ini menjelaskan jenis peristiwa Cloud VPN yang dapat ditampilkan di dasbor.
Pemeliharaan VPN
Jenis peristiwa ini melacak pemeliharaan infrastruktur untuk tugas VPN. Hal ini mencakup peristiwa untuk pemeliharaan yang dimulai dan pemeliharaan yang selesai.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Starting VPN task maintenance" OR
    textPayload:"VPN task maintenance Completed"
)
Pemilih traffic VPN dipersempit
Jenis peristiwa ini membantu mengidentifikasi kapan pemilih traffic dipersempit untuk Child SA. Hal ini mencakup peristiwa untuk pemilih traffic lokal dan jarak jauh.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Warning: Local traffic selectors narrowed for Child SA" OR
    textPayload:"Warning: Remote traffic selectors narrowed for Child SA"
)
Jenis peristiwa Compute Engine
Bagian ini menjelaskan jenis peristiwa Compute Engine yang dapat ditampilkan di dasbor.
Penghentian virtual machine
Jenis peristiwa ini membantu Anda mengidentifikasi penghentian virtual machine (VM), termasuk reset dan penghentian yang dipicu secara manual, penghentian OS tamu, penghentian pemeliharaan, dan error host.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(
            beta.compute.instances.reset OR v1.compute.instances.reset OR
            beta.compute.instances.stop OR v1.compute.instances.stop
        )
        operation.first=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=(
            compute.instances.hostError OR
            compute.instances.guestTerminate OR
            compute.instances.terminateOnHostMaintenance
        )
    )
)
Untuk informasi tambahan, lihat Menghentikan dan memulai VM serta Memecahkan masalah penonaktifan dan reboot VM.
Kegagalan memulai instance VM
Peristiwa ini melacak kegagalan memulai instance VM Compute Engine. Peristiwa ini menunjukkan kegagalan memulai karena kehabisan stok, kehabisan ruang IP, kuota terlampaui, atau error integritas shielded-VM.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(beta.compute.instances.insert OR v1.compute.instances.insert)
        protoPayload.status.message=(ZONE_RESOURCE_POOL_EXHAUSTED OR IP_SPACE_EXHAUSTED OR QUOTA_EXCEEDED)
    ) OR (
        log_id(compute.googleapis.com%2Fshielded_vm_integrity)
        severity="ERROR"
    )
)
Error OS tamu instance VM
Peristiwa ini melacak error Guest OS instance VM Compute Engine tertentu seperti yang dicatat oleh log konsol serial. Error yang dilacak adalah disk penuh, pemasangan sistem file yang gagal, dan kegagalan booting yang mengaktifkan mode darurat Linux.
Agar peristiwa ini terlihat, Anda harus mengaktifkan logging output port serial ke Cloud Logging dengan menetapkan serial-port-logging-enable=true di VM atau di metadata project. Untuk mengetahui informasi selengkapnya, lihat
Mengaktifkan dan menonaktifkan logging output port serial.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gce_instance
log_id(serialconsole.googleapis.com%2Fserial_port_1_output)
textPayload=~("No space left on device" OR "Failed to mount" OR "You are in emergency mode")
Update grup instance terkelola
Jenis peristiwa ini membantu Anda mengidentifikasi kapan Grup Instance Terkelola (MIG) Anda telah diperbarui. Misalnya, VM telah ditambahkan atau dihapus, atau batas ukuran telah diperbarui. Untuk mengetahui informasi selengkapnya, lihat Menerapkan update konfigurasi VM secara otomatis di MIG.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=gce_instance_group_manager
log_id(cloudaudit.googleapis.com%2Factivity) operation.first=true
protoPayload.methodName=(beta.compute.instanceGroupManagers.patch OR v1.compute.instanceGroupManagers.patch)
Untuk informasi tambahan, lihat Bekerja dengan instance terkelola dan Memecahkan masalah grup instance terkelola.
Autoscaler grup instance terkelola
Peristiwa ini melacak keputusan penskalaan yang dibuat oleh autoscaler MIG. Keputusan ini dapat mencakup perubahan pada ukuran yang direkomendasikan untuk MIG, atau perubahan pada status autoscaler itu sendiri. Untuk mengetahui informasi selengkapnya, lihat Penskalaan otomatis grup instance.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
resource.type=autoscaler log_id(cloudaudit.googleapis.com%2Fsystem_event)
protoPayload.methodName=(compute.autoscalers.resize OR compute.autoscalers.changeStatus)
Jenis peristiwa Personalized Service Health
Bagian ini menjelaskan jenis peristiwa Personalized Service Health yang dapat ditampilkan di dasbor.
Google Cloud insiden
Saat memecahkan masalah, Anda mungkin ingin membedakan antara kegagalan yang disebabkan oleh layanan yang Anda miliki dan kegagalan yang disebabkan oleh Google Cloud layanan yang Anda gunakan. Saat mengaktifkan anotasi Personalized Service Health di dasbor, Anda dapat melihat gangguan, atau peristiwa respons layanan, untuk layanan Google Cloud . Untuk mengetahui daftar layanan yang terintegrasi dengan Service Health, lihat Produk Google yang didukung.
Tidak seperti jenis peristiwa lainnya,insiden Google Cloud tidak diidentifikasi dengan menganalisis entri log Anda. Jika Anda ingin mendapatkan notifikasi saat peristiwa ini terjadi, buat kebijakan pemberitahuan. Anda dapat memilih kebijakan pemberitahuan yang telah dikonfigurasi sebelumnya dengan menggunakan opsi di halaman Dasbor Service Health. Untuk mengetahui informasi selengkapnya, lihat Panduan memulai: Menyiapkan pemberitahuan.
Monitoring mengidentifikasi insiden Google Cloud dengan mengeluarkan permintaan ke Service Health API, lalu memfilter respons terhadap insiden yang relevan dengan data yang Anda lihat. Permintaan tersebut memiliki konfigurasi berikut:
Enumerasi
Relevanceditetapkan keRELATED,IMPACTED, atauPARTIALLY_RELATED. Batasan ini memastikan dasbor Anda hanya menampilkan peristiwa untuk layanan Google Cloud yang digunakan projectGoogle Cloud Anda.Enumerasi
DetailedStatetidak ditetapkan keFALSE_POSITIVE.
Anotasi Service Health ditampilkan dengan waktu mulai dan durasi. Durasi ditampilkan dengan mengubah warna latar belakang diagram. Tooltip untuk insiden Google Cloud mengidentifikasi hal berikut:
- Layanan Google Cloud .
- Apakah insiden sedang berlangsung atau sudah diselesaikan.
- Tanggal dan waktu mulai acara.
- Chip yang menampilkan jumlah produk dan lokasi yang terpengaruh. Untuk mencantumkan produk atau lokasi yang terpengaruh, tempatkan kursor pada chip yang sesuai.
- Tombol View, yang jika dipilih akan membuka halaman detail untuk insiden tersebut.
Untuk mengetahui informasi tentang cara mengirim permintaan ke Service Health API, lihat Memeriksa gangguan dengan Service Health.
Untuk mengetahui informasi pemecahan masalah, lihat Memecahkan masalah umum di Service Health.
Jenis peristiwa cek uptime
Bagian ini menjelaskan jenis peristiwa cek uptime yang dapat ditampilkan di dasbor.
Kegagalan cek uptime
Jenis peristiwa ini membantu Anda mengidentifikasi kegagalan cek uptime dari region yang dikonfigurasi.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(monitoring.googleapis.com%2Fuptime_checks)
(
  resource.type=uptime_url OR resource.type=gce_instance OR
  resource.type=gae_app OR resource.type=k8s_service OR
  resource.type=servicedirectory_service OR resource.type=cloud_run_revision OR
  resource.type=aws_ec2_instance OR resource.type=aws_elb_load_balancer
)
labels.uptime_result_type=UptimeCheckResult
severity=NOTICE
Untuk mengetahui informasi pemecahan masalah, lihat Memecahkan masalah monitor sintetis dan cek uptime.
Jenis peristiwa Agen untuk SAP
Bagian ini menjelaskan jenis peristiwa Agen untuk SAP yang dapat ditampilkan di dasbor.
Ketersediaan SAP
Jenis peristiwa ini membantu Anda mengidentifikasi peristiwa yang terkait dengan ketersediaan Agen untuk SAP. Peristiwa ini dipicu saat ketersediaan SAP HANA, SAP NetWeaver, atau Cluster Pacemaker berubah.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=(workload.googleapis.com/sap/hana/service OR workload.googleapis.com/sap/hana/availability OR
  workload.googleapis.com/sap/nw/service OR workload.googleapis.com/sap/nw/availability OR
  workload.googleapis.com/sap/cluster/nodes OR workload.googleapis.com/sap/cluster/resources)
SAP Backint
Jenis peristiwa ini membantu Anda mengidentifikasi peristiwa yang terkait dengan Agen untuk SAP Backint. Setiap pencadangan atau pemulihan Backint menulis peristiwa yang menjelaskan keberhasilan atau kegagalan beserta statistik transfer. Pencadangan dan pemulihan log hanya ditampilkan saat terjadi kegagalan, sedangkan pencadangan dan pemulihan data ditampilkan saat berhasil dan gagal.
log_id(google-cloud-sap-agent-backint)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
(jsonPayload.fileType=data OR (jsonPayload.fileType=log AND jsonPayload.success=false))
jsonPayload.message=SAP_BACKINT_FILE_TRANSFER
Operasi SAP
Jenis peristiwa ini membantu Anda mengidentifikasi peristiwa yang terkait dengan operasi Agen untuk SAP. Peristiwa ini dipicu saat status replikasi SAP HANA berubah.
Jika Anda ingin membuat kebijakan pemberitahuan berbasis log untuk jenis peristiwa ini, gunakan kueri berikut:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=workload.googleapis.com/sap/hana/ha/replication
Langkah berikutnya
Untuk mempelajari cara menampilkan peristiwa di dasbor, lihat Menampilkan peristiwa di dasbor.