


כברירת מחדל, סוכן תפעול מוגדר לאסוף מדדים שמתעדים מידע על התהליכים שפועלים במכונות הווירטואליות (VM) של Compute Engine. קבוצת המדדים הזו נקראת מדדי תהליכים, ואפשר לזהות אותה לפי הקידומת agent.googleapis.com/processes.
גם סוכן Monitoring הקודם אוסף את המדדים האלה במכונות וירטואליות של Compute Engine או של Amazon Elastic Compute Cloud (EC2). מדדי תהליכים לא נאספים ב-Google Kubernetes Engine (GKE).
החל מ-6 באוגוסט 2021, יחולו חיובים על המדדים האלה, כפי שמתואר בקטע "מדדים בתשלום" בדף התמחור של Google Cloud Observability. קבוצת המדדים של התהליכים מסווגת כניתנת לחיוב, אבל החיובים אף פעם לא הוטמעו.
במאמר הזה נתאר כלים להצגה חזותית של מדדי תהליכים, איך לקבוע את כמות הנתונים שאתם מטמיעים מהמדדים האלה ואיך לצמצם את החיובים שקשורים אליהם.
עבודה עם מדדי תהליכים
אתם יכולים להציג באופן חזותי את נתוני המדדים של התהליכים באמצעות תרשימים שנוצרו באמצעות Metrics Explorer או מרכזי בקרה בהתאמה אישית. איך משתמשים במרכזי בקרה ובתרשימים בנוסף, Cloud Monitoring כולל נתונים ממדדי תהליכים בשני מרכזי בקרה מוגדרים מראש:
- לוח הבקרה VM Instances ב-Monitoring
- מרכז הבקרה Details של מכונה וירטואלית ב-Compute Engine
בקטעים הבאים מתוארים מרכזי הבקרה האלה.
מעקב: הצגת מדדי תהליכים מצטברים
כדי לראות מדדי תהליכים מצטברים בהיקף המדדים בפרויקט, נכנסים לכרטיסייה Processes במרכז הבקרה VM Instances:
-
נכנסים לדף Dashboards במסוף Google Cloud :
אם אתם משתמשים בשורת החיפוש כדי למצוא את הדף הזה, בחרו בתוצאה שכותרת המשנה שלה היא Monitoring.
בוחרים את מרכז הבקרה VM Instances מהרשימה.
לוחצים על תהליכים.
בצילום המסך הבא מוצגת דוגמה לדף Processes ב-Monitoring:
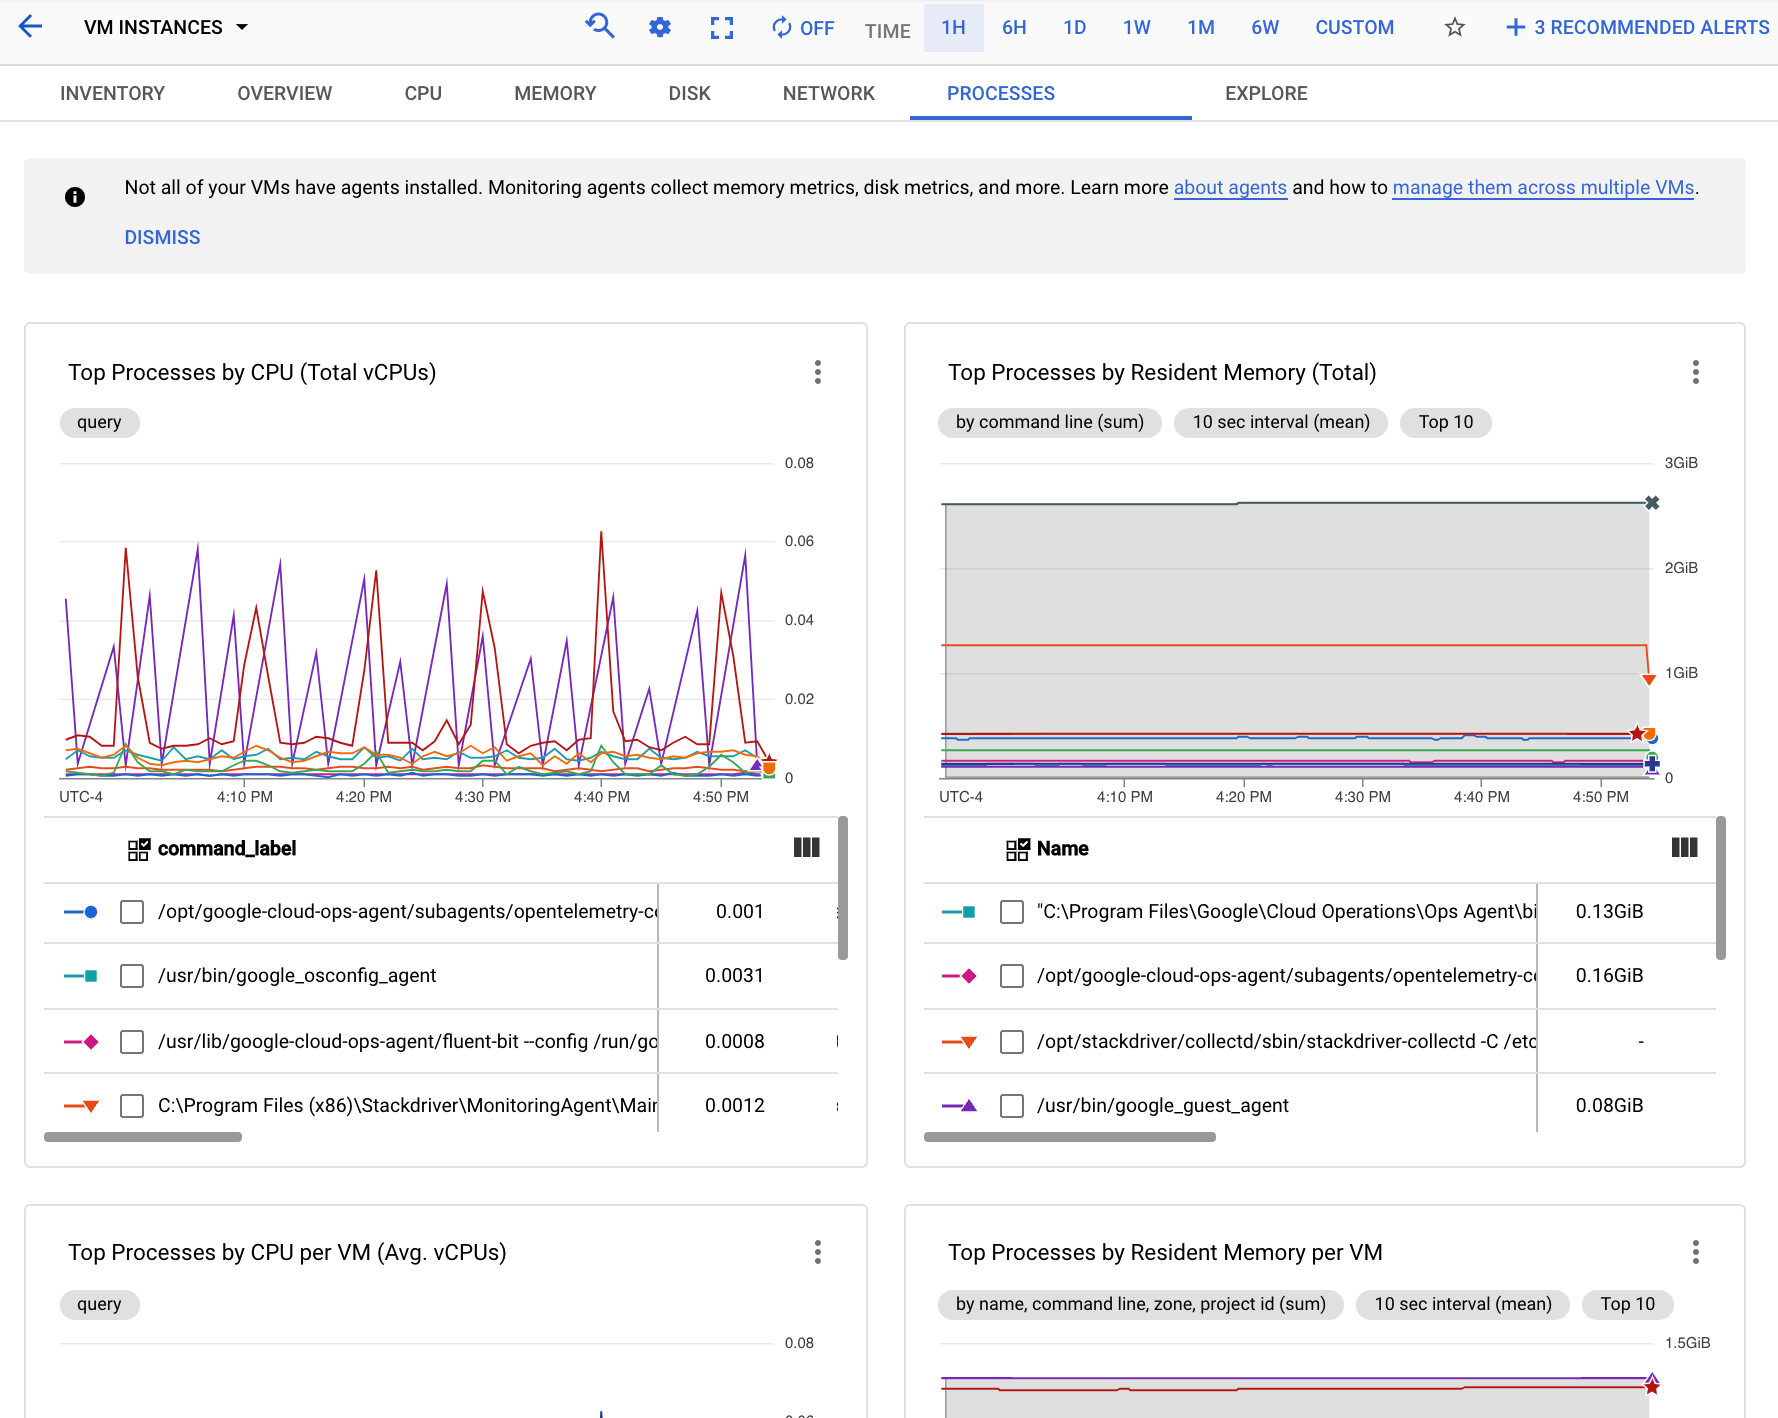
אתם יכולים להשתמש בתרשימים שבכרטיסייה Processes כדי לזהות את התהליכים בהיקף המדדים בפרויקט שצורכים הכי הרבה מעבד וזיכרון, ושהניצול שלהם בדיסק הוא הגבוה ביותר.
Compute Engine: הצגת מדדי ביצועים של מכונות וירטואליות שצורכות הכי הרבה משאבים
כדי להציג את תרשימי הביצועים של חמש המכונות הווירטואליות שצורכות הכי הרבה משאבים בפרויקט Google Cloud , נכנסים לכרטיסייה Observability של המכונות הווירטואליות:
-
נכנסים לדף VM instances במסוף Google Cloud :
אם אתם משתמשים בשורת החיפוש כדי למצוא את הדף הזה, בחרו בתוצאה שכותרת המשנה שלה היא Compute Engine.
- לוחצים על Observability.
בצילום המסך הבא מוצגת דוגמה לדף Observability של Compute Engine.
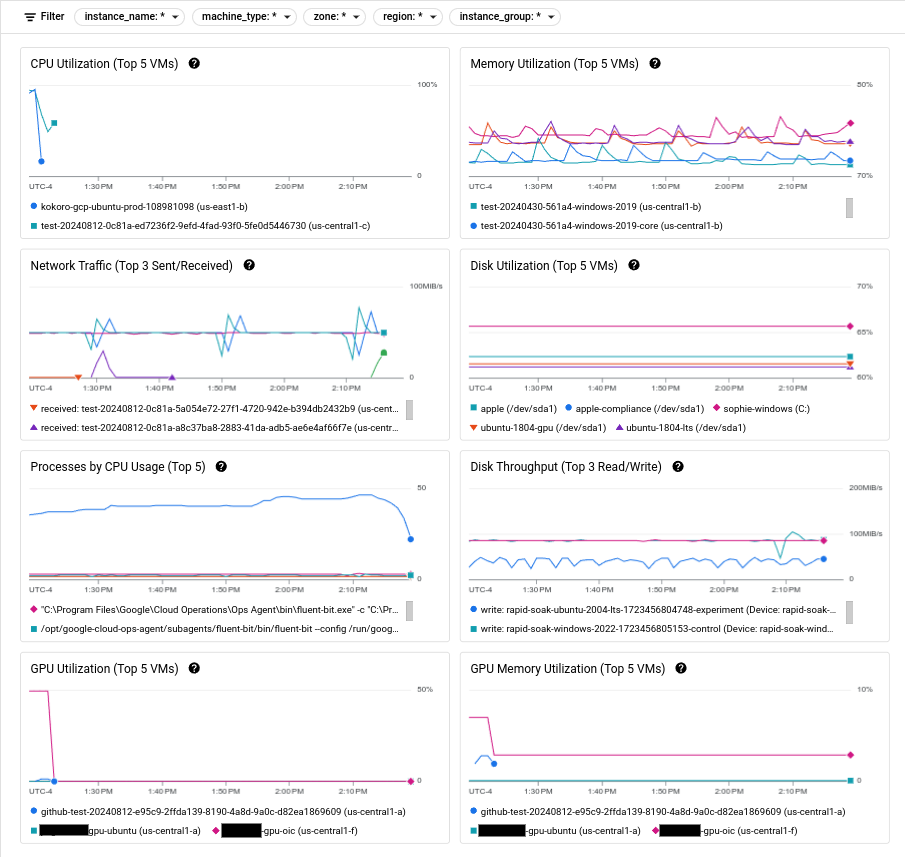
במאמר פתרון בעיות בביצועים של מכונות וירטואליות מוסבר איך להשתמש במדדים האלה כדי לאבחן בעיות במכונות הווירטואליות.
Compute Engine: הצגת מדדי תהליכים לכל מכונה וירטואלית
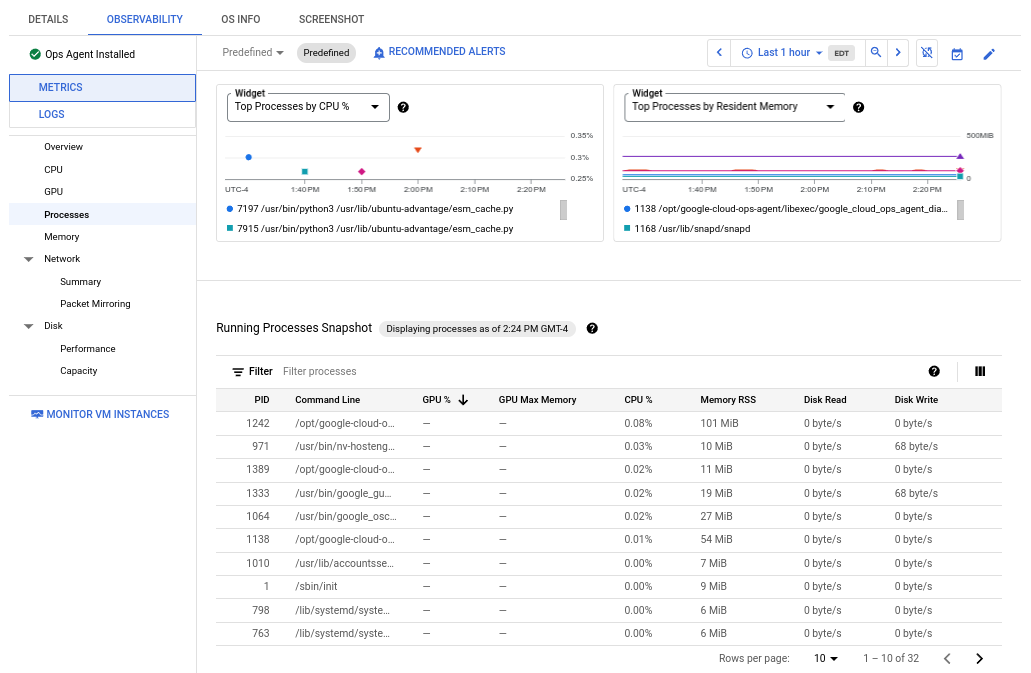
כדי לראות רשימה של התהליכים שפועלים במכונה וירטואלית (VM) אחת של Compute Engine, ותרשימים של התהליכים עם צריכת המשאבים הגבוהה ביותר, נכנסים לכרטיסייה Observability של המכונה הווירטואלית:
-
נכנסים לדף VM instances במסוף Google Cloud :
אם אתם משתמשים בשורת החיפוש כדי למצוא את הדף הזה, בחרו בתוצאה שכותרת המשנה שלה היא Compute Engine.
בכרטיסייה Instances, לוחצים על השם של המכונה הווירטואלית שרוצים לבדוק.
לוחצים על Observability כדי לראות את המדדים של המכונה הווירטואלית הזו.
בחלונית הניווט בכרטיסייה Observability, בוחרים באפשרות Processes.
בצילום המסך הבא מוצגת דוגמה לדף Processes ב-Compute Engine:
מדדי התהליכים נשמרים עד 24 חודשים, כך שתוכלו להשתמש בהם כדי להסתכל אחורה בזמן ולייחס חריגות בצריכת המשאבים לתהליכים ספציפיים, או לזהות את צרכני המשאבים היקרים ביותר. לדוגמה, בתרשים הבא מוצגים התהליכים שצורכים את האחוזים הגבוהים ביותר של משאבי המעבד (CPU). אתם יכולים להשתמש בבורר טווח התאריכים כדי לשנות את טווח התאריכים של התרשים. בורר טווח התאריכים מציע ערכים מוגדרים מראש, כמו השעה האחרונה, ואפשר גם להזין טווח תאריכים בהתאמה אישית.
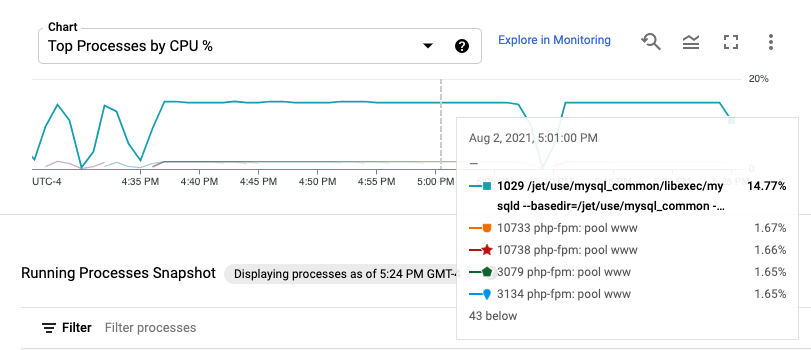
בטבלה Running Processes מופיעה רשימה של צריכת המשאבים, בדומה לפלט של הפקודה top ב-Linux.
כברירת מחדל, בטבלה מוצגת תמונת מצב של הנתונים העדכניים ביותר.
עם זאת, אם בוחרים טווח זמן בתרשים שמסתיים בעבר, בטבלה מוצגים התהליכים שפועלים בסוף הטווח הזה.
במאמר פתרון בעיות בביצועים של מכונות וירטואליות מוסבר איך להשתמש במדדים האלה כדי לאבחן בעיות במכונות הווירטואליות.
מדדי תהליכים שנאספים על ידי הנציג
סוכני Linux אוספים את כל המדדים שמפורטים בטבלה הבאה מתהליכים שפועלים במכונות וירטואליות של Compute Engine ובמכונות וירטואליות של Amazon Elastic Compute Cloud (EC2), כשמשתמשים בסוכן Monitoring הקודם.
אתם יכולים להשבית את איסוף המדדים של התהליכים על ידי סוכן תפעול (גרסאות 2.0.0 ואילך) ועל ידי סוכן מעקב המדור קודם ב-Linux. ב-Windows, אתם יכולים להשבית את האיסוף של מדדי התהליכים על ידי סוכן תפעול (גרסאות 2.0.0 ואילך). עם זאת, אי אפשר להשבית את האיסוף בסוכן Monitoring הקודם. במקרה כזה, מומלץ לשדרג ל-Ops Agent מגרסה 2.0.0 ואילך.
מידע נוסף זמין במאמר השבתת מדדי תהליכים.
טבלה של מדדי תהליכים
למחרוזות של "סוג המדד" בטבלה הזו צריך להוסיף את הקידומת agent.googleapis.com/processes/. הקידומת הזו הושמטה מהרשומות בטבלה.
כששולחים שאילתה לגבי תווית, צריך להשתמש בקידומת metric.labels., לדוגמה metric.labels.LABEL="VALUE".
| סוג המדד שלב ההשקה (רמות היררכיית המשאבים) השם המוצג |
|
|---|---|
| סוג, סוג, יחידה משאבים במעקב |
תיאור תוויות |
count_by_state
GA
(פרויקט)
תהליכים |
|
GAUGE, DOUBLE, 1
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
מספר התהליכים במצב הנתון. ב-Linux בלבד. נדגמים כל 60 שניות.
state:
פועל, במצב שינה, זומבי וכו'.
|
cpu_time
GA
(פרויקט)
מעבד (CPU) של תהליך |
|
CUMULATIVE, INT64, us{CPU}
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
זמן המעבד (CPU) של התהליך הנתון. נדגם כל 60 שניות.
process:
שם התהליך.
user_or_syst:
אם מדובר בתהליך של משתמש או של מערכת.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
disk/read_bytes_count
GA
(פרויקט)
קלט/פלט של קריאת דיסק בתהליך |
|
CUMULATIVE, INT64, By
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
קלט/פלט של קריאת דיסק בתהליך. ב-Linux בלבד. נדגם כל 60 שניות.
process:
שם התהליך.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
disk/write_bytes_count
GA
(פרויקט)
קלט/פלט של כתיבה בדיסק של תהליך |
|
CUMULATIVE, INT64, By
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
קלט/פלט של כתיבה בדיסק של תהליך. ב-Linux בלבד. נדגם כל 60 שניות.
process:
שם התהליך.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
fork_count
GA
(פרויקט)
מספר הפיצולים |
|
CUMULATIVE, INT64, 1
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
המספר הכולל של התהליכים שפוצלו. ב-Linux בלבד. נדגם כל 60 שניות. |
rss_usage
GA
(פרויקט)
זיכרון תושב של תהליך |
|
GAUGE, DOUBLE, By
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
השימוש בזיכרון הפיזי של התהליך הנתון. ב-Linux בלבד. נדגם כל 60 שניות.
process:
שם התהליך.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
vm_usage
GA
(פרויקט)
זיכרון וירטואלי של תהליך |
|
GAUGE, DOUBLE, By
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
השימוש של התהליך הנתון במכונה הווירטואלית. נדגם כל 60 שניות.
process:
שם התהליך.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
windows/handles
ALPHA
(project)
Process open handles (Windows) |
|
GAUGE, INT64, 1
aws_ec2_instance baremetalsolution.googleapis.com/Instance gce_instance |
מספר נקודות האחיזה הפתוחות של התהליך הנתון. Windows בלבד. נדגם כל 60 שניות.
process:
שם התהליך.
command:
פקודת עיבוד.
command_line:
שורת הפקודה של התהליך, עד 1,024 תווים.
owner:
הבעלים של התהליך.
pid:
מזהה התהליך.
|
הטבלה נוצרה ב-22 באוקטובר 2026 בשעה 02:44:18 לפי שעון UTC.
איך בודקים את קצב הטעינה הנוכחי
אתם יכולים להשתמש ב-Metrics Explorer כדי לראות כמה נתונים אתם מטמיעים למדדי תהליכים. כך עושים את זה:
-
במסוף Google Cloud , נכנסים לדף leaderboard Metrics explorer:
אם אתם משתמשים בשורת החיפוש כדי למצוא את הדף הזה, בחרו בתוצאה שכותרת המשנה שלה היא Monitoring.
בסרגל הכלים של החלונית query-builder, לוחצים על הלחצן code PromQL.
כדי לראות את המספר הכולל של נקודות מדדי התהליכים של המשאבים
gce_instanceו-aws_ec2_instance:מזינים את השאילתה הבאה:
sum_over_time(
  sum by (resource_type) (
    label_replace(
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/cpu_time", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "cpu_time", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/disk/read_bytes_count", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "disk_read_bytes_count", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/disk/write_bytes_count", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "disk_write_bytes_count", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/rss_usage", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "rss_usage", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/vm_usage", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "vm_usage", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/count_by_state", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "count_by_state", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/fork_count", monitored_resource="gce_instance"}[1m])),
        "metric_suffix", "fork_count", "", ""
      ),
      "resource_type", "gce_instance", "", ""
    )
    or
    label_replace(
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/cpu_time", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "cpu_time", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/disk/read_bytes_count", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "disk_read_bytes_count", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/disk/write_bytes_count", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "disk_write_bytes_count", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/rss_usage", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "rss_usage", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/vm_usage", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "vm_usage", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/count_by_state", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "count_by_state", "", ""
      )
      or
      label_replace(
        sum(count_over_time({"agent.googleapis.com/processes/fork_count", monitored_resource="aws_ec2_instance"}[1m])),
        "metric_suffix", "fork_count", "", ""
      ),
      "resource_type", "aws_ec2_instance", "", ""
    )
  )[1d:]
)
לוחצים על Run Query. בתרשים שנוצר מוצגים הערכים של כל סוג משאב.
הערכת העלות של המדדים
דוגמאות התמחור של Monitoring ממחישות איך אפשר להעריך את עלות הטמעת המדדים. אפשר להחיל את הדוגמאות האלה על מדדי תהליכים.
כל המדדים של התהליך נדגמים כל 60 שניות, ובכולם נכתבות נקודות על הגרף שנספרות כ-8 בייטים למטרות תמחור.
התמחור של מדדי התהליכים נקבע ל-5% מהעלות הסטנדרטית של נפח הנתונים שמופיעה בדוגמאות לתמחור. לכן, אם מניחים שכל המדדים בתרחישים שמתוארים בדוגמאות האלה הם מדדי תהליכים, אפשר להשתמש ב-5% מהעלות הכוללת של כל תרחיש כאומדן לעלות של מדדי התהליכים.
השבתת האיסוף של מדדי תהליכים
יש כמה דרכים להשבית את איסוף המדדים האלה באמצעות סוכן תפעול (גרסה 2.0.0 ואילך) ובאמצעות סוכן Monitoring הקודם ב-Linux.
הסוכנים פועלים רק במכונות וירטואליות של Compute Engine, וההליכים האלה רלוונטיים רק לפלטפורמה הזו.
אי אפשר להשבית את האיסוף על ידי Ops Agent אם אתם מריצים גרסאות ישנות יותר מ-2.0.0 או את סוכן Monitoring הקודם ב-Windows. אם אתם רוצים להשבית את איסוף המדדים האלה ב-Windows, מומלץ לשדרג לגרסה 2.0.0 ומעלה של סוכן תפעול. מידע נוסף זמין במאמר התקנת סוכן תפעול.
התהליך הכללי נראה כך:
מתחברים למכונה הווירטואלית.
יוצרים עותק של קובץ התצורה הקיים כגיבוי. שומרים את עותק הגיבוי מחוץ לספריית ההגדרות האישיות של הסוכן, כדי שהסוכן לא ינסה לטעון את שני הקבצים. לדוגמה, הפקודה הבאה יוצרת עותק של קובץ התצורה של סוכן Monitoring ב-Linux:
cp /etc/stackdriver/collectd.conf BACKUP_DIR/collectd.conf.bak
כדי לשנות את ההגדרה, משתמשים באחת מהאפשרויות שמתוארות בקטעים הבאים:
מפעילים מחדש את הסוכן כדי להחיל את ההגדרות החדשות:
- סוכן Monitoring מדור קודם:
sudo service stackdriver-agent restart - סוכן תפעול:
sudo service google-cloud-ops-agent restart
- סוכן Monitoring מדור קודם:
מוודאים שהמדדים של התהליכים לא נאספים יותר מהמכונה הווירטואלית הזו:
-
במסוף Google Cloud , נכנסים לדף leaderboard Metrics explorer:
אם אתם משתמשים בשורת החיפוש כדי למצוא את הדף הזה, בחרו בתוצאה שכותרת המשנה שלה היא Monitoring.
בסרגל הכלים של החלונית query-builder, לוחצים על הלחצן code PromQL.
למשאב
gce_instance, מזינים את השאילתה הבאה ומחליפים את VM_NAME בשם של המכונה הווירטואלית:rate({"agent.googleapis.com/processes/cpu_time", monitored_resource="gce_instance", metadata_system_name="VM_NAME"}[1m])לוחצים על Run Query.
-
סוכן התפעול ב-Linux או ב-Windows
המיקום של קובץ התצורה של סוכן תפעול תלוי במערכת ההפעלה:
- ב-Linux:
/etc/google-cloud-ops-agent/config.yaml - ב-Windows:
C:\Program Files\Google\Cloud Operations\Ops
Agent\config\config.yaml
כדי להשבית את האיסוף של כל מדדי התהליכים על ידי סוכן תפעול, מוסיפים את הקטע הבא לקובץ config.yaml:
metrics:
  processors:
    metrics_filter:
      type: exclude_metrics
      metrics_pattern:
      - agent.googleapis.com/processes/*
ההגדרה הזו מחריגה את מדדי התהליכים מהאיסוף במעבד metrics_filter שחל על צינור עיבוד הנתונים שמוגדר כברירת מחדל בשירות metrics.
למידע נוסף על אפשרויות ההגדרה של סוכן תפעול, קראו את המאמר הגדרת סוכן תפעול.
סוכן Monitoring מדור קודם ב-Linux
כדי להשבית את איסוף המדדים של תהליכים באמצעות סוכן Monitoring הקודם, אתם יכולים:
בקטעים הבאים מתוארת כל אפשרות ומפורטים היתרונות והסיכונים שקשורים אליה.
שינוי קובץ התצורה של הסוכן
באפשרות הזו, עורכים ישירות את קובץ התצורה הראשי של הסוכן, /etc/stackdriver/collectd.conf, כדי להסיר את הקטעים שמאפשרים את איסוף מדדי התהליכים.
התהליך
יש שלוש קבוצות של מחיקות שצריך לבצע בקובץ collectd.conf:
מוחקים את ההוראה וההגדרות של הפלאגין
LoadPluginהבאות:LoadPlugin processes <Plugin "processes"> ProcessMatch "all" ".*" Detail "ps_cputime" Detail "ps_disk_octets" Detail "ps_rss" Detail "ps_vm" </Plugin>מוחקים את ההוראה
PostCacheChainהבאה ואת ההגדרה של השרשרתPostCache:PostCacheChain "PostCache" <Chain "PostCache"> <Rule "processes"> <Match "regex"> Plugin "^processes$" Type "^(ps_cputime|disk_octets|ps_rss|ps_vm)$" </Match> <Target "jump"> Chain "MaybeThrottleProcesses" </Target> Target "stop" </Rule> <Rule "otherwise"> <Match "throttle_metadata_keys"> OKToThrottle false HighWaterMark 5700000000 # 950M * 6 LowWaterMark 4800000000 # 800M * 6 </Match> <Target "write"> Plugin "write_gcm" </Target> </Rule> </Chain>מוחקים את השרשרת
MaybeThrottleProcessesשמשמשת את השרשרתPostCache:<Chain "MaybeThrottleProcesses"> <Rule "default"> <Match "throttle_metadata_keys"> OKToThrottle true TrackedMetadata "processes:pid" TrackedMetadata "processes:command" TrackedMetadata "processes:command_line" TrackedMetadata "processes:owner" </Match> <Target "write"> Plugin "write_gcm" </Target> </Rule> </Chain>
יתרונות וסיכונים
- יתרונות
- אתם מצמצמים את המשאבים שהסוכן צורך כי המדדים לא נאספים אף פעם.
- אם ביצעתם שינויים אחרים בקובץ
collectd.conf, יכול להיות שתוכלו לשמור אותם.
- סיכונים
- כדי לערוך את קובץ התצורה הזה, צריך להשתמש בחשבון
root. - אתם עלולים להכניס שגיאות הקלדה לקובץ.
- כדי לערוך את קובץ התצורה הזה, צריך להשתמש בחשבון
החלפת קובץ התצורה של הסוכן
באפשרות הזו, מחליפים את קובץ התצורה הראשי של הסוכן בגרסה שנערכה מראש, שבה הוסרו בשבילכם החלקים הרלוונטיים.
התהליך
מורידים את הקובץ שנערך מראש,
collectd-no-process-metrics.conf, מהמאגר של GitHub לספרייה/tmp:cd /tmp && curl -sSO https://raw.githubusercontent.com/Stackdriver/agent-packaging/master/collectd-no-process-metrics.confמחליפים את הקובץ הקיים
collectd.confבקובץ שנערך מראש:cp /tmp/collectd-no-process-metrics.conf /etc/stackdriver/collectd.conf
יתרונות וסיכונים
- יתרונות
- אתם מצמצמים את המשאבים שהסוכן צורך כי המדדים אף פעם לא נאספים.
- אתם לא צריכים לערוך את הקובץ באופן ידני בתור
root. - כלים לניהול הגדרות יכולים להחליף קובץ.
- סיכונים
- אם ביצעתם שינויים אחרים בקובץ
collectd.conf, תצטרכו למזג את השינויים האלה בקובץ החלופי.
- אם ביצעתם שינויים אחרים בקובץ
פתרון בעיות
ההליכים שמתוארים במאמר הזה הם שינויים בהגדרות של הסוכן, ולכן הבעיות הבאות הן הסבירות ביותר:
- אין לך הרשאות מספיקות כדי לערוך את קובצי התצורה. צריך לערוך את קובצי התצורה דרך חשבון
root. - אם עורכים את קובץ התצורה ישירות, עלולות להיווצר בו שגיאות הקלדה.
למידע על פתרון בעיות אחרות, ראו פתרון בעיות בסוכן Monitoring.
סוכן Monitoring מדור קודם ב-Windows
אי אפשר להשבית את איסוף המדדים של תהליכים על ידי סוכן Monitoring מדור קודם שפועל במכונות וירטואליות של Windows. אי אפשר להגדיר את הסוכן הזה. אם אתם רוצים להשבית את איסוף המדדים האלה ב-Windows, מומלץ לשדרג לגרסה 2.0.0 ומעלה של סוכן תפעול. מידע נוסף זמין במאמר התקנת סוכן תפעול.
אם אתם מריצים את סוכן תפעול, קראו את המאמר סוכן תפעול ב-Linux או ב-Windows.