


인프라 중단 또는 구성 오류를 방지하기 위해 전역 외부 애플리케이션 부하 분산기의 장애 조치 전략을 설계할 수 있습니다. 이러한 전략은 리전 외부 애플리케이션 부하 분산기를 사용하고 전역 인프라 중단 또는 구성 오류 중에 고가용성을 유지하기 위해 전역 외부 애플리케이션 부하 분산기에서 리전 외부 애플리케이션 부하 분산기로 트래픽을 라우팅합니다.
장애 조치 아키텍처에서는 기본 부하 분산기와 하나 이상의 백업 부하 분산기를 배포합니다.
- 기본 부하 분산기는 정상 작동 중에 클라이언트 트래픽을 처리하는 전역 외부 애플리케이션 부하 분산기입니다.
- 백업 부하 분산기는 기본 부하 분산기가 상태 점검에 실패할 때 트래픽을 수신하는 리전 외부 애플리케이션 부하 분산기입니다.
장애 조치 및 장애 복구는 자동 트래픽 라우팅 프로세스입니다.
- 장애 조치는 Cloud DNS가 서비스 중단을 감지하고 트래픽을 기본 부하 분산기에서 백업 부하 분산기로 라우팅할 때 발생합니다.
- 장애 복구는 Cloud DNS가 이 라우팅을 되돌려 상태 점검이 통과된 후 트래픽을 기본 부하 분산기로 리디렉션할 때 발생합니다.
이 문서에서는 전역 외부 애플리케이션 부하 분산기에서 리전 백업 부하 분산기로 장애 조치하는 방법을 설명합니다. 여러 리전의 리전 외부 애플리케이션 부하 분산기 간에 장애 조치를 구성하려면 리전 외부 애플리케이션 부하 분산기의 고가용성을 참고하세요.
장애 조치에 리전 부하 분산기를 사용하는 이유
리전 외부 애플리케이션 부하 분산기는 다음 속성으로 인해 글로벌 외부 애플리케이션 부하 분산기의 장애 조치 부하 분산기로 가장 적합합니다.
- 리전 외부 애플리케이션 부하 분산기는 개별Google Cloud 리전 내에 자체 포함되어 있으며 동일한 리전에서 실행되는 모든 전역 외부 애플리케이션 부하 분산기 인프라와도 격리됩니다.
- 리전 외부 애플리케이션 부하 분산기와 전역 외부 애플리케이션 부하 분산기는 모두 Envoy 프록시를 기반으로 하며 유사한 방식으로 트래픽을 처리합니다.
전역 외부 애플리케이션 부하 분산기의 전역에서 지역으로의 장애 조치를 구현하려면 트래픽을 장애 조치할 리전에 2개 이상의 리전 외부 애플리케이션 부하 분산기를 만드세요.
장애 조치 전략
다음 전략을 사용하여 전역 외부 애플리케이션 부하 분산기의 장애 조치를 구현할 수 있습니다.
- 활성-수동 (전역에서 리전으로 장애 조치): 백업 목적으로만 하나 이상의 리전 외부 애플리케이션 부하 분산기를 배포합니다. 정상 상태에서 Cloud DNS는 전역 외부 애플리케이션 부하 분산기의 IP 주소로 확인됩니다. 전역 부하 분산기가 실패하면 Cloud DNS가 트래픽을 백업 리전 부하 분산기로 라우팅합니다. 이 구성에서는 Cloud DNS 장애 조치 라우팅 정책을 사용합니다.
- 액티브-액티브 (전역에서 리전으로 우회): 전역 외부 애플리케이션 부하 분산기는 에지 캐싱과 같은 Cloud CDN 기능을 제공하는 에지 프런트엔드 역할을 하며, 정규화된 도메인 이름 (FQDN)이 있는 인터넷 네트워크 엔드포인트 그룹 (NEG)을 사용하여 리전 외부 애플리케이션 부하 분산기로 요청을 전달합니다. 정상 상태에서 트래픽은 두 부하 분산 계층을 순차적으로 통과합니다. 이는 Cloud DNS 위치정보 라우팅 정책을 사용하여 구성할 수 있습니다. 전역 부하 분산기에 서비스 중단이 발생하면 DNS 라우팅 정책이 전역 레이어를 우회하고 클라이언트 트래픽을 리전 부하 분산기로 직접 라우팅합니다.
아키텍처가 용량 인식 글로벌 백엔드 부하 분산에 의존하지 않는 경우 활성-활성 전략을 사용하는 것이 좋습니다. 하지만 애플리케이션에서 백엔드 용량에 따라 리전 간에 트래픽을 분산하고 유출하기 위해 전역 백엔드 부하 분산이 명시적으로 필요한 경우 액티브-패시브 전략을 구현하세요.
장애 조치 전략 비교
다음 표에서는 활성-수동 및 활성-활성 장애 조치 전략을 비교합니다.
| 전략 속성 | active-passive | active-active |
|---|---|---|
| 정상 상태 트래픽 흐름 | 클라이언트 → 전역 외부 애플리케이션 부하 분산기 → 백엔드 | 클라이언트 → 전역 외부 애플리케이션 부하 분산기 → 리전 외부 애플리케이션 부하 분산기 → 백엔드 |
| 실패 상태 트래픽 흐름 | 클라이언트 → 리전 외부 애플리케이션 부하 분산기 → 백엔드 서비스는 계속 사용할 수 있지만 에지 성능 이점이 손실되어 지연 시간이 길어질 수 있습니다. |
클라이언트 → 리전 외부 애플리케이션 부하 분산기 → 백엔드 (전역 외부 애플리케이션 부하 분산기 우회) 서비스는 계속 사용할 수 있지만 에지 성능 이점이 손실되어 지연 시간이 길어질 수 있습니다. |
| 구성 관리 | 전역 및 리전 부하 분산기 간에 독립적인 구성을 동기화해야 합니다. | 대부분의 애플리케이션 로직이 리전 부하 분산기에 있으므로 전역 레이어에는 최소한의 구성만 필요합니다. 하지만 두 계층 모두에서 에지 보안 정책 (Cloud Armor)과 연결 종료 구성 (TLS 인증서)을 복제해야 합니다. |
| 신뢰성 확인 | 리전 외부 애플리케이션 부하 분산기가 정상 상태에서 유휴 상태입니다. 주기적인 테스트 또는 DNS 트릭클 트래픽이 권장됩니다. | 정상 상태 트래픽은 리전 외부 애플리케이션 부하 분산기를 지속적으로 테스트합니다. 리전 부하 분산기로 직접 주기적인 테스트 또는 트리클 트래픽을 전송하는 것이 좋습니다. |
| 점진적 배포 안전성 | 전역 외부 애플리케이션 부하 분산기 구성 변경사항은 전역으로 적용됩니다. 리전 외부 애플리케이션 부하 분산기 변경사항은 격리되지만 정상 상태 트래픽은 이를 테스트하지 않습니다. | 리전별로 리전 외부 애플리케이션 부하 분산기 변경사항을 점진적으로 적용할 수 있습니다. 리전에 장애가 발생하면 전역 레이어가 자동으로 트래픽을 정상 리전으로 라우팅합니다. |
| 글로벌 백엔드 부하 분산 | 지원됨 전역 외부 애플리케이션 부하 분산기는 용량에 따라 여러 지역의 백엔드 간에 트래픽을 분산할 수 있습니다. |
제한적 이용 전역 외부 애플리케이션 부하 분산기는 트래픽을 가장 가까운 리전 외부 애플리케이션 부하 분산기로 라우팅합니다. 리전 부하 분산기는 로컬에서만 트래픽을 분산하며 백엔드 용량에 따라 리전 간에 트래픽을 분산하지 않습니다. |
| 비용 및 결제 | 데이터 처리 수수료는 단일 부하 분산 레이어에 적용됩니다. 정상 상태에서는 전역 외부 애플리케이션 부하 분산기에서 비용이 발생합니다. 리전 외부 애플리케이션 부하 분산기 요금은 테스트 또는 장애 조치 이벤트 중에만 적용됩니다. | 트래픽이 정상 상태에서 전역 및 리전 계층을 모두 통과하므로 두 부하 분산 계층 모두 데이터 처리 비용을 동시에 생성합니다. |
| 권장 사용 사례 | 고급 전역 백엔드 부하 분산과 리전 간 용량 기반 트래픽 스필링이 필요한 워크로드 | 에지 성능 및 캐싱을 위해 전역 레이어를 사용하는 리전 격리를 중심으로 설계된 워크로드 |
활성-수동 전략
활성-수동 구성에서는 기본 전역 외부 애플리케이션 부하 분산기 또는 기본 애플리케이션 부하 분산기와 함께 하나 이상의 리전에 독립적인 리전 외부 애플리케이션 부하 분산기를 배포합니다.
활성-수동 장애 조치 작동 방식
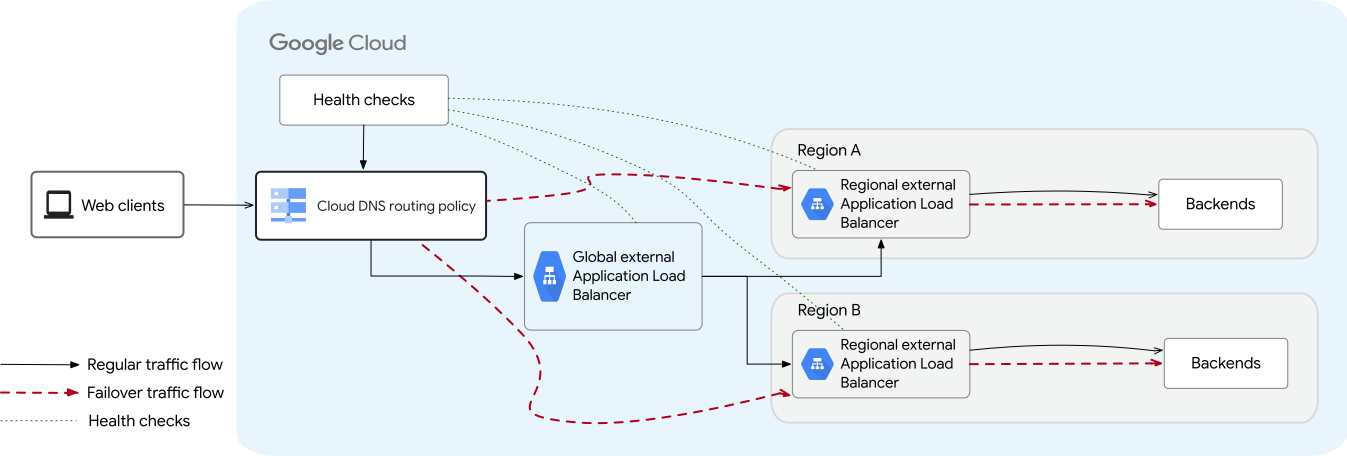
다음 설정은 전역 외부 애플리케이션 부하 분산기에서 전역 부하 분산기가 백엔드를 배포한 각 리전에 하나씩 있는 백업 리전 외부 애플리케이션 부하 분산기 2개로의 장애 조치를 보여줍니다.

활성-수동 장애 조치는 다음 워크플로를 따릅니다.
- 정상 상태: Cloud DNS가 모든 클라이언트 트래픽을 전역 외부 애플리케이션 부하 분산기로 라우팅합니다.
- 장애 감지: Google Cloud 는 세 개의 소스 리전으로 구성된 상태 점검을 사용하여 기본 부하 분산기가 정상인지 감지합니다. 두 개 이상의 소스 리전에서 시작된 상태 점검이 실패하면 Cloud DNS가 장애 조치를 트리거합니다.
- 장애 조치: Cloud DNS 장애 조치 라우팅 정책은 클라이언트 트래픽을 백업 리전 외부 애플리케이션 부하 분산기로 직접 라우팅합니다. 장애 조치 중 지연 시간 영향: 리전 외부 애플리케이션 부하 분산기는 특정 Google Cloud 리전 내에서 연결을 종료하므로 대상 리전에서 멀리 떨어진 클라이언트의 경우 장애 조치가 활성 상태일 때 지연 시간과 왕복 시간 (RTT)이 증가할 수 있습니다.
- 장애 복구: 상태 점검이 다시 성공하면 Cloud DNS는 두 부하 분산기가 모두 트래픽을 처리하므로 다운타임 없이 트래픽을 기본 부하 분산기로 자동 복원합니다.
활성-활성 전략 (글로벌에서 리전으로 우회)
액티브-액티브 전략에서 전역 외부 애플리케이션 부하 분산기는 인터넷 FQDN NEG (INTERNET_FQDN_PORT)를 사용하여 2개 이상의 리전에 있는 리전 외부 애플리케이션 부하 분산기로 트래픽을 전송합니다.
활성-활성 바이패스 작동 방식
다음 설정은 전역 외부 애플리케이션 부하 분산기에서 전역 부하 분산기가 백엔드를 배포한 각 리전에 하나씩 있는 백업 리전 외부 애플리케이션 부하 분산기 2개로의 장애 조치를 보여줍니다.
활성-활성 장애 조치는 다음 워크플로를 따릅니다.
- 정상 상태: 트래픽이 클라이언트에서 전역 외부 애플리케이션 부하 분산기로 흐릅니다.
전역 부하 분산기는
INTERNET_FQDN_PORT유형의 인터넷 FQDN 네트워크 엔드포인트 그룹 (NEG)을 사용하여 트래픽을 가장 가까운 리전 외부 애플리케이션 부하 분산기로 전달합니다. 그런 다음 리전 부하 분산기가 로컬 백엔드로 트래픽을 전달합니다. - 장애 감지: 정상 상태에서 단일 리전 외부 애플리케이션 부하 분산기 또는 해당 리전이 실패하면 전역 외부 애플리케이션 부하 분산기는 인터넷 NEG에서 Cloud DNS 상태 점검 정책을 사용하여 장애를 감지합니다. 전역 부하 분산기는 비정상 리전에서 정상 리전 부하 분산기로 트래픽을 자동으로 라우팅합니다.
- 우회: 전역 외부 애플리케이션 부하 분산기에 장애가 발생하면 Cloud DNS 장애 조치 정책이 장애를 감지하고 트래픽을 리전 외부 애플리케이션 부하 분산기로 직접 라우팅하여 전역 레이어를 완전히 우회합니다. 우회 시 지연 시간 영향: 전역 외부 애플리케이션 부하 분산기는 사용자와 더 가까운 연결 종료 및 에지 캐싱과 같은 에지 성능 이점을 제공합니다. 트래픽이 전역 부하 분산기를 우회하면 클라이언트 연결이 리전 VIP와 직접 설정되어 지리적으로 먼 클라이언트의 연결 지연 시간과 RTT가 증가할 수 있습니다.
- 장애 복구: 전역 부하 분산기가 연속으로 상태 점검을 통과하면 Cloud DNS는 DNS 응답에서 전역 Anycast VIP 반환을 자동으로 재개하여 전역 에지 라우팅 계층을 복원합니다.
기본 부하 분산기 구성 검토
장애 조치를 구성하기 전에 백업 리전 외부 애플리케이션 부하 분산기가 기본 부하 분산기에서 사용하는 기능을 지원하는지 확인합니다.
- 활성-수동 모드에서는 정전 시 트래픽을 원활하게 인계할 수 있도록 백업 리전 부하 분산기가 유사한 기능을 지원해야 합니다.
- 활성-활성 모드에서는 핵심 라우팅 및 보안 규칙을 리전 계층에서 직접 구성해야 하며, 전역 중단 시에는 Cloud CDN과 같은 전역 에지 기능이 우회됩니다.
| 기능 | 호환성 요구사항 |
|---|---|
| Google Kubernetes Engine 배포 | GKE Gateway를 사용하여 기본 부하 분산기와 백업 부하 분산기를 모두 배포합니다. 이는 GKE 게이트웨이를 사용하여 배포된 부하 분산기가 GKE 인그레스 컨트롤러를 사용하여 배포된 부하 분산기보다 이 장애 조치 메커니즘과 더 호환되기 때문입니다. GKE 인그레스 컨트롤러는 기본 애플리케이션 부하 분산기만 지원합니다. |
| Cloud CDN | 리전 외부 애플리케이션 부하 분산기는 Cloud CDN을 지원하지 않습니다. 장애 조치가 발생하면 Cloud CDN을 사용하는 작업이 영향을 받습니다. |
| Cloud Armor | 기본 부하 분산기에서 Cloud Armor를 사용하는 경우 백업 부하 분산기에서 이에 상응하는 리전 Cloud Armor 보안 정책을 구성합니다. Cloud Armor에는 리전 범위와 전역 범위에서 각각 사용할 수 있는 다른 기능이 있습니다. 자세한 내용은 리전 Cloud Armor 보안 정책 및 전역 Cloud Armor 보안 정책을 참고하세요. |
| SSL 인증서 | 기본 부하 분산기에서 사용하는 SSL 인증서 유형이 백업 리전 외부 애플리케이션 부하 분산기와 호환되는지 확인합니다. 전역, 리전, 기존 부하 분산기에서 사용할 수 있는 SSL 인증서의 차이점을 검토하세요. 자세한 내용은 Compute Engine SSL 인증서 및 인증서 관리자 SSL 인증서를 참고하세요. |
리전 부하 분산기 고려사항
장애 발생 시 트래픽을 리디렉션할 리전에 리전 외부 애플리케이션 부하 분산기를 구성하고 배포합니다.
지역 부하 분산기를 구성할 때는 장애 조치 또는 우회 아키텍처에 대한 다음 고려사항에 유의하세요.
두 배포에서 트래픽이 유사하게 처리되도록 백업 리전 외부 애플리케이션 부하 분산기의 기능을 기본 부하 분산기와 최대한 유사하게 구성해야 합니다.
전역 외부 애플리케이션 부하 분산기. 리전 외부 애플리케이션 부하 분산기는 전역 외부 애플리케이션 부하 분산기와 대부분 동일한 기능을 지원하지만 몇 가지 예외가 있습니다. 또한 리전 부하 분산기는 전역 부하 분산기와 동일한 고급 트래픽 관리 기능을 지원하므로 기본 부하 분산기와 백업 부하 분산기 간의 등가성을 더 쉽게 달성할 수 있습니다.
기존 애플리케이션 부하 분산기. 기존 애플리케이션 부하 분산기를 사용하면 기본 부하 분산기와 백업 부하 분산기 간의 기능 동등성을 달성하기가 더 어렵습니다. 리전 외부 애플리케이션 부하 분산기는 트래픽을 다르게 처리하는 Envoy 기반 부하 분산기이기 때문입니다. 프로덕션에 배포하기 전에 장애 조치 및 장애 복구를 철저히 테스트해야 합니다.
리전, 전역, 기본 애플리케이션 부하 분산기의 구체적인 기능을 확인하려면 부하 분산기 기능 비교 페이지를 참고하세요.
Terraform과 같은 자동화 프레임워크를 사용하여 기본 배포와 백업 배포에서 모두 부하 분산기 구성의 일관성을 달성하고 유지하는 것이 좋습니다.
리전 외부 애플리케이션 부하 분산기는 프리미엄 및 표준 네트워크 서비스 등급을 모두 지원합니다. 장애 조치 중에 지연 시간이 주요 문제가 아닌 경우 표준 등급을 사용하여 백업 리전 외부 애플리케이션 부하 분산기를 설정하는 것이 좋습니다. 표준 등급 인프라를 사용하면 전역 외부 애플리케이션 부하 분산기에서 사용하는 프리미엄 등급 인프라와 추가로 격리됩니다.
프록시 전용 서브넷의 크기가 장애 조치 이벤트 중에 트래픽이 증가해도 동일한 리전 및 네트워크의 다른 리전 부하 분산기를 중단하지 않을 만큼 충분한지 확인합니다. 자세한 내용은 프록시 전용 서브넷 용량 추가 예약을 참조하세요.
리전 외부 애플리케이션 부하 분산기를 구성하는 방법은 VM 인스턴스 그룹 백엔드가 있는 리전 외부 애플리케이션 부하 분산기 설정을 참고하세요.
프록시 전용 서브넷 용량 추가 예약
리전 및 VPC 네트워크의 모든 리전 Envoy 기반 부하 분산기는 동일한 Envoy 프록시 풀을 공유합니다. 장애 조치 이벤트 시 백업 리전 외부 애플리케이션 부하 분산기에서 기본 부하 분산기의 장애 조치 트래픽을 처리하기 위해 프록시 사용량이 증가합니다. 충분한 프록시 용량을 예약하면 장애 조치 이벤트로 인해 동일한 리전 및 네트워크의 다른 리전 Envoy 기반 부하 분산기가 중단되지 않습니다.
백업 부하 분산기에서 항상 용량을 사용할 수 있도록 프록시 전용 서브넷의 크기를 검토하세요. 특정 리전의 트래픽을 처리하는 데 필요한 예상 프록시 수를 계산하고 필요한 경우 용량을 늘리는 것이 좋습니다. 프록시 용량 한도 및 크기 조정 계산에 대한 자세한 내용은 'Cloud Load Balancing 가격 책정'의 프록시 인스턴스 요금 섹션을 참고하세요.
DNS 정책을 사용하여 다양한 리전의 여러 백업 부하 분산기 간에 트래픽을 분할하는 경우 리전 및 네트워크별 프록시 요구사항을 추정할 때 이를 고려해야 합니다. 프록시 전용 서브넷이 클수록Google Cloud 에서 필요에 따라 더 많은 수의 Envoy 프록시를 부하 분산기에 할당할 수 있습니다.
기본 IP 주소 범위에 하는 것과 동일한 방법으로 (expand-ip-range 명령어 사용) 프록시 전용 서브넷을 확장할 수 없습니다. 대신 요구사항을 충족하는 백업 프록시 전용 서브넷을 만든 후 활성 역할로 승격해야 합니다.
프록시 전용 서브넷의 크기를 변경하는 방법을 알아보려면 프록시 전용 서브넷의 크기 또는 IP 주소 범위 변경을 참고하세요.
기본 부하 분산기와 백업 부하 분산기 간에 백엔드 공유
완전한 인프라 중복성을 달성하려면 부하 분산기 수준과 백엔드 수준 모두에서 중복을 도입해야 합니다. 즉, 기본 부하 분산기와 중복되지 않는 백엔드(인스턴스 그룹 또는 네트워크 엔드포인트 그룹)를 사용하여 백업 리전 외부 애플리케이션 부하 분산기를 구성해야 합니다.
기본 부하 분산기와 백업 부하 분산기에 동일한 백엔드를 사용하려면 해당 백엔드가 있는 리전에 각 백업 리전 외부 애플리케이션 부하 분산기를 만들어야 합니다. 또한 인스턴스 그룹에 자동 확장이 사용 설정된 경우 적절한 장애 조치가 발생하도록 하려면 다음 요구사항을 충족해야 합니다.
- CPU 기반 확장만으로 자동 확장 처리기를 구성합니다. 부하 분산기 사용률에 기반한 자동 확장은 지원되지 않습니다.
- 전역 및 리전 백엔드 서비스 모두
UTILIZATION분산 모드만 사용해야 합니다. 장애 조치 과정에서 인스턴스가 전역 및 리전 부하 분산기 모두에서 트래픽을 2배로 수신할 수 있으므로RATE분산 모드를 사용하지 마세요. - 트래픽이 전역 부하 분산기에서 리전 부하 분산기로 전환되는 다운타임 중에 자동 확장 처리가 그룹을 조기 축소하지 않도록 수평 축소 설정을 구성합니다. 이 다운타임은 DNS TTL (수명)과 구성된 상태 점검 간격의 합계만큼 길어질 수 있습니다.
자동 확장을 올바르게 설정하지 않으면 장애 조치 중에 보조 서비스 중단이 발생할 수 있습니다. 전역 부하 분산기의 트래픽 손실로 인해 리전 부하 분산기가 인계되기 전에 인스턴스 그룹이 급격히 축소되기 때문입니다.
활성-수동 장애 조치 구성
액티브-패시브 장애 조치를 구성하려면 다음 단계를 따르세요.
- 아키텍처 고려사항 검토: 리소스를 만들기 전에 리전 부하 분산기 고려사항을 검토하여 기능 호환성, 프록시 용량, 공유 백엔드 자동 확장 요구사항을 확인하세요.
- 기본 부하 분산기 구성: 하나 이상의 리전에 분산된 백엔드 서비스로 전역 외부 애플리케이션 부하 분산기를 설정합니다. 전역 외부 애플리케이션 부하 분산기를 구성하는 방법에 대한 자세한 내용은 전역 외부 애플리케이션 부하 분산기 설정을 참고하세요.
- 기본 부하 분산기 구성 검토: 기본 부하 분산기에서 사용하는 기능 (예: 보안 기능, 트래픽 관리 및 라우팅 기능, Cloud CDN)을 백업 리전 외부 애플리케이션 부하 분산기에서 사용할 수 있는지 확인합니다. 유사한 기능을 사용할 수 없는 경우 이 부하 분산기는 장애 조치에 적합하지 않을 수 있습니다.
- 백업 리전 외부 애플리케이션 부하 분산기 구성: 트래픽을 장애 조치할 리전에 독립적인 리전 외부 애플리케이션 부하 분산기를 설정합니다. 리전 외부 애플리케이션 부하 분산기를 구성하는 방법은 VM 인스턴스 그룹 백엔드가 있는 리전 외부 애플리케이션 부하 분산기 설정을 참고하세요.
- DNS 라우팅 및 상태 점검 구성: 기본 부하 분산기의 상태 점검을 만들고 Cloud DNS 장애 조치 라우팅 정책을 구성하여 서비스 중단을 감지하고 클라이언트 트래픽을 백업 리전 부하 분산기로 라우팅합니다.
활성-활성 우회 구성
액티브-액티브 아키텍처를 구성하려면 다음 단계를 따르세요.
아키텍처 고려사항 검토: 리소스를 만들기 전에 리전 부하 분산기 고려사항을 검토하여 기능 호환성을 확인하고 프록시 전용 서브넷 용량이 정상 상태 및 장애 조치 트래픽을 처리할 수 있는지 확인합니다.
리전 외부 애플리케이션 부하 분산기 구성: 리전 부하 분산기를 구성하기 전에 기능 호환성 및 제한사항을 검토하세요. 백엔드 서비스, 외부 IP 주소, SSL 인증서, 리전 Cloud Armor 보안 정책을 사용하여 2개 이상의 리전에 리전 외부 애플리케이션 부하 분산기를 배포합니다. 설정 안내는 VM 인스턴스 그룹 백엔드가 있는 리전 외부 애플리케이션 부하 분산기 설정을 참고하세요.
리전 부하 분산기의 DNS 구성: 위치정보 또는 지연 시간 라우팅 정책을 사용하여 리전 외부 애플리케이션 부하 분산기의 외부 IP 주소를 가리키는 DNS 레코드 (예:
regional-api.example.com)를 만듭니다. 이 레코드에서 DNS 상태 점검을 사용 설정하여 특정 리전의 장애를 감지하고 트래픽을 해당 리전에서 다른 정상 리전으로 자동으로 라우팅합니다.전역 외부 애플리케이션 부하 분산기 구성: 전역 외부 IP 주소를 예약하고
INTERNET_FQDN_PORT유형의 전역 인터넷 네트워크 엔드포인트 그룹 (NEG)을 만듭니다. 지역 DNS 레코드 FQDN(예:regional-api.example.com)을 가리키는 엔드포인트를 인터넷 NEG에 추가합니다. 전역 외부 애플리케이션 부하 분산기의 백엔드 서비스를 구성하고, 인터넷 NEG를 연결하고, 필요한 경우 Cloud CDN 또는 Cloud Armor를 사용 설정합니다. URL 맵, 대상 HTTP(S) 프록시, 전역 전달 규칙을 구성합니다.장애 조치 및 상태 점검을 위한 DNS 구성:
FAILOVER라우팅 정책을 사용하여 기본 서비스 DNS 레코드 (예:api.example.com)를 만듭니다. 레코드 세트에는 전역 외부 애플리케이션 부하 분산기의 IP 주소를 가리키는 기본 엔드포인트와 리전 외부 애플리케이션 부하 분산기의 외부 IP 주소를 가리키는 백업 엔드포인트가 있어야 합니다. DNS 상태 점검을 구성하여 전역 외부 애플리케이션 부하 분산기를 모니터링합니다.
권장사항
Cloud DNS 레코드 및 상태 점검을 구성할 때 다음 권장사항에 유의하세요.
서비스 중단 기간 계산: 트래픽이 기본 부하 분산기에서 백업 부하 분산기로 장애 조치되는 데 걸리는 시간은 DNS TTL, 상태 점검 간격, 상태 점검의 비정상 기준점 파라미터에 따라 다릅니다.
Google의 Cloud DNS를 사용하는 경우 다음 수식을 사용하여 이 기간의 상한값을 계산할 수 있습니다.
Duration of outage = DNS TTL + Health Check Interval * Unhealthy ThresholdDNS TTL을 30~60초로 설정합니다. TTL 값이 높을수록 장애 조치 시간이 길어집니다. DNS가 백업 리전 외부 애플리케이션 부하 분산기로 장애 조치한 후에도 인터넷의 클라이언트가 계속해서 기본 외부 애플리케이션 부하 분산기에 액세스하기 때문입니다.
상태 점검 기준 구성: 일시적인 네트워크 오류로 인한 장애 조치를 방지하도록 정상 및 비정상 기준 매개변수를 설정합니다. 기준점이 높을수록 트래픽이 백업 부하 분산기로 장애 조치하는 데 필요한 시간이 늘어납니다.
검증을 위해 트릭클 트래픽 사용: 기본 부하 분산기가 정상 상태일 때도 항상 백업 부하 분산기로 적은 비율의 트래픽을 전송하도록
--backup-data-trickle-ratio플래그를 구성합니다. 이렇게 하면 백업 인프라가 활성 상태이고 트래픽을 처리할 준비가 됩니다. 백업 부하 분산기로 전송되는 트래픽 비율을 0에서 1 사이의 비율로 구성할 수 있습니다. Cloud DNS를 사용하면 백업 VIP 주소로 트래픽의 100%를 전송하여 장애 조치를 수동으로 트리거할 수 있지만 일반적인 값은 0.1입니다.주기적으로 장애 조치 및 장애 복구 테스트: 재해 복구 계획에 장애 조치 테스트를 포함합니다. 기본 부하 분산기에서 백업 부하 분산기로의 트래픽의 점진적 이동과 갑작스러운 이동을 모두 확인하고 장애 복구 후 트래픽이 기본 부하 분산기로 원활하게 돌아가는지 확인합니다.