

Visão geral
Esta Arquitetura de referência de solução (SRA) define o design conceitual, a topologia de componentes e os limites técnicos para hospedagem, disponibilização e validação de modelos de linguagem grandes (LLMs) de peso aberto em clusters autônomos somente de software do Distributed Cloud.
Os ambientes de borda corporativos geralmente exigem inferência de baixa latência e soberania de dados estrita. Esta arquitetura de referência de solução oferece uma pilha de disponibilização padronizada, segura e observável para implantar o modelo Gemma 4 31B em um cluster de nó único do Google Distributed Cloud somente de software equipado com uma GPU NVIDIA RTX PRO 6000 (96 GB de VRAM) fornecida pelo cliente.
Recursos e funcionalidades
- Serviço de modelos locais:expõe uma API padrão do setor compatível com a OpenAI localmente dentro do limite do cluster somente de software do Distributed Cloud.
- Suporte para modelos grandes de borda:otimizado para executar o Gemma 4 31B em precisão nativa (BF16) ou formatos quantizados, utilizando totalmente a capacidade de 96 GB de VRAM.
- Observabilidade:integra-se à infraestrutura de monitoramento do software Distributed Cloud only
(Google Cloud Managed Service para Prometheus) usando recursos nativos do
PodMonitoringpara exportar telemetria de GPU e métricas de desempenho de vLLM, evitando a necessidade de um servidor Prometheus local independente. - Validação interativa:implanta uma interface da Web baseada no Gradio para verificação visual imediata da capacidade de resposta do modelo.
Princípios de arquitetura
- Simplicidade e portabilidade:padroniza construções nativas do Kubernetes (implantação, serviço) em vez de operadores de serviço complexos, garantindo facilidade de implantação e manutenção em configurações de nó único.
- Soberania de dados:todo o tráfego de inferência e os dados de comandos e respostas permanecem estritamente dentro do limite do cluster local.
- Isolamento de recursos:dedica o acelerador de GPU física a uma única instância de disponibilização do modelo para evitar disputas de recursos e garantir uma latência previsível.
Arquitetura e design
Componentes
Os componentes da solução consistem em:
- Namespace do cliente (somente cluster de software do Distributed Cloud):
- Mecanismo de disponibilização do vLLM:implantado como uma implantação do Kubernetes que executa o contêiner do vLLM. Configurado para carregar pesos do Gemma do armazenamento permanente e expor uma API compatível com a OpenAI.
- Interface da Web do Gradio:implantada como uma implantação do Kubernetes, fornecendo a interface de chat para verificação. Opcional: também pode ser executada externamente em uma estação de trabalho de desenvolvedor ou em um ambiente de execução de teste conectado ao serviço vLLM do cluster.
- Reivindicação de volume permanente (PVC): com suporte apenas do armazenamento compartilhado local do software Distributed Cloud
(usando a StorageClass
local-shared) para hospedar os pesos do modelo. - Serviços do Kubernetes:serviço ClusterIP para endpoint de API vLLM; serviço NodePort ou LoadBalancer para expor a interface do Gradio à rede do cliente.
- Infraestrutura (gerenciada pelo cliente):
- Operador de GPU NVIDIA:orquestra e expõe os recursos físicos da GPU para o software Distributed Cloud apenas em nós de trabalho do Kubernetes.
- GPU NVIDIA RTX PRO 6000:o acelerador físico subjacente (arquitetura de memória GDDR7 de 96 GB).
- Integração com o Google Cloud:
- Google Cloud Monitoring e Logging:os agentes padrão do software Distributed Cloud coletam e encaminham registros do sistema, registros de contêineres e métricas básicas paraGoogle Cloud.
Visão geral da arquitetura de alto nível
O diagrama a seguir ilustra o fluxo de solicitações e as interações de componentes no cluster somente software do Distributed Cloud:
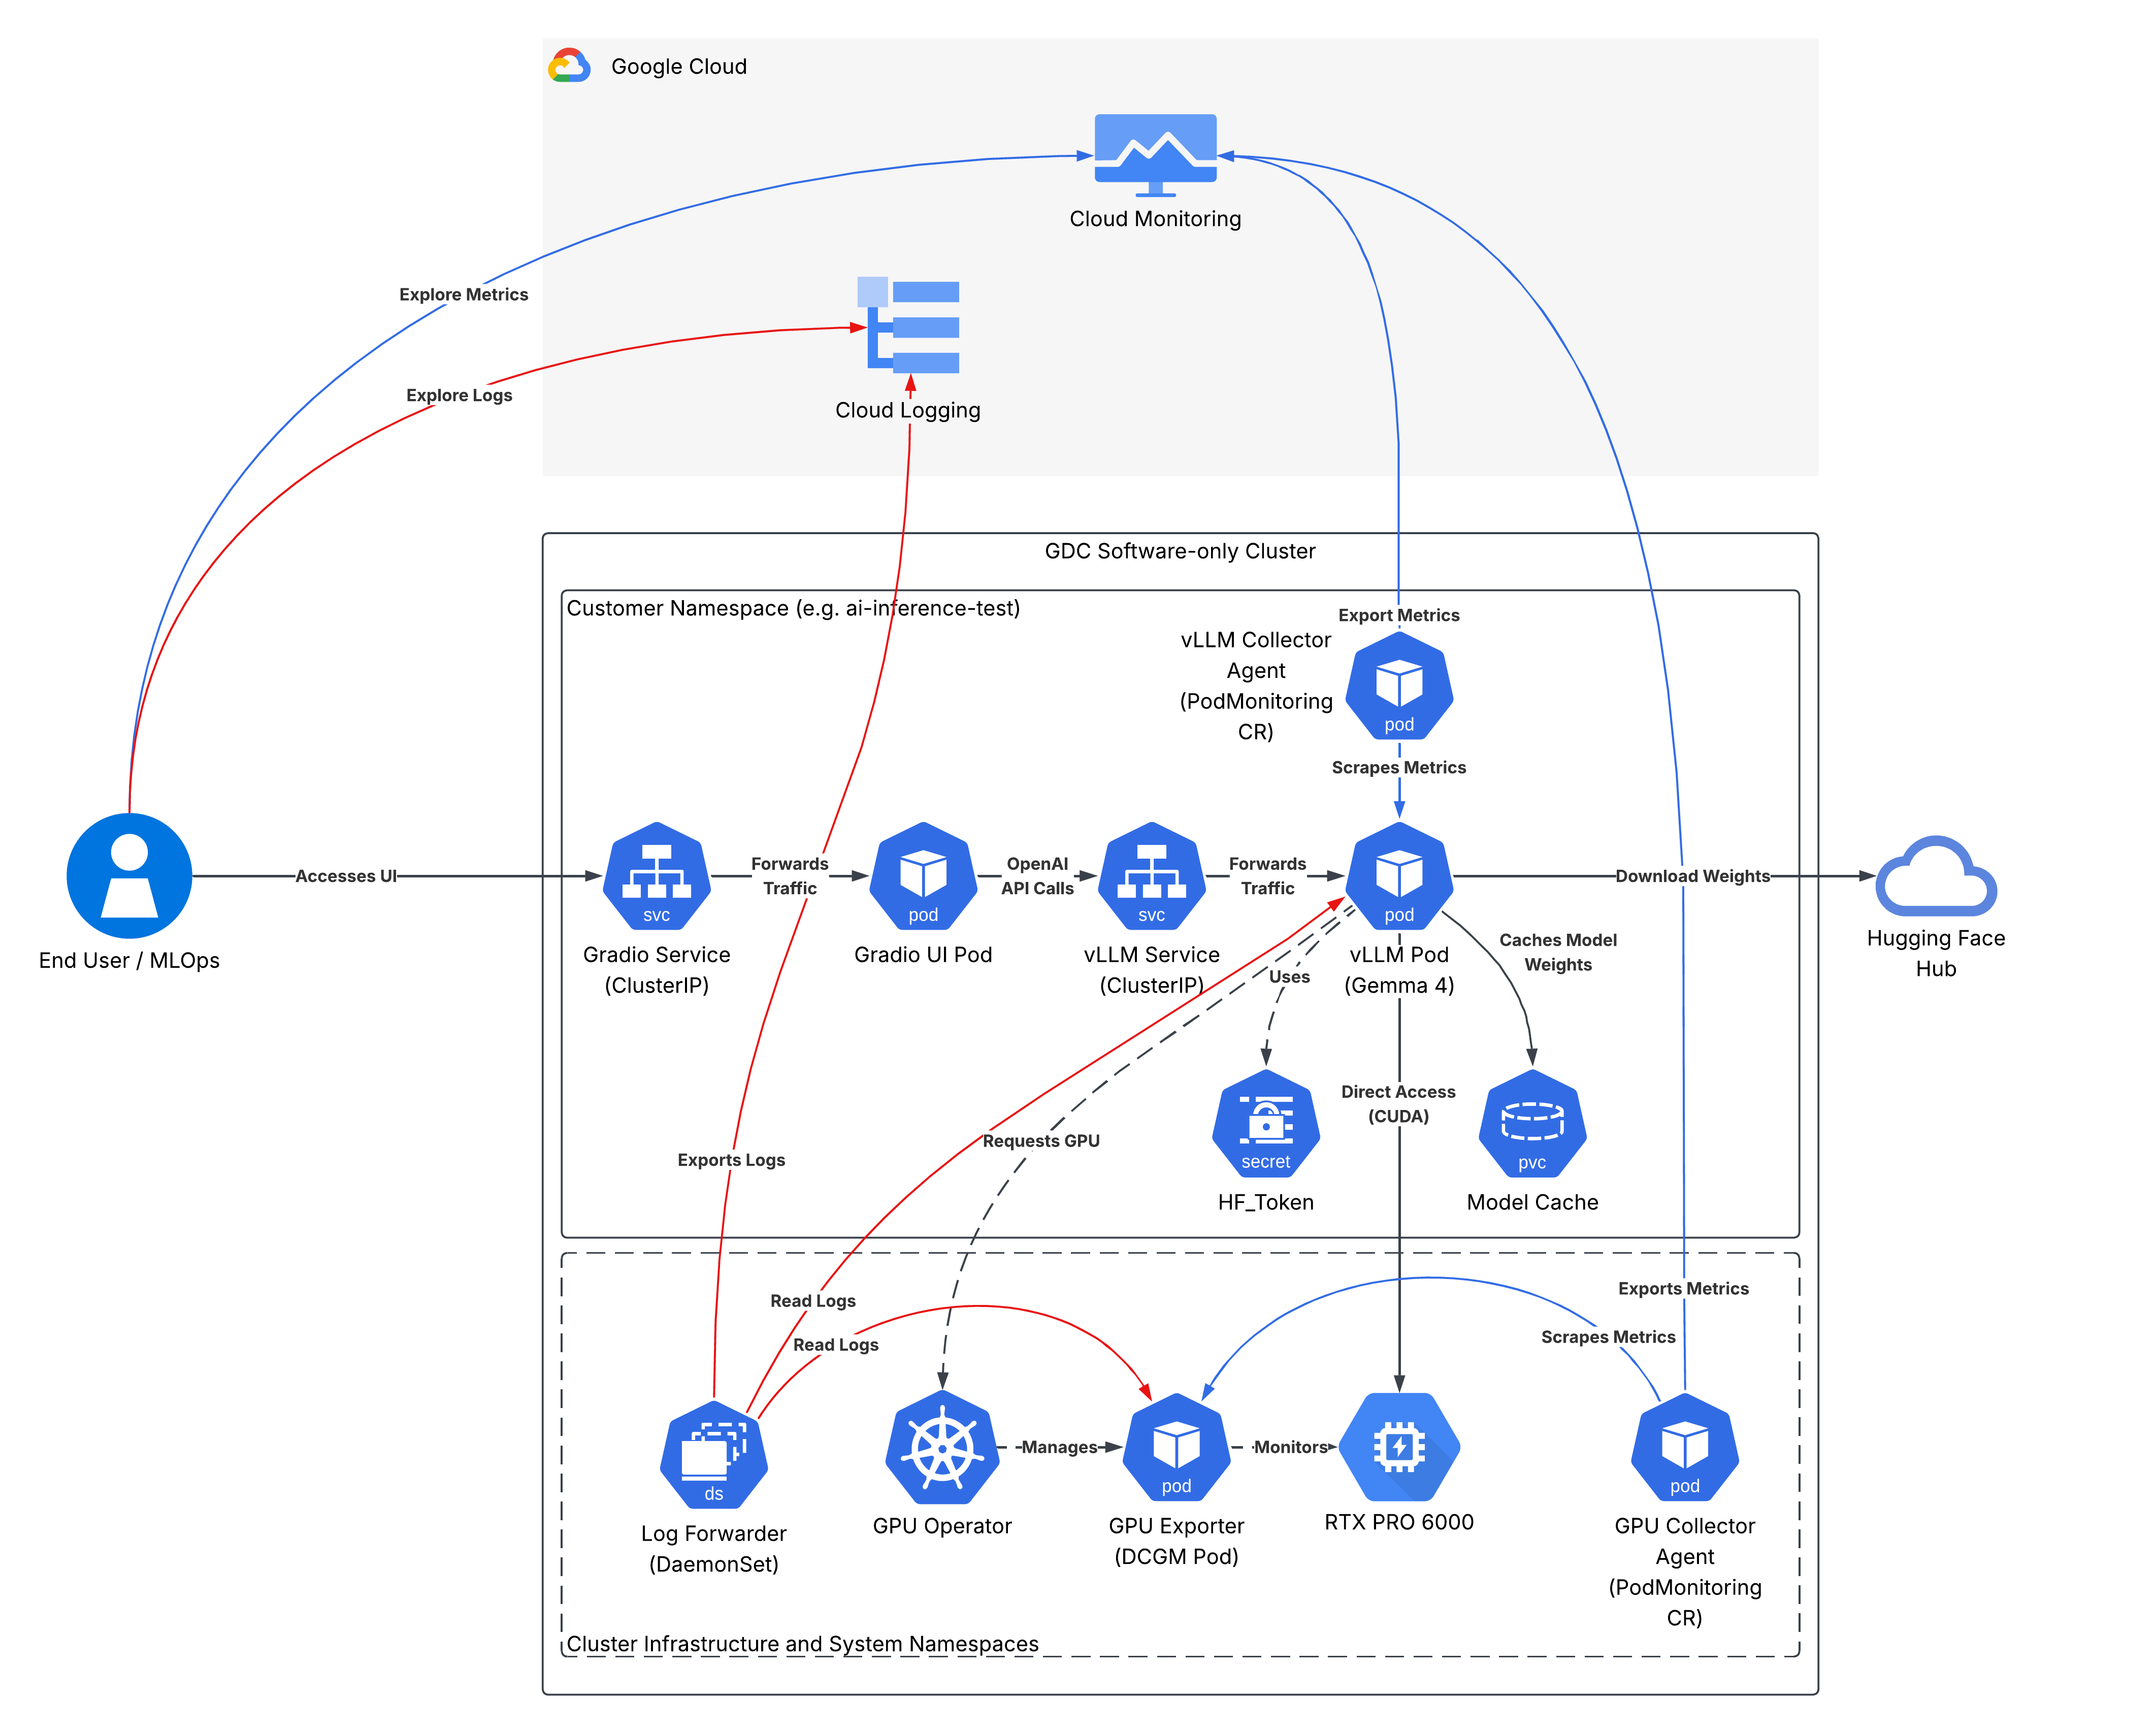
Restrições de hardware
A solução foi projetada para hardware fornecido pelo cliente equipado com a GPU NVIDIA RTX PRO 6000 Blackwell.
- Especificação da GPU:NVIDIA RTX PRO 6000 (Blackwell Server ou Workstation Edition).
- Arquitetura de memória:96 GB de VRAM GDDR7 (com ECC)
- Impacto da seleção de modelos:
- Os 96 GB de VRAM permitem executar o modelo Gemma 4 31B de destino na precisão BF16 nativa, ocupando aproximadamente 62 GB de pesos e deixando aproximadamente 34 GB de espaço livre de VRAM para o cache de chave-valor (KV).
- Quando a quantização FP8 acelerada por hardware Blackwell
(
--quantization=fp8) está ativada, conforme configurado na implementação de referência, a memória de peso do modelo é reduzida pela metade para ~31 GB, expandindo o cache KV disponível para ~56,5 GiB (tokens61,728) em--gpu-memory-utilization=0.95e permitindo grandes janelas de contexto ou tamanhos de lote simultâneos altos sem encontrar erros de falta de memória (OOM).
Matriz de capacidade de suporte (responsabilidades)
| Componente | Gerenciado por | Observações |
|---|---|---|
| Hardware físico e SO | Cliente | Hardware fornecido pelo cliente (especificamente servidor ou estação de trabalho com GPU NVIDIA RTX PRO 6000 Blackwell). |
| Instalação do cluster somente software do Distributed Cloud | Cliente | É necessário seguir a documentação padrão de instalação somente de software do Distributed Cloud. |
| Drivers e operador de GPU | Cliente | Instalação do operador de GPU NVIDIA e dos gráficos do Helm. O Google não oferece suporte à implantação do operador da NVIDIA. |
| Manifestos de disponibilização do vLLM | Google (solução) | Fornecido como parte deste guia de solução. |
| Artefatos do modelo | Cliente | Baixar e hospedar os pesos do modelo Gemma. |
| Interface do Gradio e código do app | Cliente | Camada de aplicativo de propriedade do cliente para validação e uso. |
| Cloud Logging e Cloud Monitoring | Articulação | O Google oferece integração padrão, e o cliente configura. |
Conceitos e tecnologias
Esta seção detalha os componentes funcionais, as responsabilidades deles e como eles se comunicam no sistema. Ele identifica os serviços principais, unidades de armazenamento de dados e interfaces de rede necessárias para oferecer suporte ao caso de uso de destino.
Infraestrutura e plataforma
- GPU NVIDIA RTX PRO 6000:oferece 96 GB de VRAM GDDR7. A GPU física é dedicada totalmente à instância de disponibilização do modelo. O particionamento de GPU (MIG) não está ativado para garantir que o modelo tenha acesso exclusivo à VRAM completa e à largura de banda da memória, evitando a disputa de recursos.
- Operador de GPU NVIDIA:operador gerenciado pelo cliente que orquestra e expõe os recursos físicos de GPU apenas para nós de trabalho do Kubernetes do software Distributed Cloud.
- Armazenamento local do nó (reivindicação de volume permanente): com suporte apenas do software Distributed Cloud, o armazenamento local do nó hospeda e mantém os pesos do modelo no nó. Isso garante que, depois de baixados, os pesos do modelo sejam mantidos localmente. Reinicializações ou atualizações subsequentes de pods carregam pesos desse cache local, reduzindo o tempo de inicialização e protegendo contra interrupções da WAN.
- Segmento de memória compartilhada (
/dev/shm): um volumeemptyDircommedium: Memoryé montado em/dev/shme alocado com 16 GiB para evitar falhas de segmentação durante operações de tensor de alta simultaneidade no vLLM.
Serviços e lógica
- Mecanismo de veiculação do vLLM:implantado como uma implantação do Kubernetes que executa o contêiner do vLLM qualificado para a Vertex AI, exposto por um serviço
ClusterIP(porta 8000). Os principais parâmetros de configuração incluem:--model: caminho ou ID do modelo da Gemma (por exemplo,google/gemma-4-31B-it).--tensor-parallel-size: definido como1(restrição de GPU única).--dtype: defina comobfloat16para aproveitar a precisão nativa do hardware em camadas e ativações não quantizadas.--quantization: definido comofp8na implementação de referência para aproveitar a quantização de peso FP8 do Blackwell (~31 GB de pesos, ~56,5 GiB de cache KV) ou omitido se o BF16 não quantizado (~62 GB de pesos, ~34 GB de cache KV) for preferido.
- Interface da Web do Gradio:implantada como uma implantação do Kubernetes que fornece uma interface de chat para validação, exposta por um serviço
ClusterIP(porta 8080). Ele se conecta ao serviço vLLM para interação de comando e resposta.
Observabilidade e integração Google Cloud
- Cloud Logging:usa apenas agentes de geração de registros padrão do software Distributed Cloud para capturar e encaminhar automaticamente registros de contêineres (registros de aplicativos vLLM e diagnósticos de GPU) para o Cloud Logging.
- Cloud Monitoring (PodMonitoring): os recursos do Google Cloud Managed Service para Prometheus (GMP) têm como destino o pod vLLM (para disponibilização de telemetria, como capacidade de processamento de tokens e uso de cache KV) e o pod exportador de GPU (para telemetria de GPU), exportando métricas para o Cloud Monitoring.
Considerações
Escalabilidade e desempenho
- Dedicação da GPU:a GPU NVIDIA RTX PRO 6000 é dedicada inteiramente ao contêiner vLLM. O compartilhamento da GPU via MIG ou divisão por tempo não é implementado nessa arquitetura para garantir uma latência de inferência previsível e evitar erros de falta de memória. O modelo Gemma 4 31B também exige a maior parte da capacidade de VRAM para os pesos do modelo (~62 GB), o que não deixa muita memória para outros modelos serem executados simultaneamente.
- Estratégia de implantação:aplicada como
Recreate. Como temos apenas uma GPU, não podemos executar duas instâncias do pod vLLM simultaneamente durante uma atualização. O pod antigo precisa ser encerrado para liberar o bloqueio da GPU antes que o novo pod possa ser iniciado.
Gerenciamento de recursos
- Margem de VRAM:embora a NVIDIA RTX PRO 6000 de 96 GB se encaixe no modelo Gemma 4 31B com precisão BF16 não quantizada (~62 GB para pesos, deixando ~34 GB para o cache KV), a implantação de referência ativa a quantização Blackwell FP8 (
--quantization=fp8) para reduzir a memória de peso para ~31 GB e expandir o cache KV disponível para ~56,5 GiB (tokens simultâneos61,728). - Dimensionamento do cache de KV:a SRA pressupõe a alocação padrão de vLLM (
--gpu-memory-utilization=0.95), que maximiza o uso da VRAM para o mecanismo.
Disponibilidade e confiabilidade
- Cache Warmth:o uso de PVs locais do nó é fundamental. Se o nó for reiniciado, os pesos armazenados em cache no diretório do host serão reutilizados.
- Cache de imagens:como a imagem do contêiner vLLM é grande (>10 GB), é recomendável definir
imagePullPolicy: IfNotPresentpara evitar atrasos no pull do registro ao reiniciar o pod.
Complexidade operacional
- Visibilidade do console:ao contrário do GKE, o software do Distributed Cloud não é compatível com a visualização "Modelos de IA/ML" baseada em console. Toda validação e monitoramento precisam ser realizados pela CLI
kubectl, encaminhamento de porta e painéis diretos do Cloud Monitoring.
Decisão de design
Mecanismo de inferência: vLLM x Triton x Ollama
- Opção selecionada:vLLM
- Justificativa:o vLLM oferece a melhor performance pronta para uso para LLMs via PagedAttention, tem suporte à paridade da API OpenAI e imagens de contêiner pré-qualificadas da Vertex AI.
- Alternativas rejeitadas:
- Triton:muito complexo para configurar e compilar para uma implantação de borda de modelo único.
- Ollama:não tem os endpoints de telemetria avançados e o ajuste granular de simultaneidade necessários para o monitoramento de produção.
Caminho da telemetria: GMP nativo x Prometheus local
Opção selecionada:GMP nativo (PodMonitoring)
- Justificativa:o software do Distributed Cloud só é compatível com a integração nativa ao Cloud Monitoring. Podemos encaminhar métricas diretamente para Google Cloud usando o Prometheus gerenciado, reduzindo a sobrecarga operacional no cluster.
- Alternativas rejeitadas:
- Stack local do Prometheus e do Grafana:rejeitado para minimizar o uso de recursos do plano de controle no cluster de nó único.
Suposições e limitações
Suposições
- Disponibilidade do operador de GPU:presumimos que o cliente instalou o operador de GPU NVIDIA e configurou a
nvidiaRuntimeClass antes de implantar esta solução. - Acesso ao Hugging Face:a implantação exige um token válido do Hugging Face com acesso ao repositório restrito do Gemma 4, armazenado como um secret do Kubernetes.
- Caminho de rede:o cluster precisa ter acesso à Internet (ou um proxy interno) para baixar a imagem do contêiner e os pesos do modelo durante a configuração inicial.
Limitações
- Limite de GPU única:a arquitetura da Fase 1 é limitada pela capacidade física de uma única GPU NVIDIA RTX PRO 6000. Modelos maiores que 31 bilhões (ou cargas de trabalho de alta simultaneidade que exigem paralelismo de tensor com várias GPUs) não são compatíveis na Fase 1.
- Sem atualizações graduais:a estratégia
Recreateimplica uma interrupção temporária do serviço durante as atualizações de modelo ou mudanças de configuração, já que a GPU não pode ser compartilhada entre os pods antigos e novos. - Ajuste de desempenho excluído:consistente com o escopo do projeto, as otimizações no nível do nó (fixação de CPU, hugepages,
PerformanceTuningProfile) são excluídas desta arquitetura.