


Panoramica
Questa architettura di riferimento della soluzione (SRA) definisce la progettazione concettuale, la topologia dei componenti e i limiti tecnici per l'hosting, la pubblicazione e la convalida di modelli linguistici di grandi dimensioni (LLM) open-weight su cluster autonomi solo software Distributed Cloud.
Gli ambienti edge aziendali spesso richiedono inferenza a bassa latenza e una rigorosa sovranità dei dati. Questa architettura di riferimento della soluzione fornisce uno stack di serving standardizzato, sicuro e osservabile per il deployment del modello Gemma 4 31B su un cluster software Distributed Cloud a un singolo nodo dotato di una GPU NVIDIA RTX PRO 6000 (96 GB di VRAM) fornita dal cliente.
Caratteristiche e funzionalità
- Local Model Serving: espone un'API compatibile con OpenAI e standard del settore localmente all'interno del limite del cluster solo del software Distributed Cloud.
- Supporto per modelli edge di grandi dimensioni:ottimizzato per l'esecuzione di Gemma 4 31B in precisione nativa (BF16) o formati quantizzati, utilizzando appieno la capacità della VRAM di 96 GB.
- Osservabilità:si integra con l'infrastruttura di monitoraggio del software Distributed Cloud (Google Cloud Managed Service per Prometheus) utilizzando risorse
PodMonitoringnative per esportare la telemetria della GPU e le metriche delle prestazioni di vLLM, evitando la necessità di un server Prometheus locale autonomo. - Convalida interattiva:implementa un'interfaccia web basata su Gradio per la verifica visiva immediata della reattività del modello.
Principi architettonici
- Semplicità e portabilità: standardizza i costrutti nativi di Kubernetes (Deployment, Service) anziché operatori di pubblicazione complessi, garantendo facilità di deployment e manutenzione nelle configurazioni a un solo nodo.
- Sovranità dei dati:tutto il traffico di inferenza e i dati di prompt e risposta rimangono rigorosamente all'interno del confine del cluster locale.
- Isolamento delle risorse:dedica l'acceleratore GPU fisico a una singola istanza di erogazione del modello per evitare la contesa delle risorse e garantire una latenza prevedibile.
Architettura e design
Componenti
I componenti della soluzione sono:
- Spazio dei nomi del cliente (solo cluster software Distributed Cloud):
- vLLM Serving Engine:eseguito il deployment come deployment Kubernetes che esegue il container vLLM. Configurato per caricare i pesi di Gemma da uno spazio di archiviazione permanente ed esporre un'API compatibile con OpenAI.
- Interfaccia utente web di Gradio: implementata come deployment Kubernetes che fornisce l'interfaccia di chat per la verifica (facoltativo: può essere eseguita anche esternamente su una workstation di sviluppo o un runtime di test connesso al servizio vLLM del cluster).
- Persistent Volume Claim (PVC): supportato solo dall'archiviazione condivisa locale del software Distributed Cloud
(utilizzando StorageClass
local-shared) per ospitare i pesi del modello. - Servizi Kubernetes:servizio ClusterIP per l'endpoint API vLLM; servizio NodePort o LoadBalancer per l'interfaccia utente di Gradio per esporla alla rete del cliente.
- Infrastruttura (gestita dal cliente):
- Operatore GPU NVIDIA:orchestra ed espone le risorse GPU fisiche ai nodi worker Kubernetes solo software Distributed Cloud.
- GPU NVIDIA RTX PRO 6000:l'acceleratore fisico sottostante (architettura di memoria GDDR7 da 96 GB).
- Integrazione con Google Cloud:
- Google Cloud Monitoring & Logging: agenti software Distributed Cloud predefiniti che raccolgono e inoltrano log di sistema, log dei container e metriche di base a Google Cloud.
Panoramica dell'architettura di alto livello
Il seguente diagramma illustra il flusso di richieste e le interazioni tra i componenti all'interno del cluster solo software Distributed Cloud:
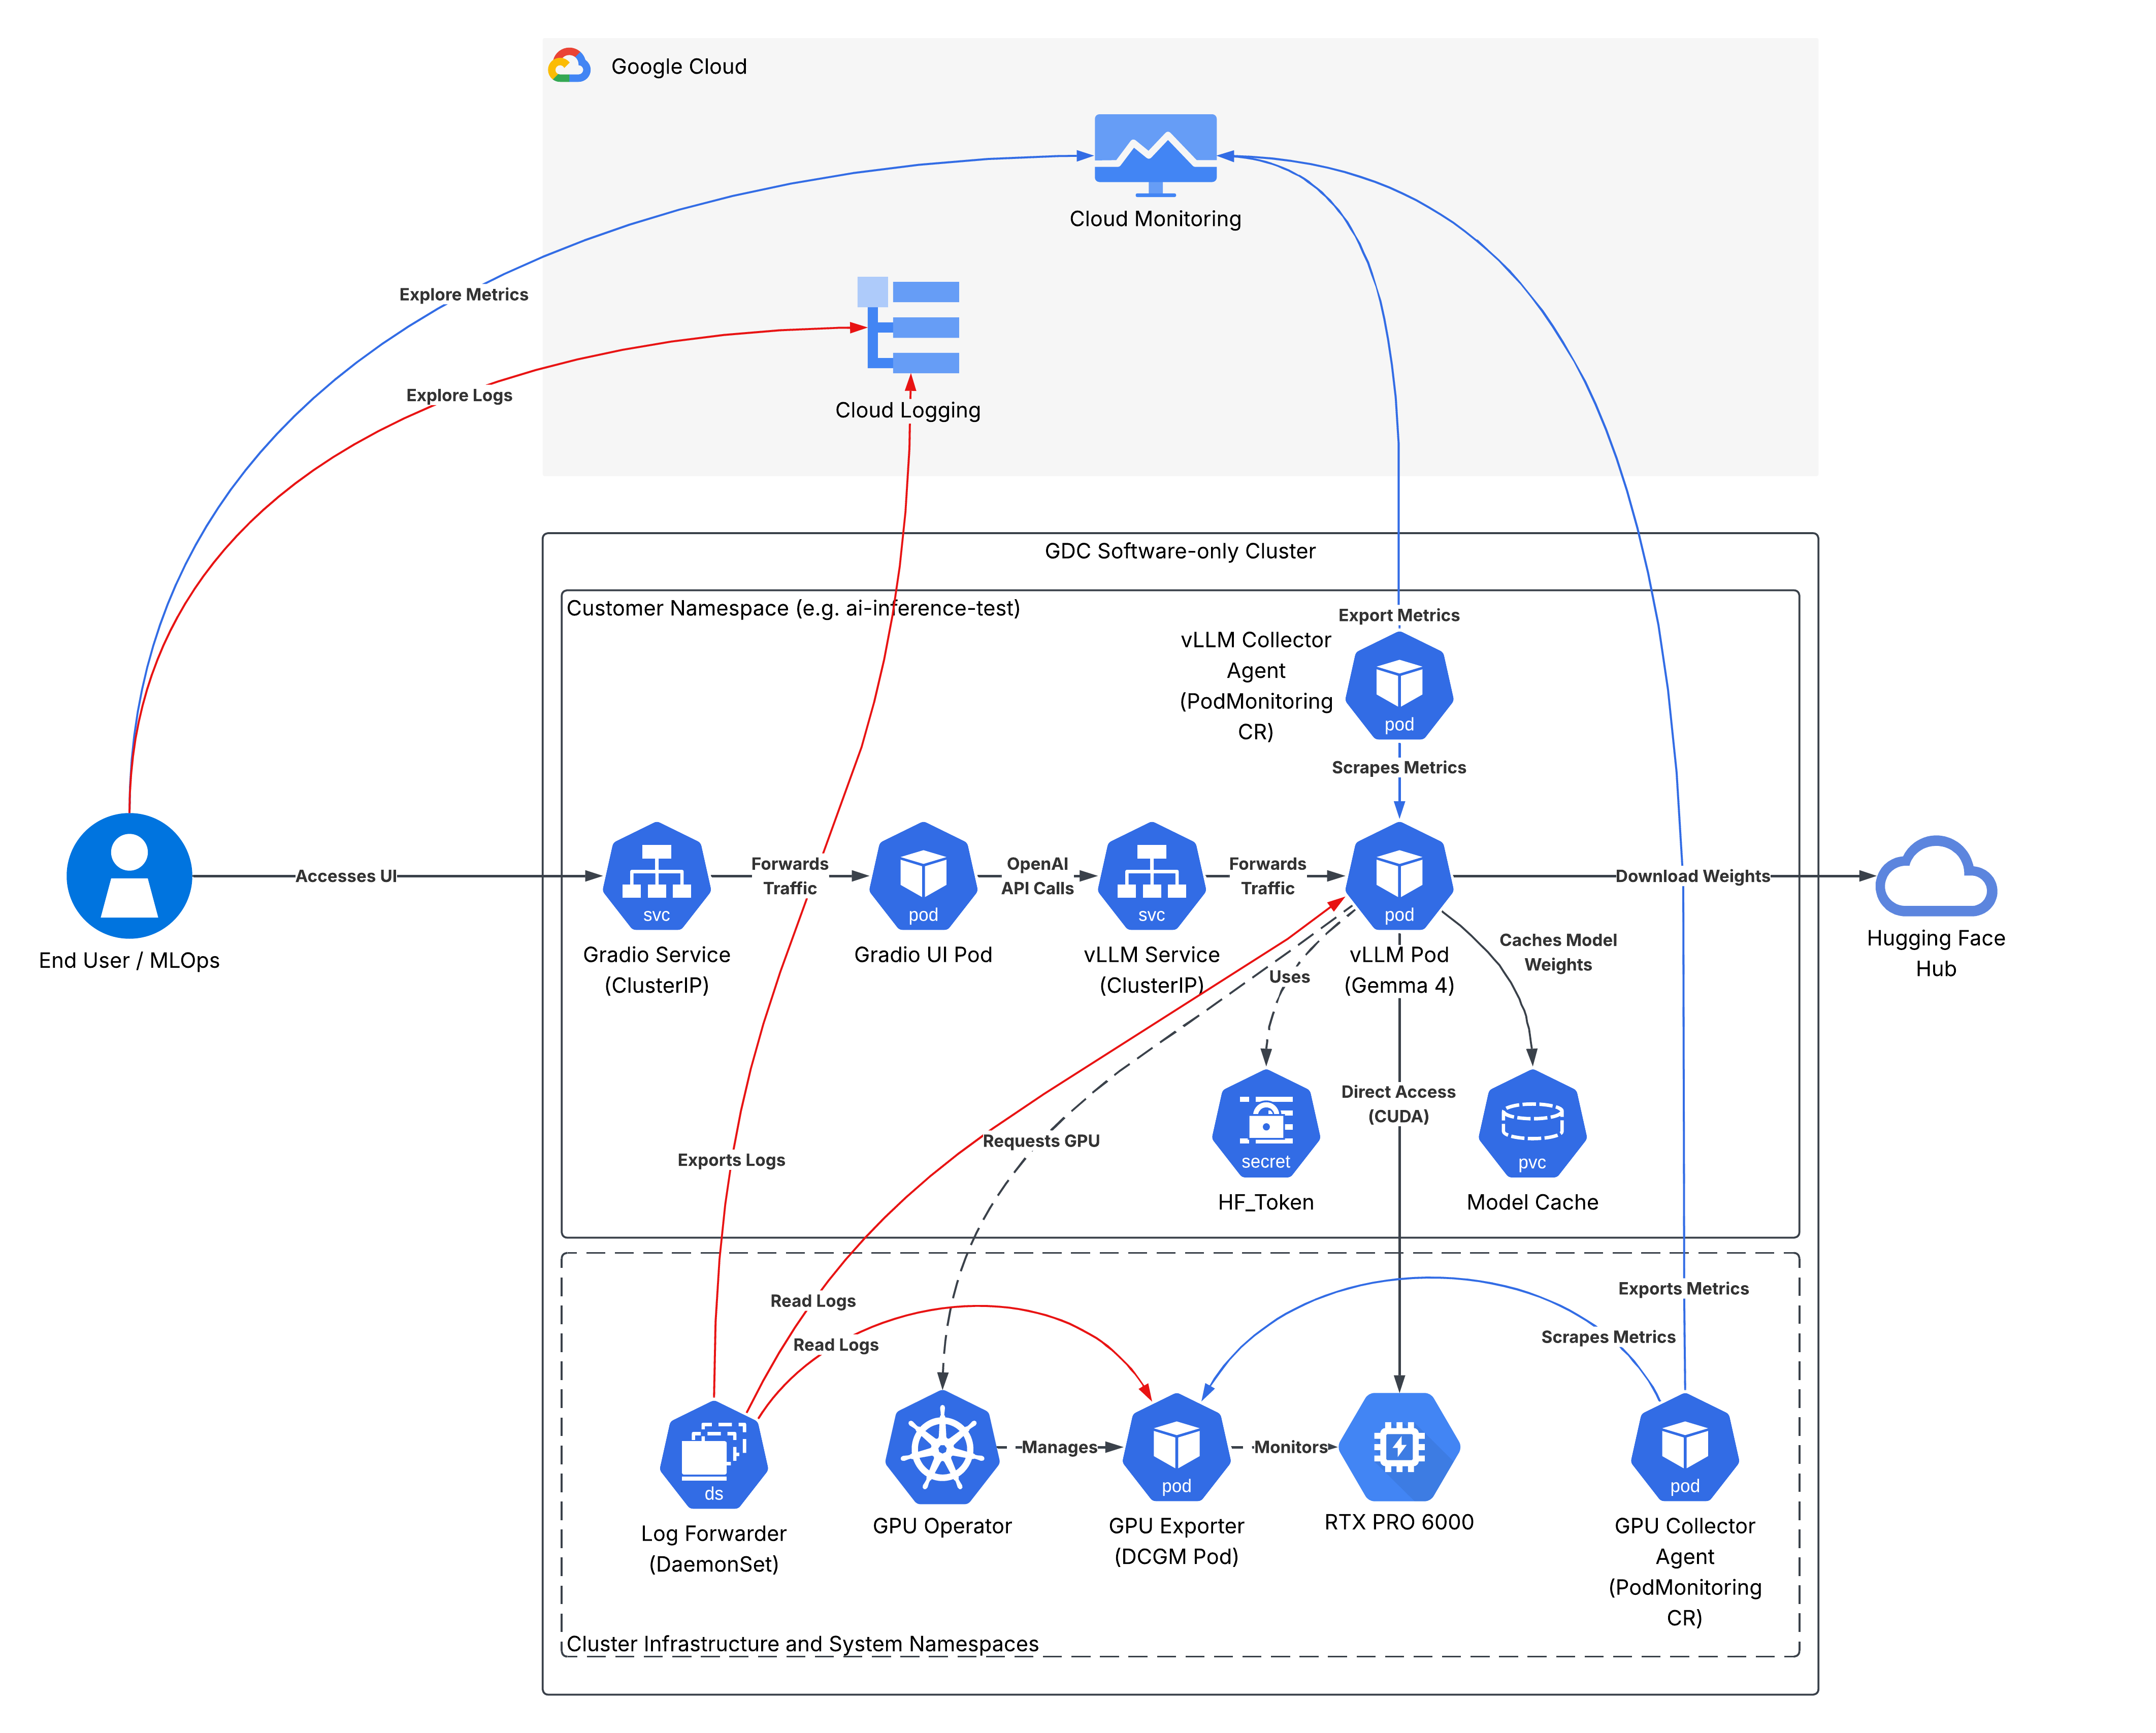
Vincoli hardware
La soluzione è progettata per hardware fornito dal cliente dotato della GPU NVIDIA RTX PRO 6000 Blackwell.
- Specifiche della GPU: NVIDIA RTX PRO 6000 (Blackwell Server o Workstation Edition).
- Architettura della memoria: 96 GB di VRAM GDDR7 (con ECC)
- Impatto della selezione del modello:
- I 96 GB di VRAM consentono di eseguire il modello Gemma 4 31B di destinazione con precisione BF16 nativa (occupando circa 62 GB di pesi e lasciando circa 34 GB di headroom della VRAM per la cache Key-Value (KV)).
- Quando è abilitata la quantizzazione FP8 con accelerazione hardware Blackwell
(
--quantization=fp8), come configurato nell'implementazione di riferimento, la memoria dei pesi del modello viene dimezzata a circa 31 GB, espandendo la cache KV disponibile a circa 56,5 GiB (61,728token) a--gpu-memory-utilization=0.95e consentendo finestre contestuali di grandi dimensioni o dimensioni dei batch simultanei elevate senza riscontrare errori di esaurimento della memoria (OOM).
Matrice di supportabilità (responsabilità)
| Componente | Gestito da | Note |
|---|---|---|
| Hardware fisico e sistema operativo | Cliente | Hardware di origine del cliente (in particolare server o workstation con GPU NVIDIA RTX PRO 6000 Blackwell). |
| Installazione del cluster solo software Distributed Cloud | Cliente | Deve seguire la documentazione standard di installazione solo del software Distributed Cloud. |
| Driver e operatore GPU | Cliente | Installazione di NVIDIA GPU Operator e dei grafici Helm. Google non supporta il deployment dell'operatore NVIDIA. |
| Manifest di pubblicazione vLLM | Google (soluzione) | Fornito nell'ambito di questa guida alla soluzione. |
| Artefatti del modello | Cliente | Download e hosting dei pesi del modello Gemma. |
| Codice dell'app e dell'interfaccia utente di Gradio | Cliente | Livello dell'applicazione di proprietà del cliente per la convalida e l'utilizzo. |
| Cloud Logging e Cloud Monitoring | Joint | Google fornisce l'integrazione predefinita; il cliente configura. |
Concetti e tecnologie
Questa sezione descrive in dettaglio i componenti funzionali, le loro responsabilità e il modo in cui comunicano all'interno del sistema. Identifica i servizi principali, le unità di archiviazione dei dati e le interfacce di rete necessarie per supportare il caso d'uso di destinazione.
Infrastruttura e piattaforma
- GPU NVIDIA RTX PRO 6000:fornisce 96 GB di VRAM GDDR7. La GPU fisica è dedicata interamente all'istanza di erogazione del modello. Il partizionamento della GPU (MIG) non è abilitato per garantire che il modello abbia accesso esclusivo alla VRAM completa e alla larghezza di banda della memoria, evitando la contesa delle risorse.
- Operatore GPU NVIDIA:operatore gestito dal cliente che orchestra ed espone le risorse GPU fisiche solo ai nodi worker Kubernetes del software Distributed Cloud.
- Archiviazione locale del nodo (rivendicazione del volume permanente): supportata dall'archiviazione locale del nodo solo software Distributed Cloud per ospitare e rendere persistenti i pesi del modello sul nodo. In questo modo, una volta scaricati, i pesi del modello vengono salvati in locale. I riavvii o gli aggiornamenti successivi dei pod caricano i pesi da questa cache locale, riducendo il tempo di avvio e proteggendo dalle interruzioni della WAN.
- Segmento di memoria condivisa (
/dev/shm): un volumeemptyDirconmedium: Memoryè montato in/dev/shme allocato 16 GiB per evitare errori di segmentazione durante le operazioni tensoriali ad alta concorrenza in vLLM.
Servizi e logica
- vLLM Serving Engine:deployment Kubernetes che esegue il container vLLM qualificato per Vertex AI, esposto tramite un servizio
ClusterIP(porta 8000). I parametri di configurazione chiave includono:--model: Percorso o ID del modello Gemma (ad es.google/gemma-4-31B-it).--tensor-parallel-size: impostato su1(vincolo di una sola GPU).--dtype: impostato subfloat16per sfruttare la precisione nativa dell'hardware per livelli e attivazioni non quantizzati.--quantization: impostato sufp8nell'implementazione di riferimento per sfruttare la quantizzazione dei pesi FP8 di Blackwell (~31 GB di pesi, ~56,5 GiB di cache KV) o omesso se è preferibile BF16 non quantizzato (~62 GB di pesi, ~34 GB di cache KV).
- Interfaccia utente web di Gradio: eseguita il deployment come deployment Kubernetes che fornisce un'interfaccia di chat per la convalida, esposta tramite un servizio
ClusterIP(porta 8080). Si connette al servizio vLLM per l'interazione con prompt e risposte.
Osservabilità e Google Cloud integrazione
- Cloud Logging: utilizza agenti di logging solo software Distributed Cloud predefiniti per acquisire e inoltrare automaticamente i log dei container (log dell'applicazione vLLM e diagnostica della GPU) a Cloud Logging.
- Cloud Monitoring (PodMonitoring): le risorse di Google Cloud Managed Service per Prometheus (GMP) hanno come target sia il pod vLLM (per la pubblicazione di dati di telemetria come il throughput dei token e l'utilizzo della cache KV) sia il pod dell'esportatore GPU (per la telemetria GPU), esportando le metriche in Cloud Monitoring.
Considerazioni
Scalabilità e prestazioni
- GPU dedicata:la GPU NVIDIA RTX PRO 6000 è dedicata interamente al container vLLM. La condivisione della GPU tramite MIG o time-slicing non è implementata in questa architettura per garantire una latenza di inferenza prevedibile ed evitare errori di esaurimento della memoria. Il modello Gemma 4 31B richiede anche la maggior parte della capacità della VRAM per i pesi del modello (~62 GB), il che non lascia molta memoria per l'esecuzione simultanea di altri modelli.
- Strategia di deployment: applicata come
Recreate. Poiché abbiamo una sola GPU, non possiamo eseguire due istanze del pod vLLM contemporaneamente durante un aggiornamento. Il vecchio pod deve essere terminato per rilasciare il blocco della GPU prima che possa essere avviato il nuovo pod.
Gestione delle risorse
- Spazio libero della VRAM:mentre la NVIDIA RTX PRO 6000 da 96 GB si adatta al modello Gemma 4 31B con precisione BF16 non quantizzata (~62 GB per i pesi, lasciando ~34 GB per la cache KV), il deployment di riferimento attiva la quantizzazione FP8 di Blackwell (
--quantization=fp8) per ridurre la memoria dei pesi a circa 31 GB ed espandere la cache KV disponibile a ~56,5 GiB (61,728token simultanei). - Dimensionamento della cache KV:SRA presuppone l'allocazione vLLM predefinita
(
--gpu-memory-utilization=0.95), che massimizza l'utilizzo della VRAM per il motore.
Disponibilità e affidabilità
- Cache Warmth:l'utilizzo di PV locali del nodo è fondamentale. Se il nodo viene riavviato, i pesi memorizzati nella cache nella directory host vengono riutilizzati.
- Memorizzazione nella cache delle immagini:poiché l'immagine container vLLM è di grandi dimensioni (> 10 GB), è
consigliabile impostare
imagePullPolicy: IfNotPresentper evitare ritardi nel pull del registro al riavvio del pod.
Complessità operativa
- Visibilità della console:a differenza di GKE, il software Distributed Cloud non supporta la visualizzazione "Modelli AI/ML" basata su console. Tutte le operazioni di convalida e monitoraggio
devono essere eseguite tramite la CLI
kubectl, l'inoltro delle porte e le dashboard Cloud Monitoring dirette.
Decisione di progettazione
Motore di inferenza: vLLM, Triton e Ollama
- Opzione selezionata: vLLM
- Motivazione: vLLM offre le migliori prestazioni pronte all'uso per gli LLM tramite PagedAttention, supporta la parità dell'API OpenAI e dispone di immagini container prequalificate da Vertex AI.
- Alternative rifiutate:
- Triton: troppo complesso da configurare e compilare per un deployment edge a modello singolo.
- Ollama: non dispone degli endpoint di telemetria avanzata e dell'ottimizzazione della concorrenza granulare necessari per il monitoraggio della produzione.
Percorso di telemetria: GMP nativo rispetto a Prometheus locale
Opzione selezionata: GMP nativa (PodMonitoring)
- Motivazione:il software Distributed Cloud supporta solo l'integrazione nativa con Cloud Monitoring. Possiamo instradare le metriche direttamente a Google Cloud utilizzando Managed Prometheus, riducendo l'overhead operativo sul cluster.
- Alternative rifiutate:
- Stack Prometheus e Grafana locale:rifiutato per ridurre al minimo l'utilizzo delle risorse del control plane nel cluster a un solo nodo.
Presupposti e limitazioni
Ipotesi
- Disponibilità dell'operatore GPU: si presuppone che il cliente abbia installato correttamente l'operatore GPU NVIDIA e configurato
nvidiaRuntimeClass prima di eseguire il deployment di questa soluzione. - Accesso a Hugging Face:il deployment richiede un token Hugging Face valido con accesso al repository Gemma 4 controllato, archiviato come secret Kubernetes.
- Percorso di rete:il cluster deve avere accesso a internet (o a un proxy interno) per scaricare l'immagine container e i pesi del modello durante la configurazione iniziale.
Limitazioni
- Limite di una singola GPU:l'architettura di Fase 1 è limitata dalla capacità fisica di una singola GPU NVIDIA RTX PRO 6000. I modelli più grandi di circa 31 miliardi (o i carichi di lavoro ad alta concorrenza che richiedono il parallelismo dei tensori multi-GPU) non sono supportati nella fase 1.
- Nessun aggiornamento continuo:la strategia
Recreateimplica un'interruzione temporanea del servizio durante gli aggiornamenti del modello o le modifiche alla configurazione, poiché la GPU non può essere condivisa tra i pod vecchi e nuovi. - Ottimizzazione delle prestazioni esclusa:in linea con l'ambito del progetto,
le ottimizzazioni a livello di nodo (blocco della CPU, hugepages,
PerformanceTuningProfile) sono escluse da questa architettura.