


סקירה כללית
בארכיטקטורת הפתרון (SRA) הזו מוגדרים העיצוב הקונספטואלי, טופולוגיית הרכיבים והגבולות הטכניים לאירוח, להצגה ולאימות של מודלים גדולים של שפה (LLM) עם משקלים פתוחים באשכולות עצמאיים של תוכנת Distributed Cloud בלבד.
בסביבות קצה של Enterprise, לעיתים קרובות נדרשת הסקה עם השהיה נמוכה וריבונות נתונים מחמירה. ארכיטקטורת העזר של הפתרון הזה מספקת מחסנית פרסום סטנדרטית, מאובטחת וניתנת לצפייה לפריסת מודל Gemma 4 31B באשכול תוכנה של Distributed Cloud עם צומת יחיד, שמצויד ב-NVIDIA RTX PRO 6000 GPU (96GB VRAM) שמקורו בלקוח.
תכונות ויכולות
- הצגת מודל מקומי: חשיפת API תואם ל-OpenAI, שהוא תקן בתעשייה, באופן מקומי רק בגבולות של אשכול תוכנה של Distributed Cloud.
- תמיכה במודלים גדולים של Edge: המערכת עברה אופטימיזציה להרצת Gemma 4 31B בדיוק מקורי (BF16) או בפורמטים כמותיים, תוך ניצול מלא של קיבולת ה-VRAM של 96GB.
- יכולת צפייה (Observability): משתלב עם תשתית המעקב של תוכנת Distributed Cloud בלבד (Google Cloud Managed Service for Prometheus) באמצעות משאבי
PodMonitoringמקומיים כדי לייצא טלמטריה של GPU ומדדי ביצועים של vLLM, בלי הצורך בשרת Prometheus מקומי עצמאי. - אימות אינטראקטיבי: פריסת ממשק אינטרנט מבוסס-Gradio לאימות חזותי מיידי של היענות המודל.
עקרונות אדריכליים
- פשטות וניידות: המערכת מתבססת על מבנים מקוריים של Kubernetes (פריסה, שירות) ולא על אופרטורים מורכבים להצגת מודעות, כדי להבטיח פריסה ותחזוקה קלות בהגדרות של צומת יחיד.
- ריבונות נתונים: כל התנועה של מסקנות ונתוני ההנחיות והתגובות נשארים אך ורק בגבולות האשכול המקומי.
- בידוד משאבים: הקצאה של מאיץ GPU פיזי למופע יחיד של פרסום מודל כדי למנוע תחרות על משאבים ולהבטיח זמן אחזור צפוי.
אדריכלות ועיצוב
רכיבים
רכיבי הפתרון כוללים:
- מרחב שמות של לקוח (אשכול תוכנה של Distributed Cloud בלבד):
- vLLM Serving Engine: נפרס כ-Kubernetes Deployment שמריץ את קונטיינר vLLM. ההגדרה היא לטעינת משקלים של Gemma מאחסון מתמיד ולחשיפת API שתואם ל-OpenAI.
- Gradio Web UI: נפרס כ-Kubernetes Deployment ומספק את ממשק הצ'אט לאימות (אופציונלי: אפשר גם להפעיל אותו חיצונית בתחנת עבודה של מפתח או בסביבת בדיקה שמתחברת לשירות vLLM של האשכול).
- Persistent Volume Claim (PVC): מגובה על ידי תוכנת Distributed Cloud רק באחסון מקומי משותף (באמצעות
local-sharedStorageClass) לאירוח משקלי המודל. - שירותי Kubernetes: שירות ClusterIP לנקודת קצה ל-API של vLLM; שירות NodePort או LoadBalancer לממשק המשתמש של Gradio כדי לחשוף אותו לרשת של הלקוח.
- תשתית (בניהול הלקוח):
- NVIDIA GPU Operator: מנהל את משאבי ה-GPU הפיזיים וחושף אותם רק לצמתי עבודה של Kubernetes בתוכנת Distributed Cloud.
- NVIDIA RTX PRO 6000 GPU: המאיץ הפיזי הבסיסי (ארכיטקטורת זיכרון GDDR7 בנפח 96GB).
- שילוב עם Google Cloud:
- Google Cloud Monitoring & Logging: סוכנים של תוכנת Distributed Cloud שמוגדרים כברירת מחדל, שאוספים ומעבירים יומני מערכת, יומני קונטיינרים ומדדים בסיסיים אלGoogle Cloud.
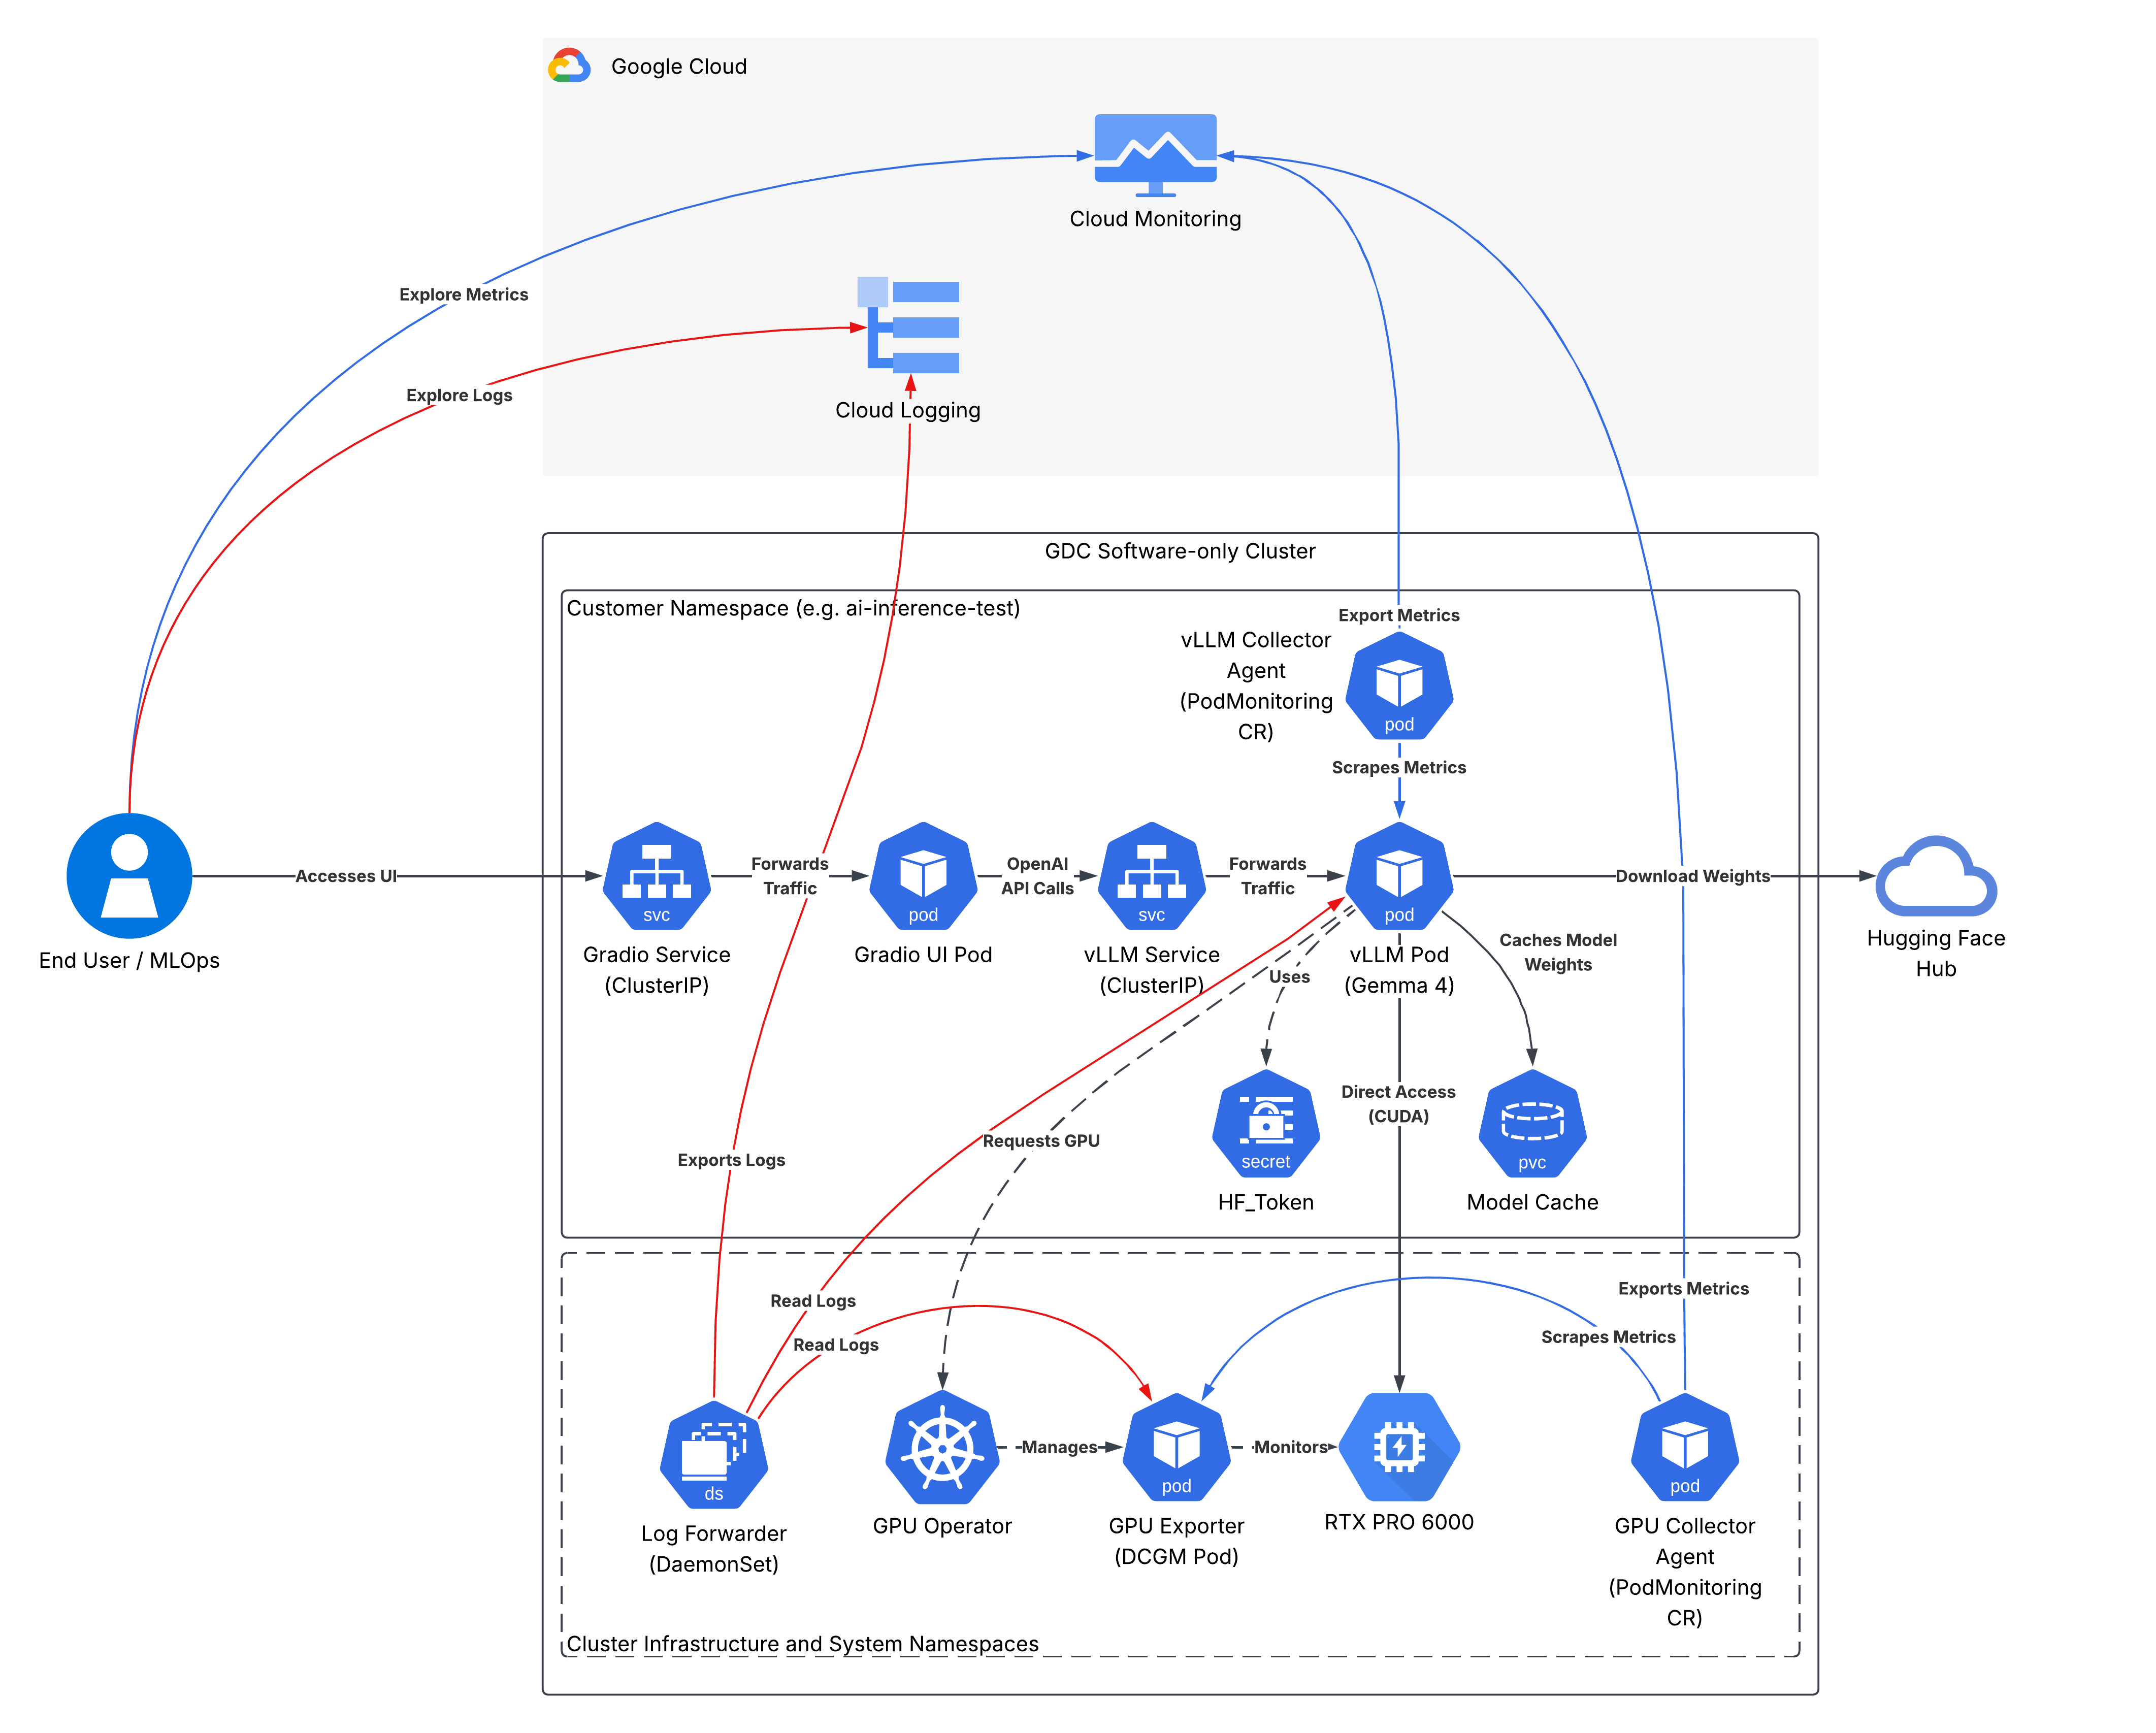
סקירה כללית של הארכיטקטורה
בתרשים הבא מוצג זרימת הבקשות והאינטראקציות בין הרכיבים באשכול של תוכנת Distributed Cloud בלבד:
מגבלות חומרה
הפתרון מיועד לחומרה שמגיעה ממקורות של לקוחות ומצוידת במעבד גרפי NVIDIA RTX PRO 6000 Blackwell.
- מפרט GPU: NVIDIA RTX PRO 6000 (Blackwell Server או Workstation Edition).
- ארכיטקטורת זיכרון: זיכרון GDDR7 VRAM בנפח 96GB (עם ECC)
- ההשפעה של בחירת המודל:
- זיכרון ה-VRAM בנפח 96GB מאפשר להריץ את מודל היעד Gemma 4 31B בדיוק BF16 מקורי (תופס נפח של ~62GB של משקלים ומשאיר נפח של ~34GB של מרווח ביטחון בזיכרון ה-VRAM למטמון של זוגות מפתח-ערך (KV)).
- כשמפעילים את הכמותית FP8 עם האצת חומרה של Blackwell (
--quantization=fp8) – כפי שמוגדר בהטמעה לדוגמה – זיכרון המשקלים של המודל מצטמצם בחצי ל-31GB בערך, ומטמון KV הזמין גדל ל-56.5GiB בערך (61,728טוקנים) ב---gpu-memory-utilization=0.95, וכך אפשר להשתמש בחלונות הקשר גדולים או בגדלים גדולים של אצווה בו-זמנית בלי להיתקל בשגיאות של חוסר זיכרון (OOM).
מטריצת תמיכה (תחומי אחריות)
| רכיב | מנוהל על ידי | הערות |
|---|---|---|
| חומרה פיזית ומערכת הפעלה | לקוח/ה | חומרה ממקור הלקוח (במיוחד שרת או תחנת עבודה עם GPU מסוג NVIDIA RTX PRO 6000 Blackwell). |
| התקנת אשכול רק של תוכנת Distributed Cloud | לקוח/ה | צריך לפעול לפי מסמכי ההתקנה הרגילים של תוכנת Distributed Cloud בלבד. |
| מנהלי התקנים של GPU ומפעיל | לקוח/ה | התקנה של NVIDIA GPU Operator ושל תרשימי Helm. Google לא תומכת בפריסת אופרטור NVIDIA. |
| מניפסטים של vLLM Serving | Google (פתרון) | הם מופיעים במדריך הפתרונות הזה. |
| פריטים שנוצרו על ידי המודל | לקוח/ה | הורדה ואירוח של משקלי מודל Gemma. |
| ממשק המשתמש של Gradio וקוד האפליקציה | לקוח/ה | שכבת אפליקציה בבעלות הלקוח לצורך אימות ושימוש. |
| Cloud Logging ו-Cloud Monitoring | משותף | Google מספקת שילוב כברירת מחדל, הלקוח מגדיר. |
מושגים וטכנולוגיות
בקטע הזה מפורטים הרכיבים הפונקציונליים, האחריות שלהם והאופן שבו הם מתקשרים בתוך המערכת. היא מזהה את שירותי הליבה, יחידות אחסון הנתונים וממשקי הרשת שנדרשים כדי לתמוך בתרחיש השימוש המיועד.
תשתית ופלטפורמה
- NVIDIA RTX PRO 6000 GPU: מספק 96GB GDDR7 VRAM. ה-GPU הפיזי מוקדש כולו למופע של מודל שמופעל. חלוקת ה-GPU (MIG) לא מופעלת כדי לוודא שלמודל יש גישה בלעדית ל-VRAM ולרוחב פס הזיכרון המלאים, וכך למנוע תחרות על משאבים.
- NVIDIA GPU Operator: אופרטור בניהול הלקוח שמבצע אורקסטרציה של משאבי ה-GPU הפיזיים ומציג אותם רק לצמתי עובדים של Kubernetes בתוכנת Distributed Cloud.
- Node-Local Storage (Persistent Volume Claim): נתמך על ידי תוכנת Distributed Cloud בלבד. אחסון מקומי של הצומת לאירוח ולשמירה של משקלי המודל בצומת. כך מוודאים שמשקלי המודל יישמרו באופן מקומי אחרי ההורדה. הפעלה מחדש או עדכונים של פודים לאחר מכן טוענים משקלים מהמטמון המקומי הזה, וכך מקצרים את זמן ההפעלה ומגנים מפני הפסקות חשמל ברשת WAN.
- פלח זיכרון משותף (
/dev/shm): נפחemptyDirעםmedium: Memoryמותקן ב-/dev/shmומוקצים לו 16GiB כדי למנוע שגיאות פילוח במהלך פעולות טנסור עם רמת מקביליות גבוהה ב-vLLM.
שירותים ולוגיקה
- vLLM Serving Engine: נפרס כ-Kubernetes Deployment שבו פועל קונטיינר vLLM שעומד בדרישות של Vertex AI, ונחשף דרך שירות
ClusterIP(יציאה 8000). פרמטרים מרכזיים להגדרה:-
--model: הנתיב או המזהה של מודל Gemma (לדוגמה,google/gemma-4-31B-it). -
--tensor-parallel-size: מוגדר ל-1(הגבלה של GPU יחיד). -
--dtype: מגדירים את הערךbfloat16כדי להשתמש בדיוק שמותאם לחומרה בשביל שכבות והפעלות לא כמותיות. -
--quantization: צריך להגדיר את הערךfp8בהטמעה לדוגמה כדי להשתמש בכימות משקלים של Blackwell FP8 (משקלים של ~31 GB, מטמון KV של ~56.5 GiB), או להשמיט את הערך אם מעדיפים BF16 לא מכומת (משקלים של ~62 GB, מטמון KV של ~34 GB).
-
- ממשק משתמש אינטרנטי של Gradio: נפרס כפריסת Kubernetes שמספקת ממשק צ'אט לאימות, שנחשף דרך שירות
ClusterIP(יציאה 8080). הוא מתחבר לשירות vLLM כדי ליצור אינטראקציה עם ההנחיה והתשובה.
ניראות ושילוב Google Cloud
- Cloud Logging: משתמש בסוכני רישום ביומן של תוכנת Distributed Cloud שמוגדרים כברירת מחדל כדי לתעד ולהעביר אוטומטית יומנים של קונטיינרים (יומני אפליקציות של vLLM ונתוני אבחון של GPU) אל Cloud Logging.
- Cloud Monitoring (PodMonitoring): משאבי Google Cloud Managed Service for Prometheus (GMP) מכוונים גם אל ה-Pod של vLLM (לשליחת טלמטריה כמו קצב העברת נתונים של טוקנים ושימוש במטמון KV) וגם אל ה-Pod של GPU exporter (לטלמטריית GPU), ומייצאים מדדים אל Cloud Monitoring.
לתשומת ליבכם
מדרגיות וביצועים
- הקצאת GPU: מעבד ה-GPU NVIDIA RTX PRO 6000 מוקצה באופן מלא לקונטיינר vLLM. שיתוף ה-GPU באמצעות MIG או חלוקת זמן לא מיושם בארכיטקטורה הזו כדי להבטיח חביון (latency) צפוי של הסקה ולמנוע שגיאות OOM. מודל Gemma 4 31B גם דורש את רוב קיבולת ה-VRAM עבור משקלי המודל (כ-62GB), כך שלא נשאר הרבה זיכרון להרצת מודלים אחרים במקביל.
- אסטרטגיית פריסה: נאכפת כ
Recreate. מכיוון שיש לנו רק GPU אחד, אנחנו לא יכולים להריץ שני מופעים של vLLM pod בו-זמנית במהלך עדכון. צריך להפסיק את הפעולה של ה-Pod הישן כדי לבטל את נעילת ה-GPU לפני שאפשר להפעיל את ה-Pod החדש.
ניהול המשאבים
- מרווח ב-VRAM: כרטיס NVIDIA RTX PRO 6000 בנפח 96GB מתאים למודל Gemma 4 31B בדיוק BF16 לא מכומת (~62 GB למשקלים, ונותרים ~34 GB למטמון KV), אבל הפריסה לדוגמה מאפשרת כימות Blackwell FP8 (
--quantization=fp8) כדי לצמצם את זיכרון המשקלים ל-~31 GB ולהרחיב את מטמון KV הזמין ל-~56.5 GiB (61,728טוקנים בו-זמניים). - גודל המטמון של KV: ה-SRA מניח הקצאה של vLLM כברירת מחדל (
--gpu-memory-utilization=0.95), שממקסמת את השימוש ב-VRAM עבור המנוע.
זמינות ואמינות
- חימום המטמון: השימוש ב-PVs מקומיים לצומת הוא קריטי. אם הצומת מופעל מחדש, המשקלים שנשמרו במטמון בספריית המארח ישמשו שוב.
- שמירת קובצי אימג' במטמון: קובץ אימג' של קונטיינר vLLM גדול (מעל 10GB), ולכן מומלץ להגדיר את
imagePullPolicy: IfNotPresentכדי למנוע עיכובים בשליפת הרישום בהפעלה מחדש של ה-Pod.
מורכבות תפעולית
- חשיפה במסוף: בניגוד ל-GKE, תוכנת Distributed Cloud לא תומכת בתצוגה 'מודלים של AI/ML' שמבוססת על המסוף. כל תהליכי האימות והמעקב צריכים להתבצע באמצעות
kubectlCLI, העברת יציאות ולוחות בקרה ישירים של Cloud Monitoring.
החלטה לגבי עיצוב
מנוע הסקה: vLLM לעומת Triton לעומת Ollama
- האפשרות שנבחרה: vLLM
- הסבר: vLLM מציע את הביצועים הכי טובים מתוך הקופסה עבור LLM באמצעות PagedAttention, תומך בשוויון ב-OpenAI API ויש לו תמונות קונטיינר שעברו הסמכה מראש מ-Vertex AI.
- חלופות שנפסלו:
- Triton: מורכב מדי להגדרה ולקימפול לפריסת קצה של מודל יחיד.
- Ollama: אין לו נקודות קצה מתקדמות לטלמטריה וכוונון מדויק של בו-זמניות שנדרשים למעקב אחר סביבת הייצור.
נתיב טלמטריה: GMP מקורי לעומת Prometheus מקומי
האפשרות שנבחרה: Native GMP (PodMonitoring)
- הסבר: תוכנת Distributed Cloud תומכת רק בשילוב מקורי עם Cloud Monitoring. אנחנו יכולים להפנות מדדים ישירות אלGoogle Cloud באמצעות Managed Prometheus, וכך להפחית את התקורה התפעולית בתוך האשכול.
- חלופות שנפסלו:
- חבילת Prometheus ו-Grafana מקומית: נדחתה כדי למזער את השימוש במשאבי מישור הבקרה באשכול עם צומת יחיד.
הנחות ומגבלות
הנחות
- זמינות של GPU Operator: אנחנו מניחים שהלקוח התקין בהצלחה את NVIDIA GPU Operator והגדיר את
nvidiaRuntimeClass לפני פריסת הפתרון הזה. - גישה ל-Hugging Face: כדי לפרוס את המודל, צריך טוקן תקף של Hugging Face עם גישה למאגר Gemma 4 המוגבל, שמאוחסן כסוד של Kubernetes.
- נתיב ברשת: כדי להוריד את קובץ אימג' של קונטיינר ואת משקלי המודל במהלך ההגדרה הראשונית, צריך שלקלאסטר תהיה גישה לאינטרנט (או לשרת proxy פנימי).
מגבלות
- גבולות של GPU יחיד: הארכיטקטורה של שלב 1 מוגבלת על ידי הקיבולת הפיזית של GPU יחיד מסוג NVIDIA RTX PRO 6000. מודלים גדולים יותר מ-31 מיליארד פרמטרים (או עומסי עבודה עם רמת מקביליות גבוהה שדורשים טנסור מקביליות של כמה GPU) לא נתמכים בשלב 1.
- אין עדכונים מדורגים: האסטרטגיה
Recreateמרמזת על השבתה זמנית של השירות במהלך עדכוני מודלים או שינויים בהגדרות, כי אי אפשר לשתף את ה-GPU בין הפודים הישנים והחדשים. - החרגה של שיפור הביצועים: בהתאם להיקף הפרויקט, אופטימיזציות ברמת הצומת (הצמדת CPU, דפי ענק,
PerformanceTuningProfile) מוחרגות מהארכיטקטורה הזו.