

Présentation
Cette architecture de référence de solution (SRA) définit la conception conceptuelle, la topologie des composants et les limites techniques pour l'hébergement, la diffusion et la validation de grands modèles de langage (LLM) open-weight sur des clusters autonomes Distributed Cloud logiciels uniquement.
Les environnements Edge d'entreprise nécessitent souvent une inférence à faible latence et une souveraineté des données stricte. Cette architecture de référence de solution fournit une pile de diffusion standardisée, sécurisée et observable pour déployer le modèle Gemma 4 31B sur un cluster logiciel Distributed Cloud à nœud unique équipé d'un GPU NVIDIA RTX PRO 6000 (96 Go de VRAM) fourni par le client.
Fonctionnalités et capacités
- Service de modèle local : expose une API compatible avec OpenAI et conforme aux normes du secteur en local dans la limite du cluster logiciel Distributed Cloud.
- Prise en charge des grands modèles Edge : optimisé pour exécuter Gemma 4 31B en précision native (BF16) ou dans des formats quantifiés, en utilisant pleinement la capacité de 96 Go de VRAM.
- Observabilité : s'intègre à l'infrastructure de surveillance du logiciel Distributed Cloud uniquement (Google Cloud Managed Service pour Prometheus) à l'aide de ressources
PodMonitoringnatives pour exporter la télémétrie GPU et les métriques de performances vLLM, ce qui évite d'avoir besoin d'un serveur Prometheus local autonome. - Validation interactive : déploie une interface Web basée sur Gradio pour une vérification visuelle immédiate de la réactivité du modèle.
Principes architecturaux
- Simplicité et portabilité : standardisation sur les constructions natives de Kubernetes (déploiement, service) plutôt que sur des opérateurs de diffusion complexes, ce qui garantit la facilité de déploiement et de maintenance sur les configurations à nœud unique.
- Souveraineté des données : l'ensemble du trafic d'inférence, ainsi que les données d'invites et de réponses, restent strictement dans les limites du cluster local.
- Isolation des ressources : le GPU physique est dédié à une seule instance de mise en service du modèle pour éviter la contention des ressources et garantir une latence prévisible.
Architecture et conception
Composants
Les composants de la solution sont les suivants :
- Espace de noms du client (cluster logiciel Distributed Cloud uniquement) :
- Moteur de diffusion vLLM : déployé en tant que déploiement Kubernetes exécutant le conteneur vLLM. Configuré pour charger les pondérations Gemma à partir du stockage persistant et exposer une API compatible avec OpenAI.
- Interface utilisateur Web Gradio : déployée en tant que déploiement Kubernetes, elle fournit l'interface de chat pour la validation (facultatif : peut également s'exécuter en externe sur une station de travail de développeur ou un environnement d'exécution de test connecté au service vLLM du cluster).
- PersistentVolumeClaim (PVC) : uniquement le stockage partagé local (à l'aide de la StorageClass
local-shared) est utilisé pour héberger les pondérations du modèle. - Services Kubernetes : service ClusterIP pour le point de terminaison de l'API vLLM ; service NodePort ou LoadBalancer pour l'interface utilisateur Gradio afin de l'exposer au réseau client.
- Infrastructure (gérée par le client) :
- Opérateur GPU NVIDIA : orchestre et expose les ressources de GPU physiques aux nœuds de calcul Kubernetes du logiciel Distributed Cloud uniquement.
- GPU NVIDIA RTX PRO 6000 : accélérateur physique sous-jacent (architecture de mémoire GDDR7 de 96 Go).
- Intégration à Google Cloud :
- Google Cloud Monitoring et Logging : agents logiciels Distributed Cloud par défaut qui collectent et transfèrent les journaux système, les journaux de conteneurs et les métriques de base versGoogle Cloud.
Présentation générale de l'architecture
Le schéma suivant illustre le flux de requêtes et les interactions entre les composants dans le cluster Distributed Cloud Software Only :
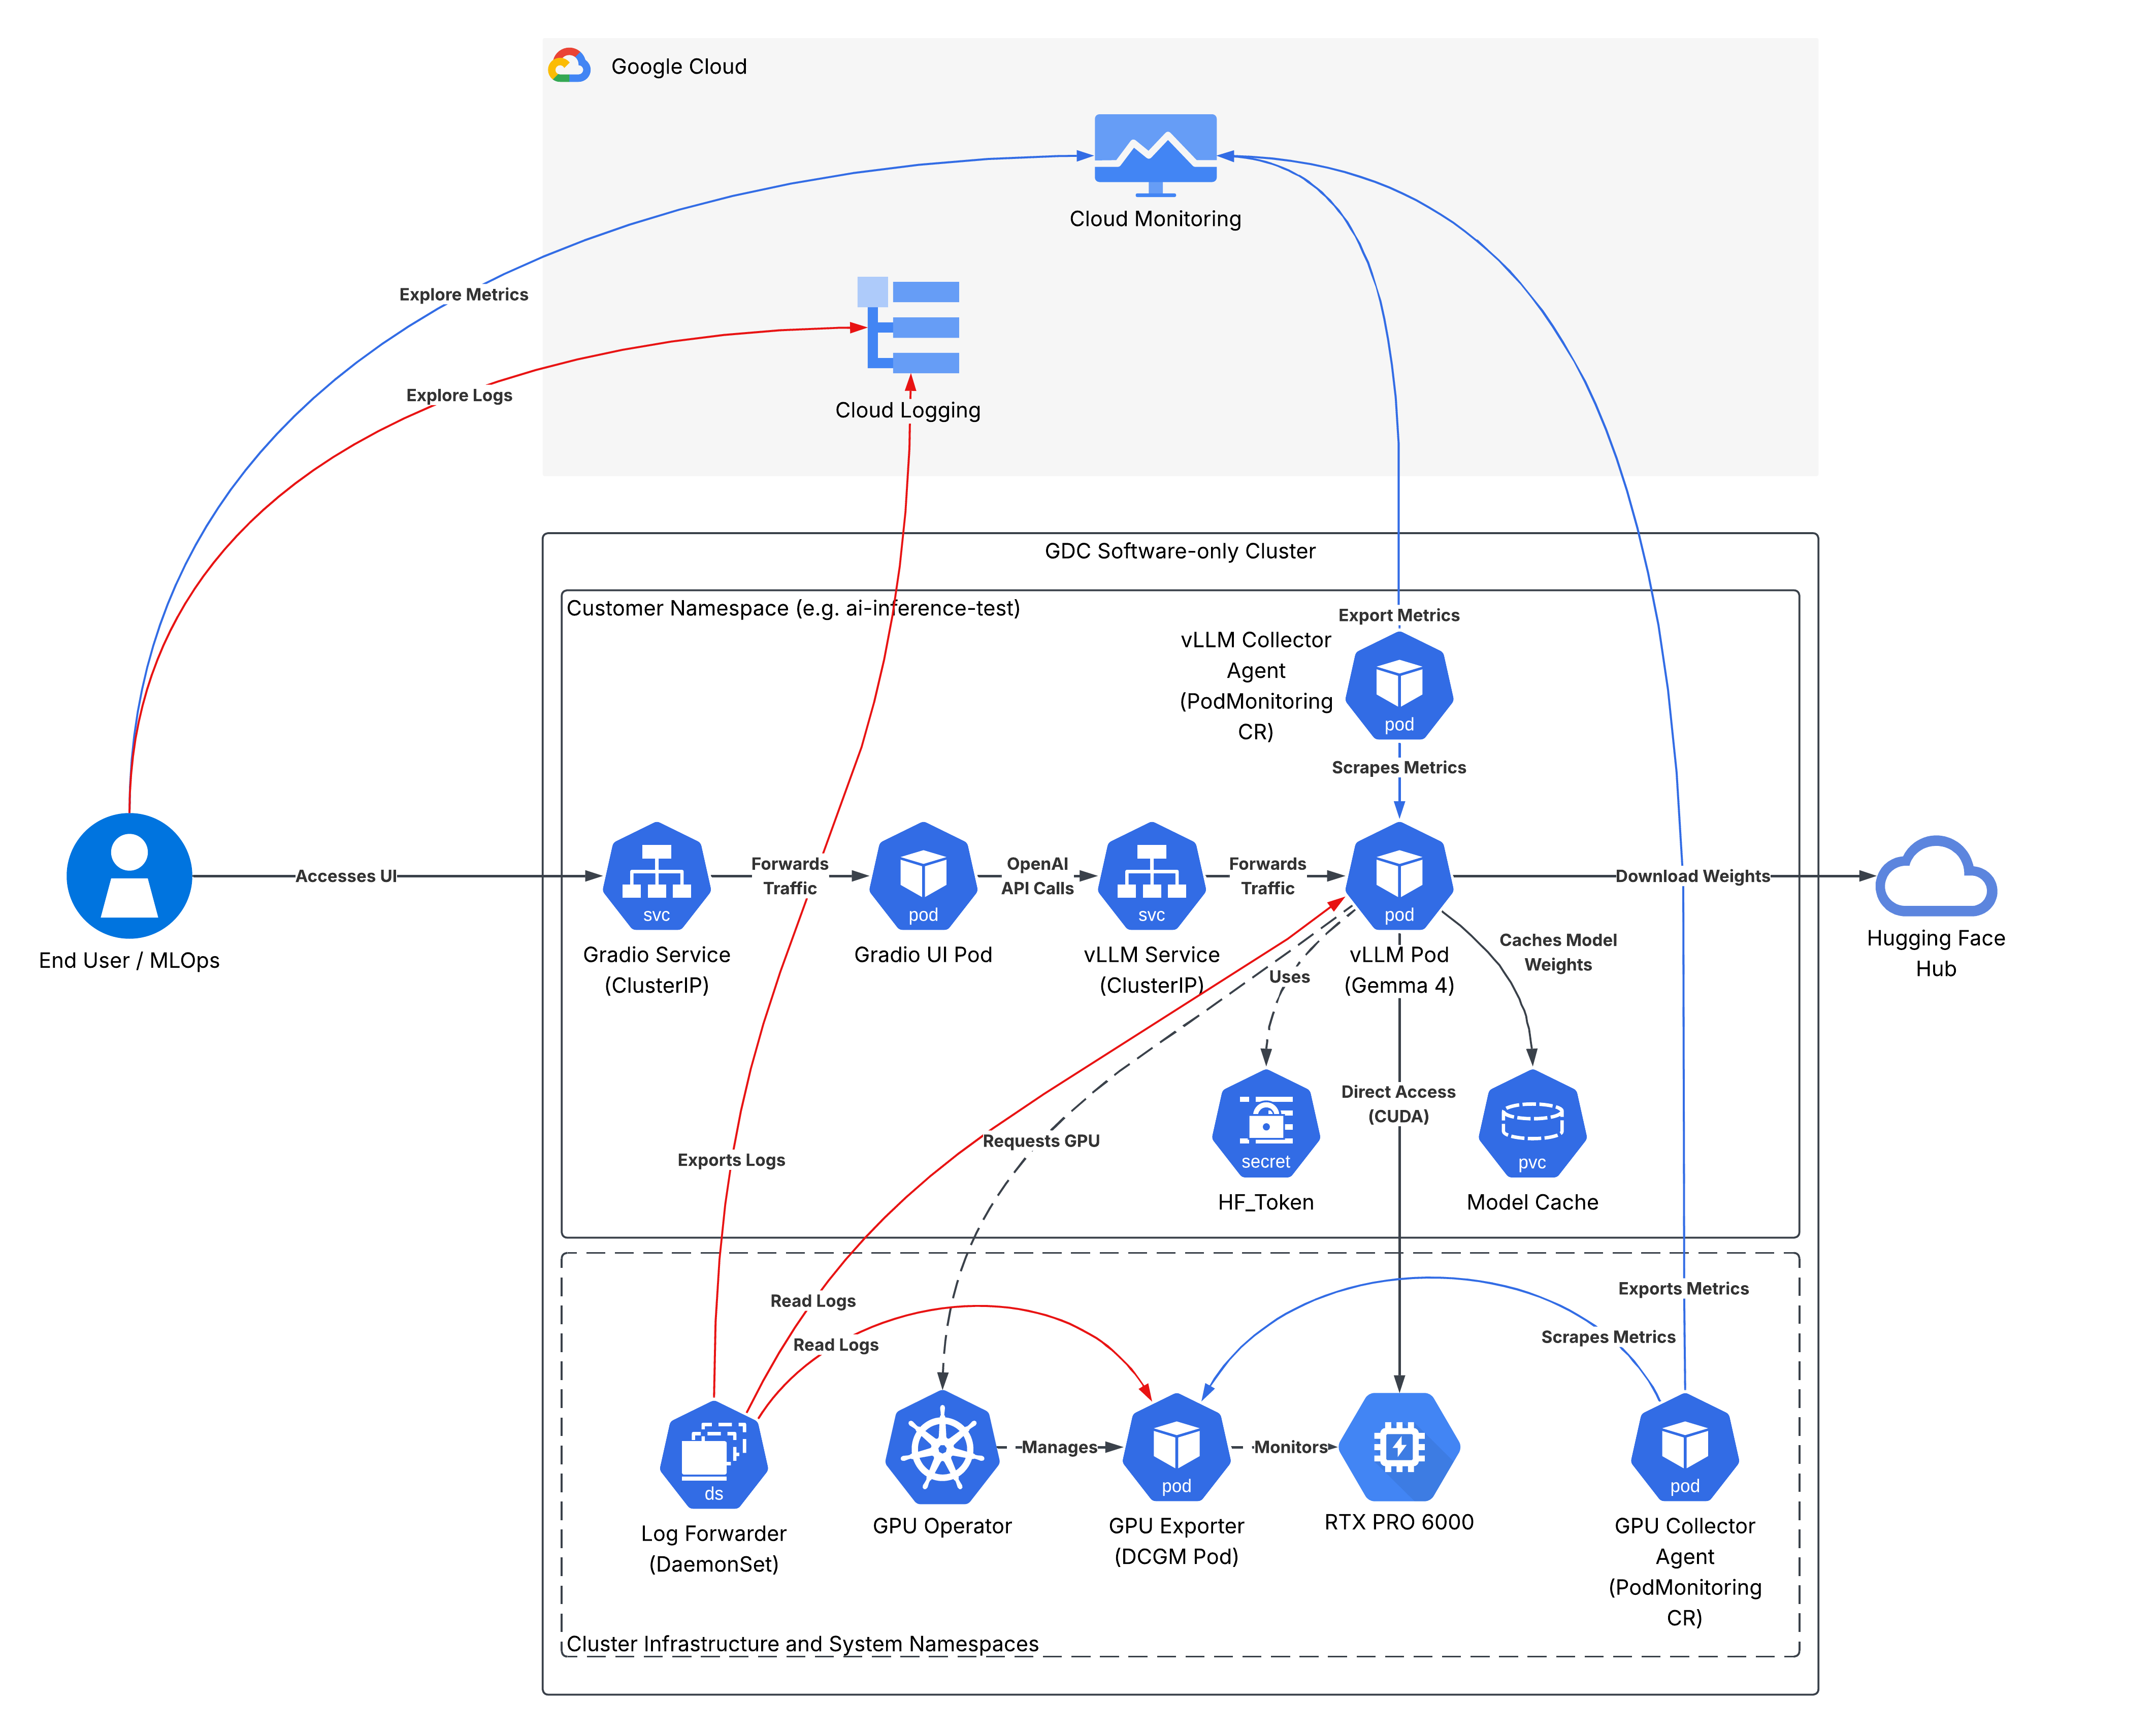
Contraintes matérielles
La solution est conçue pour le matériel fourni par le client et équipé du GPU NVIDIA RTX PRO 6000 Blackwell.
- Spécifications du GPU : NVIDIA RTX PRO 6000 (Blackwell Server ou Workstation Edition).
- Architecture de la mémoire : 96 Go de VRAM GDDR7 (avec ECC)
- Impact de la sélection du modèle :
- Les 96 Go de VRAM permettent d'exécuter le modèle Gemma 4 31B cible avec une précision BF16 native (occupant environ 62 Go de poids et laissant environ 34 Go de marge de VRAM pour le cache Key-Value (KV)).
- Lorsque la quantification FP8 accélérée par le matériel Blackwell (
--quantization=fp8) est activée, comme configuré dans l'implémentation de référence, la mémoire de poids du modèle est divisée par deux pour atteindre environ 31 Go, ce qui permet d'étendre le cache KV disponible à environ 56,5 Gio (61,728jetons) à--gpu-memory-utilization=0.95et d'activer de grandes fenêtres de contexte ou des tailles de lot simultanées élevées sans rencontrer d'erreurs de mémoire insuffisante (OOM, Out-of-Memory).
Matrice de compatibilité (responsabilités)
| Composant | Géré par | Remarques |
|---|---|---|
| Matériel physique et OS | Client | Matériel fourni par le client (plus précisément, serveur ou station de travail avec GPU NVIDIA RTX PRO 6000 Blackwell). |
| Installation d'un cluster Distributed Cloud (logiciel uniquement) | Client | Vous devez suivre la documentation standard d'installation logicielle uniquement de Distributed Cloud. |
| Pilotes et opérateur de GPU | Client | Installation de l'opérateur GPU NVIDIA et des graphiques Helm. Google n'est pas compatible avec le déploiement de l'opérateur NVIDIA. |
| Fichiers manifestes de diffusion vLLM | Google (solution) | Fourni dans ce guide de solution. |
| Artefacts de modèle | Client | Télécharger et héberger les pondérations du modèle Gemma |
| Interface utilisateur et code d'application Gradio | Client | Couche d'application appartenant au client pour la validation et l'utilisation. |
| Cloud Logging et Cloud Monitoring | Joint | Google fournit l'intégration par défaut, que le client configure. |
Concepts et technologies
Cette section décrit en détail les composants fonctionnels, leurs responsabilités et la façon dont ils communiquent au sein du système. Il identifie les services de base, les unités de stockage de données et les interfaces réseau nécessaires pour prendre en charge le cas d'utilisation cible.
Infrastructure et plate-forme
- GPU NVIDIA RTX PRO 6000 : fournit 96 Go de VRAM GDDR7. Le GPU physique est entièrement dédié à l'instance de mise en service du modèle. Le partitionnement GPU (MIG) n'est pas activé pour garantir que le modèle dispose d'un accès exclusif à l'intégralité de la VRAM et de la bande passante mémoire, ce qui évite la contention des ressources.
- Opérateur GPU NVIDIA : opérateur géré par le client qui orchestre et expose les ressources de GPU physiques aux nœuds de calcul Kubernetes du logiciel Distributed Cloud uniquement.
- Stockage local au nœud (revendication de volume persistant) : stockage local au nœud, basé sur le logiciel Distributed Cloud uniquement, pour héberger et conserver les pondérations du modèle sur le nœud. Cela garantit que les pondérations du modèle sont conservées localement une fois téléchargées. Les redémarrages ou mises à jour ultérieurs des pods chargent les pondérations à partir de ce cache local, ce qui réduit le temps de démarrage et protège contre les pannes du réseau étendu.
- Segment de mémoire partagée (
/dev/shm) : un volumeemptyDiravecmedium: Memoryest monté sur/dev/shmet 16 Gio lui sont alloués pour éviter les erreurs de segmentation lors des opérations de tenseur à forte concurrence dans vLLM.
Services et logique
- Moteur de diffusion vLLM : déployé en tant que déploiement Kubernetes exécutant le conteneur vLLM qualifié Vertex AI, exposé via un service
ClusterIP(port 8000). Voici les principaux paramètres de configuration :--model: chemin d'accès ou ID du modèle Gemma (par exemple,google/gemma-4-31B-it).--tensor-parallel-size: défini sur1(contrainte de GPU unique).--dtype: définissez surbfloat16pour exploiter la précision native du matériel pour les activations et les couches non quantifiées.--quantization: défini surfp8dans l'implémentation de référence pour exploiter la quantification des poids Blackwell FP8 (environ 31 Go de poids, environ 56,5 Gio de cache KV), ou omis si le format BF16 non quantifié (environ 62 Go de poids, environ 34 Go de cache KV) est préféré.
- Interface utilisateur Web Gradio : déployée en tant que déploiement Kubernetes fournissant une interface de chat pour la validation, exposée via un service
ClusterIP(port 8080). Il se connecte au service vLLM pour l'interaction avec les requêtes et les réponses.
Observabilité et intégration Google Cloud
- Cloud Logging : utilise uniquement les agents de journalisation du logiciel Distributed Cloud par défaut pour capturer et transférer automatiquement les journaux de conteneurs (journaux d'application vLLM et diagnostics GPU) vers Cloud Logging.
- Cloud Monitoring (PodMonitoring) : les ressources Google Cloud Managed Service pour Prometheus (GMP) ciblent à la fois le pod vLLM (pour la télémétrie de diffusion, comme le débit de jetons et l'utilisation du cache KV) et le pod d'exportateur GPU (pour la télémétrie GPU), en exportant les métriques vers Cloud Monitoring.
Remarques
Évolutivité et performances
- Dédicace du GPU : le GPU NVIDIA RTX PRO 6000 est entièrement dédié au conteneur vLLM. Le partage du GPU via MIG ou le découpage temporel ne sont pas implémentés dans cette architecture pour garantir une latence d'inférence prévisible et éviter les erreurs de mémoire insuffisante. Le modèle Gemma 4 31B nécessite également la majeure partie de la capacité de la VRAM pour les pondérations du modèle (~62 Go), ce qui ne laisse pas beaucoup de mémoire pour que d'autres modèles s'exécutent simultanément.
- Stratégie de déploiement : appliquée en tant que
Recreate. Comme nous n'avons qu'un seul GPU, nous ne pouvons pas exécuter deux instances du pod vLLM simultanément lors d'une mise à jour. L'ancien pod doit être arrêté pour libérer le verrouillage du GPU avant que le nouveau pod puisse démarrer.
Gestion des ressources
- Marge de mémoire VRAM : alors que le GPU NVIDIA RTX PRO 6000 de 96 Go convient au modèle Gemma 4 31B avec une précision BF16 non quantifiée (~62 Go pour les poids, ce qui laisse ~34 Go pour le cache KV), le déploiement de référence permet la quantification Blackwell FP8 (
--quantization=fp8) pour réduire la mémoire de poids à ~31 Go et étendre le cache KV disponible à ~56,5 Gio (61,728jetons simultanés). - Taille du cache KV : la SRA suppose l'allocation vLLM par défaut (
--gpu-memory-utilization=0.95), qui maximise l'utilisation de la VRAM pour le moteur.
Disponibilité et fiabilité
- Cache Warmth : l'utilisation de volumes persistants locaux aux nœuds est essentielle. Si le nœud redémarre, les pondérations mises en cache dans le répertoire hôte sont réutilisées.
- Mise en cache des images : l'image de conteneur vLLM étant volumineuse (> 10 Go), il est recommandé de définir
imagePullPolicy: IfNotPresentpour éviter les délais d'extraction du registre lors du redémarrage du pod.
Complexité opérationnelle
- Visibilité dans la console : contrairement à GKE, le logiciel Distributed Cloud uniquement n'est pas compatible avec la vue "Modèles d'IA/ML" basée sur la console. Toutes les validations et surveillances doivent être effectuées via l'CLI
kubectl, le transfert de port et les tableaux de bord Cloud Monitoring directs.
Décision de conception
Moteur d'inférence : vLLM vs Triton vs Ollama
- Option sélectionnée : vLLM
- Justification : vLLM offre les meilleures performances prêtes à l'emploi pour les LLM via PagedAttention, est compatible avec l'API OpenAI et dispose d'images de conteneurs préqualifiées de Vertex AI.
- Alternatives refusées :
- Triton : trop complexe à configurer et à compiler pour un déploiement Edge à modèle unique.
- Ollama : il ne dispose pas des points de terminaison de télémétrie avancée ni du réglage précis de la simultanéité requis pour la surveillance de la production.
Chemin de télémétrie : GMP natif ou Prometheus local
Option sélectionnée : GMP natif (PodMonitoring)
- Justification : Le logiciel Distributed Cloud n'est compatible qu'avec l'intégration native à Cloud Monitoring. Nous pouvons acheminer les métriques directement versGoogle Cloud à l'aide de Managed Prometheus, ce qui réduit la surcharge opérationnelle sur le cluster.
- Alternatives refusées :
- Pile Prometheus et Grafana locale : refusée pour minimiser l'utilisation des ressources du plan de contrôle sur le cluster à nœud unique.
Hypothèses et limites
Hypothèses
- Disponibilité de l'opérateur GPU : nous partons du principe que le client a installé l'opérateur GPU NVIDIA et configuré la
nvidiaRuntimeClass avant de déployer cette solution. - Accès Hugging Face : le déploiement nécessite un jeton Hugging Face valide avec accès au dépôt Gemma 4 restreint, stocké en tant que secret Kubernetes.
- Chemin réseau : le cluster doit avoir accès à Internet (ou à un proxy interne) pour télécharger l'image de conteneur et les pondérations du modèle lors de la configuration initiale.
Limites
- Limite d'un seul GPU : l'architecture de la phase 1 est limitée par la capacité physique d'un seul GPU NVIDIA RTX PRO 6000. Les modèles de plus de 31 milliards de paramètres (ou les charges de travail à forte simultanéité nécessitant un parallélisme tensoriel multi-GPU) ne sont pas compatibles avec la phase 1.
- Pas de mises à jour progressives : la stratégie
Recreateimplique une indisponibilité temporaire du service lors des mises à jour de modèle ou des modifications de configuration, car le GPU ne peut pas être partagé entre les anciens et les nouveaux pods. - Exclusion du réglage des performances : conformément au champ d'application du projet, les optimisations au niveau des nœuds (épinglage du processeur, hugepages,
PerformanceTuningProfile) sont exclues de cette architecture.