

Descripción general
En esta Arquitectura de referencia de la solución (SRA), se definen el diseño conceptual, la topología de los componentes y los límites técnicos para alojar, entregar y validar modelos de lenguaje grandes (LLM) de código abierto en clústeres independientes solo de software de Distributed Cloud.
Los entornos perimetrales empresariales suelen requerir inferencia de baja latencia y una estricta soberanía de los datos. Esta arquitectura de referencia de la solución proporciona una pila de entrega estandarizada, segura y observable para implementar el modelo Gemma 4 31B en un clúster de software de Distributed Cloud de un solo nodo equipado con una GPU NVIDIA RTX PRO 6000 (96 GB de VRAM) proporcionada por el cliente.
Características y funciones
- Publicación de modelos locales: Expone una API compatible con OpenAI y estándar de la industria de forma local dentro del límite del clúster solo de software de Distributed Cloud.
- Compatibilidad con modelos perimetrales grandes: Se optimizó para ejecutar Gemma 4 31B en precisión nativa (BF16) o formatos cuantizados, y utiliza por completo la capacidad de VRAM de 96 GB.
- Observabilidad: Se integra con la infraestructura de supervisión del software de Distributed Cloud únicamente (Google Cloud Managed Service para Prometheus) a través de recursos
PodMonitoringnativos para exportar la telemetría de la GPU y las métricas de rendimiento de vLLM, lo que evita la necesidad de un servidor de Prometheus local independiente. - Validación interactiva: Implementa una interfaz web basada en Gradio para la verificación visual inmediata de la capacidad de respuesta del modelo.
Principios de arquitectura
- Simplicidad y portabilidad: Se estandariza en construcciones nativas de Kubernetes (Deployment, Service) en lugar de operadores de servicio complejos, lo que garantiza la facilidad de implementación y mantenimiento en configuraciones de un solo nodo.
- Soberanía de los datos: Todo el tráfico de inferencia y los datos de instrucciones y respuestas permanecen estrictamente dentro del límite del clúster local.
- Aislamiento de recursos: Dedica el acelerador de GPU físico a una sola instancia de entrega de modelos para evitar la contención de recursos y garantizar una latencia predecible.
Arquitectura y diseño
Componentes
Los componentes de la solución son los siguientes:
- Espacio de nombres del cliente (solo clúster de software de Distributed Cloud):
- Motor de servicio de vLLM: Se implementa como una implementación de Kubernetes que ejecuta el contenedor de vLLM. Se configuró para cargar pesos de Gemma desde el almacenamiento persistente y exponer una API compatible con OpenAI.
- IU web de Gradio: Se implementa como una implementación de Kubernetes que proporciona la interfaz de chat para la verificación (opcional: también se puede ejecutar de forma externa en una estación de trabajo del desarrollador o en un entorno de ejecución de prueba conectado al servicio de vLLM del clúster).
- Persistent Volume Claim (PVC): Está respaldada por el almacenamiento compartido local solo del software de Distributed Cloud (con la StorageClass
local-shared) para alojar los pesos del modelo. - Servicios de Kubernetes: Servicio ClusterIP para el extremo de API de vLLM; servicio NodePort o LoadBalancer para la IU de Gradio para exponerla a la red del cliente.
- Infraestructura (administrada por el cliente):
- Operador de GPU de NVIDIA: Coordina y expone los recursos de GPU física solo a los nodos de trabajo de Kubernetes del software de Distributed Cloud.
- GPU NVIDIA RTX PRO 6000: Es el acelerador físico subyacente (arquitectura de memoria GDDR7 de 96 GB).
- Integración en Google Cloud:
- Google Cloud Monitoring & Logging: Agentes predeterminados solo de software de Distributed Cloud que recopilan y reenvían registros del sistema, registros de contenedores y métricas básicas aGoogle Cloud.
Descripción general de la arquitectura de alto nivel
En el siguiente diagrama, se ilustra el flujo de solicitudes y las interacciones de los componentes dentro del clúster de solo software de Distributed Cloud:
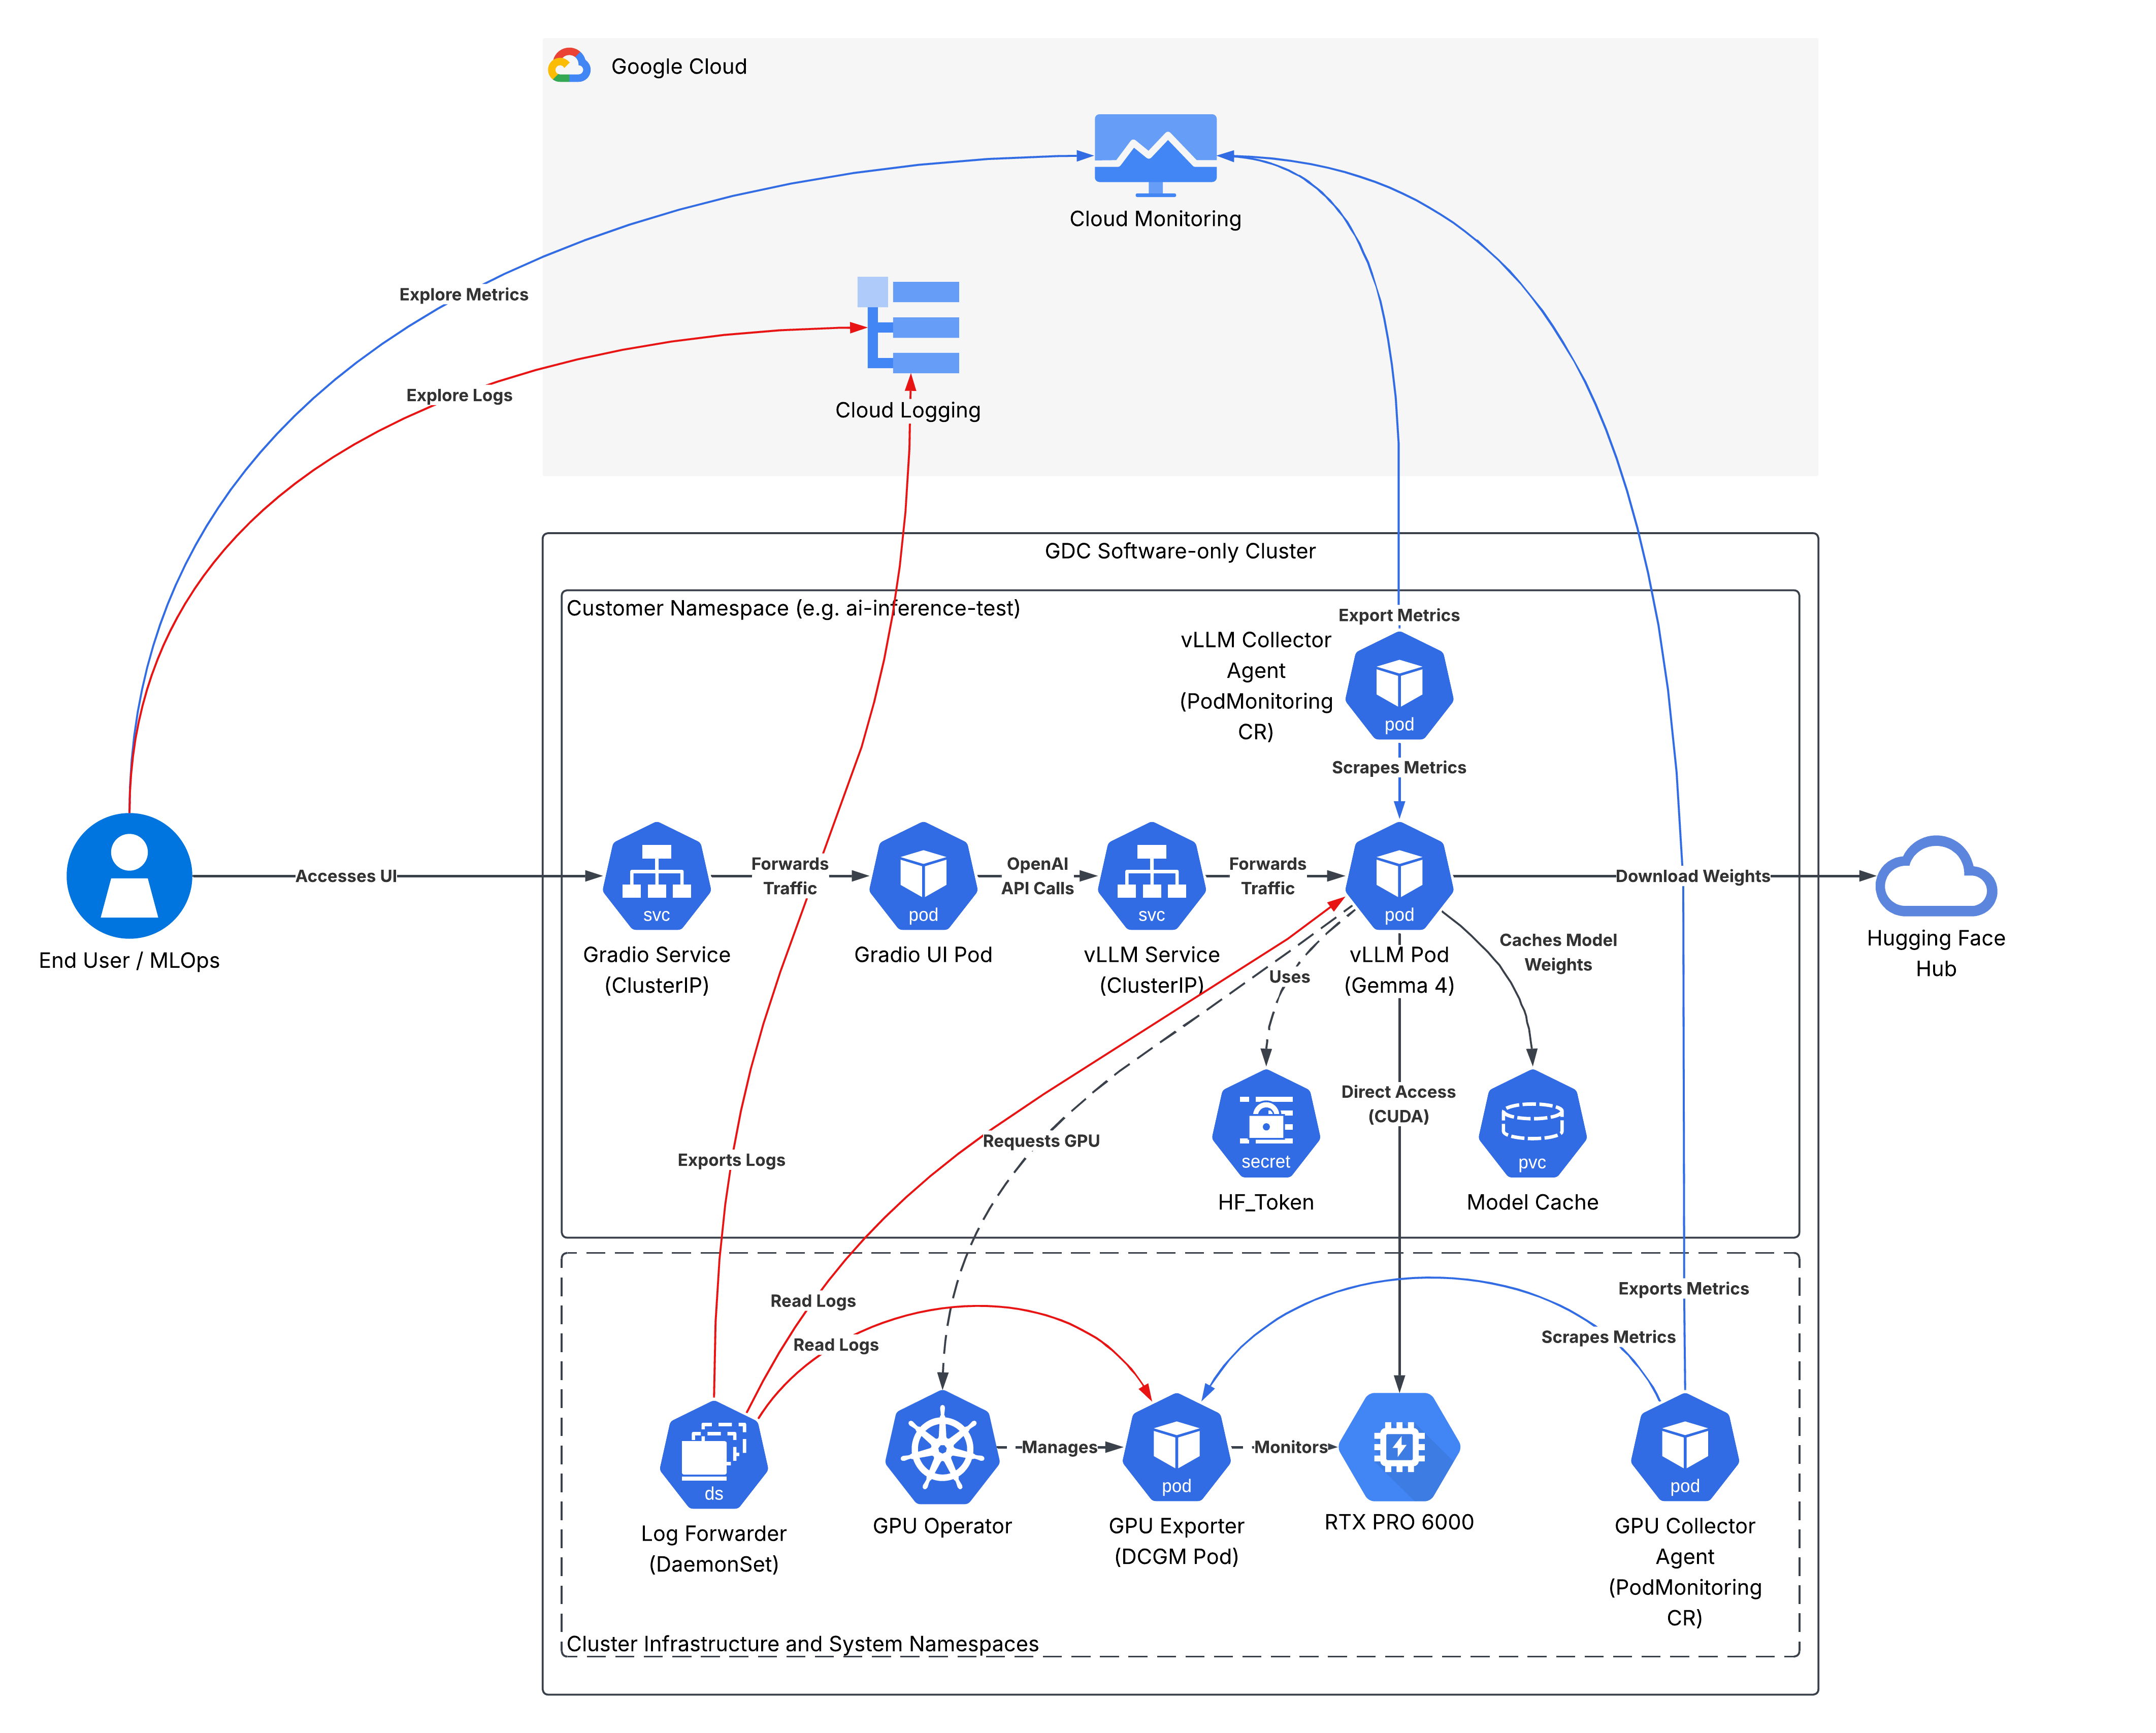
Restricciones de hardware
La solución está diseñada para hardware de origen del cliente equipado con la GPU NVIDIA RTX PRO 6000 Blackwell.
- Especificación de la GPU: NVIDIA RTX PRO 6000 (Blackwell Server o Workstation Edition).
- Arquitectura de memoria: 96 GB de VRAM GDDR7 (con ECC)
- Impacto de la selección del modelo:
- Los 96 GB de VRAM permiten ejecutar el modelo objetivo Gemma 4 31B en precisión BF16 nativa (ocupa alrededor de 62 GB de pesos y deja alrededor de 34 GB de margen de VRAM para la caché de clave-valor [KV]).
- Cuando se habilita la cuantificación FP8 acelerada por hardware de Blackwell (
--quantization=fp8), tal como se configura en la implementación de referencia, la memoria de peso del modelo se reduce a la mitad, hasta alcanzar aproximadamente 31 GB, lo que expande la caché de KV disponible a aproximadamente 56.5 GiB (tokens de61,728) en--gpu-memory-utilization=0.95y permite grandes ventanas de contexto o tamaños de lote simultáneos altos sin encontrar errores de memoria insuficiente (OOM).
Matriz de compatibilidad (responsabilidades)
| Componente | Administrado por | Notas |
|---|---|---|
| Hardware y SO físicos | Cliente | Hardware de origen del cliente (específicamente, servidor o estación de trabajo con GPU NVIDIA RTX PRO 6000 Blackwell) |
| Instalación de clúster solo con software de Distributed Cloud | Cliente | Debe seguir la documentación estándar de instalación de solo software de Distributed Cloud. |
| Controladores y operador de GPU | Cliente | Instalación del operador de GPU de NVIDIA y de los gráficos de Helm Google no admite la implementación del operador de NVIDIA. |
| Manifiestos de publicación de vLLM | Google (solución) | Se proporciona como parte de esta guía de soluciones. |
| Artefactos del modelo | Cliente | Descarga y aloja los pesos del modelo de Gemma. |
| IU de Gradio y código de la app | Cliente | Capa de aplicación propiedad del cliente para la validación y el uso. |
| Cloud Logging y Cloud Monitoring | Articulación | Google proporciona la integración predeterminada, y el cliente la configura. |
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales, sus responsabilidades y cómo se comunican dentro del sistema. Identifica los servicios principales, las unidades de almacenamiento de datos y las interfaces de redes necesarios para admitir el caso de uso objetivo.
Infraestructura y plataforma
- GPU NVIDIA RTX PRO 6000: Proporciona 96 GB de VRAM GDDR7. La GPU física se dedica por completo a la instancia de entrega de modelos. La partición de GPU (MIG) no está habilitada para garantizar que el modelo tenga acceso exclusivo a toda la VRAM y al ancho de banda de la memoria, lo que evita la contención de recursos.
- Operador de GPU de NVIDIA: Es un operador administrado por el cliente que organiza y expone los recursos físicos de la GPU solo a los nodos de trabajo de Kubernetes del software de Distributed Cloud.
- Almacenamiento local del nodo (reclamo de volumen persistente): Se respalda con almacenamiento local del nodo solo de software de Distributed Cloud para alojar y conservar los pesos del modelo en el nodo. Esto garantiza que, una vez que se descargan los pesos del modelo, se conserven de forma local. Los reinicios o las actualizaciones posteriores de los pods cargan pesos desde esta caché local, lo que reduce el tiempo de inicio y protege contra las interrupciones de la WAN.
- Segmento de memoria compartida (
/dev/shm): Se monta un volumenemptyDirconmedium: Memoryen/dev/shmy se le asignan 16 GiB para evitar errores de segmentación durante las operaciones de tensores de alta simultaneidad en vLLM.
Servicios y lógica
- Motor de entrega de vLLM: Se implementa como una implementación de Kubernetes que ejecuta el contenedor de vLLM calificado para Vertex AI y se expone a través de un servicio
ClusterIP(puerto 8000). Entre los parámetros de configuración clave, se incluyen los siguientes:--model: Es la ruta de acceso o el ID del modelo de Gemma (p.ej.,google/gemma-4-31B-it).--tensor-parallel-size: Se establece en1(restricción de una sola GPU).--dtype: Se establece enbfloat16para aprovechar la precisión nativa del hardware en las capas y activaciones no cuantificadas.--quantization: Se establece enfp8en la implementación de referencia para aprovechar la cuantificación de peso FP8 de Blackwell (pesos de ~31 GB, caché de KV de ~56.5 GiB) o se omite si se prefiere BF16 sin cuantificar (pesos de ~62 GB, caché de KV de ~34 GB).
- IU web de Gradio: Se implementa como un recurso Deployment de Kubernetes que proporciona una interfaz de chat para la validación, expuesta a través de un servicio
ClusterIP(puerto 8080). Se conecta al servicio de vLLM para la interacción de instrucciones y respuestas.
Observabilidad e Google Cloud integración
- Cloud Logging: Utiliza solo los agentes de registro predeterminados del software de Distributed Cloud para capturar y reenviar automáticamente los registros de contenedores (registros de aplicaciones de vLLM y diagnósticos de GPU) a Cloud Logging.
- Cloud Monitoring (PodMonitoring): Los recursos de Google Cloud Managed Service para Prometheus (GMP) segmentan el pod de vLLM (para la telemetría de servicio, como la capacidad de procesamiento de tokens y el uso de la caché de KV) y el pod del exportador de GPU (para la telemetría de GPU), y exportan las métricas a Cloud Monitoring.
Consideraciones
Escalabilidad y rendimiento
- Dedicación de la GPU: La GPU NVIDIA RTX PRO 6000 está dedicada por completo al contenedor de vLLM. En esta arquitectura, no se implementa el uso compartido de la GPU a través de MIG o segmentación de tiempo para garantizar una latencia de inferencia predecible y evitar errores de OOM. El modelo Gemma 4 31B también requiere la mayor parte de la capacidad de VRAM para los pesos del modelo (~62 GB), lo que no deja mucha memoria para que otros modelos se ejecuten de forma simultánea.
- Estrategia de implementación: Se aplica como
Recreate. Como solo tenemos una GPU, no podemos ejecutar dos instancias del pod de vLLM de forma simultánea durante una actualización. El pod anterior debe finalizarse para liberar el bloqueo de la GPU antes de que se pueda iniciar el pod nuevo.
Administración de recursos
- Espacio libre de VRAM: Si bien la NVIDIA RTX PRO 6000 de 96 GB se ajusta al modelo Gemma 4 31B con una precisión BF16 sin cuantificar (~62 GB para los pesos, lo que deja ~34 GB para la caché de KV), la implementación de referencia habilita la cuantificación FP8 de Blackwell (
--quantization=fp8) para reducir la memoria de peso a ~31 GB y expandir la caché de KV disponible a ~56.5 GiB (61,728tokens simultáneos). - Tamaño de la caché de KV: La SRA supone la asignación predeterminada de vLLM (
--gpu-memory-utilization=0.95), lo que maximiza el uso de la VRAM para el motor.
Disponibilidad y confiabilidad
- Cache Warmth: El uso de PV locales al nodo es fundamental. Si se reinicia el nodo, se reutilizan los pesos almacenados en caché en el directorio del host.
- Almacenamiento en caché de imágenes: Debido a que la imagen del contenedor de vLLM es grande (más de 10 GB), se recomienda establecer
imagePullPolicy: IfNotPresentpara evitar retrasos en la extracción del registro cuando se reinicie el Pod.
Complejidad operativa
- Visibilidad de la consola: A diferencia de GKE, el software de Distributed Cloud solo admite la vista "Modelos de IA/ML" basada en la consola. Toda la validación y la supervisión se deben realizar a través de la CLI de
kubectl, el reenvío de puertos y los paneles directos de Cloud Monitoring.
Decisión de diseño
Motor de inferencia: vLLM en comparación con Triton y Ollama
- Opción seleccionada: vLLM
- Justificación: vLLM ofrece el mejor rendimiento listo para usar para los LLM a través de PagedAttention, admite la paridad de la API de OpenAI y tiene imágenes de contenedor precalificadas de Vertex AI.
- Alternativas rechazadas:
- Triton: Es demasiado complejo de configurar y compilar para una implementación de borde de un solo modelo.
- Ollama: No tiene los extremos de telemetría avanzados ni el ajuste de simultaneidad detallado que se requieren para la supervisión de producción.
Ruta de telemetría: Comparación entre GMP nativo y Prometheus local
Opción seleccionada: GMP nativa (PodMonitoring)
- Justificación: El software de Distributed Cloud solo admite la integración nativa con Cloud Monitoring. Podemos enrutar las métricas directamente aGoogle Cloud con Prometheus administrado, lo que reduce la sobrecarga operativa en el clúster.
- Alternativas rechazadas:
- Pila local de Prometheus y Grafana: Se rechazó para minimizar el uso de recursos del plano de control en el clúster de un solo nodo.
Supuestos y limitaciones
Suposiciones
- Disponibilidad del operador de GPU: Se supone que el cliente instaló correctamente el operador de GPU de NVIDIA y configuró el
nvidiaRuntimeClass antes de implementar esta solución. - Acceso a Hugging Face: La implementación requiere un token de Hugging Face válido con acceso al repositorio restringido de Gemma 4, almacenado como un Secret de Kubernetes.
- Ruta de acceso a la red: El clúster debe tener acceso a Internet (o un proxy interno) para descargar la imagen del contenedor y los pesos del modelo durante la configuración inicial.
Limitaciones
- Límite de una sola GPU: La arquitectura de la fase 1 está limitada por la capacidad física de una sola GPU NVIDIA RTX PRO 6000. En la fase 1, no se admiten modelos de más de 31 mil millones de parámetros (~31B) ni cargas de trabajo de alta simultaneidad que requieran paralelismo de tensor con varias GPU.
- Sin actualizaciones progresivas: La estrategia
Recreateimplica un tiempo de inactividad temporal del servicio durante las actualizaciones del modelo o los cambios de configuración, ya que la GPU no se puede compartir entre los pods antiguos y los nuevos. - Ajuste del rendimiento excluido: De acuerdo con el alcance del proyecto, las optimizaciones a nivel del nodo (fijación de CPU, páginas enormes,
PerformanceTuningProfile) se excluyen de esta arquitectura.