


בעזרת Knowledge Catalog אתם יכולים לאחד מטא-נתונים טכניים וסמנטיקה עסקית בנתונים מובְנים ולא מובְנים, באמצעות יכולות מבוססות-Gemini. אחר כך תוכלו להשתמש בתרשים ההקשר שנוצר כדי לגלות נכסים, לאמת את איכות הנתונים ולבסס אפליקציות של AI גנרטיבי כדי לצמצם הזיות.
המסמך מיועד למהנדסי נתונים והקשר, למדעני נתונים, למנהלי מידע ארגוני ולמפתחי AI. המדריך מניח שאתם מכירים מערכות של מסדי נתונים ואחסון, כמו BigQuery או Cloud Storage, ושיש לכם הבנה בסיסית במושגים של AI גנרטיבי, כמו יצירת נתונים משולבת באחזור (RAG) או Model Context Protocol (MCP).
בסרטון הבא תוכלו לראות הדרכה מפורטת על Knowledge Catalog:
פתרון למורכבות של נתונים ספציפיים לתחום
בארגונים מודרניים, הנתונים מורכבים, מבוזרים מאוד וקיימים בפורמטים מובְנים ולא מובְנים. בקשות עסקיות ממופות לעיתים רחוקות לסכימה אחת של מסד נתונים או למאגר מסמכים אחד. האתגר התפעולי הגדול הוא לשלב את המאגרים האלה בצורה מאובטחת, ובו-זמנית לספק תשובות מיידיות ומהימנות לשאלות שחוצות תחומים.
Knowledge Catalog משמש כבסיס הסמנטי שמגשר על הפער הזה, ומאפשר לסוכני AI ולכלי ניתוח לאחזר הקשר מבוסס ורלוונטי.
תפקידי משתמשים מרכזיים
מהנדסי הקשר (מהנדסי נתונים). אוטומציה של צבירת מטא-נתונים במסדי נתונים וב-Cloud Storage, מעקב אחרי טרנספורמציות באמצעות שושלת נתונים, ויצירת תהליכי עבודה להעשרה ולהערכה.
מנהלי נתונים (צוותי משילות). לפקח על איכות המטא-נתונים באמצעות בדיקות של האדם שבתהליך לתיאורים שנוצרו על ידי AI, ליצור סטנדרטיזציה של אוצר המילים העסקי באמצעות מילוני מונחים ולהגדיר היבטים בהתאמה אישית כדי לצרף הקשר ספציפי לדומיין לרשומות בקטלוג.
מפתחי AI. התבססות של מודלי LLM ואפליקציות AI על סכימות נתונים מהימנות של הארגון באמצעות שרתי MCP או ממשקי API לאחזור הקשר.
תרחישי שימוש בתחומים שונים
בטבלה הבאה מוצגות השאלות המורכבות שעולות בפועל, איך הן חוצות גבולות טכניים ואיך Knowledge Catalog עוזר לארגונים להתמודד איתן:
| ענף | אתגרים תפעוליים ואתגרים שקשורים לנתונים | הבעיה העסקית שצריך לפתור | איך Knowledge Catalog מטפל בזה |
|---|---|---|---|
| מסחר אלקטרוני |
|
"מצא מוצרי אלקטרוניקה עם שיעורי החזרה גבוהים ותמונות של לקוחות שמראות סימני נזק כשהמוצר הגיע". | ביסוס סמנטי בפורמטים שונים של נתונים: המערכת מגלה באופן אוטומטי מטא-נתונים ממסדי נתונים של טרנזקציות ומקשרת אותם לתמונות לא מובנות בקטגוריות אחסון ב-Cloud Storage, וכך מאפשרת לכלי AI לפתור את השאילתה במערכות אחסון שונות. |
| ייצור |
|
"צור סיכומים של כל דוחות הבדיקה שקשורים למכונות באזור המערבי שנכשלו בבדיקות הבטיחות ברבעון האחרון". | סריקה אזורית ולא מובנית: סריקה וקטלוג של דוחות בדיקה לא מובנים בפורמט PDF לצד מטא-נתונים של נכסים, שמאפשרים לסוכני AI גנרטיבי לאתר, לאסוף ולסכם דוחות לפי אזור. |
| שירותי בריאות |
|
"אילו מטופלים נמצאים בסיכון הגבוה ביותר לאשפוז חוזר תוך 30 יום, בהתבסס על המדדים החיוניים האחרונים שנבדקו במעבדה ועל תדירות הפגישות?" | איכות הנתונים והשושלת שלהם: חישוב פרופילים של איכות הנתונים ברמת השורה ומפות שושלת בפידים של סיכום מצב בריאותי אלקטרוני, כדי לוודא שמודלים קליניים של חיזוי מסתמכים רק על מדדים חיוניים מאומתים ואיכותיים של המטופלים. |
| שירותים פיננסיים |
|
"אילו 10 לקוחות שמניבים הכי הרבה הכנסות התלוננו על 'בעיות בביצועים', ואיך זה משפיע על התחזיות לרבעון השלישי?" | תרשים הקשר מאוחד: מאחד רשומות של לקוחות, משוב על התמיכה וטבלאות פיננסיות, ומאפשר לשאילתות בשפה טבעית לשלב נתונים סטטיסטיים של הכנסות מלקוחות עם קובצי משוב לא מובנים כדי לחזות את ההשפעה הפיננסית. |
כדי להתמודד עם האתגרים התפעוליים האלה, Knowledge Catalog מספק יכולות מרכזיות שעוזרות למהנדסי מערכות מידע, למדעני נתונים ולמפתחי AI לפתח מערכות נתונים מנוהלות:
איך מבססים סוכני AI באמצעות Model Context Protocol (MCP) אתם יכולים לחשוף מטא-נתונים, סכימות, שושלת נתונים וכללים עסקיים ישירות לסוכני AI באמצעות שרתי MCP מקומיים או מרוחקים. השרתים האלה מאפשרים למודלים לאמת את הציפיות התפעוליות לפני שהם מציעים פעולות.
האצת הגילוי של AI וניתוח נתונים. חיפוש נכסי נתונים רלוונטיים באמצעות חיפוש סמנטי בשפה טבעית. סיכומים והמלצות שנוצרים על ידי AI גנרטיבי עוזרים למשתמשים לאתר נתונים בלי לחכות לבדיקות ידניות של מסמכים.
ניהול מוצרי נתונים בקנה מידה נרחב. אריזת אוספים של נכסים עם הסכמי רמת שירות (SLA), חוזים, פרטי בעלות והערות שימוש ליחידות מנוהלות נפרדות לחיפוש ולמינוי.
איך פועל Knowledge Catalog
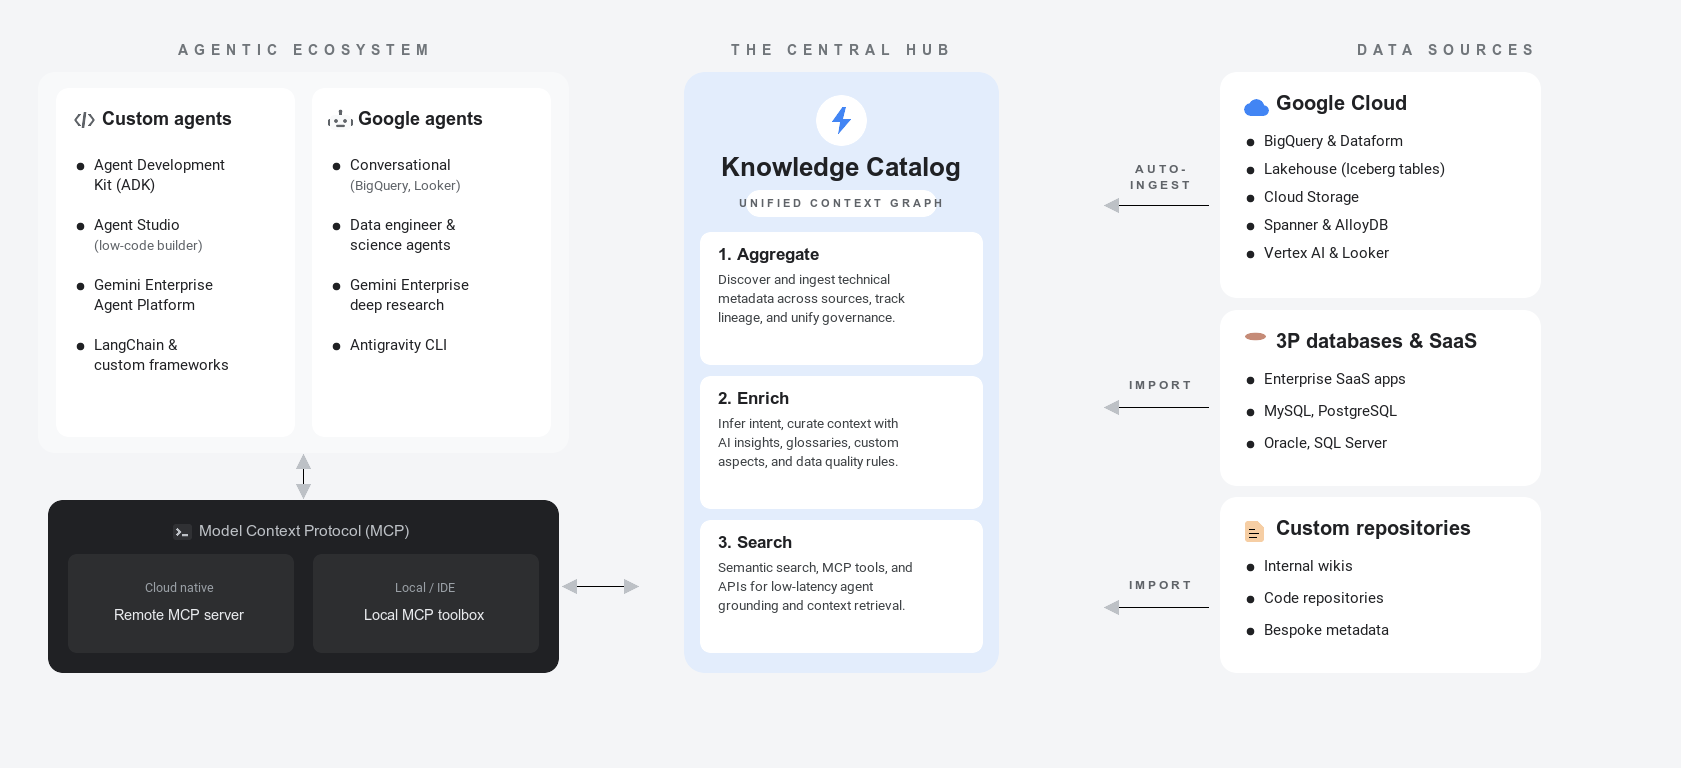
ב-Knowledge Catalog, ניהול הנתונים וההקשר מאוחדים באמצעות מחזור חיים שמורכב משלושה שלבים. הדיאגרמה הבאה ממחישה איך השירות ממפה נכסי נתונים פיזיים לסמנטיקה עסקית לצורך עיגון של סוכן AI:
למידע נוסף על המושגים האלה שקשורים למטא-נתונים, קראו את המאמר מידע על מטא-נתונים.
בקטעים הבאים מתוארים שלושת עמודי התווך של מחזור החיים של המטא-נתונים, ומוסבר איך חברה קמעונאית מיישמת אותם בטבלאות של מסדי נתונים, בקבצים ובערכים בקטלוגים חיצוניים:
צבירה (איתור והטמעה). Knowledge Catalog סורק ומוסיף לאינדקס באופן אוטומטי מטא-נתונים טכניים בכל נכסי הנתונים שלכם, בלי להעביר את הנתונים הבסיסיים:
- מסדי נתונים מובנים. קטלוג אוטומטי מתעד סכימות ומאפיינים בפלטפורמות כמו BigQuery, AlloyDB ל-PostgreSQL ו-Spanner.
- קישוריות מנוהלת. הטמעת הגדרות ממערכות חיצוניות, כמו Oracle או PostgreSQL, או ממרשמים של שותפים, כמו Collibra, בלי לכתוב צינורות עיבוד נתונים בהתאמה אישית.
- שושלת נתונים. מעקב אחרי טרנספורמציות ברמת העמודה בצינורות עיבוד נתונים כדי לראות מאיפה הנתונים מגיעים ואיך הם השתנו.
- דוגמה: חברה קמעונאית מטמיעה באופן אוטומטי מטא-נתונים של מסד נתונים של עסקאות, כמו הטבלאות
ordersו-order_items, ומוסיפה לאינדקס קובצי מוצרים לא מובְנים שמאוחסנים בקטגוריות של Cloud Storage. הם מקשרים מסדי נתונים חיצוניים כדי ליצור אינדקס מטא-נתונים מאוחד בספרייה שניתן לגלות.
מידע נוסף על צבירת מטא-נתונים והטמעת נתונים (לחצו כדי להרחיב)
- מקורות נתונים נתמכים: רשימה של כל מקורות הנתונים הנתמכים של Google Cloud ומקורות חיצוניים להטמעה אוטומטית.
- סקירה כללית של קישוריות מנוהלת: הסבר על הטמעת סכימות טכניות ממערכות חיצוניות.
- מעקב אחרי שושלת נתונים: איך להציג טרנספורמציות של צינור עיבוד נתונים וזרימת נתונים ברמת העמודה.
העשרה (הוספת הקשר ואימות המהימנות). ב-Knowledge Catalog, מבנים טכניים מקבלים משמעות עסקית ונוצרים אותות אמון:
- תובנות שנוצרו על ידי AI. Gemini מנתח את יומני השאילתות כדי ליצור תיאורי עמודות, סיכומי טבלאות והמלצות לצירופים.
- מילוני מונחים והיבטים. מיפוי שמות של מדדים פנימיים לאוצר מילים משותף באמצעות מונחים עסקיים ותבניות לוגיות.
- איכות הנתונים וזיהוי אנומליות. אוכפים הנחיות לניקיון ומריצים סריקות של למידת מכונה כדי לזהות חריגות סטטיסטיות או בעיות בעדכניות הנתונים, וכך יוצרים אותות אמון חשובים.
- בדיקות של ניהול תקין. כדי לנהל את הסיכונים, כדאי להשתמש בתהליכי בדיקה של תהליכי עבודה כדי לאמת את עדכוני המטא-נתונים לפני הפרסום.
- דוגמה: צוות הקמעונאות מעשיר את הנכסים על ידי הפעלת תובנות מנתונים כדי להמליץ על תיאורי עמודות והפעלת כללים לאיכות הנתונים. הם ממפים הגדרות עסקיות להזמנות פעילות על ידי יצירת מילוני מונחים והיבטים.
מידע נוסף על העשרת מטא-נתונים ואימות מהימנות (לחצו כדי להרחיב)
- הגדרת תובנות מנתונים: איך ליצור תיאורים וסיכומים אוטומטיים של מערכי נתונים.
- ניהול מילוני המונחים הארגוניים: איך להתאים אישית מונחים סטנדרטיים ואוצר מילים עסקי.
- העשרת מטא-נתונים באמצעות היבטים: איך לצרף מאפייני מטא-נתונים מובְנים לנכסים לוגיים.
- שימוש חוזר בכללים לאיכות הנתונים: איך מגדירים כללים לאימות מסד נתונים ומשתמשים בהם שוב.
- סקירה כללית של יצירת פרופיל נתונים: איך מגדירים סריקות לאיתור חריגות בסכימה ושינויים סטטיסטיים.
חיפוש ואחזור (גישה ועיגון). אפליקציות AI ומשתמשים עסקיים שולחים שאילתות לתרשים ההקשר המאוחד כדי לגשת לנתונים בצורה בטוחה:
- סוכנים שמבוססים על נתונים. מקשרים את האפליקציות והסוכנים שמבוססים על LLM לקטלוג.
- Context API. לבצע בקשות למטען ייעודי (payload) של ביסוס עם זמן אחזור קצר.
- חיפוש סמנטי. למצוא את הנכסים המתאימים באמצעות שאילתות בשפה טבעית.
- אריזת נתונים. אפשר לאגד אוספים של טבלאות, פרטי רישוי והסכמי SLA לחבילות נתונים מאובטחות בשירות עצמי.
- דוגמה: מנתחי נתונים מבצעים חיפושים סמנטיים בשפה טבעית כדי לאתר נכסים. אפליקציות AI משתמשות באינדקס הזה באופן מאובטח באמצעות שרתי MCP או ה-API לאחזור הקשר, ונכסים באיכות גבוהה נארזים בתצוגה מאובטחת.
מידע נוסף על אחזור הקשר וביסוס הסוכן (לחצו כדי להרחיב)
- סקירה כללית של Model Context Protocol (MCP): הסבר על הגישור בין סוכני AI גנרטיבי ושכבות האפליקציות לבין ההקשר של Knowledge Catalog.
- אחזור הקשר באמצעות LookupContext: מראה איך לחלץ מטען ייעודי (payload) תפעולי מרכזי להנדסת פרומפטים לסוכן.
- חיפוש נכסים: מתאר את יכולות החיפוש של נכסים באמצעות תחביר של שאילתות סמנטיות בשפה טבעית.
Knowledge Catalog ב- Google Cloud ובסביבה העסקית של AI
כשבונים תשתית נתונים, חשוב להבין איך Knowledge Catalog משתלב עם שירותים קשורים.
Google Cloud מסדי נתונים ומודלים
- BigQuery. ב-Knowledge Catalog מתבצעת סריקה ונוצר אינדקס באופן אוטומטי של מערכי נתונים, טבלאות ותצוגות של BigQuery. הוא מפעיל תובנות מנתונים שמבוססות על Gemini כדי לנתח את היסטוריית השאילתות, לפרסם תיאורים ולהציע שאילתות לדוגמה שאומתו.
- Looker (Google Cloud core). Knowledge Catalog מטמיע מרכזי בקרה, Looks ומבני LookML של Looker, כמו תצוגות, חקירות, מאפיינים ומדדים. ההטמעה הזו יוצרת מיפויים של שושלת נתונים כדי לעקוב אחרי האופן שבו ערכים תפעוליים ממופים לסמנטיקה עסקית.
- קטלוג ייעודי לזמן ריצה של Lakehouse. Knowledge Catalog משתלב עם הקטלוג הייעודי לזמן ריצה של Lakehouse, שהוא המטא-מאגר לזמן ריצה של עומסי עבודה ב-Iceberg בקוד פתוח. הוא מוסיף באופן אוטומטי אינדקס למטא-נתונים טכניים על גבי עומסי עבודה של קטלוג ייעודי לזמן ריצה של Lakehouse, כדי לספק Active Context מאוחד.
פלטפורמות ועוזרים אישיים של סוכני AI
- ניתוח נתונים בממשק שיחה. ממשקי ניתוח משתמשים במונחים מהקטלוג ובכלי חיפוש כדי לאפשר למשתמשים לשלוח שאילתות על מדדים עסקיים בשפה טבעית עם ביסוס מאומת.
- Gemini לסוכני AI. סוכני Assistant ברמת דיוק גבוהה משתמשים במטא-נתונים של הקטלוג כדי להריץ חיפושים במסד הנתונים, וכך מפחיתים את ההזיות.
- Gemini Enterprise Agent Platform. Knowledge Catalog משמש כסטנדרט המרכזי למשילות מידע (data governance) בסביבות של פלטפורמות היעד. הוא מקושר ל-Gemini Enterprise Agent Platform כדי להזין כלים והקשר למאגר הסוכנים של הפלטפורמה.
שילוב של מסד נתונים ושירות AI ב-Google Cloud
Knowledge Catalog פועל לצד מוצרים אחרים שלGoogle Cloud כדי ליצור את בסיס הנתונים. בטבלה הבאה מוסבר איך Knowledge Catalog משתלב עם שירותים קשורים ומשלים אותם:
| שירות | תפקיד ראשי | איך הוא משתלב עם Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | פיקוח והקשר של סוכני AI | משמש כתרשים ההקשר הסמנטי המאוחד, מבצע סריקות לבדיקת איכות הנתונים וחושף סכימות מעוגנות בנתונים למודלי AI ולאפליקציות. |
| BigQuery | אחסון נתונים ארגוניים | שומר, שולח שאילתות ומעבד מערכי נתונים; סורק, מוסיף לאינדקס ומעשיר את הטבלאות האלה באופן אוטומטי בהיבטים של סיווג עסקי. |
| פלטפורמת הסוכנים של Gemini Enterprise | פיתוח מודלי AI | מפתחת, פורסת ומארחת מודלים בסיסיים. סוכנים בהתאמה אישית מאחזרים הקשר של מטא-נתונים כדי לבסס חשיבה לוגית. |
| Cloud Storage | אחסון קבצים לא מובנים | מאחסן קבצים גולמיים לא מובְנים, מריץ באופן אוטומטי סריקות לאיתור נתונים לא מובְנים כדי לנתח קובצי PDF ותמונות וליצור מפות קשרים. |
סמנטיקה ופורמטים של נתונים
כדי להנחות מערכות מבוססות-סוכנים ולבסס אותן בצורה יעילה, צריך להבחין בין מבנה הנתונים הפיזי לבין המשמעות הסמנטית:
- סמנטיקה. המשמעות העסקית, הכוונה והקשרים שמשויכים לנתונים שלכם. סכימות טכניות מגדירות את המפרט המבני של האחסון, כמו סוג מסד הנתונים, אורך התווים או אילוץ של מספר שלם, אבל הסמנטיקה מתארת מה קבוצת הנתונים מייצגת בפועל. לדוגמה, אפשר למפות עמודה בשם
txn_qtyלהגדרה העסקית "כמות שנרכשה". - נתונים מובְנים. מידע שמאוחסן בסכימות מוגדרות ובפורמטים יחסיים. לדוגמה, טבלאות ב-BigQuery, מסדי נתונים ב-Spanner וטבלאות תפעוליות ב-Postgres. Knowledge Catalog סורק אוטומטית את המטא-נתונים האלה ומתעד עמודות ואילוצים.
תזמור הקשר ב-Agentic Data Cloud
במסגרת Agentic Data Cloud של Google, Knowledge Catalog משמש כשכבת התזמור הסמנטי. במקום לדרוש מהמפתחים לכתוב בתוך הקוד באופן ידני סכימות וכללים של מסדי נתונים להנחיות, מנוע תלוי ההקשר מספק באופן דינמי את ההקשר הסמנטי המדויק שהסוכן צריך כדי לקבל החלטות חכמות.
בתרשים הבא אפשר לראות איך Knowledge Catalog מתזמר ומספק את ההקשר של הנתונים:
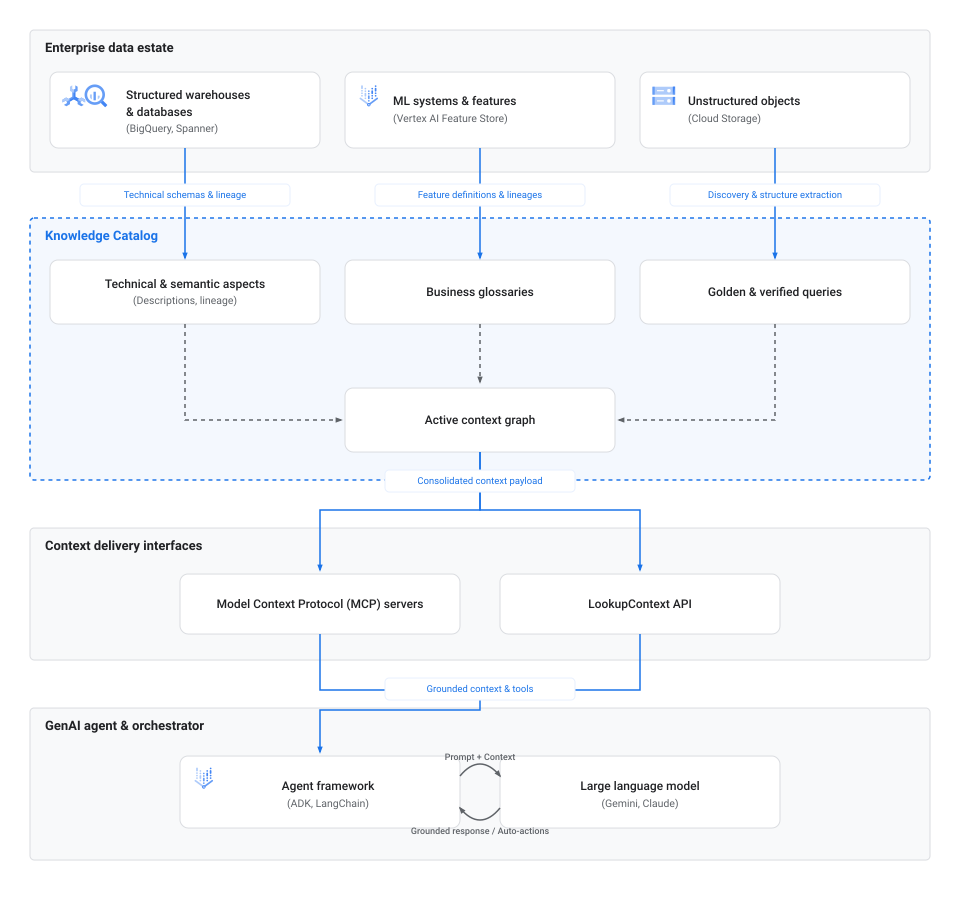
תהליך העבודה של תזמור ההקשר כולל את השלבים הבאים:
- הטמעה וגילוי. מסדי נתונים תפעוליים, מחסני נתונים כמו Spanner ו-BigQuery, מאגרי אובייקטים לא מובְנים כמו Cloud Storage ומטא-נתונים של זמן ריצה כמו קטלוג ייעודי לזמן ריצה של Lakehouse, מזינים סכימות טכניות, מפות שושלת יוחסין והגדרות של מטא-נתונים ישירות ל-Knowledge Catalog.
- מיפוי הקשר. בתוך Knowledge Catalog, מאפייני המטא-נתונים האלה מקושרים לרכיבים סמנטיים, כולל היבטים טכניים, מילון המונחים הארגוני ושאילתות מאומתות, כדי ליצור את תרשים ההקשר הפעיל.
- ממשקי מסירה. אפליקציות ותזמורים של AI מאחזרים את תרשים ההקשר המאוחד הזה באופן פרוגרמטי באמצעות מחברים סטנדרטיים, כמו MCP או נקודות קצה ישירות ל-API של
LookupContext. - עיגון הסוכן. מסגרות תזמור, כמו ערכת הפיתוח של הסוכן (ADK) או LangChain, מוסיפות את ההקשר של המטא-נתונים ישירות להנחיות של ה-LLM. ההחדרה הזו מבססת את החשיבה של הנציג על כללים ארגוניים מאומתים, שמאפשרים לו לשלוח שאילתות למסדי נתונים או לבצע פעולות אוטומטיות בלי הזיות.
פרופילים של סוכני AI
בהתאם לתהליכי העבודה שאתם רוצים להפוך לאוטומטיים, אתם יכולים ליצור סוגים שונים של סוכנים שמבוססים על Knowledge Catalog:
- סוכני איתור נתונים. העוזרים הדיגיטליים האלה עוזרים למשתמשים לחפש ולנווט במאגר הנתונים. במקום להסתמך על התאמה למילות מפתח, הם מנתחים כוונות ומגבלות ארוכות בשפה טבעית כדי לאחזר את הנכסים הפיזיים הרלוונטיים ביותר.
- סוכנים להעשרת מטא-נתונים. הסוכנים האלה פועלים ברקע ומקבלים טקסט לא מובנה מוויקי, מקובצי README או מיומני צ'אט, מנתחים את הטקסט למטא-נתונים רשמיים וכותבים את המטא-נתונים כהיבטים ב-Knowledge Catalog כדי לשמור על עדכניות המטא-נתונים.
- סוכנים לאיכות הנתונים ולצינורות עיבוד נתונים. הסוכנים האוטונומיים האלה מעריכים את כללי האיכות, מזהים שינויים בסכימה ויוצרים או מתקנים צינורות עיבוד נתונים לטרנספורמציה של נתונים, על ידי שליחת שאילתות לגבי שושלת נתונים וסטטיסטיקות של פרופילים.
כלי תזמור
כדי ליצור ולשלב את הנציגים האלה, אתם יכולים להשתמש בכלים הבאים:
- Model Context Protocol (MCP). פרוטוקול פתוח וסטנדרטי לקישור סוכנים למשאבים חיצוניים. אתם יכולים להגדיר סוכנים שיתחברו לקטלוג באמצעות שרת MCP מרוחק או ארגז כלים מקומי של MCP. מידע נוסף זמין במאמר מידע על Model Context Protocol (MCP) ב-Knowledge Catalog.
- Agent Development Kit (ADK). סביבת עבודה של Google שמאפשרת ליצור, להריץ ולבדוק בקלות סוכני AI גנרטיבי, ומציעה קישורים מובנים ל-Catalog Service API. מידע נוסף זמין בדף הבית של ADK.
- LookupContext API. נקודת קצה ל-API בארכיטקטורת REST ו-gRPC שמחלצת מטען ייעודי (payload) מאוחד של הקשר YAML או JSON לנכסי נתונים, שמוכן להזרקה ישירות להנחיות ל-LLM. מידע נוסף זמין במאמר אחזור הקשר באמצעות LookupContext API.
גישה להקשר באמצעות MCP
Model Context Protocol (MCP) הוא גשר סטנדרטי שמאפשר לסוכני AI ולכלים להתחבר בצורה חלקה למקורות נתונים כמו Knowledge Catalog. אתם יכולים להיעזר בטבלת ההשוואה הבאה כדי לבחור את האפשרות הכי טובה לשילוב:
| הטמעה | למי זה מתאים | הפרטים העיקריים | נקודת קצה או הגדרה |
|---|---|---|---|
| שרת MCP מרוחק | פריסות שמתמקדות בענן, סביבות ללא שרת (serverless) כמו Cloud Run ושירותים חיצוניים מנוהלים. | נקודת קצה (endpoint) שמתארחת ב-Google ולא דורשת ניהול של שרת מקומי. | נקודת קצה: https://dataplex.googleapis.com/mcpכדי להגדיר, קראו את המאמר שימוש בשרת MCP מרוחק. |
| ארגז כלים מקומי של MCP | פיתוח סוכנים מקומיים, יצירת אב טיפוס מהירה ושילובים של סביבות פיתוח משולבות (IDE) למחשב כמו VS Code או Cursor. | כלי שורת פקודה שפועל כשרת proxy מקומי בין סביבת סביבת העבודה לבין Knowledge Catalog. | צריך להתקין קובץ בינארי ולשנות את ההגדרות של .mcp.json.כדי להגדיר את השרת, אפשר לעיין במאמר איך משתמשים בשרת MCP מקומי. |
שיטות מומלצות להקשר של נתונים בסוכנים
כדי ליצור חוויות אמינות של סוכנים, חשוב לפעול לפי השיטות המומלצות הבאות כשמארגנים מטא-נתונים ב-Knowledge Catalog ושולחים אליהם שאילתות:
- להוסיף היבטים. סוכני AI לא יכולים להבחין בין טבלאות ייצור רשמיות לבין מודלים זמניים של ארגז חול לפי השם בלבד. הגדירו והחילו היבט מותאם אישית של אותות אמון כדי לאשר מוצרי נתונים מוסמכים, וכך להבטיח שהסוכנים יתעדפו או יגבילו שאילתות למשאבים האלה.
- אופטימיזציה של חיפושים באמצעות תקציבי הקשר. כששולחים קריאה ל-API של
LookupContext, צריך לציין את הפרמטרcontext_budget. ה-API מבצע אופטימיזציה ומתאים קודם את המטא-נתונים החשובים ביותר, כמו שושלת ותיאורים ראשיים, במסגרת מגבלות הטוקנים שציינתם. - לספק מקורות מידע שקשורים לנושא כדי לחשוף נתיבי הצטרפות. בשאילתות ההקשר, אפשר לציין עד 10 טבלאות או נכסים קשורים. כשמספקים קבוצה של נכסים, מנוע תלוי הקשר יכול לאכלס באופן אוטומטי נתיבי איחוד וקשרים, וכך הסוכן יכול להבין איך הטבלאות מתממשקות.
- מבנה של מילוני מונחים סמנטיים. להגדיר מונחים וקיצורים סטנדרטיים במילוני המונחים הארגוניים. הסטנדרטיזציה הזו עוזרת לכלים של ממשק השיחה לפתור בצורה מדויקת מילים נרדפות ומדדים שספציפיים לעסק.
- פרסום שאילתות לדוגמה. מצרפים שאילתות מאומתות בשפה טבעית ואת המקבילות הנכונות שלהן ב-SQL ישירות לרשומות ב-Knowledge Catalog. כשמבססים את החשיבה על התבניות המאומתות האלה, מונעים שגיאות בהמרת SQL בסוכני text-to-SQL.
שדרוג מ-Dataplex Universal Catalog ל-Knowledge Catalog
Dataplex Universal Catalog הפך ל-Knowledge Catalog. איך משדרגים מ-Dataplex Universal Catalog ל-Knowledge Catalog
מגבלות
כשמתכננים את הפריסה, חשוב להביא בחשבון את המגבלות הבאות:
השילובים הנתמכים למרות ש-Knowledge Catalog תומך במערכות עיקריות של צד שלישי, יכול להיות שחילוצים סמנטיים אוטומטיים מסוימים יהיו מוגבלים לשירותים מובנים של Google Cloud .
מגבלות מכסה. מכסות ה-API הרגילות של Google Cloud חלות על פעולות של אחזור הקשר וחילוץ מטא-נתונים.
היקפי אבטחה. לפני שיוצרים את המשאבים, צריך ליצור באופן ידני מתחם אבטחה היקפית של VPC Service Controls. אחרת, המשאבים לא יהיו מוגנים על ידי ההיקף. מידע נוסף מופיע במאמר VPC Service Controls עם Knowledge Catalog.
המאמרים הבאים
מידע על הקשר הנתונים
איך ההקשר הפעיל הופך מטא-נתונים פסיביים למידע שסוכני AI יכולים להתבסס עליו כדי למנוע הזיות.
הגדרת הקשר בסיסי לנתונים
ליצור מילון מונחים ארגוני, להגדיר סוגי היבטים בהתאמה אישית ולהעשיר נכסים ב-BigQuery.
התאמת סוכנים באמצעות MCP
מחברים סוכני AI וכלים למפתחים ל-Knowledge Catalog באמצעות Model Context Protocol.
חיפוש מקורות מידע
חיפוש ועיון במשאבים בקטלוג ב-Google Cloud ובמערכות של צד שלישי באמצעות שפה טבעית.
אוטומציה של סריקות לאיכות הנתונים
הגדירו כללי אימות ועקבו אחרי ניקיון הנתונים בטבלאות באמצעות סריקות איכות אוטומטיות.
תרחישי שימוש אינטראקטיביים
הסבר על פתרונות בעולם האמיתי להעשרת הקשר, שושלת נתונים ו-Agentic Workflows.