


Knowledge Studio (anteprima) trasforma i metadati in un motore di contesto attivo che ti aiuta a migliorare l'affidabilità delle applicazioni di AI generativa. Puoi utilizzare Knowledge Studio per prevenire le allucinazioni negli agenti AI, come l'analisi conversazionale in BigQuery e Gemini, basandoli sul contesto aziendale.
Knowledge Studio automatizza la selezione dei metadati unificando le conoscenze frammentate provenienti da schemi, wiki e query SQL precedenti. Puoi esplorare i dati utilizzando il linguaggio naturale, navigare in un grafico di contesto visivo che collega gli asset di dati alla semantica aziendale ed eseguire workflow automatizzati che creano bozze di aggiornamenti del catalogo per la revisione umana. Puoi quindi fornire dinamicamente questi blocchi di contesto selezionati agli agenti utilizzando il Model Context Protocol (MCP) o le API Knowledge Catalog.
Questo documento è rivolto ad architetti dei dati, responsabili della governance e ingegneri AI che vogliono capire come funziona Knowledge Studio.
Da catalogo passivo a motore contestuale attivo
I cataloghi di metadati tipici archiviano schemi, descrizioni e dizionari di dati statici. Sebbene siano sufficienti per gli analisti di dati umani che cercano tabelle, i metadati statici non sono sufficienti per gli agenti AI generativa che richiedono quanto segue:
Relazioni semantiche profonde: comprensione del modo in cui le tabelle si uniscono tra gli schemi, quali colonne rappresentano le metriche aziendali chiave e come i glossari aziendali vengono mappati allo spazio di archiviazione sottostante.
Grounding operativo: incorporazione nel contesto di pattern di utilizzo SQL reali, frequenza delle query e prompt e risposte effettivi dell'agente.
Autoapprendimento continuo: perfezionamento automatico delle descrizioni delle tabelle, degli aspetti e delle definizioni delle colonne in base al feedback degli utenti e ai tassi di successo dell'esecuzione degli agenti.
Knowledge Studio offre queste funzionalità tramite un motore contestuale sempre attivo che estrae continuamente indicatori operativi, genera proposte di metadati ad alta fedeltà ed eroga blocchi di contesto preformattati agli agenti tramite il Model Context Protocol (MCP) o le API Knowledge Catalog.
Interfacce di Knowledge Studio
Knowledge Studio organizza il tuo flusso di lavoro in tre aree principali:
Nuova chat: un'interfaccia di chat conversazionale e un grafico di contesto interattivo per l'esplorazione dei dati, l'indagine e lo strumento di convalida query semantiche utilizzando il linguaggio naturale. Per saperne di più, consulta Esplora gli asset di dati.
Set di contesto: un'interfaccia per creare e gestire i container logici (gruppi di voci) che pacchettizzano i metadati arricchiti per basare in modo sicuro gli agenti AI downstream. Per saperne di più, consulta Gestisci i set di contesto.
Arricchimenti: un centro di controllo per automatizzare la generazione di metadati, configurare i benchmark di valutazione ed esaminare gli aggiornamenti del catalogo proposti dall'AI (richieste di modifica) con workflow di selezione human-in-the-loop. Per saperne di più, consulta Informazioni sulle attività di arricchimento.
Scenari reali con più prodotti
Knowledge Studio connette il tuo data warehouse, i repository di conoscenze aziendali e le applicazioni di AI generativa. I seguenti scenari illustrano il funzionamento di Knowledge Studio su più prodotti in un'architettura aziendale.
Basare le query in linguaggio naturale su BigQuery
La sfida: gli analisti aziendali utilizzano il linguaggio naturale nell'analisi conversazionale per porre domande come "Qual è stato il nostro tasso di fidelizzazione netto per regione nell'ultimo trimestre?" Senza una semantica aziendale curata, il modello potrebbe generare allucinazioni per le chiavi di join o scambiare le prenotazioni lorde per le entrate nette.
La soluzione Knowledge Studio: l'analista utilizza l'interfaccia Nuova chat per verificare le relazioni tra le tabelle di gestione temporanea delle vendite e la
SZBank Business Glossarycertificata. Knowledge Studio basa l'analisi conversazionale sul grafico del contesto attivo, garantendo che l'SQL generato includa condizioni di join verificate e formule KPI standard.
Arricchisci i metadati dalle SOP aziendali
La sfida: i team di data engineering gestiscono decine di set di dati in BigQuery, mentre le regole aziendali critiche e la derivazione delle pipeline risiedono in wiki Confluence esterni o ticket Jira. Man mano che gli schemi si evolvono, la documentazione del catalogo diventa obsoleta.
La soluzione Knowledge Studio: un responsabile della governance configura un Enrichment task ricorrente che ha come target il set di dati di analisi. Knowledge Studio acquisisce SOP non strutturate da Confluence e log delle query storici da Cloud Logging, proponendo automaticamente definizioni di colonne e relazioni tra tabelle aggiornate. I curatori esaminano le differenze proposte nella pagina Dettagli esecuzione e approvano gli aggiornamenti verificati del catalogo.
Fornisci un contesto selezionato agli agenti
- La sfida: gli sviluppatori di AI che creano agenti di assistenza o consulenza rivolti ai clienti utilizzando LangChain o l'ADK hanno bisogno di una semantica dello schema aggiornata senza impostare come hardcoded le credenziali del database o inserire nel prompt definizioni di tabelle di grandi dimensioni.
- La soluzione Knowledge Studio: Knowledge Studio acquisisce metadati selezionati e grafici di join convalidati in un set di contesto (ad esempio
entryGroups/customer-360). Per accedere al contesto, gli agenti possono connettersi a Knowledge Studio tramite il Model Context Protocol (MCP) o utilizzare le API Knowledge Catalog. Al momento dell'inferenza, l'agente esegue una query sull'endpoint MCP o sulle API Catalog per recuperare dinamicamente il contesto aziendale certificato e le query di esempio pertinenti all'intent dell'utente.
Panoramica dell'architettura
Il seguente diagramma illustra l'interazione dei componenti di Knowledge Studio con il tuo patrimonio di dati, i foundation model e le applicazioni di AI che li utilizzano:
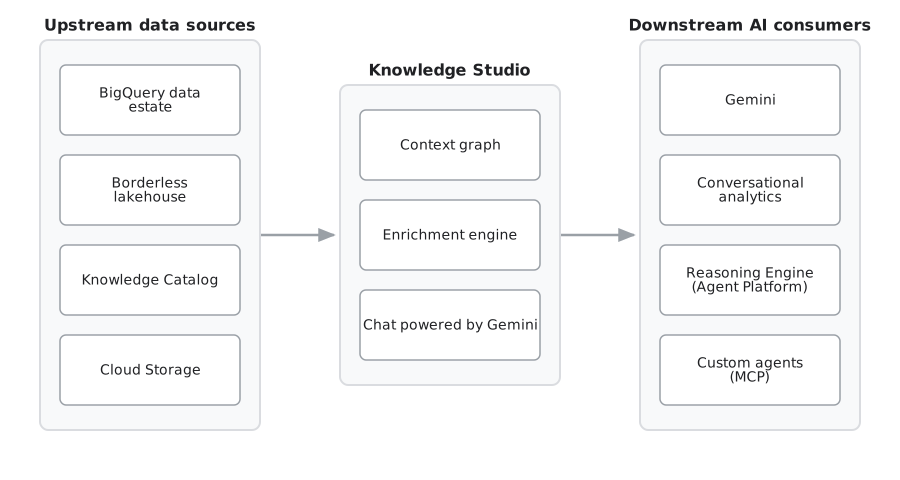
Concetti principali
Per lavorare in modo efficace con Knowledge Studio, devi comprendere come i metadati aziendali vengono modellati, pacchettizzati e curati.
Grafo di contesto
Il grafo di contesto è la topologia visiva interattiva centrale di Knowledge Studio. Unifica gli asset di dati (come tabelle BigQuery, viste e lakehouse) con la semantica aziendale (come termini del glossario aziendale, formule delle metriche e prodotti di dati). Nei cataloghi tipici, una tabella di dati e la relativa definizione del glossario aziendale esistono in silo separati. Nel grafo di contesto, esistono come nodi
la stessa tela. Gli analisti e gli ingegneri dei dati possono visualizzare le relazioni tra i dati, tramite l'utilizzo dedotto, le condizioni di join sulle tabelle e altro ancora, mentre Gemini utilizza il grafico per basare l'esplorazione in linguaggio naturale. Per saperne di più, consulta Esplora gli asset di dati in Knowledge Studio.
Tipi di risorse e connessioni supportati per il grafico del contesto
Il grafico del contesto supporta il rendering delle seguenti risorse del Knowledge Catalog come nodi o container:
- Tabelle e viste: tabelle, viste, set di dati e cataloghi tecnici di BigQuery e Lakehouse.
- Database e spazio di archiviazione: database operativi (come Spanner e AlloyDB) e risorse Cloud Storage.
- Analisi e modellazione: progetti Looker e modelli, test ed esposizioni dbt.
- Termini del glossario: singole definizioni aziendali di un glossario aziendale.
- Prodotti di dati: pacchetti selezionati di asset di dati per l'utilizzo tra team.
- Contesto: set di contesti personalizzati e documentazione allegata.
- Asset personalizzati: gruppi di voci personalizzati e tipi di voci non supportati.
Il grafico definisce il modo in cui queste risorse sono collegate visualizzando i seguenti archi di relazione semantica:
Join di schema: relazioni di join strutturali e operative tra le tabelle. Il sistema analizza automaticamente i job BigQuery per individuare le query che indicano che le colonne di tabelle diverse condividono lo stesso significato e possono essere unite.
Definizione: link che mappano un asset o una colonna di dati tecnici alla definizione del glossario aziendale corrispondente.
Contesto: link che attribuiscono set di contesti specializzati o documentazione di dominio personalizzato a un asset di dati di destinazione.
Pacchetti: link di aggregazione che mostrano quali asset di dati sono raggruppati in un prodotto dati specifico.
Link alla voce
Un link di ingresso rappresenta un arco semantico orientato o non orientato nel grafo di contesto. Questi link uniscono visivamente gli asset di dati e altre risorse unificate sul canvas. Puoi filtrare selettivamente questi link per isolare relazioni specifiche nel tuo patrimonio di dati.
I link di ingresso collegano entità distinte all'interno della tua azienda:
Link alle definizioni: collega le colonne della tabella sottostante direttamente ai termini del glossario aziendale certificato e alle formule dei KPI.
Link di relazione: mappa la chiave primaria verificata, la chiave esterna e i percorsi di join di più tabelle.
Link di traccia dell'agente: associa i prompt degli utenti dell'AI reali alle tabelle specifiche utilizzate per rispondere.
Pacchetti collegati: unisci insiemi di asset di dati a un prodotto di dati selezionato.
I link di ingresso fungono da singole connessioni attraversate per assemblare i set di contesto. Durante le esecuzioni di arricchimento automatico, l'agente propone nuovi link alle voci per l'approvazione del curatore ogni volta che identifica join candidati o termini non collegati.
Set di contesti
Un set di contesto è un container limitato di informazioni semantiche e riferimenti ad asset di dati. Ogni set di contesto viene implementato come un gruppo di voci specializzato (type="context-set").
I set di contesto stabiliscono confini di esecuzione ermetici che impediscono agli agenti di eseguire ricerche aperte nell'intero catalogo aziendale. Questo metodo riduce le allucinazioni e il consumo di token.
Per capire in che modo i set di contesto differiscono dai costrutti correlati, come i prodotti di dati e il grafico del contesto semantico, o per informazioni dettagliate su funzionalità, categorie, spazi dei nomi e pattern di consultazione degli agenti dell'architettura, consulta Panoramica dei set di contesto.
Attività ed esecuzioni di arricchimento
Il miglioramento automatico dei metadati in Knowledge Studio è organizzato in attività di arricchimento, job di arricchimento ed esecuzioni di arricchimento.
Attività di arricchimento: una configurazione permanente che definisce il modo in cui l'agente di arricchimento analizza un insieme mirato di asset di dati. Un'attività di arricchimento specifica il set di contesti di destinazione, le origini di input contestuali e i benchmark di valutazione.
Job di arricchimento: il processo di orchestrazione del backend all'interno di Knowledge Studio che esegue un'attività di arricchimento.
Esecuzione di arricchimento: una singola istanza di esecuzione point-in-time di un'attività. Ogni esecuzione ispeziona gli asset target, estrae gli indicatori semantici e genera richieste di modifica (proposte) che i data steward possono esaminare.
Per saperne di più sui workflow di arricchimento, consulta Informazioni sulle attività di arricchimento.
Grafico di contesto rispetto alla derivazione dei dati
Comprendere la differenza tra il grafico di contesto di Knowledge Studio e la derivazione dei dati di Knowledge Catalog è essenziale per scegliere lo strumento giusto.
La derivazione dei dati monitora il movimento operativo e la trasformazione sottostante dei dati nel tempo. La derivazione risponde a domande come: Da dove provengono questi dati? Quale pipeline ETL ha compilato questa tabella? Se questo schema upstream cambia, quali dashboard downstream si interrompono? I nodi rappresentano gli asset e i job di trasformazione sottostanti (come le pipeline Dataflow o i job BigQuery), mentre i bordi diretti rappresentano il flusso di dati sottostante.
Il grafo di contesto modella la semantica, le relazioni e la conoscenza del dominio aziendale. Il grafico di contesto risponde a domande come: Cosa significa questa colonna in termini di business? Qual è la relazione concettuale tra queste due tabelle? In che modo un agente AI deve unire questi asset per rispondere a una domanda? I nodi rappresentano gli asset sottostanti insieme alle entità concettuali (come termini del glossario, formule dei KPI e prodotti dati), mentre i bordi rappresentano le connessioni semantiche (come i link di definizione da colonna a glossario e le condizioni di join verificate).
Per saperne di più sulla tracciabilità delle pipeline, consulta Derivazione dei dati di Knowledge Catalog.
Sicurezza e governance di livello enterprise
Knowledge Studio si basa su un'architettura di sicurezza di livello enterprise progettata per ambienti rigorosamente regolamentati.
Identità di esecuzione gestita dall'utente: le attività di arricchimento vengono eseguite utilizzando un account di servizio gestito dall'utente, ovvero un'identità che crei e gestisci nel tuo progetto per consentire ai servizi di agire per tuo conto. L'agente di servizio Dataplex (P4SA) impersona questo service account utilizzando il ruolo Creatore token account di servizio (
roles/iam.serviceAccountTokenCreator) per generare credenziali OAuth 2.0 di breve durata. La generazione di queste credenziali di breve durata limita la durata dei token di accesso, riducendo al minimo il rischio di esposizione delle credenziali rispetto all'utilizzo di chiavi dei account di servizio di lunga durata.Autenticazione di terze parti: la connessione di origini di conoscenza SaaS remote (come Microsoft SharePoint, Atlassian Confluence, Jira e GitHub) utilizza il gestore di autenticazione di Agent Identity diGoogle Cloud, garantendo che gli operatori umani non gestiscano mai i client secret non elaborati.
Per informazioni su come configurare queste funzionalità di sicurezza, consulta Configura i prerequisiti di arricchimento.
Limitazioni
Regimi di conformità di Assured Workloads (tra cui FedRAMP, CJIS, IL4/IL5 e HIPAA).
Impegni relativi alla residenza dei dati (DRZ). I dati trattati da questa funzionalità potrebbero essere archiviati o trattati al di fuori dei confini geografici configurati in modo rigoroso.
Chiavi di crittografia gestite dal cliente (CMEK). I dati archiviati o elaborati da questa funzionalità vengono criptati utilizzando chiavi di proprietà di Google eGoogle-owned and Google-managed encryption keys anziché le tue chiavi di Cloud Key Management Service o Cloud EKM.
Controlli di servizio VPC. I Controlli di servizio VPC non sono supportati.
Notifiche di Access Transparency (AXT) e controlli di Access Approval. Le azioni intraprese dal personale di Google per supportare o mantenere questa anteprima non verranno registrate nel Cloud Access Ledger (CAL) di Access Transparency.
Durante l'anteprima, Knowledge Studio opera entro i seguenti limiti aggiuntivi:
Ambito regionale dei set di contesto: i set di contesto globali collegati ad asset di dati regionali non sono supportati. I set di contesto devono essere in linea con i confini regionali degli asset che raggruppano.
Gestione incentrata sulla console: le attività di arricchimento e le sessioni di esplorazione vengono gestite tramite la console Google Cloud . Le API REST dirette e i comandi dell'interfaccia a riga di comando
gcloudper la gestione delle attività non sono disponibili in Anteprima. Tuttui, gli agenti downstream possono scoprire ed eseguire query in modo programmatico su set di contesti selezionati utilizzando le API Catalog di Knowledge Catalog (ListEntries,LookupEntry) e il Model Context Protocol (MCP).Curation centralizzata: la revisione e l'approvazione di tutti i metadati avvengono nella pagina Dettagli dell'esecuzione dell'arricchimento.
Nessuno SKU di fatturazione autonomo: Knowledge Studio non introduce SKU di prodotto separati. Le tariffe di utilizzo riflettono il consumo standard delle risorse sottostanti ( Gemini Reasoning Engine, BigQuery e Cloud Storage).
Passaggi successivi
Esplora gli asset di dati e il grafico di contesto
Utilizza il canvas visivo di Knowledge Studio per chattare con i tuoi dati e tracciare le relazioni semantiche.
Informazioni sul contesto dei dati
Scopri come il contesto attivo trasforma i metadati passivi per fornire un grounding agli agenti AI e prevenire le allucinazioni.
Panoramica dei set di contesti
Scopri i container di contesto pacchettizzati di Knowledge Studio utilizzati per eseguire il grounding in modo sicuro degli agenti AI downstream.
Informazioni sulle attività di arricchimento
Scopri come configurare workflow di estrazione dei metadati basati sull'AI per creare automaticamente il contesto dei dati.
Stabilisci un contesto di dati di base
Crea un glossario aziendale, definisci tipi di aspetti personalizzati e arricchisci gli asset in BigQuery.
Integra gli agenti con MCP
Connetti gli agenti AI e gli strumenti per sviluppatori a Knowledge Catalog utilizzando Model Context Protocol.