


Le attività di arricchimento sono agenti autonomi in Knowledge Catalog che aiutano i data steward e i platform engineer a scalare le operazioni di stewardship dei dati. Un'attività di arricchimento analizza continuamente gli schemi dei set di dati, legge la documentazione aziendale e genera descrizioni proposte per gli asset di dati. Per ottenere il massimo dalle attività di arricchimento, devi avere familiarità con i concetti principali di Knowledge Catalog e con l'architettura dei dati della tua organizzazione.
Automatizzando la generazione dei metadati, le attività di arricchimento riducono l'onere della selezione manuale, garantendo al contempo che il catalogo rifletta un contesto accurato e specifico per l'attività.
Perché utilizzare le attività di arricchimento
Le attività di arricchimento affrontano la sfida di mantenere i Data Catalog su larga scala accurati e aggiornati.
| Aspetto | Approccio convenzionale | Approccio di Knowledge Studio |
|---|---|---|
| Procedura | Descrizioni scritte a mano. I responsabili esaminano manualmente migliaia di tabelle e intervistano esperti del dominio. | Basato sugli agenti. Un agente autonomo analizza i dati e legge le procedure operative standard. |
| Velocità e scalabilità | Lente e difficili da gestire man mano che gli schemi cambiano nel tempo. | Scalabilità elevata. I suggerimenti di metadati di alta qualità vengono generati continuamente. |
| Impegno umano | Alta. Inserimento manuale dei dati e manutenzione continua. | Basso. I data steward devono solo esaminare e approvare i suggerimenti generati. |
Casi d'uso delle attività di arricchimento
Le attività di arricchimento aiutano le organizzazioni a risolvere i seguenti problemi comuni relativi ai metadati:
Integrazione delle acquisizioni: un'azienda acquisisce una nuova unità aziendale con migliaia di asset di dati non documentati. I data engineer indirizzano un'attività di arricchimento al nuovo set di dati, utilizzando i dizionari di dati dell'azienda acquisita come indicatore di conoscenza. L'agente propone descrizioni in linea con l'attività per l'intero set di dati in poche ore anziché in mesi.
Documentazione continua: un team di platform engineering crea un lakehouse dinamico in cui gli schemi cambiano ogni giorno. Configurano un'attività di arricchimento da eseguire con pianificazione giornaliera con la pubblicazione automatica abilitata, assicurando che il catalogo rifletta sempre le ultime modifiche allo schema.
Governance semantica: un ufficio dati centrale vuole standardizzare la terminologia in tutti i reparti. Eseguono il deployment di un'attività di arricchimento che fa riferimento a un glossario di Knowledge Catalog selezionato. L'agente segnala e propone automaticamente override per le descrizioni delle tabelle che violano i termini del glossario aziendale approvato.
Concetti principali
Quando configuri un'attività di arricchimento, definisci i seguenti componenti principali:
- Attività di arricchimento
-
La configurazione che definisce ciò che l'agente deve fare. Un'attività contiene il set di contesto selezionato, le risorse di destinazione, la pianificazione e gli indicatori di conoscenza che fornisci.
Ad esempio, un'attività configurata per indicare all'agente di leggere i tuoi repository GitHub e arricchire il tuo set di dati
financeogni domenica a mezzanotte. - Job di arricchimento
- Il processo di orchestrazione del backend all'interno di Knowledge Studio che esegue un'attività di arricchimento.
- Esecuzione arricchimento
-
Una singola istanza di esecuzione point-in-time di un'attività. La console di Knowledge Studio include una scheda Job che elenca le esecuzioni storiche di un'attività. Puoi aprire un'esecuzione specifica per esaminare le proposte di metadati generate.
Ad esempio, l'istanza di esecuzione specifica che si è verificata il 24 ottobre e ha generato 15 modifiche alle colonne proposte.
- Set di contesti
-
Un container limitato di asset di dati e metadati di destinazione. Ogni attività di arricchimento deve essere configurata in modo da avere come target esattamente un set di contesto. Il set di contesto può contenere risorse di destinazione, come un set di dati BigQuery o un lakehouse, ma puoi anche creare un set di contesto vuoto se non ne esiste uno.
Ad esempio, un set di contesto di marketing che delimita logicamente le tabelle delle campagne, le metriche ROAS e i glossari terminologici in un unico confine di contesto AI.
- Indicatori di conoscenza
- Materiali esterni che basano l'agente sulla realtà della tua azienda. Fornendo bucket Cloud Storage contenenti dizionari di dati, glossari di Knowledge Catalog o URL della documentazione interna, ti assicuri che l'agente utilizzi la tua logica di business specifica anziché fare ipotesi generiche.
- Set di valutazione
-
Domande di test e SQL corrispondente (fornito in formato
.jsonl) utilizzati per valutare l'accuratezza dell'agente. Quando l'agente propone nuovi metadati, esegue queste domande di test sulle proposte per garantire che l'accuratezza non diminuisca prima della pubblicazione.Ad esempio, fornire una domanda di test come "Qual è il nostro MRR?" abbinata alla query SQL esatta necessaria per calcolare le entrate ricorrenti mensili. Se l'agente propone metadati confusi che causano l'errore di questa query di test, la proposta viene segnalata.
- Fonti di autoapprendimento
-
Log di conversazione in tempo reale dalle tue app Gemini Enterprise o da BigQuery Agent Analytics. L'agente legge questi log di chat per identificare le domande degli utenti, scopre le lacune di conoscenza mancanti e propone automaticamente nuovi metadati per colmarle.
Ad esempio, se i log della chat rivelano che gli utenti chiedono spesso "Cosa significa il codice di stato 42?" e l'agente non riesce a rispondere, l'autoapprendimento attiva una proposta di metadati per documentare il codice di stato mancante.
Origini dati e integrazioni supportate per le attività di arricchimento
Le attività di arricchimento si integrano sia con Google Cloud sia con sistemi di terze parti.
Asset di dati target
L'agente di arricchimento può arricchire e aggiungere direttamente i seguenti asset di dati target ai tuoi set di contesto:Google Cloud
Set di dati, tabelle e viste BigQuery
Lake, zone e asset di Lakehouse
Tramite l'integrazione di Lakehouse, Knowledge Studio supporta indirettamente l'arricchimento dei metadati da origini di terze parti collegate tramite integrazioni del catalogo REST Iceberg (come Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog e SAP Business Data Cloud).
Indicatori di conoscenza
Durante un'esecuzione di arricchimento, l'agente estrae regole semantiche, contesto aziendale e conoscenza del dominio dalle seguenti origini di sola lettura:
Google Cloud:
- Bucket Cloud Storage contenenti formati file supportati (come PDF, CSV, Markdown, configurazione, set di dati e file di testo non strutturati)
- Glossari aziendali di Knowledge Catalog situati nello stesso ambito regionale
- Applicazioni Google Workspace, inclusi i file di Google Drive (come Documenti, Fogli, Slides, PDF, file e documenti di testo generici)
Sistemi di terze parti (non Google Cloud):
- File di Microsoft SharePoint di dimensioni inferiori a 5 MB (ad esempio PDF, file di Office e documenti di testo generici, esclusi i formati legacy o le immagini)
- Repository GitHub (qualsiasi file contenente testo leggibile)
- Corpi delle pagine Atlassian Confluence
Fonti di autoapprendimento
Per identificare le lacune di conoscenza dai log delle interazioni reali, l'agente di arricchimento estrae le traiettorie da quanto segue:
- Applicazioni Gemini Enterprise
- Tabelle BigQuery Agent Analytics
- Cloud Logging con visualizzazioni dei log con ambito
Come funziona l'agente di arricchimento
Quando attivi un'attività di arricchimento, on demand o con una pianificazione ricorrente, viene avviata un'esecuzione di arricchimento. L'agente di arricchimento viene eseguito in modo asincrono in background, analizzando gli asset di dati, le tracce delle query e la documentazione per produrre proposte di metadati verificate.
Il seguente diagramma illustra l'architettura del flusso di lavoro di alto livello di un agente di arricchimento:
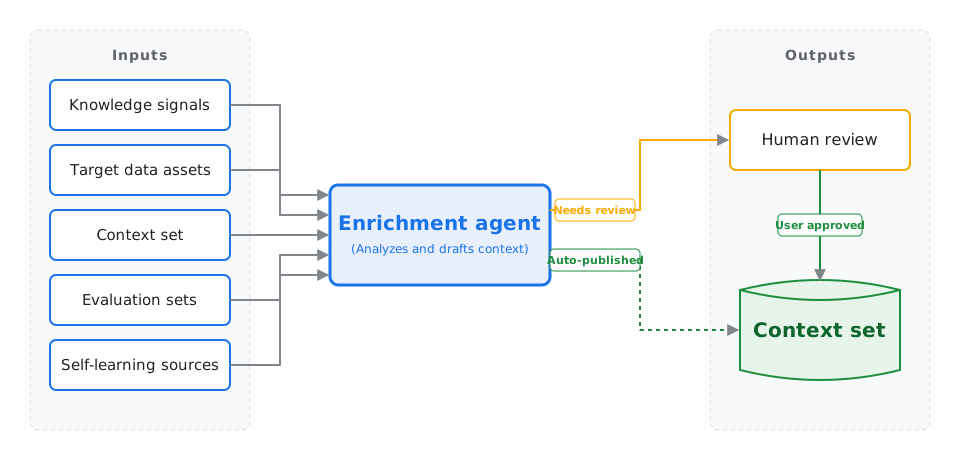
L'agente cura il set di contesto attraverso quattro fasi chiave:
- Analisi di indicatori e documentazione: l'agente analizza i log delle interazioni per trovare i punti in cui gli agenti AI downstream hanno avuto difficoltà o hanno richiesto una disambiguazione. Analizza i documenti aziendali in Cloud Storage o nelle app di terze parti collegate ed esamina la cronologia delle query per scoprire join di tabelle ad alta frequenza e dipendenze upstream.
- Bozze di proposte di contesto: guidato dal tuo obiettivo di selezione, l'agente redige un contesto strutturato per gli asset target. Sono incluse panoramiche delle tabelle orientate al business, formule formali delle metriche, condizioni di join verificate e modelli di query SQL basati su parametri d'oro.
- Benchmarking e ottimizzazione: utilizzando le domande di test del set di valutazione, l'agente testa in modo iterativo i propri metadati in bozza, perfezionando le descrizioni fino a massimizzare l'accuratezza delle query downstream. Quindi, esegue query di test di holdout per calcolare un tasso di errore di regressione. A ogni regola di descrizione o metrica proposta viene assegnato un punteggio di affidabilità.
- Applicazione delle policy di revisione: le proposte che soddisfano la soglia di confidenza attivano le regole delle policy. Se hai attivato la pubblicazione automatica e il tasso di errore di regressione rientra nel limite consentito, le modifiche vengono unite automaticamente. Se l'errore di regressione supera la soglia consentita, la pubblicazione automatica viene interrotta immediatamente e tutte le proposte vengono raggruppate in un'unica richiesta di modifica per la revisione umana.
Sicurezza e governance dei dati
Poiché le attività di arricchimento di Knowledge Studio utilizzano l'intelligenza artificiale per analizzare gli schemi dei dati e la documentazione interna, la piattaforma implementa limiti rigorosi per proteggere le tue informazioni proprietarie.
Addestramento dei foundation model: i tuoi dati rimangono tuoi. Le tracce di esecuzione, gli schemi di database e gli indicatori di conoscenza forniti (come documenti o glossari interni) dei clienti non vengono mai utilizzati per addestrare i foundation model di Google.
Sanitizzazione dei dati: prima che i metadati proposti vengano scritti in un set di contesto, l'agente oscura automaticamente le informazioni che consentono l'identificazione personale (PII) dai log di sistema e dalle tracce di generazione.
Limiti di esecuzione: l'agente di arricchimento opera all'interno di un tenant sicuro gestito da Google. Accede in modo sicuro alle tue origini dati private utilizzando un'interfaccia Private Service Connect e un proxy in uscita controllato dal cliente.
Stato di conformità: durante l'attuale fase di anteprima, le attività di arricchimento non supportano i Controlli di servizio VPC (VPC-SC), le chiavi di crittografia gestite dal cliente (CMEK) o Assured Workloads.
Configurazioni consigliate
Knowledge Catalog fornisce diverse impostazioni facoltative per le attività di arricchimento. Ti consigliamo di iniziare con una configurazione di base e di attivare progressivamente le funzionalità avanzate man mano che scali le operazioni sui metadati.
| Configurazione | Componenti inclusi | Pubblicazione automatica | Consigliato per |
|---|---|---|---|
| Basic | Set di contesti | Disabilitato | Test dello strumento. Ti consente di vedere in che modo l'agente deduce i metadati esclusivamente dallo schema del set di dati. Devi esaminare manualmente tutte le proposte. |
| Grounded |
|
Disabilitato | Ambienti di produzione. Fonda l'agente sulla tua logica di business specifica, utilizzando le tue procedure operative standard e i tuoi glossari per migliorare l'accuratezza. |
| Automatico |
|
Abilitato | Scalabilità delle operazioni sui metadati. Il set di valutazione funge da barriera di sicurezza. Se una proposta generata automaticamente causa una regressione nell'accuratezza downstream, la pubblicazione viene interrotta per la revisione manuale. |
| Autoapprendimento |
|
Abilitato | Cataloghi avanzati e autonomi. L'agente si adatta continuamente analizzando le interazioni degli utenti in tempo reale e i log delle chat degli agenti per identificare e colmare le lacune di conoscenza. |
Limitazioni e confini dell'anteprima
Durante l'anteprima, le attività di arricchimento operano entro i seguenti limiti:
Gestione incentrata sulla console: configuri e gestisci le attività esclusivamente tramite la console Google Cloud . Le API REST pubbliche dirette e i comandi dell'interfaccia a riga di comando
gcloudnon sono disponibili in Anteprima.Quote e limiti: le attività di arricchimento e le esecuzioni delle attività sono soggette a quote di risorse e quote di frequenza regionali per progetto. Per saperne di più, consulta la sezione Attività di arricchimento di Knowledge Studio in Quote e limiti.
Ciclo di vita del deployment
Il processo di creazione e deployment di un'attività di arricchimento segue un ciclo di vita lineare:
- Configura i prerequisiti: concedi i ruoli richiesti, configura i service account e abilita la profilazione dei dati e gli insight sui dati AI sulle tabelle utilizzate di frequente. Per saperne di più, consulta Configura i prerequisiti per le attività di arricchimento.
- Collega conoscenze esterne: autorizza l'attività a leggere i file da Google Drive o dai repository Git esterni per il grounding.
- Crea l'attività: definisci il set di contesti, le risorse target, gli indicatori di conoscenza e la strategia di valutazione.
- Esamina le proposte dell'AI: controlla la diagnostica dell'esecuzione, esamina le descrizioni proposte e approva le modifiche ai metadati.
Passaggi successivi
Panoramica di Knowledge Studio
Scopri i concetti fondamentali e l'architettura di Knowledge Studio.
Panoramica dei set di contesti
Scopri come i metadati generati dalle attività di arricchimento vengono archiviati nei set di contesto per fornire dati di base agli agenti AI.
Configura i prerequisiti di arricchimento
Scopri come configurare i ruoli e i service account per eseguire le attività di arricchimento.
Crea attività di enrichment
Scopri come generare metadati eseguendo attività di arricchimento automatico.
Gestisci le esecuzioni di arricchimento
Scopri come monitorare i job e rivedere o approvare manualmente i suggerimenti di metadati.
Gestisci le attività di arricchimento
Scopri come modificare, mettere in pausa ed eliminare i job di arricchimento pianificati.