


Les ensembles de contexte Knowledge Catalog vous permettent de regrouper des schémas de données, des définitions sémantiques et des schémas de requête validés dans des conteneurs de connaissances limités et spécifiques à un domaine. Ces connaissances ciblées permettent d'ancrer de manière fiable les applications d'IA autonomes telles que Gemini Enterprise et les agents personnalisés, afin qu'elles puissent fonctionner avec une grande précision.
Ce document s'adresse aux architectes de données, aux responsables de la gouvernance et aux ingénieurs IA qui souhaitent comprendre comment les ensembles de contexte structurent les connaissances du domaine pour les agents IA.
Qu'est-ce qu'un ensemble de contextes ?
Un ensemble de contexte est un groupe d'entrées Knowledge Catalog spécialisé (un conteneur logique pour les enregistrements de métadonnées) qui regroupe une collection autonome d'informations sémantiques et de références d'éléments de données pour des domaines d'analyse et des agents IA spécifiques.
Dans ce conteneur, les connaissances sont organisées en entrées, qui représentent des concepts d'entreprise, des documents ou des éléments de données individuels. Ces entrées sont enrichies d'aspects, qui sont des attributs de métadonnées modulaires stockant des détails spécifiques tels que des termes métier, des modèles SQL et de la documentation Markdown.
Plutôt que de forcer les agents à effectuer des recherches dans l'ensemble d'un catalogue d'entreprise, ce qui introduit de la latence, gaspille des jetons de prompt et risque de générer des réponses hallucinées, les ensembles de contexte établissent des conteneurs de connaissances hermétiques et limités au domaine que les agents peuvent consulter avec une grande précision.
Comme les ensembles de contexte agissent en tant que conteneurs administratifs, vous pouvez organiser les métadonnées par propriété de projet et appliquer des règles de contrôle des accès IAM (Identity and Access Management) à toutes les entrées groupées en même temps, sans configurer les autorisations individuellement. Pour en savoir plus sur les groupes d'entrées, les entrées et les aspects, consultez À propos de la gestion des métadonnées.
Exigences d'ancrage des agents IA
Lorsque les organisations déploient des agents IA autonomes (comme Gemini Enterprise, Antigravity et des agents personnalisés du kit de développement d'agents) pour orchestrer les workflows de données et générer des analyses, les agents ont besoin d'un ancrage fiable :
- Définitions sémantiques : que signifie une colonne ou une métrique spécifique en termes d'activité ?
- Schémas de requête validés : comment les experts du domaine ont-ils interrogé et joint ces tables ?
- Règles opérationnelles : quelles règles d'entreprise, critères d'exception et procédures opérationnelles standards (SOP) régissent ces données ?
Modèles de dénomination recommandés pour les ensembles de contexte
Le diagramme d'architecture suivant illustre comment les quatre conventions de nommage logique de base fonctionnent ensemble dans la limite du groupe d'entrées pour ancrer les applications d'IA en aval :
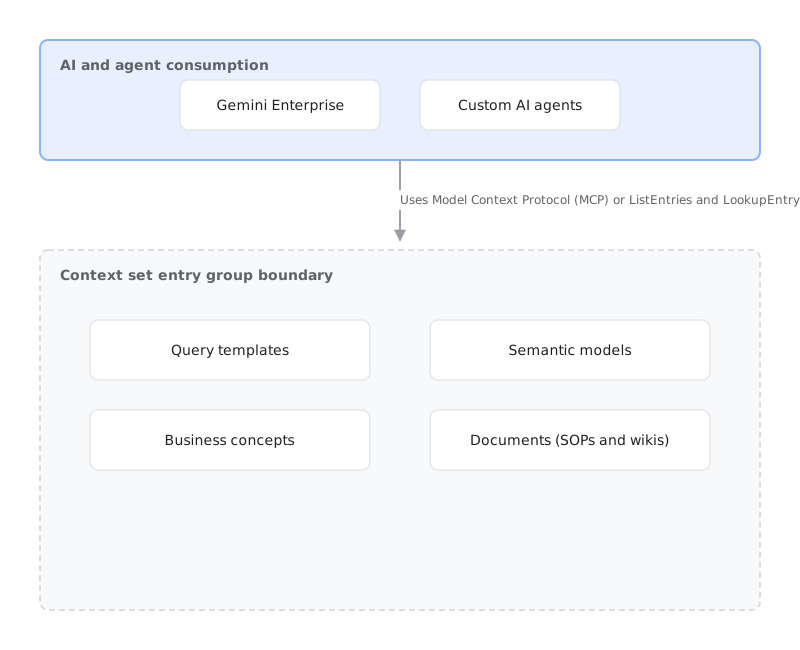
Bien qu'un ensemble de contextes ne nécessite pas strictement chaque type d'entrée pour fonctionner, nous vous recommandons d'organiser vos entrées en utilisant les conventions de dénomination logique suivantes. L'utilisation de ces conventions d'attribution de noms permet de s'assurer que les humains et les agents autonomes peuvent découvrir et interpréter les connaissances de manière cohérente :
| Format de nom | Type d'entrée | Description et objectif | Aspects associés |
|---|---|---|---|
Concepts d'entreprise concepts_<id> |
generic |
Termes du glossaire d'entreprise, définitions des métriques, acronymes et formules de calcul. | glossary-term-aspect, contacts. |
documents_<path> document |
document |
Contexte narratif, procédures d'exploitation standards, wikis d'intégration et liens vers la documentation externe. | Document, overview (Markdown en texte enrichi et liens). |
Modèles de requêtes query-templates_<path> |
query-template |
Modèles de requêtes SQL prévalidés et paramétrés, logique de jointure à haute fréquence et modèles d'exécution. | query-template (inclut des champs tels que sources, intent, nlQuery, parameters et query). |
Modèles sémantiques semantic-models_<id> |
semantic-model, semantic-entity, semantic-metric |
Modèles relationnels formels, définitions d'entités, hiérarchies dimensionnelles et mesures. | semantic-model, semantic-entity, semantic-metric. |
Concepts d'entreprise
Une entrée de concept d'entreprise (entrée de type générique utilisant la convention d'attribution de noms concepts_*) définit la terminologie d'entreprise standardisée, les métriques de domaine, les acronymes et les formules de calcul (glossary-term-aspect).
Voici les principales fonctionnalités de cette solution :
- Alignement de la terminologie : élimine l'ambiguïté de la terminologie entre les unités commerciales et les équipes d'analyse.
- Formules de KPI : fournit des formules mathématiques et une logique pour les indicateurs clés de performance (KPI) spécifiques au domaine.
- Propriété organisationnelle : établit une propriété organisationnelle claire via des aspects de gouvernance associés (
contacts).
Par exemple, dans un ensemble de contexte d'e-commerce, une entrée au niveau de concepts_net_items_sold spécifie le calcul exact des unités nettes vendues. Lorsqu'un agent reçoit une requête demandant le "nombre net d'articles vendus", il consulte l'entrée du concept pour appliquer le calcul validé plutôt que d'inventer une logique SQL.
Exemple de représentation de ressource :
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/concepts_net_items_sold
entryType: generic
aspects:
  dataplex-types.global.glossary-term-aspect:
    definition: "Calculates the absolute number of items sold minus customer returns in a given time period."
Documents
Une entrée de document (entrée de type document utilisant la convention d'attribution de noms documents_*) stocke le contexte narratif et procédural dans un format Markdown structuré (Document, overview).
Voici les principales fonctionnalités de cette solution :
- Procédures opérationnelles normalisées (SOP) : capture les SOP, les checklists de runbooks et les guides d'intégration directement dans le catalogue.
- Règles de conformité : documente les règles de conformité, les contraintes réglementaires (telles que les règles de traitement du RGPD ou de la loi HIPAA) et les critères d'exception.
- Wikis de référence externes : fait référence à des wikis actifs externes (tels que des documents Google, Atlassian Confluence, Notion ou GitHub) via des pointeurs d'URI sources (liens
overview).
Par exemple, un ensemble de contextes de vêtements inclut documents_return_policy_rules pour indiquer aux agents comment exclure les ventes finalisées et les articles endommagés pendant le transport lors du calcul des taux de retour standards.
Exemple de représentation de ressource :
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents_return_policy_rules
entryType: document
aspects:
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
Modèles de requêtes
Une entrée de modèle de requête (entrée de type query-template utilisant la convention d'attribution de noms query-templates_*) contient des requêtes SQL paramétrées vérifiées par l'humain, mappées à des intents analytiques courants en langage naturel (à l'aide de l'aspect query-template).
Voici les principales fonctionnalités de cette solution :
- Requêtes prévalidées : stocke les chemins de jointure, les conditions de filtre et les modèles d'agrégation prévalidés pour les questions métier fréquentes.
- Paramétrage de l'environnement d'exécution : accepte la substitution des paramètres d'exécution (tels que
@start_date,@regionet@limit) pour l'exécution dynamique de l'agent. - Prévention des erreurs : évite les jointures de tables hallucinées et les erreurs de syntaxe du dialecte SQL.
Par exemple, lorsqu'un agent doit répondre à une question sur les comptes les plus performants, il met en correspondance query-templates_sales_top_accounts_by_arr et remplace la plage de dates demandée dans le modèle SQL validé.
Exemple de représentation de ressource :
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/query-templates_top_categories_by_season
entryType: query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Which e-commerce product categories performed best this season?"
    query: "SELECT category, SUM(revenue) FROM sales WHERE season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    parameters:
      -   name: "season"
        type: "STRING"
      -   name: "limit"
        type: "INTEGER"
Modèles sémantiques
Les entrées de modèle sémantique (utilisant les types d'entrées semantic-model, semantic-entity et semantic-metric avec la convention d'attribution de noms semantic-models_*) formalisent les structures relationnelles, les hiérarchies dimensionnelles et les mesures d'agrégation dans les tables normalisées.
Voici les principales fonctionnalités de cette solution :
Définition relationnelle : définit les clés primaires, les clés étrangères et les cardinalités de jointure (telles que les relations un à plusieurs ou plusieurs à plusieurs).
Mappage des dimensions d'entreprise : mappe les colonnes sous-jacentes brutes aux dimensions d'entreprise, aux grains temporels et aux mesures réutilisables.
Conseils pour les agents : guide les agents autonomes lors de l'assemblage de requêtes analytiques complexes multitables lorsqu'il n'existe pas de modèle de requête exact.
Abstraction de la complexité sous-jacente : contrairement aux liens d'entrée de jointure de schéma bruts qui ne documentent que les connexions de table mécaniques dans l'ensemble de données source, les modèles sémantiques fonctionnent au niveau de la couche logique métier pour empêcher l'agent IA d'halluciner des traversées de diagramme ER incorrectes.
Par exemple, un ensemble de contexte de vêtements utilise semantic-models_apparel_sales_model pour définir la manière dont warehouses, shipments et line_items se joignent dans les tables de faits et de dimensions du schéma en étoile.
Exemple de représentation de ressource :
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/semantic-models_apparel_sales_model
entryType: semantic-model
aspects:
  dataplex-types.global.semantic-model:
    entities:
      -   name: "products"
      -   name: "orders"
    relationships:
      -   sourceEntity: "orders"
        foreignKey: "product_id"
        targetEntity: "products"
        primaryKey: "id"
        type: "MANY_TO_ONE"
Exemple : Ensemble de contextes d'un magasin de vêtements en ligne
Pour illustrer le fonctionnement des quatre conventions de nommage, prenons l'exemple d'un marchand de vêtements en ligne qui déploie un assistant IA pour les responsables merchandising de ses magasins. Sans contexte délimité, l'agent peut interroger des tables de préproduction brutes ou mal comptabiliser les articles populaires en ne soustrayant pas les retours des clients.
Pour ancrer l'agent, un responsable de l'intendance des données crée un ensemble de contexte nommé online-apparel-store :
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── concepts_* (Business concepts)
│   ├── concepts_net_items_sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── concepts_bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents_* (Documents and SOPs)
│   ├── documents_return_policy_rules
│   │     Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│   └── documents_size_chart_guide
│         Markdown guide: Sizing conversions across US, UK, and EU clothing labels
│
├── query-templates_* (Golden SQL queries)
│   └── query-templates_top_categories_by_season
│         Verified SQL template with parameters: @season, @limit
│
└── semantic-models_* (Semantic models)
    └── semantic-models_apparel_sales_model
          Join keys: orders.product_id = products.product_id (many-to-one)
                     orders.order_id = returns.order_id (one-to-many)
Comment un agent résout une requête
Lorsqu'un marchand demande à l'agent "Quels sont nos cinq modèles de vestes d'hiver les plus vendus, à l'exclusion des retours endommagés ?", l'agent résout la requête via l'ensemble de contexte :
Recherche de modèle de requête : l'agent vérifie
query-templates_*et met en correspondancequery-templates_top_categories_by_season, en remplaçant@season = 'Winter'et@limit = 5.Vérification du concept : l'agent inspecte
concepts_net_items_soldetconcepts_bestsellerpour confirmer que les articles retournés doivent être soustraits des quantités totales de la commande.Application de la règle SOP : l'agent lit
documents_return_policy_ruleset ajoute la condition de filtreWHERE return_reason != 'DAMAGED_IN_TRANSIT'.Validation du schéma et de la jointure : à l'aide de
semantic-models_apparel_sales_modelet des tables@bigqueryassociées, l'agent jointstore.orders,store.productsetstore.returnsà l'aide de clés étrangères validées et exécute la requête SQL.
Capacités architecturales
Les ensembles de contexte offrent plusieurs fonctionnalités de base pour les environnements de données d'entreprise :
Limites d'exécution hermétiques : en limitant le contexte à un ensemble d'éléments et d'entrées sémantiques sélectionnés, les agents fonctionnent dans un bac à sable hermétique. Cela élimine les bruits superflus du catalogue, permet de garantir des évaluations déterministes et minimise l'utilisation des jetons.
Importation rapide et indexation groupée : les équipes peuvent importer et indexer des ensembles de concepts, de requêtes et de documents en une seule opération atomique, ce qui vous permet de les intégrer à des pipelines d'intégration et de déploiement continus (CI/CD).
Empaquetage sans copie : Context définit les métadonnées et les relations du package sans copier ni déplacer le stockage de données sous-jacent, ce qui évite les coûts de stockage redondants et les retards de synchronisation des données.
Modèles de consultation d'agents
Les agents en aval consomment des ensembles de contexte via le protocole MCP (Model Context Protocol) ou les API Knowledge Catalog directes. Pour en savoir plus, consultez Récupérer le contexte des données avec les API Catalog. Pour optimiser la latence des réponses et minimiser la consommation de jetons, les agents suivent une hiérarchie de consultation à trois niveaux :
Correspondance de modèle de requête : l'agent recherche
query-templates_*. Si un modèle validé correspond à l'intention de l'utilisateur, l'agent paramètre la requête et l'exécute directement. Cela permet d'obtenir la réponse la plus rapide avec un risque d'erreur de requête quasi nul.Assemblage du modèle sémantique : si aucun modèle de requête ne correspond, l'agent évalue
semantic-models_*pour comprendre les relations entre les entités et construire une instruction SQL multitables.Consultation de documents et de concepts : pour les cas limites ambigus (comme les dates limites de l'année fiscale ou les exclusions de litiges), l'agent lit
concepts_*etdocuments_*pour appliquer les règles métier.
Consommer du contexte dans les applications d'IA générative
Les applications d'IA générative utilisent des ensembles de contexte sélectionnés pour comprendre la sémantique du domaine de l'entreprise, parcourir des schémas complexes et générer du code SQL fiable sans hallucinations. Les applications consomment généralement ces ensembles de contexte via deux modèles principaux :
Découverte de contexte dynamique : dans les environnements d'analyse conversationnelle ou en libre-service, les utilisateurs posent des questions ad hoc en langage naturel. L'application évalue de manière dynamique l'intention de l'utilisateur pour identifier et récupérer l'ensemble de contexte le plus pertinent dans Knowledge Catalog, en injectant les connaissances du domaine récupérées dans le prompt actif.
Ensembles de contexte préconfigurés : pour les applications d'agent dédiées, vous pouvez préconfigurer l'agent avec une référence d'ensemble de contexte explicite en fournissant son URI de ressource. La liaison d'un ensemble de contextes dédié fournit un ancrage déterministe, garantissant que toutes les interactions utilisent des définitions d'entreprise certifiées sans surcharge de recherche d'exécution. L'agent hérite automatiquement des améliorations de qualité, car les workflows d'enrichissement récurrents affinent l'ensemble de contexte au fil du temps.
Pour optimiser ces fonctionnalités d'enrichissement et d'auto-apprentissage, nous vous recommandons de spécifier un modèle Gemini 3.8 Flash ou ultérieur dans l'application Gemini Enterprise. Pour en savoir plus sur les étapes de sélection du modèle, consultez la section "Créer un agent à l'aide du générateur de flux" dans Concevoir des agents dans Agent Studio.
Comparaison des ensembles de contexte avec les constructions associées
Pour choisir la construction de métadonnées adaptée à votre architecture, découvrez comment les ensembles de contextes Knowledge Catalog se comparent aux fonctionnalités de plate-forme associées.
Ensembles de contextes et graphiques contextuels
Le graphique de contexte et les ensembles de contexte sont deux constructions distinctes qui jouent des rôles différents dans l'architecture de Knowledge Studio :
Graphe de contexte : topologie sémantique complète et en temps réel de votre organisation. Il associe les éléments de données sous-jacents, les termes du glossaire d'entreprise et les traces d'interaction. Vous explorez et parcourez ce graphe ouvert de manière interactive dans l'interface Explorer.
Ensemble de contexte : unité de packaging limitée, régionale et sélectionnée. Il extrait et empaquette hermétiquement un sous-ensemble spécifique de connaissances du domaine dans un groupe d'entrées (
type="context-set") que les agents IA en aval peuvent interroger via le protocole MCP (Model Context Protocol). Un ensemble de contextes agit comme un sous-graphe cohérent et à haute densité dans le graphe de contexte plus large.
Ensembles de contextes Knowledge Catalog par rapport aux ensembles de contextes de base de données
Knowledge Catalog et les bases de données opérationnelles Google Cloudutilisent le terme ensemble de contexte pour désigner les informations sélectionnées qui ancrent les modèles d'IA générative.
Bien que les deux variantes partagent la même architecture sous-jacente (elles sont stockées de manière native en tant qu'ensembles de contextes Knowledge Catalog (groupes d'entrées extensibles avec type="context-set") et utilisent les API Knowledge Catalog standards), elles ciblent différentes couches de la pile de données d'entreprise :
- Ensembles de contexte de base de données (QueryData) : conçus pour diffuser des bases de données opérationnelles et transactionnelles (telles qu'AlloyDB pour PostgreSQL, Cloud SQL et Spanner). Ces ensembles de contexte sont fortement optimisés pour les configurations SQL. Ils regroupent des modèles de requêtes de référence, des métadonnées de schéma et des facettes de filtrage qu'un agent d'ingénierie de contexte dédié évalue pour améliorer la traduction du langage naturel en SQL (NL2SQL) dans les environnements d'exécution opérationnels.
- Ensembles de contexte Knowledge Catalog (Knowledge Studio) : conçus pour diffuser des ressources de données analytiques (telles que BigQuery, les lacs de données et les produits de données Knowledge Catalog). Ces ensembles de contexte regroupent des connaissances multimodales plus larges dans plusieurs conventions de dénomination, y compris des concepts métier, des wikis de documentation Markdown et des modèles sémantiques. Elles sont organisées à l'aide de workflows d'enrichissement Knowledge Studio et diffusées aux agents d'analyse en aval via le protocole MCP (Model Context Protocol).
Ensembles de contexte et produits de données
Comprendre comment les ensembles de contexte interagissent avec les produits de données Knowledge Catalog vous aide à établir des limites claires pour la gouvernance des données et de l'IA :
Les produits de données gèrent les ressources sous-jacentes : les produits de données regroupent de manière sécurisée des ressources concrètes telles que des tables, des buckets et des flux BigQuery, établissant ainsi une unité principale pour le partage de données, les contrats de données et le contrôle des accès au plan de données.
Les ensembles de contexte regroupent la sémantique conversationnelle : les ensembles de contexte n'accordent pas d'accès aux données. À la place, ils regroupent les connaissances du domaine, telles que les concepts, les modèles de requête et les documents requis par les agents IA et les humains pour comprendre les données. Les intendants de données peuvent associer un ensemble de contextes à un produit de données en le déclarant dans les références
additional_contextdu produit.
Sécurité et gouvernance d'entreprise
Les ensembles de contexte s'intègrent aux contrôles de sécurité et de gouvernance Google Cloud pour protéger les métadonnées d'entreprise sensibles :
Rôles IAM des ensembles de contexte : comme les ensembles de contexte contiennent souvent des informations sémantiques sensibles, l'accès est régi par des rôles IAM appliqués directement au groupe d'entrées
context-set. Cela vous permet d'organiser les connaissances sélectionnées par région géographique et par propriété de domaine, en accordant des autorisations de modification aux gestionnaires de domaine et des autorisations de lecture aux agents IA consommateurs. Pour créer un ensemble de contextes, vous devez disposer de l'autorisation IAMdataplex.entryGroups.setIamPolicy. Cette autorisation est requise pour vous accorder automatiquement des autorisations de propriétaire lors de la création de l'ensemble de contextes. Vous pouvez obtenir cette autorisation via des rôles prédéfinis tels que Administrateur de catalogue Dataplex (roles/dataplex.catalogAdmin) ou Propriétaire du groupe d'entrées Dataplex (roles/dataplex.entryGroupOwner).Sécurité des données sous-jacentes sans copie : accorder à un agent l'accès à un ensemble de contexte lui permet de lire les métadonnées sémantiques et les modèles de requête, mais ne contourne pas les contrôles d'accès sur les tables sous-jacentes. Pour exécuter une requête SQL sur BigQuery ou lire des fichiers dans Cloud Storage, l'identité qui exécute la requête doit disposer des autorisations IAM requises sur le plan de données pour ces ressources sous-jacentes.
Gouvernance avec intervention humaine : lorsque les tâches d'enrichissement autonomes de Knowledge Studio extraient de nouveaux concepts, des SOP ou des modèles de requête à partir des journaux opérationnels, les propositions sont mises en préproduction en tant que demandes de modification pouvant être examinées. Les gestionnaires de données inspectent les comparaisons de différences et les scores d'évaluation avant d'approuver les modifications apportées à un ensemble de contexte de production. Pour en savoir plus sur l'examen des propositions, consultez Gérer les demandes.
Identité d'exécution gérée par l'utilisateur : les tâches d'enrichissement automatisées qui renseignent les ensembles de contexte s'exécutent sous un compte de service géré par l'utilisateur dont l'identité est empruntée par l'agent de service Dataplex via le rôle Créateur de jetons du compte de service (
roles/iam.serviceAccountTokenCreator).
Champ d'application et limites de la version Preview
Pendant la version Preview, les ensembles de contexte fonctionnent dans les limites suivantes :
Champ d'application régional : les ensembles de contexte globaux associés à des éléments de données régionaux ne sont pas acceptés. Un ensemble de contextes doit s'aligner sur les limites régionales des éléments qu'il empaquette.
Interfaces de création et de consommation : vous pouvez créer des ensembles de contexte via le conteneur Knowledge Studio dans la console Google Cloud , en les distinguant logiquement des groupes d'entrées d'administration Knowledge Catalog standards. Vous pouvez remplir automatiquement les ensembles de contexte via les workflows d'enrichissement de Knowledge Studio. Les agents IA en aval peuvent découvrir et interroger des ensembles de contexte de manière programmatique à l'aide des API Knowledge Catalog (
ListEntriesetLookupEntry) et du protocole MCP (Model Context Protocol). Pour en savoir plus, consultez À propos des serveurs MCP.Facturation : Knowledge Catalog ne facture pas de SKU autonome distinct pour la création de groupes d'entrées d'ensembles de contexte.
Quotas partagés : étant donné que les ensembles de contexte sont fondamentalement des groupes d'entrées spécialisés (
type="context-set"), ils consomment et partagent les mêmes quotas de ressources que les groupes d'entrées Knowledge Catalog standards.
Étapes suivantes
Présentation de Knowledge Studio
Découvrez comment orchestrer un contexte de données enrichi, créer des ensembles de contextes et ancrer des agents IA à l'aide des interfaces Knowledge Studio.
Explorer les assets de données et le graphique de contexte
Utilisez le canevas visuel de Knowledge Studio pour discuter avec vos données et tracer des relations sémantiques.
À propos de la gestion des métadonnées
Comprendre comment les entrées, les groupes d'entrées et les aspects constituent la base structurelle des ensembles de contexte.
À propos des serveurs MCP
Exposer des ensembles de contexte et des métadonnées enrichies aux agents d'IA générative en aval à l'aide de MCP
Récupérer le contexte des données avec les API Catalog
Découvrez et récupérez de manière programmatique des ensembles de contextes pour le raisonnement de l'IA générative à l'aide des API ListEntries et LookupEntry.
Gérer les ensembles de contextes
Découvrez comment créer, afficher, modifier et supprimer des ensembles de contexte dans pour organiser les connaissances du domaine.