


本文說明如何建立及最佳化脈絡資料集,提高 Spanner Graph 資料代理應用程式的 QueryData 準確度。情境工程代理可自動建立及最佳化 Graph Query Language (GQL) 情境集,協助您建構、評估及改善這些情境集。
如要瞭解 Spanner Graph 的情境集和 QueryData,請參閱「情境集總覽」和「QueryData 總覽」。
如要建構企業圖形資料應用程式,自然語言轉 GQL 的準確率通常需要達到近乎 100% 的品質。圖表遍歷模式不正確或缺少邊緣篩選器,會影響應用程式可用性和使用者體驗。如要取得可解釋、與業務相關且高度準確的答案,就必須進行情境工程,也就是建立及反覆最佳化情境組合。
只要為 QueryData 提供 Spanner Graph 結構定義和業務應用程式的相關背景資訊,就能提供精確的圖表遍歷規則和網域定義,讓系統解析細微的使用者意圖。
本文件中的範例使用 FinGraph 屬性圖表結構定義和範例資料集 (Person 和 Account 節點由 Owns 和 Transfers 邊緣連結)。如要建立 FinGraph 結構定義並插入樣本資料,請參閱「設定及查詢 Spanner Graph」。
脈絡工程代理
脈絡工程代理會自動執行脈絡工程工作流程:生成評估資料集、啟動脈絡集,並反覆改善。
以下列舉一些自然語言提示,說明如何指示代理,以及代理的回應方式:
- 情境建議提示詞範例:「閱讀我的 Spanner 資料庫中
FinGraph屬性圖的應用程式文件,並建議要新增的 GQL 情境項目。」代理會剖析您提供的資料集應用程式文件、將業務規則對應至FinGraph節點和邊緣標籤,並建議 GQL 範本和面向。 - 使用者問題未傳回預期結果時,差距分析的提示範例:「當使用者詢問『從緊急預備金帳戶轉帳』時,QueryData 會篩選
nick_name = 'rainy day account',且不會傳回任何結果。請更新 Spanner 資料庫中FinGraph屬性圖譜的背景資訊,以便正確回答這個問題。」代理會檢查結構定義,找出暱稱是以Rainy Day Fund形式儲存,並建議對Account.nick_name進行值搜尋 (如果問題在於模式,則建議使用範本或 facet)。 大量處理的提示詞範例:「以下是 Spanner 資料庫中
FinGraph屬性圖的自然語言問題和 GQL 查詢。將其轉換為範本:- 找出 Dana 轉帳給哪些人,以及轉帳金額:
GRAPH FinGraph MATCH (:Person {name: 'Dana'})-[:Owns]->(:Account)-[transfer:Transfers]->(:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS recipient, transfer.amount AS amount - Alex 進行了哪些高風險轉移?
GRAPH FinGraph MATCH (:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount"
代理會大量處理輸入內容,將常值替換為
?預留位置,並更新情境集檔案。- 找出 Dana 轉帳給哪些人,以及轉帳金額:
黃金資料集的重要性
如要最佳化脈絡,首先必須建立一個符合應用程式自然語言輸入情境的黃金資料集。代理可協助您建立黃金資料集,其中包含使用者問題和預期的 GQL 查詢。黃金資料集可讓您執行下列操作:
- 建立自然語言轉 GQL 查詢效能的基準。
- 根據基準真相 GQL 查詢,驗證背景資訊更新。
- 評估各最佳化疊代的準確度改善情形。
系統化的爬坡程序
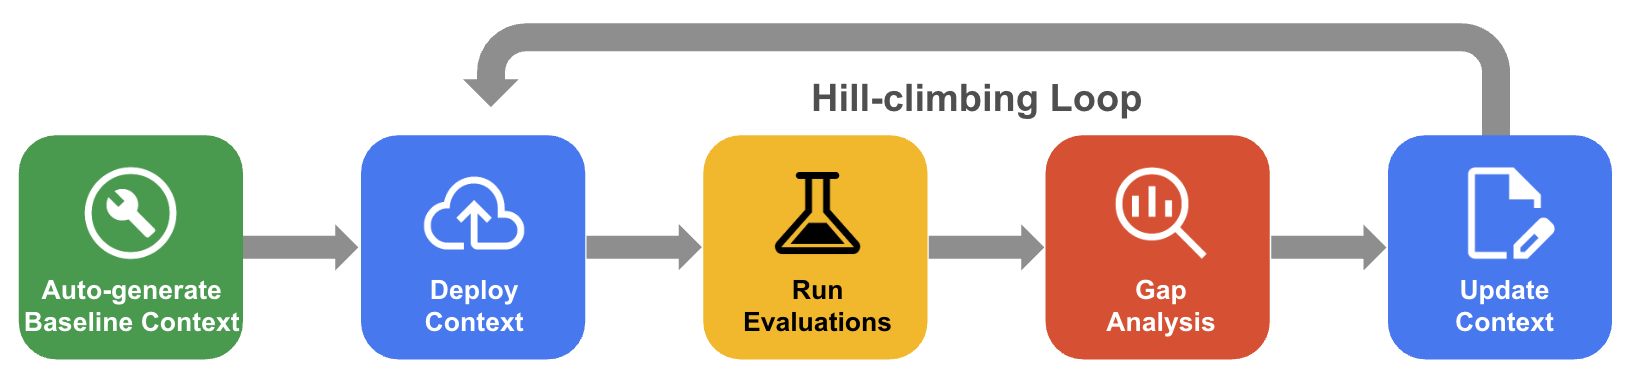
在系統化爬山演算法中,代理會透過評估黃金資料集、差距分析和指定 GQL 情境更新,反覆改善情境集,將準確率提升至接近 100%:
- 自動生成基準情境:根據 Spanner Graph 屬性圖譜結構定義和應用程式構件,建立起始 GQL 情境集。
- 爬山演算法最佳化工作流程:讓代理使用設定好的
graph_ids評估 QueryData 準確率、對失敗的 GQL 查詢執行差距分析,並自動提出改善建議,提高準確率。
下圖顯示系統化爬坡法的工作流程:
事前準備
使用脈絡工程代理前,請先完成下列必要條件:
啟用必要服務
為專案啟用下列服務:準備 Spanner 執行個體
- 確認 Spanner 執行個體可用。詳情請參閱「建立執行個體」。
- 請務必在執行個體中建立資料庫,以便在其中建立資料表。詳情請參閱「在 Spanner 執行個體上建立資料庫」。
必要角色和權限
- 將 IAM 使用者或服務帳戶新增至執行個體。詳情請參閱「套用 IAM 角色」。
- 在專案層級,將
roles/spanner.databaseReader、roles/serviceusage.serviceUsageConsumer和roles/geminidataanalytics.queryDataUser角色授予 IAM 使用者。詳情請參閱「新增專案的 IAM 政策繫結」。 - 如要建立、上傳及管理情境集,請在專案層級,將 Dataplex Catalog 編輯者 (
roles/dataplex.catalogEditor) 或 Dataplex Catalog 管理員 (roles/dataplex.catalogAdmin) 角色授予 IAM 使用者。詳情請參閱「情境組合權限」。 - 在專案層級,為 IAM 使用者授予所需資料庫的角色和權限。
如要設定 FinGraph 屬性圖譜結構定義,並插入本指南使用的範例圖譜資料,請按照「設定及查詢 Spanner Graph」中的步驟操作。
準備環境
您可以在任何本機開發環境或 IDE 中建構脈絡集檔案。如要準備環境,請完成下列步驟:
- 安裝脈絡工程代理。
- 設定 Spanner Graph 的資料庫連線。
安裝內容比對引擎代理程式
情境工程代理會執行 Model Context Protocol (MCP) 伺服器,該伺服器需要 uv 才能管理基礎 Python 套件。
- 按照「安裝
uv」中的操作說明安裝uv。 確認已安裝
uv,且可透過指令列存取:uv --version
如要準備環境,請在所選代理工具 (例如 Antigravity CLI、Claude Code 或 Gemini CLI) 中安裝脈絡工程代理。
視所選的代理駕馭系統而定,請按照對應的安裝步驟操作:
Antigravity CLI
如要在 Antigravity CLI 中安裝情境工程代理,請按照下列步驟操作:
- 安裝 Antigravity CLI。請參閱「開始使用 Antigravity CLI」。
- 安裝情境工程代理外掛程式,其中包含情境生成工作流程:
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
- 啟動 Antigravity CLI:
agy
- 更新外掛程式:
agy plugin uninstall google-cloud-db-context-engineering
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
Claude Code
如要在 Claude Code 中安裝情境工程代理,請按照下列步驟操作:
- 新增外掛程式市集:
/plugin marketplace add https://github.com/GoogleCloudPlatform/db-context-enrichment.git
- 安裝外掛程式:
/plugin install db-context-engineering@db-context-enrichment-marketplace
- 重新載入外掛程式,讓變更生效:
/reload-plugins
- 更新外掛程式:
/plugin update db-context-engineering@db-context-enrichment-marketplace
Gemini CLI (已淘汰)
如要在 Gemini CLI 中安裝情境工程代理,請按照下列步驟操作:
- 安裝 Gemini CLI。請參閱「開始使用 Gemini CLI」。
- 安裝擴充功能:
gemini extensions install https://github.com/GoogleCloudPlatform/db-context-enrichment
- 更新擴充功能:
gemini extensions update mcp-db-context-enrichment
設定資料庫連線
代理需要資料庫連線,才能擷取屬性圖表結構定義 (spanner-list-graphs)、檢查基礎資料表 (spanner-list-tables),以及驗證生成的 GQL 和 SQL 查詢語法 (spanner-execute-sql)。如要讓代理與 Spanner 資料庫中的屬性圖表互動,請設定驗證憑證並定義資料庫連線設定。
設定應用程式預設憑證
設定應用程式預設憑證 (ADC),提供使用者憑證,以便從情境工程代理存取 Google Cloud 資源:
- Toolbox MCP 伺服器:使用憑證連線至 Spanner 資料庫、擷取屬性圖譜結構定義,並執行 GQL 查詢進行驗證。
- Evalbench:使用憑證透過
graph_ids呼叫QueryDataREST API,並在評估期間於 Vertex AI 執行 LLM 評估器。
在終端機執行下列指令來驗證:
gcloud auth application-default login設定資料庫連線檔案
代理需要資料庫連線才能生成情境,MCP Toolbox 支援這項功能,並在設定檔 (autoctx/tools.yaml) 中定義,同時搭配狀態追蹤器 (autoctx/state.md) 記錄使用中的屬性圖名稱 (例如 FinGraph)。
- 啟動代理環境。
請代理設定 Spanner 資料庫的資料庫連線,並指定屬性圖名稱。例如,輸入下列提示詞:
Help me set up the database connection for my Spanner database with the FinGraph property graph.按照代理的指示,提供專案 ID、Spanner 執行個體 ID、資料庫 ID 和屬性圖名稱 (
FinGraph)。代理會建立autoctx/tools.yaml(包含spanner-list-graphs、spanner-list-tables和spanner-execute-sql工具) 和autoctx/state.md。開啟
autoctx/state.md,確認## Active Database區段以以下格式列出屬性圖:- **Graph Ids**: ["FinGraph"]評估工作流程只會從這一行讀取屬性圖 ID。如果缺少該行、該行空白 (
[]),或格式不正確,評估作業會呼叫 QueryData,但不包含graph_ids,而 QueryData 會生成關聯式 SQL,而非 GQL。如要套用新的
tools.yaml設定,請重新載入連線:- 在 Antigravity CLI 中執行
/mcp,然後選取toolbox重新啟動。 - 在 Gemini CLI 中執行
/mcp reload。 - 在 Claude Code 中執行
/mcp,然後依序選取toolbox和Reconnect。
- 在 Antigravity CLI 中執行
如要進一步瞭解如何手動設定資料庫設定檔,請參閱「MCP Toolbox 設定」。
生成及最佳化背景資訊
情境工程代理提供一組代理技能和 MCP 工具,可生成基準 GQL 情境集、根據精確 GQL 資料集評估成效,並反覆套用改善措施。您可以從工作流程的任何階段開始:
- 如果您已有情境集,可以直接進行評估。
- 如果您想修正失敗的 GQL 查詢,可以直接進行差距分析。
在任何階段,請提醒代理目標是 Spanner 資料庫中的屬性圖譜,並命名圖譜 (例如 FinGraph),讓代理保持在 GQL 專屬工作流程中。
建立及擴充評估資料集
如要提升成效,首先必須進行評估。黃金資料集是一組使用者問題,以及預期的 GQL 查詢。如果沒有基準真相,情境工程就缺乏系統化驗證;有了基準真相,每次情境變更都是可衡量的改善,可根據基準真相進行驗證。
手動建立具代表性的黃金資料集相當耗時,而且小型資料集可能無法涵蓋使用者用詞的變化。代理會採取下列行動來解決這個問題:
- 根據屬性圖結構定義,生成候選自然語言問題和 GQL 查詢組合。
- 使用篩選器變化版本、同義詞和多躍路徑改寫,擴充種子資料集。
- 對 Spanner 資料庫執行生成的 GQL 查詢,確認每項查詢都能順利執行並傳回有效結果。
根據「Spanner Graph 查詢總覽」中的 FinGraph 查詢,黃金資料集 (autoctx/golden.json) 是 JSON 檔案,內含自然語言問題和 GQL 配對,例如:
[
  {
    "id": "fingraph_001",
    "database": "example-db",
    "nlq": "Find everyone that Dana transferred money to, along with the account IDs and transfer amounts.",
    "golden_sql": "GRAPH FinGraph MATCH (from_person:Person {name: 'Dana'})-[:Owns]->(from_account:Account)-[transfer:Transfers]->(to_account:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS to_account_owner, to_account.id AS to_account_id, transfer.amount AS amount;"
  },
  {
    "id": "fingraph_002",
    "database": "example-db",
    "nlq": "Find all money transfers involving a blocked account.",
    "golden_sql": "GRAPH FinGraph MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true}) RETURN transfer.order_number, transfer.amount;"
  },
  {
    "id": "fingraph_003",
    "database": "example-db",
    "nlq": "Find destination accounts that are 1 to 3 transfers away from account 7, and show the path length.",
    "golden_sql": "GRAPH FinGraph MATCH (src:Account {id: 7})-[e:Transfers]->{1, 3}(dst:Account) WHERE src != dst RETURN dst.id AS dst_account_id, ARRAY_LENGTH(e) AS path_length;"
  },
  {
    "id": "fingraph_004",
    "database": "example-db",
    "nlq": "Find all high-risk transfers initiated by Alex.",
    "golden_sql": "GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;"
  }
]
核准的配對會填入工作區中的 autoctx/golden.json 檔案,準備進行評估。在每個項目中,database 必須與 Spanner 資料庫 ID (例如 example-db) 相符。
您可以使用下列範例提示詞,指示代理,並指定 FinGraph 是 Spanner 資料庫中的屬性圖:
- 「從 Spanner 資料庫的
FinGraph屬性圖譜生成 GQL 評估資料集。」 - 「以下是 Spanner 資料庫中
FinGraph屬性圖譜的種子問題和 GQL 查詢。請將其擴充為更廣泛的 GQL 評估資料集,並確認查詢能順利執行。」
生成基準脈絡資料集
為避免從頭建立情境,您可以讓代理從屬性圖結構定義和應用程式構件 (例如業務規則、GQL 查詢範例或設計文件),衍生初始 GQL 情境集 (bootstrap_context.json)。由於資料集是 Spanner 資料庫中的屬性圖,代理在生成範本和篩選條件時,會優先使用 GQL 模式 (GRAPH FinGraph MATCH ...),而非關聯式 SQL join。
您可以使用下列範例提示詞,指示代理:
- 「根據 Spanner 資料庫中的
FinGraph屬性圖譜,生成基準 GQL 脈絡資料集。」 - 「使用屬性圖譜結構定義和
requirements.md中的業務規則,為 Spanner 資料庫中的FinGraph屬性圖譜生成初始 GQL 情境。」
代理會提示您為實驗命名 (例如 fingraph_tuning),並將生成的構件整理到 autoctx/experiments/fingraph_tuning/ 下。代理生成 bootstrap_context.json 後,請按照「在 Spanner Studio 管理情境集」一文的指示,上傳情境集檔案。
評估情境成效
建立背景資訊集和黃金資料集後,您可以使用每個黃金問題查詢 QueryData API,讓代理評估背景資訊成效。代理會使用 Evalbench,將生成的 GQL 和執行結果與預期的精確答案進行比較。
如果是 Spanner Graph,評估作業會直接呼叫 QueryData REST API,因此每項要求都能包含 graph_ids。
如果 autoctx/state.md 包含 - **Graph Ids**: ["FinGraph"],代理會生成 Evalbench 模型設定檔 (autoctx/experiments/fingraph_tuning/eval_configs/model_config.yaml),該檔案使用 REST API,並在 spanner_reference.database_reference 中包含 graph_ids,如下所示:
generator: query_data_api
project_id: PROJECT_ID
location: global
use_rest_api: true
context:
  datasource_references:
    spanner_reference:
      database_reference:
        engine: GOOGLE_SQL
        project_id: PROJECT_ID
        instance_id: INSTANCE_ID
        database_id: DATABASE_ID
        graph_ids:
        - FinGraph
      agent_context_reference:
        context_set_id: projects/PROJECT_ID/locations/REGION/contextSets/CONTEXT_SET_ID
執行評估前,請開啟 model_config.yaml,確認 use_rest_api 為 true,且 graph_ids 列出您的屬性圖。
執行評估作業後,您會取得下列資訊:
- 量化指標,例如通過和失敗結果,以及匯總分數,用於追蹤 GQL 情境疊代的進度。
- 內嵌對話摘要和詳細 CSV 報表,會寫入實驗資料夾中的
eval_reports/目錄。
如要開始評估,請提供黃金資料集路徑 (autoctx/golden.json) 和脈絡集 ID。如要瞭解如何找出情境組合 ID,請參閱「找出情境組合 ID」。
您可以使用下列範例提示詞,指示代理:
- 「Evaluate my context for the FinGraph property graph in my Spanner database against
autoctx/golden.json. 呼叫 QueryData REST API,並將graph_ids設為FinGraph。 - 「使用上次實驗的設定,重新評估 Spanner 資料庫中的 FinGraph 屬性圖。」
如要直接從工作區根目錄重新執行先前產生的評估設定,請執行下列指令:
uvx google-evalbench --experiment_config=autoctx/experiments/fingraph_tuning/eval_configs/run_config.yaml如要進一步瞭解評估設定結構定義,以及如何自訂評估執行作業,請參閱 Evalbench 說明文件。
執行差距分析並提出改善建議
如要解決 GQL 查詢失敗問題,請找出根本原因,例如:
- 反向邊緣方向 (
-[:Owns]->與<-[:Owns]-) - 缺少量化路徑邊界 (
->{1, 3}) - 未對應的業務定義 (例如
high-risk transfers) - 未解析的屬性值
如要瞭解查詢語法,請參閱「Spanner Graph 查詢總覽」和「GQL 參考資料」。
代理會自動執行這個分析和修正迴圈,處理 Spanner 資料庫中的屬性圖:
- 落差分析:代理會讀取評估結果和情境設定,將類似的 GQL 失敗分組,並建議有針對性的新增項目,例如 GQL 範本、切面,或節點和邊緣屬性的
GRAPH_TABLE值搜尋。 - 建議修正:代理會提出具體的 GQL 情境編輯建議,並使用
spanner-execute-sql針對 Spanner 資料庫測試生成的 GQL,驗證解決方案。 - 保留基準:代理會將改善項目寫入新的 JSON 檔案 (
improved_context_v1.json),並保留基準情境,不更動原始檔案。
您可以使用下列範例提示詞,指示代理將資料集指定為 Spanner 資料庫中的屬性圖,觸發 GQL 專屬的內容工程工作流程:
- 「針對 Spanner 資料庫中 FinGraph 屬性圖譜的上次評估結果執行差距分析,並提出 GQL 情境修正建議。」
- 「針對
autoctx/golden.json,最佳化 Spanner 資料庫中 FinGraph 屬性圖的這個情境組合。」
為準備下一次疊代,請按照「編輯情境集」中的操作說明,將改良後的情境集檔案 (improved_context_v1.json) 上傳至 Spanner Studio 中的目標情境集。
視需要建立特定情境項目
如果您已知道所需的內容項目 (例如特定圖表遍歷的 GQL 範本、重複邊緣篩選器的 facet,或節點或邊緣屬性的 GRAPH_TABLE 值搜尋),代理就能視需要生成正確參數化的 JSON 物件,不必執行完整評估。
您可以使用下列範例提示,指示代理處理 Spanner 資料庫中的屬性圖:
- 「針對 Spanner 資料庫中的 FinGraph 屬性圖,建立『找出 Alex 發起的所有高風險轉帳』範本,並使用 GQL 查詢:
GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;。」 - 「針對 Spanner 資料庫中的 FinGraph 屬性圖譜,為 GQL 子句
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})建立一個名為『涉及封鎖帳戶的轉帳』的 facet。」 - 「針對 Spanner 資料庫中的 FinGraph 屬性圖,在概念類型為『帳戶暱稱』的
Account節點nick_name屬性上建立GRAPH_TABLE值搜尋,比對暱稱時不區分大小寫。」
選取背景資訊類型的理由
選取適當的背景資訊類型 (GQL 範本、facet 或值搜尋),有助於避免背景資訊膨脹和查詢迴歸。您可以提示代理,根據查詢模式推薦合適的情境類型:
- 「在 Spanner 資料庫的 FinGraph 屬性圖中,我一直使用
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})篩選涉及封鎖帳戶的轉帳,這需要執行許多 GQL 查詢。如何才能拍出最棒的效果?」 - 「使用者會用『度假基金』或『緊急預備金』等暱稱,來指稱 Spanner 資料庫中 FinGraph 屬性圖的帳戶。我應該在
Account.nick_name上設定哪種GRAPH_TABLE值搜尋? - 「Spanner Graph 的情境集中,GQL 範本和面向有何差異?兩者的使用時機為何?」
對脈絡資料集套用大量作業
代理程式支援大量更新,可一致管理大型 GQL 情境集,例如在多個範本和面向中更新屬性圖標籤或變更業務門檻:
- 「讀取 Spanner 資料庫中 FinGraph 屬性圖譜的
golden.json,並將所有問題-GQL 組合轉換為範本。」 - 「在
context_set.json中,針對 Spanner 資料庫中的 FinGraph 屬性圖,將參照『高風險轉移』的任何 GQL 項目中的t.amount >= 200替換為t.amount >= 300。不要理會不相關的項目。
後續步驟
- 進一步瞭解情境組合。
- 瞭解如何在 Spanner Studio 建立或刪除情境集。
- 瞭解如何測試 Spanner Graph 的 QueryData。
- 請按照端對端教學課程,將 QueryData 與應用程式整合。