


Wichtig: Legen Sie beim Erstellen eines RAG-Korpus den Korpus-description fest. Der description kann nach dem Erstellen nicht mehr bearbeitet werden. Hochwertige Beschreibungen sind entscheidend für eine effektive korpusübergreifende Suche, da das System anhand dieser Beschreibungen die geeigneten Korpora für Ihre Abfrage auswählt.
Auf dieser Seite werden zwei APIs beschrieben, AsyncRetrieveContexts und AskContexts, die den korpusübergreifenden RAG-Abruf unterstützen, der im Backend durch agentischen Datenabruf unterstützt wird.
AsyncRetrieveContexts API: Dies ist eine asynchrone API, mit der Nutzer relevante Kontexte aus mehreren RAG-verwalteten Korpora abrufen können. Dies ist eine API mit langer Ausführungszeit. Nutzer können die Vorgangs-ID verwenden, um den Status der Abfrage und des Ergebnisses abzurufen.
AskContexts API: Dies ist eine synchrone API, die die Antwort auf die Abfrage direkt generiert, indem sie mehrere RAG-verwaltete Korpora durchsucht.
Wichtig: Wenn Sie diese Funktion verwenden möchten, müssen Sie dem Dienstkonto der RAG Engine auf der Gemini Enterprise Agent Platform (service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com) die Rolle Agent Platform User in Ihrem Projekt zuweisen.
Wichtig: Diese Funktion ist nur in us-central1 verfügbar.
Systemarchitektur und Korpusauswahl
In diesem Abschnitt wird die Architektur des RAG-Systems für korpusübergreifendes Abrufen beschrieben und wie es geeignete Korpora für das Abrufen auswählt.
Systemarchitektur
Das Cross Corpus Retrieval-System verwendet einen agentischen Ansatz, um den Abruf über mehrere Korpora hinweg zu orchestrieren. Eine allgemeine Übersicht über die Architektur umfasst die folgenden Komponenten:
- Orchestrator/Router: Empfängt die Nutzeranfrage und koordiniert den Abrufprozess.
- Planungs-Agent: Analysiert die Anfrage und bestimmt anhand der
descriptions, welche Korpora am relevantesten sind. - Retrieval Engine: Führt eine semantische Suche in den ausgewählten RAG-Korpora durch.
- Reasoning Agent: Bewertet, ob die abgerufenen Kontexte ausreichen, um die Anfrage zu beantworten. Wenn die Informationen nicht ausreichen, wird Feedback generiert, um eine weitere Abrufschleife basierend auf Sufficient Context Awareness (SCA) auszulösen. Weitere Informationen finden Sie im Blogpost zu SCA und im Forschungsbericht.
- LLM-Generator (für
AskContexts): Synthetisiert die abgerufenen Kontexte, um eine endgültige Antwort zu generieren.
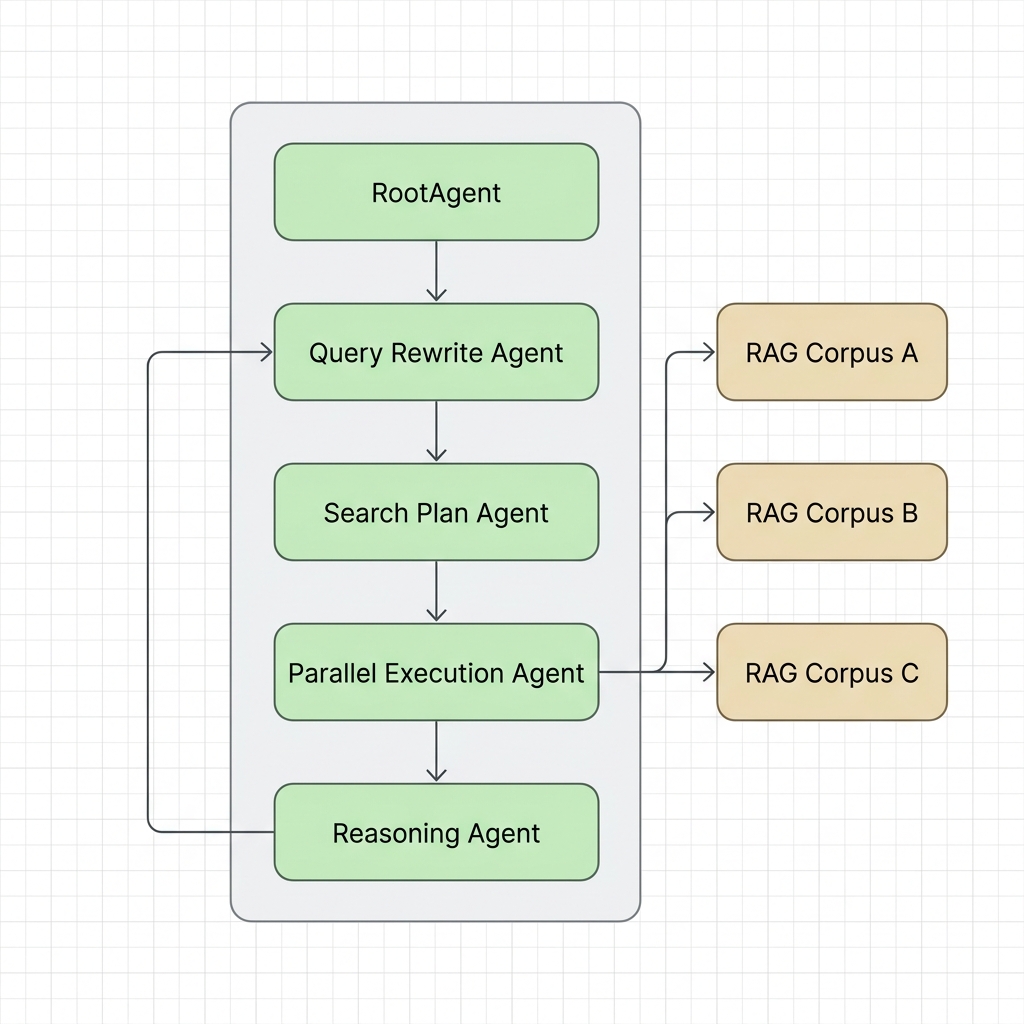
Auswahl von Korpora
Wenn eine Abfrage über mehrere von RAG verwaltete Korpora ausgeführt wird, muss das System bestimmen, welcher Korpus die Informationen enthält, die zur Beantwortung der Abfrage erforderlich sind. Dies wird durch agentischen Datenabruf erreicht:
- Korpuszuordnung: Das System verwaltet eine Zuordnung der verfügbaren RAG-Korpora zusammen mit ihren technischen Beschreibungen (im Feld
descriptiondes RAG-Korpus angegeben). - Semantischer Abgleich: Ein Agent für die strategische Planung (unterstützt von einem Gemini-Modell) wertet die Anfrage des Nutzers anhand der
descriptionsder verfügbaren Korpora aus. - Zielgerichtetes Routing: Der Planer generiert einen Abrufplan, der bestimmte Teile der Abfrage den relevantesten Korpora zuordnet. So wird sichergestellt, dass der Abruf fokussiert und effizient ist, anstatt alle Korpora naiv zu durchsuchen.
Codebeispiele
Die folgenden Codebeispiele zeigen, wie Sie die RAG Cross Corpus Retrieval APIs verwenden.
AsyncRetrieveContexts API
In diesem Codebeispiel wird gezeigt, wie Sie Kontexte asynchron aus mehreren RAG-Korpora abrufen.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Vorgangsergebnis abrufen
Da AsyncRetrieveContexts ein Vorgang mit langer Ausführungszeit ist, können Sie die GetOperations API verwenden, um das Ergebnis mithilfe der Vorgangs-ID abzufragen.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
AskContexts API
In diesem Codebeispiel wird gezeigt, wie Sie eine Antwort direkt generieren, indem Sie synchron in mehreren RAG-Korpora suchen.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Nächste Schritte
- Weitere Informationen zur RAG API finden Sie unter RAG Engine API.
- Weitere Informationen zu den Antworten von RAG finden Sie unter Abruf- und Generierungsausgabe der RAG Engine.
- Informationen zur RAG Engine finden Sie in der Übersicht über die RAG Engine.