


生成式 AI 詞彙表
本詞彙表定義了生成式人工智慧 (AI) 術語。
AI 代理
AI 代理是一種應用程式,會處理輸入內容、使用可用工具進行推論,並根據決策採取行動,以達成目標。AI 代理會使用呼叫函式設定輸入內容格式,確保與外部工具精確互動。下圖顯示 AI 代理的元件:
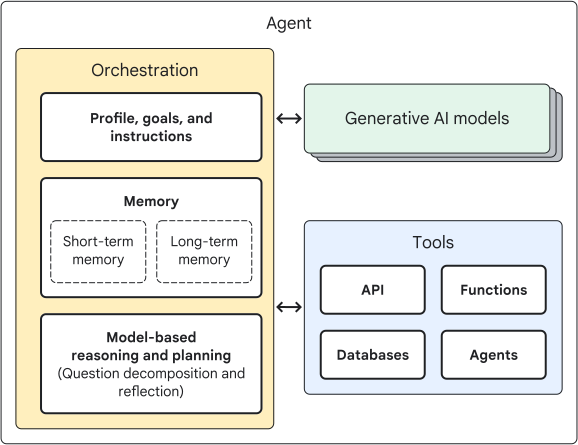
如上圖所示,AI 代理包含下列元件:
- 調度管理:代理的調度管理層會控管計畫、工具使用和資料流程,藉此管理記憶、狀態和決策。自動化調度管理包含下列元件:
- 設定檔和指令:代理會扮演特定角色或人物,引導其行動和決策。
- 記憶:為保留背景資訊和狀態,代理會保留短期和長期記憶。短期記憶體會保留當前工作所需的即時情境和資訊。長期記憶會保留完整的對話記錄。
- 推論與規劃:代理會使用模型執行工作分解和反思,然後建立計畫。首先,代理會將使用者提示拆解為子元件,並呼叫一或多個函式來處理複雜工作。接著,代理會運用推理和意見回饋,思考函式輸出內容,進而改善回覆。
- 模型:任何生成式語言模型,可處理目標、建立計畫並生成回覆。為發揮最佳效能,模型應支援呼叫函式,並使用工具或推論步驟的資料簽章進行訓練。
- 工具:一組工具,包括 API、服務或函式,可擷取資料並執行動作或交易。工具可讓代理與外部資料和服務互動。
如果應用程式需要自主決策、複雜的多步驟工作流程管理,或自動調整體驗,AI 代理的表現會優於標準基礎模型。代理擅長使用外部資料即時解決問題,以及自動執行知識密集型工作。這些功能可讓代理提供更強大的結果,超越基礎模型的被動文字生成功能。
如要進一步瞭解 AI 代理,請參閱「什麼是 AI 代理」。
脈絡窗口
脈絡窗口是指基礎模型在特定提示中可處理的詞元數量。脈絡窗口越大,模型就能存取及處理更多資訊,進而生成更連貫、相關且全面的回覆。
Gemini 模型專為處理大量資訊而設計,具備長脈絡窗口。舉例來說,如果模型的脈絡窗口支援 100 萬個詞元,就能處理下列任一輸入內容:
- 50,000 行程式碼 (每行標準長度為 80 個字元)
- 過去 5 年內傳送的所有簡訊
- 8 本平均長度的英文小說
- 超過 200 份平均長度的 Podcast 節目轉錄稿
- 1 小時無音訊影片
- 約 45 分鐘的影片 (含音訊)
- 9.5 小時的音訊
如要進一步瞭解長脈絡提示的最佳做法,請參閱「長脈絡」。
嵌入
嵌入是資料 (例如文字、圖片或影片) 的數值表示法,可擷取不同輸入內容之間的關係。嵌入是在模型訓練階段產生,方法是將文字、圖片和影片轉換為浮點數陣列,稱為「向量」。嵌入通常會降低資料維度,有助於提高運算效率,並處理大型資料集。降低維度對於訓練及部署複雜模型至關重要。
機器學習 (ML) 模型需要以可處理的格式表示資料。嵌入功能可將資料對應至連續向量空間,讓含義相近的資料點更靠近,進而滿足這項需求。嵌入可讓模型辨別原始資料中難以察覺的細微模式和關係。
舉例來說,大型語言模型 (LLM) 仰賴嵌入來理解文字的脈絡和意義。LLM 就能生成連貫且相關的回覆。在圖像生成中,嵌入項目會擷取圖像的視覺特徵,讓模型能建立逼真且多樣化的輸出內容。
使用檢索增強生成 (RAG) 的系統會依據嵌入,將使用者查詢與相關知識進行比對。提出查詢時,系統會將查詢轉換為嵌入,然後與知識庫中文件的嵌入進行比較。這項比對作業是透過向量空間中的相似度搜尋進行,可讓系統擷取語意最相關的資訊。
如要進一步瞭解嵌入模型和用途,請參閱「嵌入 API 總覽」。
基礎模型
基礎模型是大型且功能強大的模型,以大量資料訓練而成,通常涵蓋文字、圖片、影片和音訊等多種模態。這些模型會使用統計模型預測提示的可能回覆,並生成新內容。這些模型會從訓練資料中學習模式,例如用於生成文字的語言模式,以及用於生成圖像的擴散技術。
Google 提供多種生成式 AI 基礎模型,可透過代管 API 存取。如要存取 Google Cloud中可用的基礎模型,請使用 Vertex AI Model Garden。
呼叫函式
函式呼叫功能可將大型語言模型 (LLM) 連結至 API 和函式等外部工具,強化 LLM 的回覆。這項功能可讓 LLM 突破靜態知識的限制,並運用即時資訊和服務 (例如資料庫、客戶關係管理系統和文件存放區) 強化回覆。
如要使用呼叫函式,請提供一組函式給模型。接著,當您向模型提示時,模型會根據您的要求選取並呼叫函式。模型會分析提示,然後生成結構化資料,指定要呼叫的函式和參數值。結構化資料輸出內容會呼叫函式,然後將結果傳回模型。模型會將結果納入推論,生成回覆。模型可透過這個程序存取及運用內部知識以外的資訊,進而執行需要外部資料或處理的工作。
呼叫函式是 AI 代理架構的重要元件。呼叫函式可讓模型以結構化方式指定要使用的工具,以及輸入內容的格式,確保與外部系統精確互動。
如要進一步瞭解 Gemini 的呼叫函式功能,請參閱「呼叫函式簡介」。
生成式 AI
生成式 AI 是一種 AI,超越了傳統 AI 著重於分類和預測的範疇。傳統 AI 模型會從現有資料學習,根據歷史模式分類資訊或預測未來結果。生成式 AI 會使用基礎模型生成文字、圖片、音訊或影片等新內容。這類模型會學習訓練資料的基礎模式和風格,進而生成新內容,因此能有效建立與訓練資料相似的輸出內容。
進一步瞭解使用生成式 AI 的時機和生成式 AI 商業用途。
建立基準
建立基準是指將模型輸出內容連結至可驗證的資訊來源。這些來源可能提供實用且符合情境的資訊,例如公司內部文件、專案專屬資料或通訊記錄。建立基準可讓模型存取特定資料來源,進而提高 AI 輸出內容的準確性、可靠性和實用性。建立基準可降低幻覺發生的可能性,也就是模型生成與事實不符的內容。常見的建立基準方法是檢索增強生成 (RAG),也就是檢索相關外部資訊,強化模型的回覆。
如要進一步瞭解如何以 Google 搜尋強化事實基礎,請參閱「建立基準總覽」。
大型語言模型 (LLM)
大型語言模型 (LLM) 是以文字為基礎的基礎模型,以大量資料訓練而成。LLM 可用於執行自然語言處理 (NLP) 工作,例如生成文字、機器翻譯、生成文字摘要和回答問題。「LLM」LLM一詞有時會與「基礎模型」交替使用。不過,LLM 是以文字為基礎,而基礎模型則可透過多種模態 (包括文字、圖片、音訊和影片) 進行訓練及接收輸入內容。
為學習語言中的模式和關係,LLM 會使用強化學習和指令微調等技術。設計提示時,請務必考量可能影響模型回覆的各種因素。
延遲時間
延遲時間是指模型處理輸入提示並生成回覆所需的時間。檢查模型延遲時間時,請考量下列事項:
- 第一個詞元生成時間 (TTFT):模型收到提示後,生成第一個回覆詞元所需的時間。對於需要即時回饋的串流應用程式而言,TTFT 非常重要。
- 最後一個詞元生成時間 (TTLT):模型處理提示並生成完整回覆所需的總時間。
如要瞭解如何縮短延遲時間,請參閱「大型語言模型 (LLM) 的最佳做法」。
提示工程
提示工程是指建立提示並存取模型回覆,以取得所需回覆的反覆過程。撰寫結構良好的提示詞,是確保語言模型提供準確、高品質回覆的重要環節。
以下是可用來改善回覆的常見技巧:
- 零樣本提示:提供不含任何範例的提示,並仰賴模型現有的知識。
- 單樣本提示:在提示中提供單一樣本,引導模型生成回覆。
- 少量樣本提示:在提示中提供多個範例,展示您想要的模式或工作。
提供範例給模型,有助於控制模型回應的各個層面,例如格式、用詞、範圍和整體模式。有效的少量樣本提示會結合清楚的指令,以及具體且多樣化的範例。請務必多方嘗試,找出最佳樣本數量。樣本太少可能無法提供足夠的指引,但樣本太多可能會導致模型過度擬合樣本,無法妥善推論。
如要進一步瞭解提示的最佳做法,請參閱「提示策略總覽」。
提示
提示是傳送至生成式 AI 模型的自然語言要求,用於引導模型提供回覆。視模型而定,提示詞可包含文字、圖片、影片、音訊、文件和其他模態,甚至是多種模態 (多模態)。
有效的提示詞包含內容和結構。內容提供所有相關工作資訊,例如指令、範例和背景資訊。結構可確保透過組織 (包括排序、標籤和分隔符號) 有效剖析。視您需要的輸出內容而定,您可能需要考慮其他元件。
模型參數
模型參數是模型用來決定如何處理輸入資料和生成輸出內容的內部變數。在訓練期間,您可以調整模型參數 (例如權重和偏誤),將模型效能最佳化。在推論期間,您可以透過各種提示參數影響模型輸出內容,但這不會直接變更模型學到的參數。
以下是 Vertex AI Gemini API 中,會影響內容生成的提示參數:
temperature:溫度會改變生成回覆時選取詞元的隨機程度,進而影響輸出的創意和可預測性。temperature的值介於0到1之間。溫度越低 (越接近0),結果越確定且可預測。溫度越高 (越接近1),生成的文字越多元且有創意,但結果可能較不連貫。topP:Top-P 會影響模型取樣及選取輸出詞元的方式。Top-P 會選取累積機率超過門檻 (或p) 的最小詞元組合,然後從該分布中取樣。topP的值介於0到1之間。舉例來說,假設詞元 A、B 和 C 的可能性分別為 0.3、0.2 和 0.1,而topP值為0.5,模型會依據 temperature 選擇 A 或 B 做為下一個詞元,並排除 C。topK:Top-K 會影響模型取樣及選取輸出詞元的方式。Top-K 會選取統計上最有可能的詞元來生成回覆。topK的值代表1到40之間的詞元數量,模型會從中選擇,然後生成回覆。舉例來說,假設詞元 A、B、C 和 D 的可能性分別為 0.6、0.5、0.2 和 0.1,而 Top-K 值為3,模型會依據溫度參數選擇 A、B 或 C 做為下一個詞元,並排除 D。maxOutputTokens:maxOutputTokens設定會變更回覆中可生成的詞元數量上限。值越低,生成的回覆越短;值越高,生成的回覆可能越長。
如要進一步瞭解 Vertex AI 中 Gemini API 的取樣參數,請參閱「內容生成參數」。
檢索增強生成 (RAG)
檢索增強生成 (RAG) 技術可利用模型訓練後檢索到的知識來源建立基準,提升大型語言模型 (LLM) 輸出內容的品質和準確度。RAG 可解決 LLM 的限制,例如事實不準確、無法存取最新或專業資訊,以及無法引用來源。RAG 可讓 LLM 存取從可信知識庫或文件擷取的資訊,包括模型未經訓練的資料、專屬資料或私密使用者資料,進而生成更可靠且符合情境的回覆。
使用 RAG 的模型收到提示時,RAG 程序會完成下列階段:
- 擷取:搜尋與提示相關的資料。
- 增強:將檢索到的資料附加至提示。
- 生成:
- 指示 LLM 根據增強後的提示詞建立摘要或回覆。
- 傳回回應。
如要進一步瞭解 Vertex AI 和 RAG,請參閱「Vertex AI RAG Engine 總覽」。
個詞元
詞元是基礎模型處理的基本資料單位。模型會將提示中的資料拆分為詞元,以便處理。模型使用的所有符記組合稱為「詞彙」。詞元可以是單一字元 (例如 z)、完整字詞 (例如 cat),或較長字詞的一部分。
斷詞器會將長字詞 (例如複雜或技術用語、複合字詞,或含有標點符號和特殊字元的字詞) 拆分為多個詞元。將文字拆分為詞元的程序稱為「斷詞」。符記化的目標是建立具有語意意義的符記,這些符記可以重新組合,以理解原始字詞。舉例來說,「predefined」一詞可以拆分為下列符記:「pre」、「define」、「ed」。
詞元可以代表圖片、影片和音訊等多模態輸入內容。嵌入技術會將多模態輸入內容轉換為數值表示法,讓模型能以詞元形式處理。以下是多模態輸入範例的大約詞元計算方式,不論顯示或檔案大小為何:
- 圖片:共 258 個詞元
- 影片:每秒 263 個詞元
- 音訊:每秒 32 個詞元
每個模型在提示和回覆中可處理的詞元數量都有上限。此外,模型使用費用是根據輸入和輸出詞元數量計算。如要瞭解如何取得傳送至 Gemini 模型的提示詞元數量,請參閱「列出和計算詞元數」。如要瞭解 Vertex AI 的生成式 AI 模型費用,請參閱「Vertex AI 定價」。
調整
調整是指調整基礎模型,讓模型更精準地執行特定工作。調整模型時,可以調整部分或所有模型參數,或使用資料集訓練模型,資料集內含的範例會複製您要的工作和結果。調整是疊代程序,可能複雜且成本高昂,但有機會大幅提升效能。如果標籤資料集有超過 100 個範例,且您想執行複雜或獨特的工作,但提示技術不足以達成目標,則調整模型最有效。
Vertex AI 支援下列調整技術:
- 全量微調:在調整過程中更新模型所有參數的技術。全量微調可能需要大量運算資源和資料,但也有可能達到最高效能,特別是在處理複雜工作時。
- 高效參數調整:這項技術也稱為適應器調整,會在調整過程中更新模型的部分參數。與全量微調相比,高效參數調整更節省資源,也更具成本效益。
- 監督式微調:使用加上標籤的輸入/輸出組合訓練模型的技術。監督式微調通常用於分類、翻譯和摘要等工作。
如要進一步瞭解調整,請參閱「調整簡介」。