


Der Zweck einer Hochverfügbarkeitskonfiguration besteht darin, Ausfallzeiten zu reduzieren, wenn eine Datenbankclusterinstanz nicht mehr verfügbar ist. Dies kann passieren, wenn einer Instanz der Arbeitsspeicher ausgeht. Mit Hochverfügbarkeit sind Ihre Daten weiterhin für Clientanwendungen verfügbar.
Innerhalb eines Standorts besteht die Konfiguration aus einer primären Instanz und einem Standby-Replikat. Alle an der primären Instanz ausgeführten Schreibvorgänge werden auf das Stand-by-Replikat repliziert, bevor eine Transaktion als Commit gemeldet wird. Wenn Ihre primäre Instanz nicht mehr verfügbar ist, stuft GDC das Stand-by-Replikat automatisch zur neuen primären Instanz hoch. Der Anwendungs-Traffic wird dann zur neuen primären Instanz umgeleitet. Dieser Vorgang wird als Failover bezeichnet.
Ein automatisches Failover wird nach drei aufeinanderfolgenden Fehlern bei der Systemdiagnose auf der primären Instanz gestartet, die jeweils 30 Sekunden auseinanderliegen.
GDC unterstützt sowohl automatisches als auch manuelles Failover. Das automatische Failover ist standardmäßig aktiviert. Sie können es bei Bedarf deaktivieren. Sie können auch jederzeit manuell ein Failover auslösen, um nach einem unerwarteten Fehler eine schnelle Wiederherstellung sowie eine geringe Ausfallzeit zu erreichen.
Das Failover umfasst die folgenden Schritte in der angegebenen Reihenfolge:
GDC nimmt die primäre Instanz offline.
GDC wandelt das Stand-by-Replikat in den neuen aktiven Datenbankcluster um.
GDC löscht den vorherigen aktiven Datenbankcluster.
GDC erstellt ein neues Stand-by-Replikat.
Vorhandenen Cluster aktualisieren
Sie können die Hochverfügbarkeitseinstellungen für einen vorhandenen Datenbankcluster aktualisieren:
Console
Wählen Sie im Navigationsmenü Datenbankdienst aus.
Klicken Sie in der Liste der Datenbankcluster auf den Datenbankcluster, den Sie aktualisieren möchten.
Wählen Sie im Abschnitt Hochverfügbarkeit die Option Bearbeiten Bearbeiten aus.
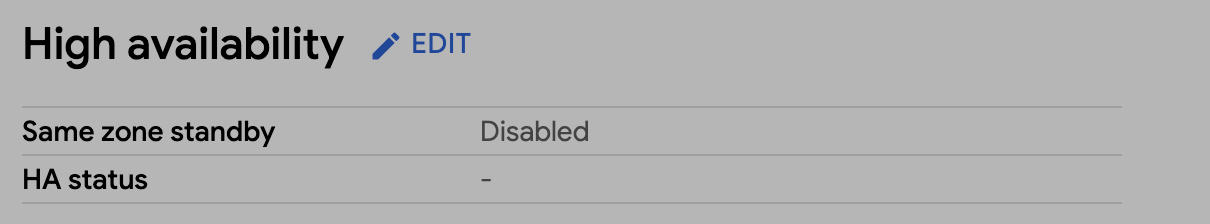
Wählen Sie Stand-by-Instanz in derselben Zone aktivieren aus, um die Verfügbarkeit einer Stand-by-Instanz in derselben Zone wie Ihr primärer Datenbankcluster zu aktivieren oder zu deaktivieren.
Klicken Sie auf Speichern.
Prüfen Sie, ob die Hochverfügbarkeitsaktualisierung für Ihren Datenbankcluster übernommen wurde. Sehen Sie sich dazu den Status in der Spalte Hochverfügbarkeit der Datenbankclusterliste an.
gdcloud
Aktualisieren Sie die Hochverfügbarkeitskonfiguration Ihres Datenbankclusters:
gdcloud database clusters update CLUSTER_NAME \
    --availability-type HA_TYPE
Ersetzen Sie Folgendes:
CLUSTER_NAME: Der Name des Datenbankclusters.HA_TYPE: die Hochverfügbarkeitsstufe für den Datenbankcluster. Sie könnenzonaloderzonal_hafestlegen. Der Wertzonalist standardmäßig festgelegt.
Prüfen Sie, ob Ihr Datenbankcluster das Hochverfügbarkeitsupdate widerspiegelt:
gdcloud database clusters list
API
Aktualisieren Sie die Hochverfügbarkeitskonfiguration Ihres Datenbankclusters:
  kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
    -n USER_PROJECT \
    -p '{"spec": {"availability": {"enableHighAvailability": HA_ENABLED}}}' \
    --type=merge
Ersetzen Sie die folgenden Variablen:
DBCLUSTER_NAME: Der Name des Datenbankclusters.USER_PROJECT: der Name des Nutzerprojekts, in dem der Datenbankcluster erstellt wurde.HA_ENABLED: die Hochverfügbarkeitsstufe für den Datenbankcluster. Sie könnentrueoderfalsefestlegen. Der Wertfalseist standardmäßig festgelegt.
Prüfen Sie, ob Ihr Datenbankcluster das Hochverfügbarkeitsupdate widerspiegelt:
kubectl get dbcluster.DBENGINE_NAME.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -o yaml
Zur neuesten Hochverfügbarkeitsimplementierung migrieren
Wenn Sie prüfen möchten, ob Ihr Hochverfügbarkeits-Datenbankcluster die neueste Implementierung verwendet, prüfen Sie, ob die Annotation dbcluster.dbadmin.goog/raasEnabled in der CR Ihres Hochverfügbarkeits-Datenbankclusters vorhanden ist. Diese Annotation wird nur in Clustern angezeigt, die die neue Implementierung verwenden. Wenn Sie diese Annotation nicht haben, können Sie sie aktivieren und Ihren Cluster mit den folgenden Schritten migrieren:
- Fragen Sie Ihren Infrastrukturbetreiber, ob Ihre GDC-Umgebung auf Version 1.15.1 oder höher aktualisiert wurde.
- Deaktivieren Sie die Hochverfügbarkeit für Ihren Datenbankcluster. Warten Sie, bis die Bedingung
HAReadynicht mehr angezeigt wird, und aktivieren Sie dann die Hochverfügbarkeit wieder. - Wenn
HAReady in progressoderHAReady setup completeangezeigt wird, prüfen Sie die CR des Datenbankclusters auf die Annotationdbcluster.dbadmin.goog/raasEnabled. Wenn er angezeigt wird, wurde Ihr Datenbankcluster erfolgreich migriert.
Failover auslösen
Wenn Sie Hochverfügbarkeit für Ihren Datenbankcluster konfiguriert haben, können Sie ein Failover auslösen. Führen Sie die folgenden Schritte aus, um ein Failover auszulösen:
Console
Wählen Sie im Navigationsmenü Datenbankdienst aus.
Klicken Sie in der Liste der Datenbankcluster auf den Datenbankcluster, für den Sie ein Failover auslösen möchten. Für Ihren Datenbankcluster muss die Hochverfügbarkeit aktiviert sein, damit ein Failover möglich ist.
Klicken Sie auf Failover.
Geben Sie die ID des Clusters für die Bestätigungsphrase ein und klicken Sie auf Failover, um den Failover-Prozess auszulösen.
gdcloud
Lösen Sie das Failover für den Datenbankcluster aus:
gdcloud database clusters failover CLUSTER_NAME
Ersetzen Sie CLUSTER_NAME durch den Namen des Datenbankclusters.
API
  apiVersion: fleet.dbadmin.gdc.goog/v1
  kind: Failover
  metadata:
    name: FAILOVER_NAME
    namespace: USER_PROJECT
  spec:
    dbclusterRef: DBCLUSTER_NAME
Ersetzen Sie die folgenden Variablen:
DBCLUSTER_NAME: der Name des Datenbankclusters.USER_PROJECT: der Name des Nutzerprojekts, in dem der Datenbankcluster erstellt wurde.FAILOVER_NAME: der eindeutige Name des Failovers, z. B.failover-sample.
Automatischen Failover deaktivieren
Automatisches Failover ist standardmäßig für Datenbankcluster mit Hochverfügbarkeit aktiviert.
Wenn Sie das automatische Failover deaktivieren möchten, setzen Sie im Manifest des Datenbankclusters enableAutoFailover auf false:
spec:
  availability:
    enableAutoFailover: false
Führen Sie den folgenden Befehl aus, um die automatische Failover-Konfiguration für einen vorhandenen Datenbankcluster mithilfe der API zu aktualisieren:
kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -p '{"spec": {"availability": {"enableAutoFailover": AUTO_FAILOVER_ENABLED}}}' \
  --type=merge
Ersetzen Sie die folgenden Variablen:
DBCLUSTER_NAME: Der Name des Datenbankclusters.USER_PROJECT: Der Name des Nutzerprojekts, in dem der Datenbankcluster erstellt wurde.AUTO_FAILOVER_ENABLED: die Einstellung für den automatischen Failover für den Datenbankcluster. Sie könnentrueoderfalsefestlegen. Der Werttrueist standardmäßig festgelegt.