


Google Distributed Cloud(GDC)エアギャップ アプライアンスのアラート モニタリングを使用すると、アラートルールを作成した後に、プロジェクト全体でアクティブな通知を追跡してトラブルシューティングできます。アラートの重大度、期間、ステータス、ラベルは、GDC コンソールで確認できます。スクリプト、cron ジョブ、カスタム統合の場合は、curl を使用してプロジェクトの Cortex Alertmanager HTTP エンドポイントにクエリを実行します。
始める前に
アラートのクエリと可視化に必要な権限を取得するには、プロジェクトの IAM 管理者に、プロジェクトの名前空間に関連付けられた Project Cortex Alertmanager ロールのいずれかを付与するよう依頼します。必要なアクセスレベルと権限に応じて、プロジェクト内のこのリソースの編集者ロールまたは閲覧者ロールを取得できます。
ログのエクスポートに必要な権限を取得するには、プロジェクト IAM 管理者にプロジェクト Grafana 閲覧者(project-grafana-viewer)ロールを付与するよう依頼してください。このロールベース アクセス制御プロセスにより、データの可視化に安全にアクセスできます。これらのロールの詳細については、IAM 権限を準備するをご覧ください。
次の表に、PA and AO persona の Role 要件をまとめます。
| ペルソナ | オブジェクト | クラスタ | ロール | 名前空間 | グループ / ユーザー | 構成 |
|---|---|---|---|---|---|---|
| PA | alertmanager | org-admin | project-cortex-alertmanager-viewer |
platform-obs | グループ | 1 |
| PA | alertmanager | org-admin | project-cortex-alertmanager-viewer |
platform-obs | ユーザー | 2 |
| AO | alertmanager | org-admin | project-cortex-alertmanager-viewer |
PROJECT_NAMESPACE | グループ | 1 |
| AO | alertmanager | org-admin | project-cortex-alertmanager-viewer |
PROJECT_NAMESPACE | ユーザー | 2 |
次の変数を適切に置き換えます。
| 変数 | 説明 |
|---|---|
KUBECONFIG |
この RoleBinding が適用される NAMESPACE を含む特定のクラスタの kubeconfig が必要になります。 |
RULE_NAME |
Namespace 内のこの RoleBinding リソースの一意の名前。例: pa-cortex-alertmanager-viewer |
NAMESPACE |
この RoleBinding が作成され、適用される Kubernetes Namespace。前の表の Namespace 列を探します。 |
EMAIL_ADDRESS |
ロールが付与されるユーザーの ID。通常はメールアドレスです。例: platform-administrator@example.com |
ROLE |
ユーザーに付与する権限を含む Role の名前。前の表で利用可能なロールを探します。 |
GROUP_NAME |
PA/AO ユーザーが所属する Group の名前。例: pa-group |
ZONE |
ゾーンの名前 |
構成 1
この構成により、org クラスタの PA/AO アラートにアクセスする権限がユーザー グループに付与されます。この構成を設定したら、このドキュメントのコンソール セクションを参照して、GDC コンソールでアラートを表示します。
kubectl コマンド
一般的なコマンド形式は次のとおりです。
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n `NAMESPACE` --group=`GROUP_NAME` --role=project-cortex-alertmanager-viewer例:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-cortex-alertmanager-viewer-binding --role=project-cortex-alertmanager-viewer --group=my-team --namespace=platform-obsYaml ファイル
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: RULE_NAME
  namespace: NAMESPACE
subjects:
- kind: Group
  name: GROUP_NAME
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: project-cortex-alertmanager-viewer
  apiGroup: rbac.authorization.k8s.io
構成 2
この構成により、org クラスタ内の PA/AO アラートにアクセスする権限がユーザーに付与されます。この構成を設定したら、このドキュメントのコンソール セクションを参照して、GDC コンソールでアラートを表示します。
kubectl コマンド
一般的なコマンド形式は次のとおりです。
kubectl --kubeconfig `KUBECONFIG` create rolebinding `RULE_NAME` -n `NAMESPACE` --user=`EMAIL_ADDRESS` --role=project-cortex-alertmanager-viewer例:
kubectl --kubeconfig <path-to-kubeconfig> create rolebinding project-cortex-alertmanager-viewer-binding --role=project-cortex-alertmanager-viewer --user=my-email@example.com --namespace=platform-obsIAC ファイルパス
/infrastructure/zonal/zones/`ZONE`/org-admin/rolebindings/`EMAIL_ADDRESS`/<YAML_FILE>Yaml ファイル
apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: RULE_NAME namespace: NAMESPACE subjects: - kind: User name: EMAIL_ADDRESS apiGroup: rbac.authorization.k8s.io roleRef: kind: Role name: project-cortex-alertmanager-viewer apiGroup: rbac.authorization.k8s.ioこれらのロールの詳細については、IAM 権限を準備するをご覧ください。
Grafana エンドポイント
アプリケーション オペレーター(AO)の場合:
次の URL を開いて、プロジェクトのエンドポイントにアクセスします。
https://GDC_URL/PROJECT_NAMESPACE/grafana
次のように置き換えます。
- GDC_URL: GDC の組織の URL。
- PROJECT_NAMESPACE: プロジェクトの Namespace。
プロジェクトの UI には、アラートに関する情報を含む [アラート - 概要] ダッシュボードなどのデフォルトのダッシュボードが含まれています。UI からアラートをクエリすると、プロジェクトからアラート情報を視覚的に取得し、リソースの統合ビューを取得して、問題を認識して迅速に解決できます。
プラットフォーム管理者(PA)の場合:
次の URL を開いて、platform-obs プロジェクトのエンドポイントにアクセスします。
https://GDC_URL/platform-obs/grafana
GDC_URL は、GDC の組織の URL に置き換えます。
システム モニタリング インスタンスのユーザー インターフェース(UI)には、データ オブザーバビリティのアラートに関する情報を含む [Alerts - Overview] ダッシュボードなどのデフォルトのダッシュボードが含まれています。UI からアラートをクエリすると、プロジェクトからアラート情報を視覚的に取得し、リソースの統合ビューを取得して、問題を認識して迅速に解決できます。
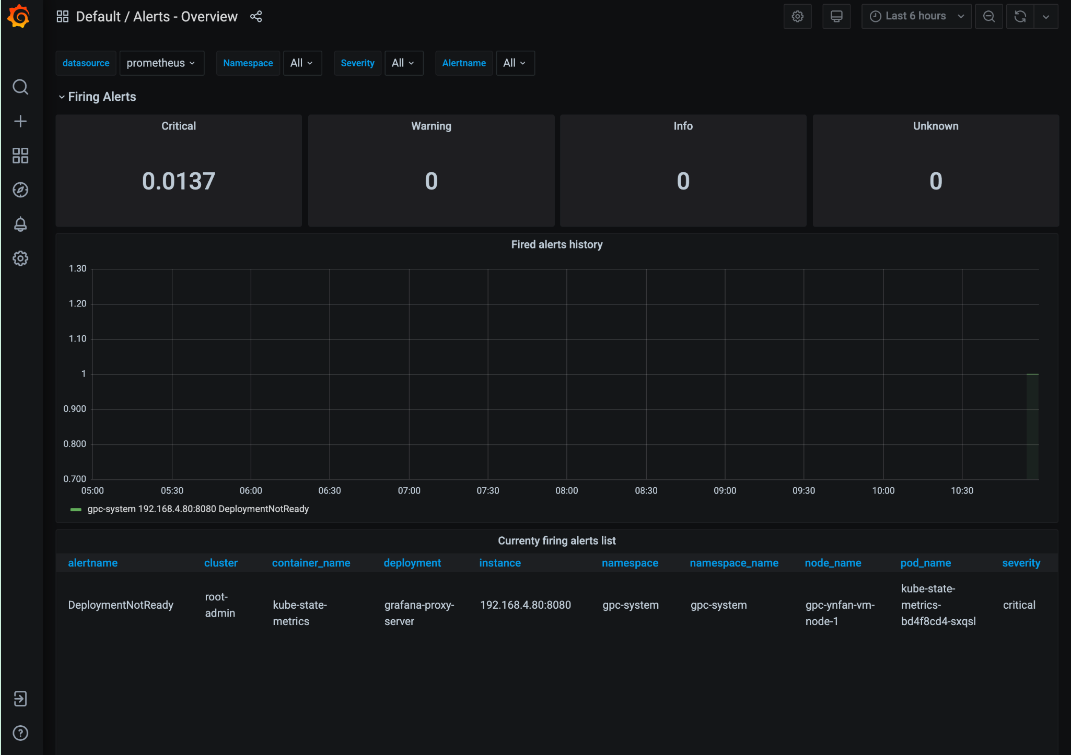
図 1. Grafana UI の [Alerts - Overview] ダッシュボード。
オープン・アラートを表示してフィルタする
次のいずれかの方法を選択して、プロジェクトの名前空間から未解決のアラートをクエリしてフィルタします。
コンソール
GDC コンソールからプロジェクトの未対応のアラートを表示します。
- GDC コンソールにログインします。
- GDC コンソールで、プロジェクトを選択します。
- ナビゲーション メニューで、[オペレーション] > [アラート] を選択します。
- [アラート] タブを選択します。
- アラートのリストを表示します。
- [Alerts opened] セクションで、[Filter] をクリックして、オープン状態のアラートのみを表示します。他のプロパティ名または値でアラートをフィルタすることもできます。
- アラート名をクリックすると、アラートの詳細が表示されます。
Cortex エンドポイント
このセクションでは、Cortex Alertmanager エンドポイントを使用してアラートにアクセスする方法について説明します。
Cortex エンドポイントを特定する
次の URL は、プロジェクトの Cortex インスタンスのエンドポイントです。
https://GDC_URL/PROJECT_NAMESPACE/cortex/alertmanager/
次のように置き換えます。
GDC_URL: GDC の組織の URL。PROJECT_NAMESPACE: プロジェクトの名前空間。たとえば、
org-1組織のplatform-obsプロジェクトの Cortex エンドポイントはhttps://org-1/platform-obs/cortex/alertmanager/です。
curl リクエストを認証する
- gdcloud CLI をダウンロードしてインストールします。
gdcloud
core/organization_console_urlプロパティを設定します。gdcloud config set core/organization_console_url https://GDC_URL-
gdcloud auth login ユーザー名とパスワードを使用して認証し、ログインします。
ログインに成功すると、
gdcloud auth print-identity-tokenコマンドを使用して cURL リクエストで認証ヘッダーを使用できます。詳細については、gdcloud auth をご覧ください。
Cortex エンドポイントを呼び出す
curl ツールを使用して Cortex エンドポイントにアクセスするには、次の手順を行います。
curlリクエストを認証する。curlを使用して Cortex エンドポイントを呼び出し、標準の Alertmanager API 仕様(https://prometheus.io/docs/prometheus/latest/querying/api/#alertmanagers)を使用して URL を拡張し、アラートをクエリします。curlリクエストの例を次に示します。curl https://GDC_URL/PROJECT_NAME/cortex/alertmanager/api/v1/alertmanagers \ -H "Authorization: Bearer $(gdcloud auth print-identity-token \ --audiences=https://GDC_URL)"コマンドの後に、次のような出力が表示されます。API レスポンスは JSON 形式です。
Alertmanager
Alertmanager を使用すると、クライアント アプリケーションからのアラート通知をモニタリングできます。Alertmanager を使用してアラートを検査してミュートし、アラートをフィルタまたはグループ化できます。
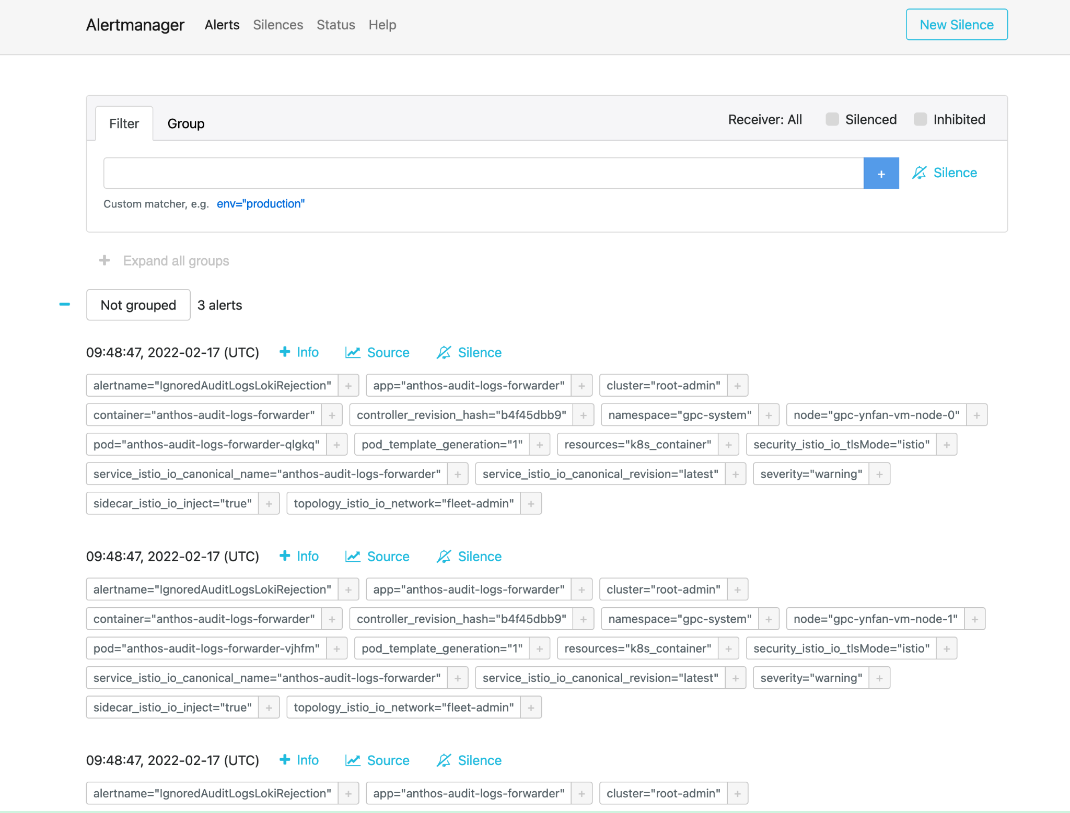
図 2. Alertmanager から監査ログをクエリするメニュー オプション。
事前定義されたアラート ポリシー
次の表に、Prometheus にプリインストールされているアラートルールを示します。
| 名前 | 説明 |
|---|---|
| KubeAPIDown(重大) | KubeAPI が Prometheus ターゲット検出から 15 分間消えています。 |
| KubeClientErrors(警告) | Kubernetes API サーバーのクライアント エラー率が 15 分間で 0.01 を超えています。 |
| KubeClientErrors(重大) | Kubernetes API サーバーのクライアント エラー率が 15 分間にわたって 0.1 を超えています。 |
| KubePodCrashLooping(警告) | Pod が 15 分以上クラッシュ ループ状態になっている。 |
| KubePodNotReady(警告) | Pod の準備ができていない状態が 15 分以上続いています。 |
| KubePersistentVolumeFillingUp(重大) | 要求された PersistentVolume の空きバイト数 < 0.03。 |
| KubePersistentVolumeFillingUp(警告) | 要求された PersistentVolume の空きバイト数 < 0.15。 |
| KubePersistentVolumeErrors(重大) | 永続ボリュームが 5 分間、Failed または Pending フェーズになっている。 |
| KubeNodeNotReady(警告) | ノードが 15 分以上準備できていない。 |
| KubeNodeCPUUsageHigh(重大) | ノードの CPU 使用率が 80% を超えている。 |
| KubeNodeMemoryUsageHigh(重大) | ノードのメモリ使用量が 80% を超えています。 |
| NodeFilesystemSpaceFillingUp(警告) | ノードのファイル システムの使用率が 60% を超えている。 |
| NodeFilesystemSpaceFillingUp(重大) | ノードのファイル システムの使用率が 85% を超えている。 |
| CertManagerCertExpirySoon(警告) | 証明書の有効期限が 21 日後に切れます。 |
| CertManagerCertNotReady(重大) | 10 分経過しても証明書がトラフィックを処理する準備ができていない。 |
| CertManagerHittingRateLimits(重大) | 証明書の作成と更新のレート制限に 5 分間達しました。 |
| DeploymentNotReady(重大)。 | 組織管理クラスタの Deployment が 15 分以上準備完了状態になっていません。 |
alertmanagerConfigurationConfigmaps のサンプル
alertmanagerConfigurationConfigmaps が一覧表示する ConfigMap の構成の構文は、https://prometheus.io/docs/alerting/latest/configuration/ に従う必要があります。
apiVersion: observability.gdc.goog/v1alpha1
kind: ObservabilityPipeline
metadata:
  # Choose namespace that matches the project's namespace
  namespace: kube-system
  name: observability-config
# Configure Alertmanager
 alerting:
  # Storage size for alerting data within organization
  # Permission: PA
  localStorageSize: 1Gi

  # Permission: PA & AO
  # alertmanager config must be under the key "alertmanager.yml" in the configMap
  alertmanagerConfig: <configmap-for-alertmanager-config>

  # Permission: PA
  volumes:
    - <volume referenced in volumeMounts>

  # Permission: PA
  volumeMounts:
    - <volumeMount referenced in alertmanagerConfig>
ルール構成の例
# Configures either an alert or a target record for precomputation
apiVersion: monitoring.gdc.goog/v1alpha1
kind: MonitoringRule
metadata:
  # Choose namespace that contains the metrics that rules are based on
  # Note: alert/record will be produced in the same namespace
  namespace: g-fleetns-a
  name: alerting-config
spec:
  # Rule evaluation interval
  interval: <duration>

  # Configure limit for number of alerts (0: no limit)
  # Optional, Default: 0 (no limit)
  limit: <int>

  # Configure record rules
  recordRules:
    # Define which timeseries to write to (must be a valid metric name)
  - record: <string>

    # Define PromQL expression to evaluate for this rule
    expr: <string>

    # Define labels to add or overwrite
    # Optional, Map of {key, value} pairs
    labels:
      <labelname>: <labelvalue>

  # Configure alert rules
  alertRules:
    # Define alert name
  - alert: <string>

    # Define PromQL expression to evaluate for this rule
    # https://prometheus.io/docs/prometheus/latest/configuration/alerting_rules/
    expr: <string>

    # Define when an active alert moves from pending to firing
    # Optional, Default: 0s
    for: <duration>

    # Define labels to add or overwrite
    # Required, Map of {key, value} pairs
    # Required labels:
    #     severity: [error, critical, warning, info]
    #     code:
    #     resource: component/service/hardware related to alert
    #     additional labels are optional
    labels:
      severity: <enum: [error, critical, warning, info]>
      code:
      resource: <Short name of the related operable component>
      <labelname>: <tmpl_string>

    # Define annotations to add
    # Optional, Map of {key, value} pairs
    # Recommended annotations:
    #     message: value of Message field in UI
    #     expression: value of Rule field in UI
    #     runbookurl: URL for link in Actions to take field in UI
    annotations:
      <labelname>: <tmpl_string>
# Configures either an alert or a target record for precomputation
apiVersion: logging.gdc.goog/v1alpha1
kind: LoggingRule
metadata:
  # Choose namespace that contains the logs that rules are based on
  # Note: alert/record will be produced in the same namespace
  namespace: g-fleetns-a
  name: alerting-config
spec:
  # Choose which log source to base alerts on (Operational/Audit/Security Logs)
  # Optional, Default: Operational
  source: <string>

  # Rule evaluation interval
  interval: <duration>

  # Configure limit for number of alerts (0: no limit)
  # Optional, Default: 0 (no limit)
  limit: <int>

  # Configure record rules
  recordRules:
    # Define which timeseries to write to (must be a valid metric name)
  - record: <string>

    # Define LogQL expression to evaluate for this rule
    # https://grafana.com/docs/loki/latest/rules/
    expr: <string>

    # Define labels to add or overwrite
    # Optional, Map of {key, value} pairs
    labels:
      <labelname>: <labelvalue>

  # Configure alert rules
  alertRules:
    # Define alert name
  - alert: <string>

    # Define LogQL expression to evaluate for this rule
    expr: <string>

    # Define when an active alert moves from pending to firing
    # Optional, Default: 0s
    for: <duration>

    # Define labels to add or overwrite
    # Required, Map of {key, value} pairs
    # Required labels:
    #     severity: [error, critical, warning, info]
    #     code:
    #     resource: component/service/hardware related to alert
    #     additional labels are optional
    labels:
      severity: <enum: [error, critical, warning, info]>
      code:
      resource: <Short name of the related operable component>
      <labelname>: <tmpl_string>

    # Define annotations to add
    # Optional, Map of {key, value} pairs
    # Recommended annotations:
    #     message: value of Message field in UI
    #     expression: value of Rule field in UI
    #     runbookurl: URL for link in Actions to take field in UI
    annotations:
      <labelname>: <tmpl_string>
HTTP API からアラートをクエリする
Observability プラットフォームは、システム モニタリングのためにプロジェクトから指標、アラート、その他の時系列データをクエリして読み取るための HTTP API エンドポイントを公開します。Observability HTTP API から直接アラートをクエリして、自動化されたタスクを設定し、レスポンスを調整して、ユースケースに応じて統合を構築します。たとえば、出力を別のコマンドに挿入したり、詳細をテキスト ファイル形式にエクスポートしたり、Linux の cron ジョブを構成したりできます。Observability HTTP API は、コマンドライン インターフェース(CLI)またはウェブブラウザから呼び出して、結果を JSON 形式で取得できます。
このセクションでは、API 仕様を使用して、CLI から Observability HTTP API エンドポイントを呼び出し、アラートをクエリする方法について説明します。
Observability HTTP API から直接アラートをクエリして、自動化されたタスクを設定し、レスポンスを調整して、ユースケースに応じて統合を構築します。たとえば、出力を別のコマンドに挿入したり、詳細をテキスト ファイル形式にエクスポートしたり、Linux の cron ジョブを構成したりできます。Observability HTTP API は、コマンドライン インターフェース(CLI)またはウェブブラウザから呼び出して、結果を JSON 形式で取得できます。
このセクションでは、Alertmanager API 仕様を使用して CLI から Observability HTTP API エンドポイントを呼び出し、指標をクエリする方法について説明します。
始める前に
オブザーバビリティ HTTP API エンドポイントにアクセスするために必要な権限を取得するには、プロジェクトの IAM 管理者に、プロジェクトの名前空間でプロジェクト Cortex Alertmanager 閲覧者(project-cortex-alertmanager-viewer)ロールを付与するよう依頼してください。
プロジェクト IAM 管理者は、ロール バインディングを作成することでアクセス権を付与できます。
a. インフラストラクチャ オペレーター(IO)ルート管理者 - Project Cortex Alertmanager Viewer:
kubectl --kubeconfig $HOME/root-admin-kubeconfig create rolebinding
io-cortex-alertmanager-viewer-binding -n infra-obs
--user=fop-infrastructure-operator@example.com
--role=project-cortex-alertmanager-viewer
b. プラットフォーム管理者(PA)ルート管理者 - Project Cortex Alertmanager Viewer:
kubectl --kubeconfig $HOME/root-admin-kubeconfig create rolebinding
pa-cortex-alertmanager-viewer-binding -n platform-obs
--user=fop-platform-admin@example.com
--role=project-cortex-alertmanager-viewer
c. アプリケーション オペレーター(AO)ルート管理者 - プロジェクト Cortex Alertmanager 閲覧者: プロジェクト: $AO_PROJECT AO ユーザー名: $AO_USER
kubectl --kubeconfig $HOME/root-admin-kubeconfig create rolebinding
project-cortex-alertmanager-viewer-binding -n $AO_PROJECT
--user=$AO_USER
--role=project-cortex-alertmanager-viewer
ロール バインディングが作成されると、ログイン ユーザー名を使用して対応する Alertmanager にアクセスできます。
ロール バインディングを確認する
kubectl --kubeconfig $HOME/org-1-admin-kubeconfig get rolebinding -n platform-obs
GDC コンソールからロール バインディングを設定する方法については、リソースへのアクセス権を付与するをご覧ください。
Cortex エンドポイント
次の URL は、アラートにアクセスするための Cortex エンドポイントです。
https://GDC_URL/PROJECT_NAME/cortex/alertmanager/
次のように置き換えます。
- GDC_URL: GDC の組織の URL。
- PROJECT_NAME: プロジェクトの名前。
API エンドポイントを呼び出す
CLI から Cortex API エンドポイントにアクセスしてアラートをクエリする手順は次のとおりです。
- 前提条件を満たしていることを確認します。
- CLI を開きます。
curlツールを使用して Cortex エンドポイント URL を呼び出し、標準の https://prometheus.io/docs/prometheus/latest/querying/api/#alertmanagers を使用して URL を拡張し、アラートをクエリします。次に例を示します。curl https://console.org-1.zone1.google.gdch.test/alice/cortex/alertmanager/api/v1/alertmanagers
コマンドに続いて CLI に出力が表示されます。API レスポンスの形式は JSON です。