


O reconhecimento óptico de caracteres (OCR) é uma API pré-treinada da Vertex AI no dispositivo com isolamento físico do Google Distributed Cloud (GDC) que permite detectar e extrair texto de tipos de arquivo compatíveis, incluindo imagens, documentos e notas manuscritas. É possível processar solicitações de imagens e documentos inline em idiomas compatíveis.
Métodos de reconhecimento óptico de caracteres
O OCR oferece os seguintes métodos disponíveis no dispositivo GDC com isolamento físico para reconhecer texto:
| Método | Descrição |
|---|---|
BatchAnnotateImages |
Detectar texto de um lote de imagens JPEG ou PNG fornecidas em uma solicitação inline. |
BatchAnnotateFiles |
Detectar texto de um lote de arquivos PDF ou TIFF fornecidos em uma solicitação inline. |
Recursos de reconhecimento óptico de caracteres
A API OCR pode detectar e extrair texto de imagens. Os dois recursos de anotação a seguir são compatíveis com o reconhecimento óptico de caracteres:
TEXT_DETECTIONdetecta e extrai texto de qualquer imagem. Por exemplo, uma fotografia pode conter uma rua ou uma placa de trânsito. O serviço de OCR retorna um arquivo JSON com a string extraída, as palavras individuais e as caixas delimitadoras delas.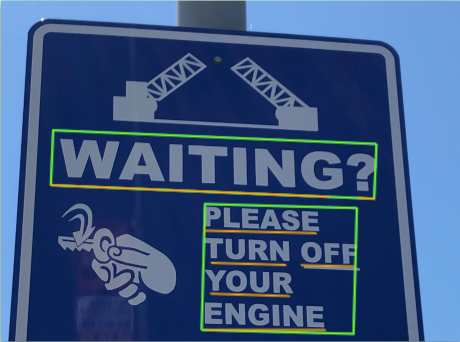
Figura 1. Fotografia de placa de trânsito em que a API OCR detecta palavras e as caixas delimitadoras delas.
A
DOCUMENT_TEXT_DETECTIONtambém extrai texto de uma imagem, mas o serviço otimiza a resposta para textos e documentos densos. Por exemplo, uma imagem digitalizada de texto digitado pode conter vários parágrafos e títulos. O serviço de OCR retorna um arquivo JSON com informações de página, bloco, parágrafo, palavra e quebra.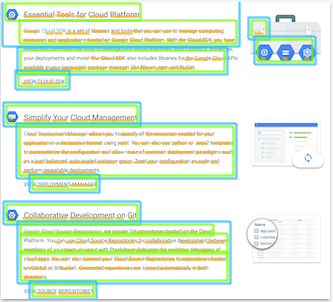
Figura 2. Imagem digitalizada de texto digitado em que a API OCR detecta informações como palavras, páginas e parágrafos.
Texto escrito à mão
A Figura 3 é uma imagem de texto escrito à mão. A API OCR detecta e extrai texto dessas imagens. Para uma lista de scripts de escrita manual que oferecem suporte ao reconhecimento de escrita manual, consulte Scripts de escrita manual.
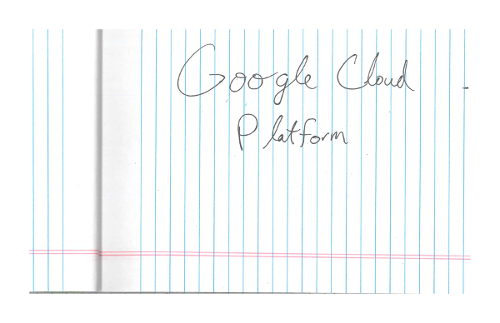
Figura 3. Imagem de escrita à mão em que a API OCR detecta texto.
Limites de reconhecimento óptico de caracteres
É possível reconhecer até 30 imagens por minuto, o equivalente a uma imagem a cada dois segundos por unidade de dispositivo.
Os métodos de API BatchAnnotateImages e BatchAnnotateFiles só aceitam uma
solicitação por chamada em lote.
A tabela a seguir lista os limites atuais do serviço de OCR no Distributed Cloud.
| Limite de arquivos para OCR | Valor |
|---|---|
| Número máximo de páginas | Cinco |
| Tamanhos máximos dos arquivos | 20 MB |
| Tamanho máximo da imagem | 20 milhões de pixels (comprimento x largura) |
Os arquivos enviados para a API OCR que excedem o número máximo de páginas ou o tamanho máximo de arquivo retornam um erro. Os arquivos enviados que excedem o tamanho máximo de imagem são reduzidos para 20 milhões de pixels.
Tipos de arquivo compatíveis com OCR
A API pré-treinada de OCR detecta e transcreve textos dos seguintes tipos de arquivo:
- TIFF
- JPG
- PNG
Armazene os arquivos localmente no ambiente do Distributed Cloud. Não é possível acessar arquivos hospedados no Cloud Storage ou arquivos disponíveis publicamente para detecção de texto.