


Il riconoscimento ottico dei caratteri (OCR) è un'API Vertex AI pre-addestrata nell'appliance Google Distributed Cloud (GDC) con air gap che consente di rilevare ed estrarre testo dai tipi di file supportati, tra cui immagini, documenti e note scritte a mano. Puoi elaborare richieste di immagini e documenti incorporati nelle lingue supportate.
Metodi di riconoscimento ottico dei caratteri
L'OCR offre i seguenti metodi disponibili nell'appliance GDC con air gap per riconoscere il testo:
| Metodo | Descrizione |
|---|---|
BatchAnnotateImages |
Rileva il testo da un gruppo di immagini JPEG o PNG fornite in una richiesta in linea. |
BatchAnnotateFiles |
Rileva il testo da un gruppo di file PDF o TIFF forniti in una richiesta in linea. |
Funzionalità di riconoscimento ottico dei caratteri
L'API OCR può rilevare ed estrarre il testo dalle immagini. Le seguenti due funzionalità di annotazione supportano il riconoscimento ottico dei caratteri:
TEXT_DETECTIONrileva ed estrae il testo da qualsiasi immagine. Ad esempio, una fotografia potrebbe contenere un segnale stradale o un cartello. Il servizio OCR restituisce un file JSON con la stringa estratta, le singole parole e i relativi riquadri di delimitazione.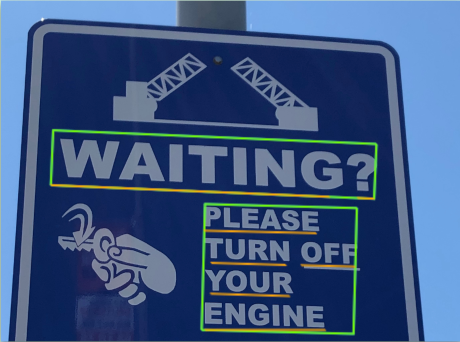
Figura 1. Fotografia di un segnale stradale in cui l'API OCR rileva le parole e i relativi riquadri di delimitazione.
DOCUMENT_TEXT_DETECTIONestrae anche il testo da un'immagine, ma il servizio ottimizza la risposta per testo e documenti densi. Ad esempio, un'immagine scansionata di un testo digitato potrebbe contenere diversi paragrafi e intestazioni. Il servizio OCR restituisce un file JSON con informazioni su pagina, blocco, paragrafo, parola e interruzione.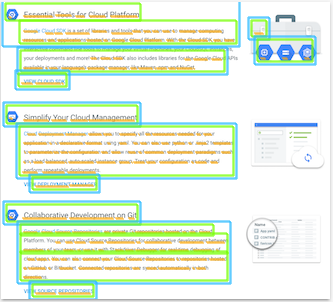
Figura 2. Immagine scansionata di testo digitato in cui l'API OCR rileva informazioni come parole, pagine e paragrafi.
Testo scritto a mano
La Figura 3 è un'immagine di testo scritto a mano. L'API OCR rileva ed estrae il testo da queste immagini. Per un elenco degli alfabeti che supportano il riconoscimento della scrittura a mano libera, consulta Alfabeti per la scrittura a mano libera.

Figura 3. Immagine di scrittura a mano libera in cui l'API OCR rileva il testo.
Limiti del riconoscimento ottico dei caratteri
Puoi riconoscere fino a 30 immagini al minuto, l'equivalente di un'immagine ogni due secondi per unità di appliance.
I metodi API BatchAnnotateImages e BatchAnnotateFiles supportano solo una singola richiesta per chiamata batch.
La tabella seguente elenca i limiti attuali del servizio OCR in Distributed Cloud.
| Limite di file per l'OCR | Valore |
|---|---|
| Numero massimo di pagine | Cinque |
| Massima dimensione del file | 20 MB |
| Dimensione massima immagine | 20 milioni di pixel (lunghezza x larghezza) |
I file inviati per l'API OCR che superano il numero massimo di pagine o le dimensioni massime del file restituiscono un errore. I file inviati che superano le dimensioni massime delle immagini vengono ridotti a 20 milioni di pixel.
Tipi di file supportati per l'OCR
L'API preaddestrata OCR rileva e trascrive il testo dai seguenti tipi di file:
- TIFF
- JPG
- PNG
Devi archiviare i file localmente nel tuo ambiente Distributed Cloud. Non puoi accedere ai file ospitati in Cloud Storage o ai file disponibili pubblicamente per il rilevamento del testo.