


La reconnaissance optique des caractères (OCR) est une API Vertex AI pré-entraînée dans l'appareil air-gapped Google Distributed Cloud (GDC) qui vous permet de détecter et d'extraire du texte à partir de types de fichiers compatibles, y compris des images, des documents et des notes manuscrites. Vous pouvez traiter les requêtes d'images et de documents intégrés dans les langues acceptées.
Méthodes de reconnaissance optique des caractères
L'OCR propose les méthodes suivantes dans l'appareil GDC sous air gap pour reconnaître du texte :
| Méthode | Description |
|---|---|
BatchAnnotateImages |
Détecter du texte à partir d'un lot d'images JPEG ou PNG fournies dans une requête intégrée. |
BatchAnnotateFiles |
Détectez du texte à partir d'un lot de fichiers PDF ou TIFF fournis dans une requête intégrée. |
Fonctionnalités de reconnaissance optique des caractères
L'API OCR peut détecter et extraire du texte à partir d'images. Les deux fonctionnalités d'annotation suivantes sont compatibles avec la reconnaissance optique des caractères :
TEXT_DETECTIONdétecte et extrait le texte de n'importe quelle image. Par exemple, une photo peut contenir un panneau de signalisation ou un panneau de rue. Le service de reconnaissance optique des caractères renvoie un fichier JSON contenant la chaîne extraite, les mots individuels et leurs cadres de délimitation.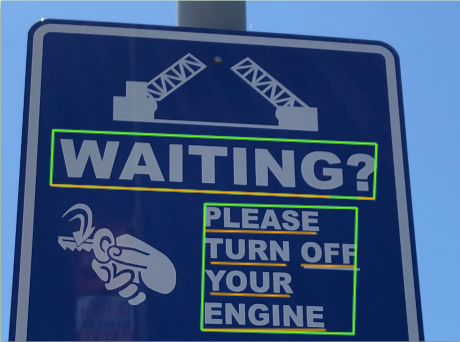
Figure 1 : Photo d'un panneau de signalisation sur laquelle l'API OCR détecte des mots et leurs cadres de délimitation.
DOCUMENT_TEXT_DETECTIONextrait également le texte d'une image, mais le service optimise la réponse pour le texte dense et les documents. Par exemple, une image numérisée d'un texte dactylographié peut contenir plusieurs paragraphes et en-têtes. Le service de reconnaissance optique des caractères renvoie un fichier JSON contenant des informations sur les pages, les blocs, les paragraphes, les mots et les sauts.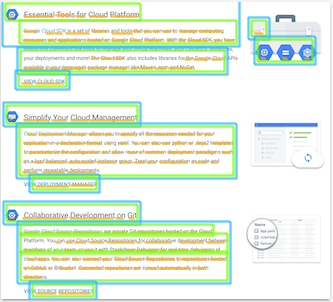
Figure 2. Image numérisée d'un texte dactylographié dans laquelle l'API OCR détecte des informations telles que des mots, des pages et des paragraphes.
Texte manuscrit
La figure 3 est une image de texte manuscrit. L'API OCR détecte et extrait le texte de ces images. Pour obtenir la liste des scripts d'écriture manuscrite compatibles avec la reconnaissance de l'écriture manuscrite, consultez Scripts d'écriture manuscrite.

Figure 3. Image d'écriture manuscrite dans laquelle l'API OCR détecte du texte.
Limites de la reconnaissance optique des caractères
Vous pouvez reconnaître jusqu'à 30 images par minute, ce qui équivaut à une image toutes les deux secondes par unité d'appareil.
Les méthodes d'API BatchAnnotateImages et BatchAnnotateFiles n'acceptent qu'une seule requête par appel par lot.
Le tableau suivant liste les limites actuelles du service OCR dans Distributed Cloud.
| Limite de fichiers pour l'OCR | Valeur |
|---|---|
| Nombre maximal de pages | Cinq |
| Taille maximale du fichier | 20 Mo |
| Taille maximale de l'image | 20 millions de pixels (longueur x largeur) |
Les fichiers envoyés à l'API OCR qui dépassent le nombre maximal de pages ou la taille maximale de fichier renvoient une erreur. Les fichiers envoyés qui dépassent la taille d'image maximale sont réduits à 20 millions de pixels.
Types de fichiers compatibles avec l'OCR
L'API pré-entraînée de reconnaissance optique des caractères détecte et transcrit le texte des types de fichiers suivants :
- TIFF
- JPG
- PNG
Vous devez stocker les fichiers localement dans votre environnement Distributed Cloud. Vous ne pouvez pas accéder aux fichiers hébergés dans Cloud Storage ni aux fichiers accessibles publiquement pour la détection de texte.