


Cloud Monitoring collecte des métriques, des événements et des métadonnées provenant des Google Cloud produits. Avec Cloud Monitoring, vous pouvez également configurer des tableaux de bord personnalisés et des alertes d'utilisation.
Ce document vous explique comment utiliser les métriques, découvrir le tableau de bord des métriques personnalisées et configurer des alertes.
Ressources surveillées
Une ressource surveillée dans Cloud Monitoring représente une entité logique ou physique, telle qu'une machine virtuelle, une base de données ou une application. Les ressources surveillées contiennent un ensemble unique de métriques qui peuvent être explorées, présentées dans un tableau de bord ou utilisées pour créer des alertes. Chaque ressource possède également un ensemble d'étiquettes de ressources, qui sont des paires clé/valeur contenant des informations supplémentaires sur la ressource. Les étiquettes de ressources sont disponibles pour toutes les métriques associées à la ressource.
À l'aide de l'API Cloud Monitoring, les performances de Firestore en mode Datastore sont surveillées avec les ressources suivantes :
| Ressources | Description | Mode de base de données compatible |
firestore.googleapis.com/Database (recommandé) | Type de ressource surveillée qui fournit des répartitions pour project,
location* et database_id . L'
database_id étiquette sera (default) pour les bases de données créées
sans nom spécifique. |
S'applique aux deux modes. |
datastore_request | Type de ressource surveillée pour les projets Datastore qui ne fournit pas de répartition pour les bases de données. |
Métriques
Firestore est disponible dans deux modes différents : Firestore en mode natif et Firestore en mode Datastore. Pour comparer les fonctionnalités de ces deux modes, consultez Choisir entre les modes de base de données.
Pour obtenir la liste complète des métriques de Firestore en mode Datastore, consultez Métriques de Firestore en mode Datastore.
Métriques d'exécution du service
Les serviceruntime
métriques fournissent une vue d'ensemble du trafic d'un projet. Ces métriques sont
disponibles pour la plupart des Google Cloud API. Le
consumed_api
type de ressource surveillée contient ces métriques courantes. Ces métriques sont échantillonnées toutes les 30 minutes, ce qui permet de lisser les données.
Une étiquette de ressource importante pour les métriques serviceruntime est method. Cette étiquette représente la méthode RPC sous-jacente appelée. Il est possible que la méthode SDK que vous appelez ne porte pas le même nom que la méthode RPC sous-jacente. En effet, le SDK fournit une abstraction d'API de haut niveau. Toutefois, lorsque vous essayez de comprendre comment votre application interagit avec Firestore, il est important de comprendre les métriques en fonction du nom de la méthode RPC.
Si vous avez besoin de connaître la méthode RPC sous-jacente pour une méthode SDK donnée, consultez la documentation de l'API.
api/request_count
Cette métrique fournit le nombre de requêtes effectuées, par protocole(protocole de requête, tel que HTTP, gRPC, etc.),
code de réponse (code de réponse HTTP), response_code_class (classe de code de réponse, telle que 2xx, 4xx, etc.) et grpc_status_code (code de réponse gRPC numérique). Utilisez cette métrique pour observer la requête API globale et calculer le taux d'erreur.
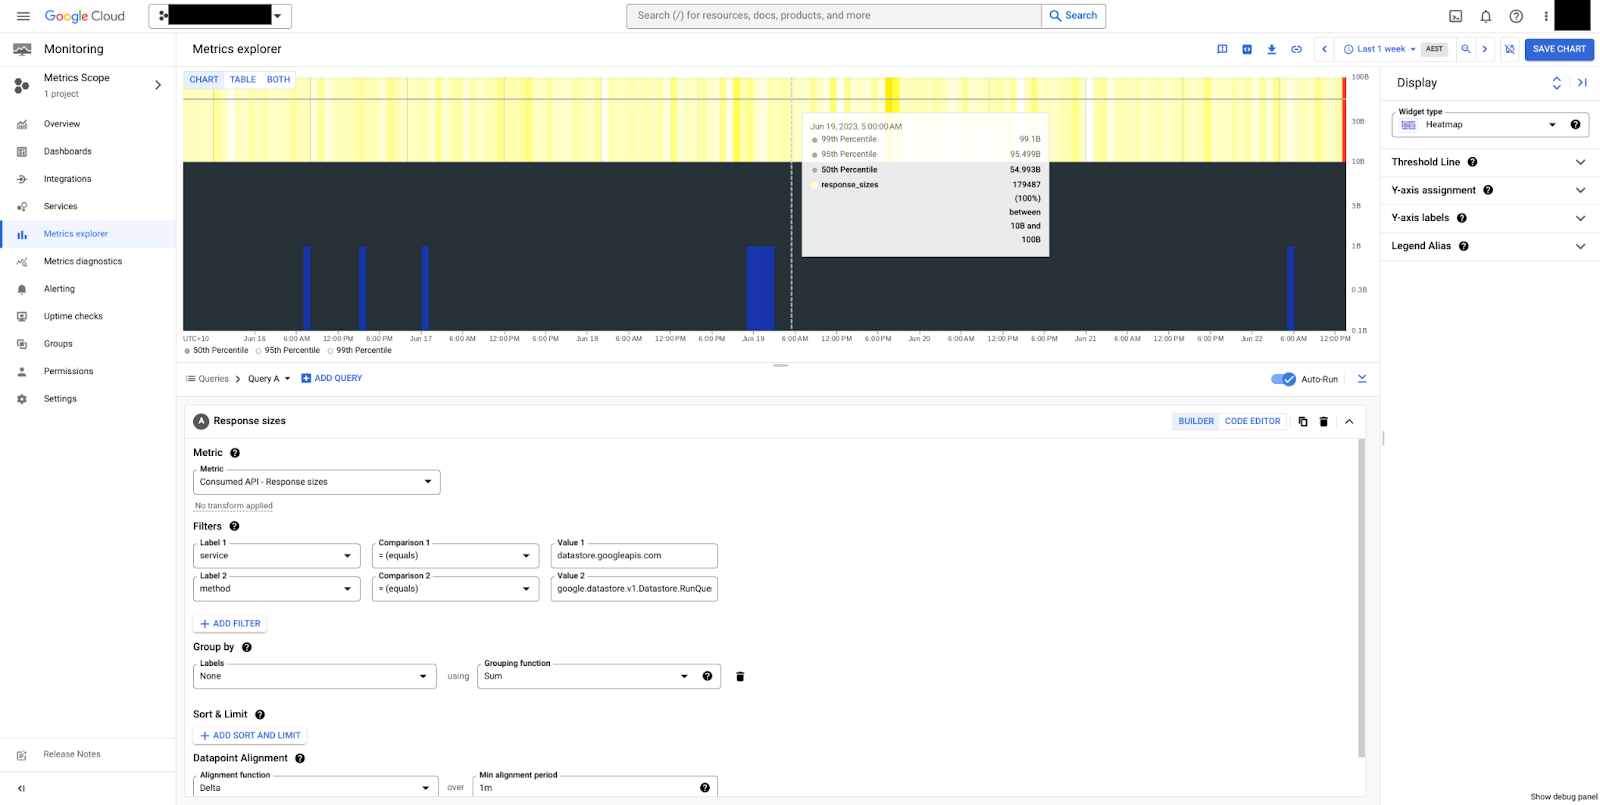
La figure 1 montre les requêtes qui renvoient un code 2xx regroupées par service et par méthode. Les codes 2xx sont des codes d'état HTTP qui indiquent que la requête a réussi.
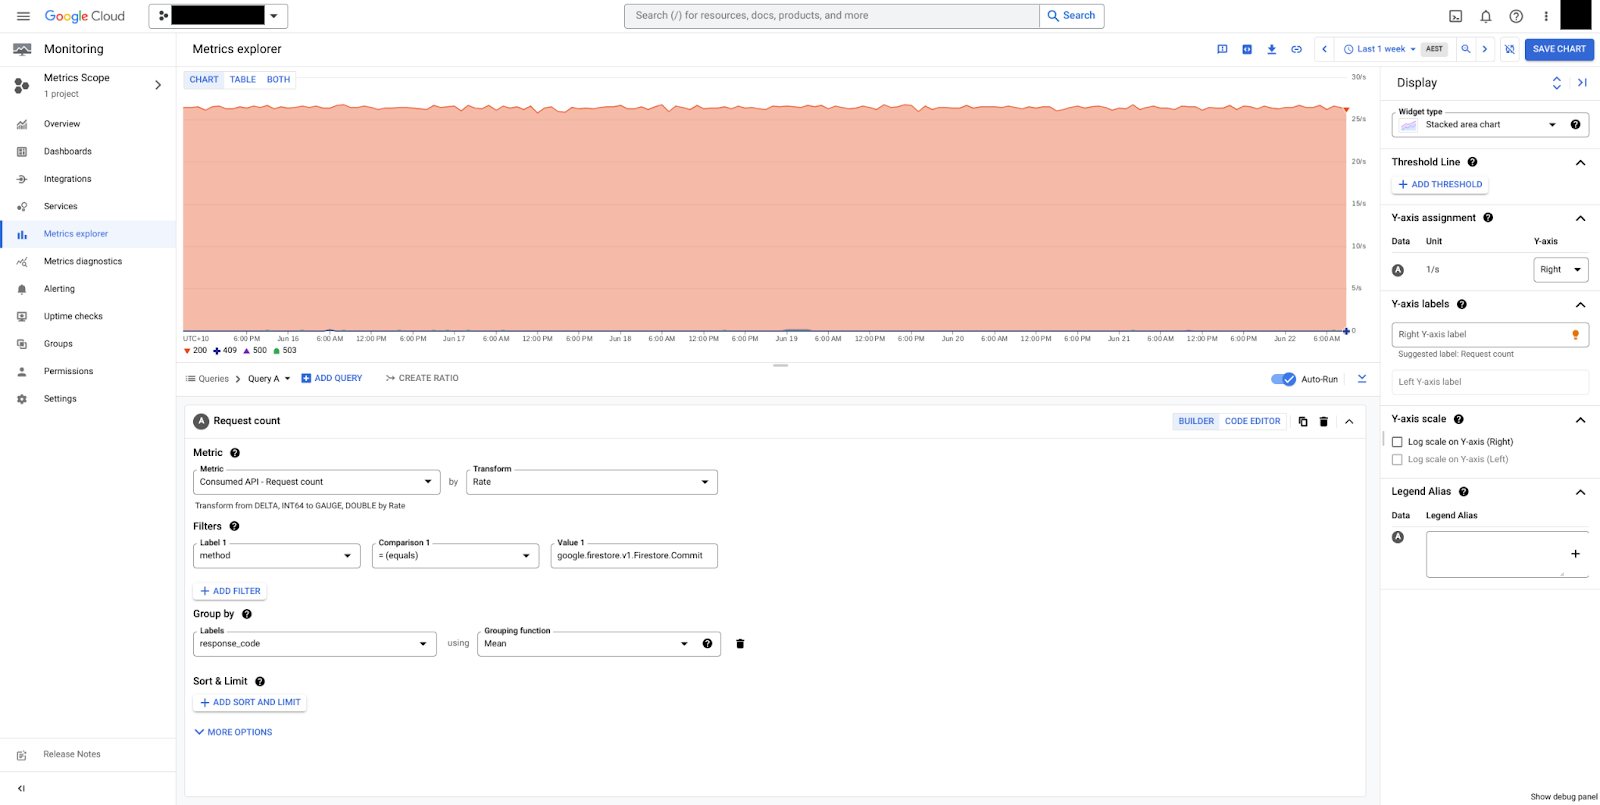
La figure 2 montre les commits regroupés par response_code. Dans cet exemple, nous ne voyons que des réponses HTTP 200, ce qui implique que la base de données est en bon état.
Utilisez les métriques d'exécution de service suivantes pour surveiller votre base de données.
api/request_count dans le type de ressource datastore_request
La métrique api/request_count est également disponible sous le type de ressource datastore_request avec des répartitions api_method et response_code. Utilisez plutôt cette métrique pour profiter de la période d'échantillonnage plus fine, ce qui permet de détecter les pics.
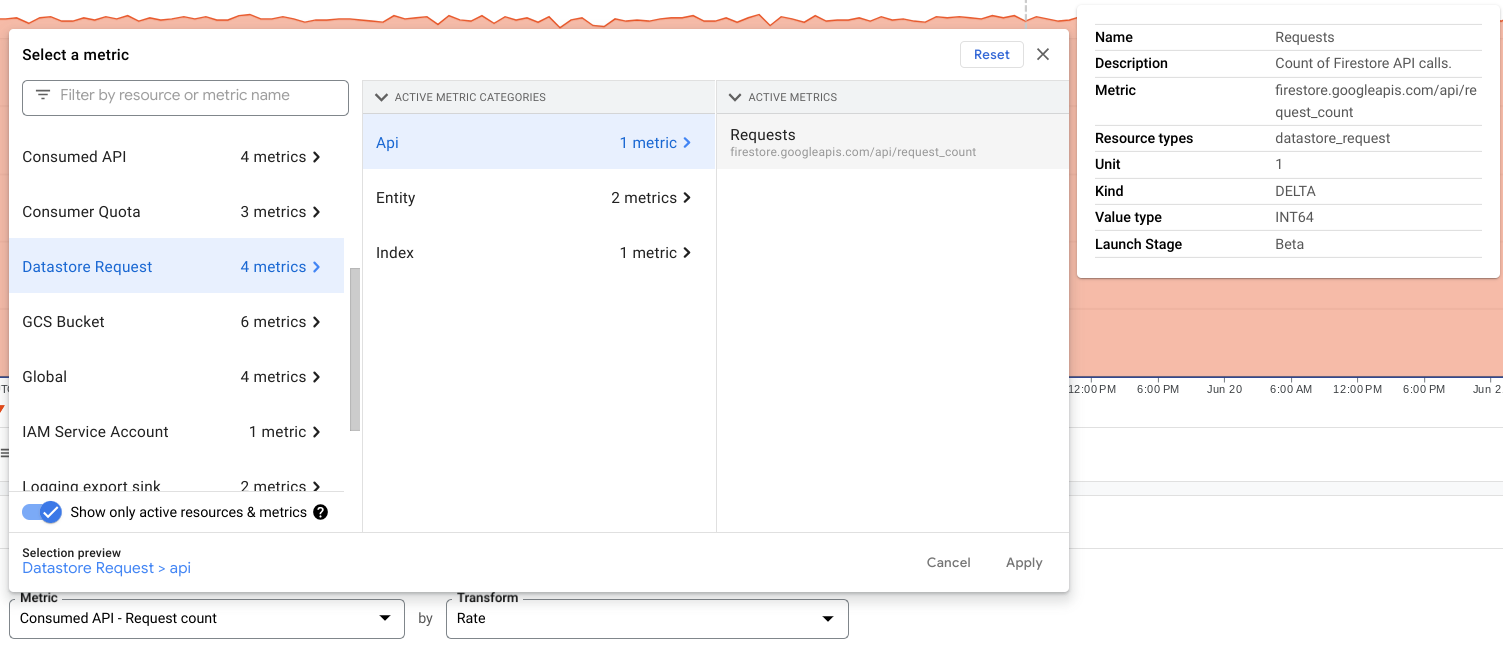
api/request_latencies
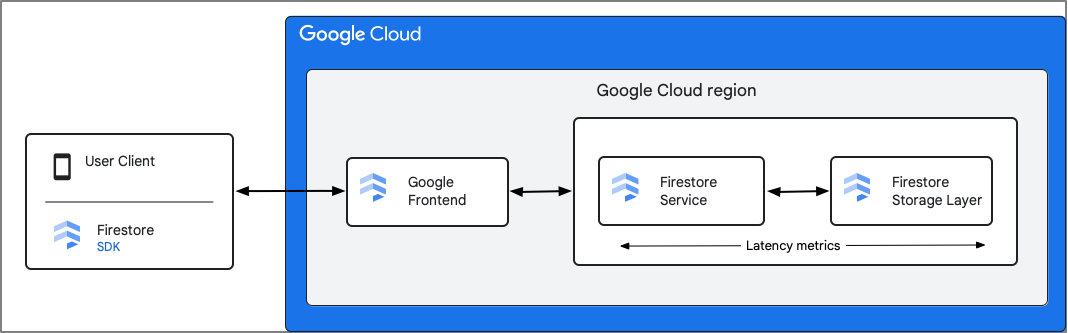
La métrique api/request_latencies fournit des distributions de latence pour toutes les requêtes effectuées.
Firestore enregistre les métriques à partir du composant Service Firestore. Les métriques de latence incluent le temps écoulé entre le moment où Firestore reçoit la requête et celui où il termine l'envoi de la réponse, y compris les interactions avec la couche de stockage. Par conséquent, la latence aller-retour (RTT) entre le client et le service Firestore n'est pas incluse dans ces métriques.
api/request_sizes et api/response_sizes
Les métriques api/request_sizes et api/response_sizes fournissent respectivement des informations sur la taille des charges utiles (en octets). Elles peuvent être utiles pour comprendre les charges de travail en écriture qui envoient de grandes quantités de données ou les requêtes trop larges qui renvoient des charges utiles volumineuses.
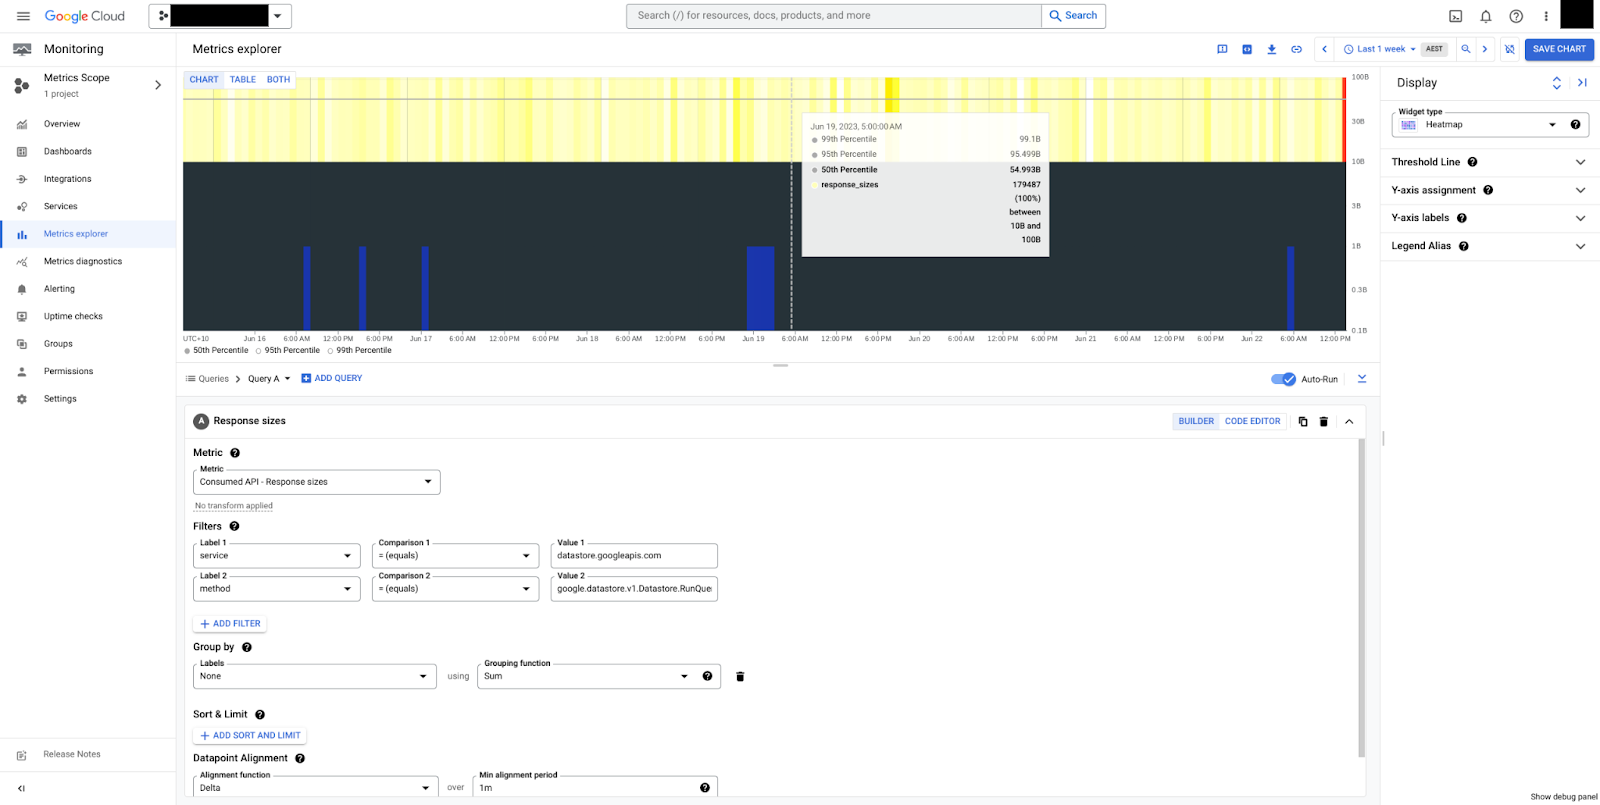
La figure 5 montre une carte de chaleur des tailles de réponse pour la méthode RunQuery.
Nous pouvons constater que les tailles sont stables, avec une médiane de 50 octets et une plage globale comprise entre 10 et 100 octets. Notez que les tailles de charge utile sont toujours mesurées en octets non compressés, à l'exclusion des frais généraux de contrôle de la transmission.
Métriques d'opération d'entité
Ces métriques fournissent des distributions en octets des tailles de charge utile pour les lectures (recherches et requêtes) et les écritures dans une base de données Firestore. Les valeurs représentent la taille totale de la charge utile. Par exemple, tous les résultats renvoyés par une requête.
Ces métriques sont semblables aux métriques api/request_sizes et api/response_sizes, la principale différence étant que les métriques d'opération d'entité fournissent un échantillonnage plus précis, mais des répartitions moins précises.
Par exemple, les métriques d'opération d'entité utilisent la ressource surveillée datastore_request. Il n'y a donc pas de répartition par service ni par méthode.
entity/read_sizes: distribution des tailles des entités lues, regroupées par type.entity/write_sizes: distribution des tailles des entités écrites, regroupées par opérations.
Métriques d'index
Les taux d'écriture d'index peuvent être comparés à la métrique document/write_ops_count pour comprendre le taux de sortance de l'index.
index/write_count: nombre d'écritures d'index.
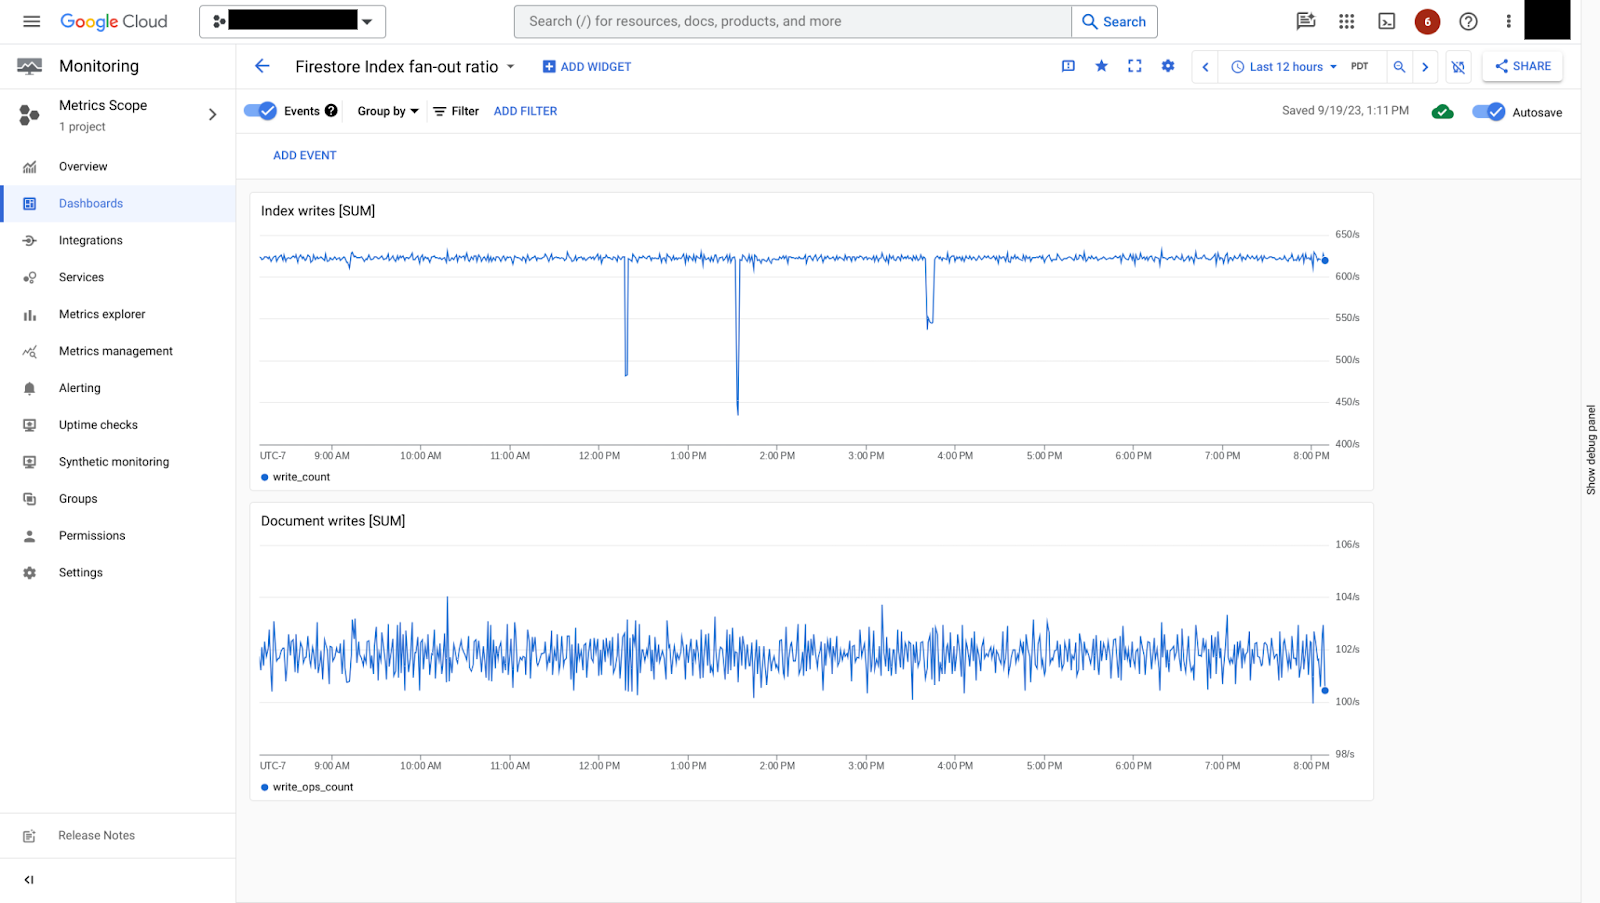
La figure 7 montre comment le taux d'écriture d'index peut être comparé au taux d'écriture de document. Dans cet exemple, pour chaque écriture de document, il existe environ six écritures d'index, ce qui correspond à un taux de fan-out d'index relativement faible.
Métriques TTL
Les métriques TTL sont disponibles pour les bases de données Firestore en mode natif et Firestore en mode Datastore. Utilisez ces métriques pour surveiller l'effet de la règle TTL appliquée.
entity/ttl_deletion_count: nombre total d'entités supprimées par les services TTL.entity/ttl_expiration_to_deletion_delays: temps écoulé entre l'expiration d'une entité avec une valeur TTL et sa suppression effective.Si vous constatez que les délais de suppression TTL dépassent 24 heures, contactez l'assistance.
Étape suivante
- Découvrez comment utiliser le tableau de bord Cloud Monitoring pour afficher les métriques.